


本页面介绍了用于在 Google Cloud上对旧版大型主机工作负载进行现代化的工具、策略和结构化工作流。
如果您是企业云架构师、大型主机工程师或迁移专家,可以使用本页面中的信息来评估大型主机评估工具、实现大型主机数据现代化、使用 AI 辅助工具生成云原生服务,以及在割接前验证功能对等性。
在阅读本页内容之前,您应该先清点大型主机应用(例如 COBOL、PL/I、JCL 和 DB2/VSAM 数据集),并了解目标云架构目标。
选择大型主机现代化改造路径
使用下表,根据您的源工作负载和现代化改造目标选择现代化改造策略和推荐的 Google Cloud 工具:
| 现代化改造路径 | 源工作负载 | 推荐的工具 | 目标服务 | 场景指南 |
|---|---|---|---|---|
| AI 辅助式应用重构 | 单体式 COBOL、PL/I 和 CICS 应用 | Google Cloud Modernization Hub、Mainframe Assessment Tool、Antigravity CLI | Google Kubernetes Engine (GKE)、Cloud Run、Spanner 或 AlloyDB for PostgreSQL | 大型主机应用重构 |
| 自动代码转换和验证 | 提取的业务规则和旧版过程代码库 | Antigravity CLI、Dual Run | Cloud Run 或 GKE | 自动大型机代码转换 |
| 大型主机直接原样迁移(模拟) | 需要极少代码更改的 IBM z/OS 或 IBM i 工作负载 | 合作伙伴模拟运行时、Mainframe Connector | Compute Engine、Cloud SQL | 大型主机工作负载直接原样迁移 |
| 数据分流和分析 | EBCDIC 批处理数据集、VSAM 文件和 DB2 表 | Mainframe Connector | BigQuery、Cloud Storage | Mainframe Connector 配置 |
主要功能
Google Cloud 为大型主机现代化改造的每个阶段提供以下工具和服务:
- 自动化应用评估:Mainframe Assessment Tool (MAT) 可对源代码(COBOL、PL/I、JCL)进行逆向工程,映射程序和数据依赖关系,并提取嵌入式业务规则。
- AI 辅助正向工程:Antigravity CLI 和 Antigravity 可帮助开发者将提取的业务规则转换为在 GKE 或 Cloud Run 上运行的目标语言(例如 Java 或 Go)的现代云原生服务。
- 数据现代化改造:Mainframe Connector 会对大型主机数据集 (EBCDIC) 进行转码并将其移至Google Cloud BigQuery 和 Cloud Storage 等服务。
- 功能验证:Dual Run 在大型主机和Google Cloud 上同时运行生产工作负载,以在割接前验证数据一致性和功能对等性。
逆向和正向工程
大型主机现代化改造依赖于以下双重方法来安全地提取逻辑和重新构建应用:
- 逆向工程:在现代化改造开始前,分析现有大型主机应用,以了解代码库。通过使用 Mainframe Assessment Tool (MAT),您可以映射应用依赖项并从旧版代码(COBOL、PL/I)中提取业务规则。MAT 使用生成式 AI 生成技术规格和目录数据结构。
- 正向工程:将高级业务需求和提取的规则转换为现代应用代码。在大型主机现代化改造中,正向工程使用自动化工具和 Antigravity CLI 将业务规则转换为功能规范、产品需求文档 (PRD)、用户故事和 Google Cloud上的云服务。
现代化改造工作流
下图展示了大型机现代化改造流程的五个阶段:
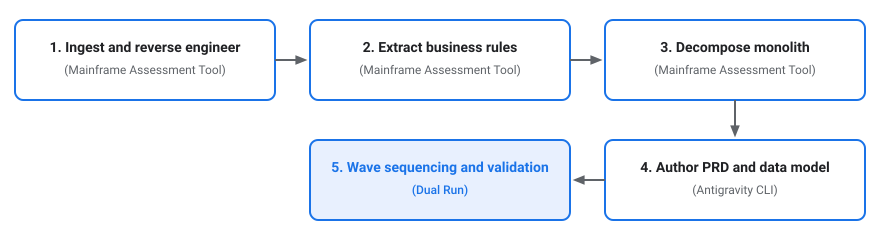
第 1 阶段:提取和逆向工程源代码
在第 1 阶段,您可以使用 Mainframe Assessment Tool (MAT) 分析现有大型主机应用,涵盖以下功能:
- 源代码注入:清点和解析 COBOL、PL/I、汇编语言、JCL 批量作业、copybook 和数据库架构。
- 数据依赖性映射:识别 DB2 表、VSAM 文件、IMS 数据库和平面文件之间的关系。
- 调用树创建:生成直观的程序调用图,显示批处理序列和在线客户信息控制系统 (CICS) 事务流,以建立迁移波次。
如需了解详情,请参阅在 Modernization Hub 中设置 Mainframe Assessment Tool、创建评估和查看评估结果。
第 2 阶段:提取嵌入式业务规则
在生成现代应用之前,请先从复杂的旧版 COBOL 或 PL/I 代码块中隔离并验证关键业务逻辑:
- AI 辅助规则提取:Mainframe Assessment Tool 使用 Gemini 逐行分析源代码,并将复杂的条件逻辑转换为通俗易懂的英语业务规则。
- 规则隔离:从过程代码中提取特定于网域的验证、利息计算或交易逻辑。
- 人机协同审核:领域专家和业务分析师审核、优化和认证提取的业务规则。
- 文档生成:自动为旧版程序编译最新的技术规范。
如需了解详情,请参阅提取业务规则。
第 3 阶段:将单体式应用分解为业务领域
在部署微服务之前,请将单体式大型主机代码库划分为有界上下文和解耦的可迁移业务领域:
- 网域映射:将代码资产细分为逻辑业务网域(例如账号、结算和付款)。
- 共享数据集解耦:识别必须拆分为服务专用数据库的共享 VSAM 或 DB2 数据结构。
- 接口定义:为提取的服务定义 REST 或 gRPC API 边界。
如需了解详情,请参阅查看针对您的业务网域生成的 AI 数据分析。
第 4 阶段:编写 PRD、数据模型和现代代码
使用 Antigravity CLI 将提取的评估输出转换为结构化规范、目标架构和现代应用代码,运行在 Google Cloud上:
- PRD 和用户故事生成:将评估数据整合到功能规范、详细说明关键用户历程 (CUJ) 和运营 SLA 的产品需求文档 (PRD) 以及敏捷工程任务中。
- 目标云架构:选择目标计算运行时(Cloud Run、GKE 或 Compute Engine)。
- 目标数据建模:设计数据结构(关系型、文件、键值对),并根据工作负载选择现代云数据库架构:
- 自动生成代码:对实现蓝图进行排序,并以目标语言(例如 Java 或 Go)生成应用代码,以实现提取的业务规则和目标数据模型。
如需了解如何配置导出的 AGENTS.md 文件、启用 Mainframe Assessment Tool MCP 服务器以及验证生成的代码,请参阅现代化改造和验证。
第 5 阶段:对迁移批次进行排序并验证一致性
在生产切换之前,以结构化批次迁移数据集并验证功能对等性:
- 大型主机数据现代化改造:配置 Mainframe Connector,以便将旧版 EBCDIC 数据集大量转码到 Cloud Storage 和 BigQuery。
- 增量波次割接:按业务领域安排现代化改造波次,而不是执行全系统割接。
- 功能对等测试:使用 Dual Run 并行重放实时大型主机事务,以验证现代化应用并验证功能对等,然后再停用旧代码。 Google Cloud
- 部署和运维:将现代化工作负载部署到生产环境,并使用 Google Cloud Observability 监控性能。