


本页面提供了架构指南和模拟策略,用于在尽可能减少代码修改的情况下将旧版大型主机工作负载(例如 IBM z/OS 或 IBM i)迁移到Google Cloud 。
如果您是云架构师、大型主机工程师或基础架构专家,请使用本页面中的信息评估模拟运行时、将大型主机工作负载重新平台化到 Compute Engine、降低大型主机 MIPS 许可费用,以及使用 Mainframe Connector 将批量数据流式传输到 BigQuery。
在阅读本页内容之前,您应了解大型主机工作负载 MIPS 消耗、应用依赖项和目标模拟运行时要求。
大型主机直接原样迁移架构
大型主机直接原样迁移会将物理大型主机硬件替换为云虚拟基础设施,在 Compute Engine 上的模拟运行时环境中运行旧版 COBOL 或 PL/I 程序。
除了计算模拟之外,您还可以使用 Mainframe Connector 来分流 CPU 密集型报告工作负载并减少大型主机 MIPS 消耗。借助 Mainframe Connector,您可以完成以下任务:
- 将 EBCDIC 数据集(QSAM 和 VSAM)转码为 ORC、JSON 或 CSV 格式。
- 将数据迁移到 Cloud Storage 和 BigQuery。
- 直接从作业控制语言 (JCL) 提交 BigQuery 作业。
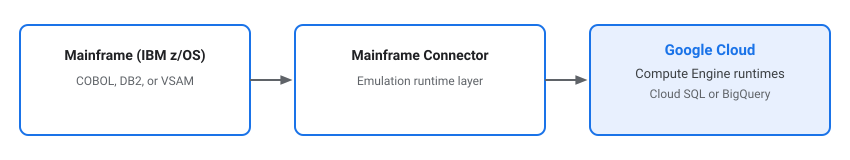
下图展示了大型主机直接迁移架构:
关键组件
大型机直接迁移架构包含以下组件:
- 计算模拟运行时:在 Compute Engine 上部署合作伙伴模拟引擎(例如 Micro Focus、NTT DATA 或 LzLabs),以运行 COBOL 或 CICS 二进制文件,而无需重写业务逻辑。
- 数据集转码:使用 Mainframe Connector 将 EBCDIC 数据集转码为 ORC、JSON 或 CSV 格式,并将大量大型主机批处理文件直接注入 BigQuery 或 Cloud Storage。
- 数据库模拟:将 DB2 或 IMS 数据重新平台化到代管式云关系型数据库(例如 Cloud SQL 或 Spanner)。