


光学式文字認識(OCR)は、Google Distributed Cloud(GDC)エアギャップ アプライアンスの事前トレーニング済み Vertex AI API で、画像、ドキュメント、手書きメモなどのサポートされているファイル形式からテキストを検出して抽出できます。サポートされている言語でインライン画像とドキュメントのリクエストを処理できます。
光学式文字認識(OCR)メソッド
OCR には、GDC エアギャップ アプライアンスでテキストを認識するために使用できる次のメソッドが用意されています。
| メソッド | 説明 |
|---|---|
BatchAnnotateImages |
インライン リクエストで提供された JPEG または PNG 画像のバッチからテキストを検出します。 |
BatchAnnotateFiles |
インライン リクエストで提供された PDF または TIFF ファイルのバッチからテキストを検出します。 |
光学式文字認識機能
OCR API は、画像からテキストを検出して抽出できます。次の 2 つのアノテーション機能は、光学式文字認識をサポートしています。
TEXT_DETECTIONは、任意の画像からテキストを検出、抽出します。たとえば、写真に道路標識や交通標識が含まれている場合があります。OCR サービスは、抽出された文字列、個々の単語、境界ボックスを含む JSON ファイルを返します。
図 1. OCR API が単語とその境界ボックスを検出する道路標識の写真。
DOCUMENT_TEXT_DETECTIONも画像からテキストを抽出しますが、このサービスは、高密度のテキストとドキュメント用にレスポンスを最適化します。たとえば、入力されたテキストのスキャン画像には、複数の段落と見出しが含まれている場合があります。OCR サービスは、ページ、ブロック、段落、単語、改行の情報を含む JSON ファイルを返します。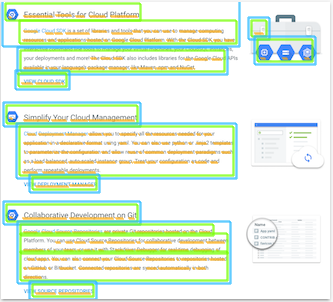
図 2. OCR API が単語、ページ、段落などの情報を検出する、入力されたテキストのスキャン画像。
手書きテキスト
図 3 は手書きテキストの画像です。OCR API は、これらの画像からテキストを検出して抽出します。手書き入力認識をサポートする手書きスクリプトの一覧については、手書きスクリプトをご覧ください。
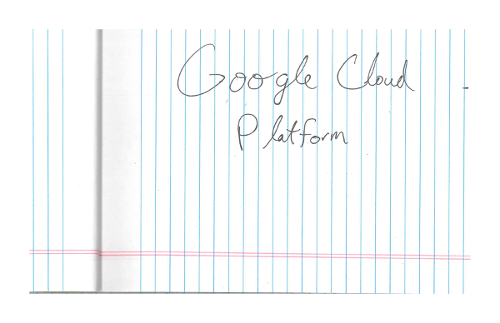
図 3. OCR API がテキストを検出する手書き画像。
光学式文字認識の制限
1 分あたり最大 30 枚の画像を認識できます。これは、アプライアンス ユニットあたり 2 秒ごとに 1 枚の画像に相当します。
BatchAnnotateImages メソッドと BatchAnnotateFiles API メソッドは、バッチ呼び出しごとに 1 つのリクエストのみをサポートします。
次の表に、Distributed Cloud の OCR サービスの現在の制限を示します。
| OCR のファイル上限 | 値 |
|---|---|
| 最大ページ数 | 5 |
| 最大ファイルサイズ | 20 MB |
| 最大画像サイズ | 2,000 万ピクセル(縦 × 横) |
OCR API に送信されたファイルが最大ページ数または最大ファイルサイズを超えると、エラーが返されます。送信されたファイルが最大画像サイズを超えている場合、2,000 万ピクセルに縮小されます。
OCR でサポートされているファイル形式
OCR 事前トレーニング済み API は、次のファイル形式のテキストを検出して文字変換します。
- TIFF
- JPG
- PNG
ファイルは、Distributed Cloud 環境にローカルに保存する必要があります。Cloud Storage でホストされているファイルや、テキスト検出用に一般公開されているファイルにはアクセスできません。