


El reconocimiento óptico de caracteres (OCR) es una API de Vertex AI previamente entrenada en el dispositivo de Google Distributed Cloud (GDC) aislado que te permite detectar y extraer texto de tipos de archivos compatibles, como imágenes, documentos y notas escritas a mano. Puedes procesar solicitudes de imágenes y documentos intercalados en idiomas compatibles.
Métodos de reconocimiento óptico de caracteres
El OCR ofrece los siguientes métodos disponibles en el dispositivo de GDC aislado para reconocer texto:
| Método | Descripción |
|---|---|
BatchAnnotateImages |
Detecta texto de un lote de imágenes JPEG o PNG proporcionadas en una solicitud intercalada. |
BatchAnnotateFiles |
Detecta texto de un lote de archivos PDF o TIFF proporcionados en una solicitud intercalada. |
Funciones de reconocimiento óptico de caracteres
La API de OCR puede detectar y extraer texto de las imágenes. Las siguientes dos funciones de anotación admiten el reconocimiento óptico de caracteres:
TEXT_DETECTIONdetecta y extrae el texto de cualquier imagen. Por ejemplo, una fotografía que contenga una señal de tránsito. El servicio de OCR devuelve un archivo JSON con la cadena extraída, las palabras individuales y sus cuadros delimitadores.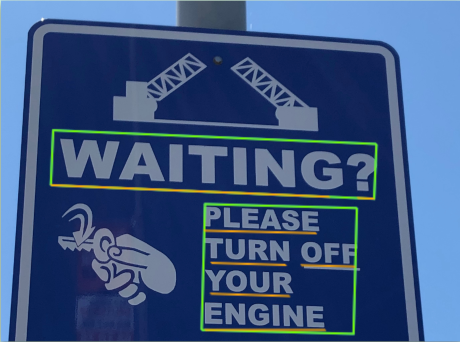
Figura 1. Fotografía de un letrero de ruta en la que la API de OCR detecta palabras y sus cuadros delimitadores.
DOCUMENT_TEXT_DETECTIONtambién extrae el texto de una imagen, pero el servicio optimiza la respuesta para textos y documentos densos. Por ejemplo, una imagen escaneada de texto escrito puede contener varios párrafos y encabezados. El servicio de OCR devuelve un archivo JSON con información de la página, el bloque, el párrafo, la palabra y la división.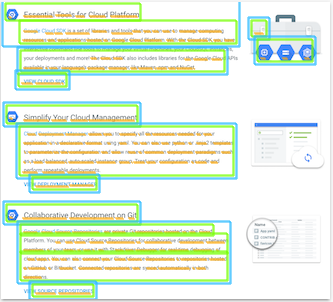
Figura 2. Imagen escaneada de texto escrito en la que la API de OCR detecta información, como palabras, páginas y párrafos.
Texto escrito a mano
La figura 3 es una imagen de texto escrito a mano. La API de OCR detecta y extrae texto de estas imágenes. Para obtener una lista de las secuencias de comandos de escritura a mano que admiten el reconocimiento de escritura a mano, consulta Secuencias de comandos de escritura a mano.
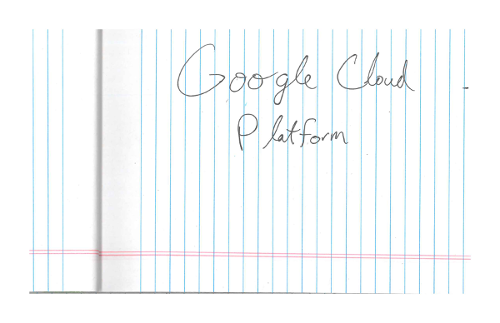
Figura 3. Imagen de escritura a mano en la que la API de OCR detecta texto.
Límites del reconocimiento óptico de caracteres
Puedes reconocer hasta 30 imágenes por minuto, lo que equivale a una imagen cada dos segundos por unidad de dispositivo.
Los métodos de la API de BatchAnnotateImages y BatchAnnotateFiles solo admiten una
única solicitud por llamada por lotes.
En la siguiente tabla, se enumeran los límites actuales del servicio de OCR en Distributed Cloud.
| Límite de archivos para el OCR | Valor |
|---|---|
| Cantidad máxima de páginas | Cinco |
| Tamaño máximo de archivo | 20 MB |
| Tamaño máximo de la imagen | 20 millones de píxeles (largo por ancho) |
Los archivos enviados para la API de OCR que superen la cantidad máxima de páginas o el tamaño máximo de archivo devuelven un error. Los archivos enviados que superen el tamaño máximo de imagen se reducirán a 20 millones de píxeles.
Tipos de archivos compatibles con el OCR
La API previamente entrenada de OCR detecta y transcribe texto de los siguientes tipos de archivos:
- TIFF
- JPG
- PNG
Debes almacenar los archivos de forma local en tu entorno de Distributed Cloud. No puedes acceder a los archivos alojados en Cloud Storage ni a los archivos disponibles de forma pública para la detección de texto.