


Knowledge Catalog 採用 Gemini 技術,可整合結構化和非結構化資料的技術中繼資料和業務語意。接著,您可以使用產生的情境圖表探索資產、驗證資料品質,並為生成式 AI 應用程式建立基準,減少幻覺。
本文適用對象為資料和情境工程師、資料科學家、資料監管人員和 AI 開發人員。本指南假設您熟悉資料庫和儲存系統 (例如 BigQuery 或 Cloud Storage),並對生成式 AI 概念有基本瞭解,例如檢索增強生成 (RAG) 或 Model Context Protocol (MCP)。
如需 Knowledge Catalog 的詳細逐步操作說明,請觀看下列影片:
解決產業專屬資料複雜性
現代企業的資料相當複雜、高度分散,且同時存在結構化和非結構化格式。業務要求很少對應到單一資料庫結構定義或文件儲存庫。如何安全地整合這些孤立資料,同時提供即時、可靠的跨領域問題解答,是營運上的重大挑戰。
Knowledge Catalog 是語意基礎,可彌補這項落差,讓 AI 代理和數據分析工具擷取有依據的相關背景資訊。
主要使用者角色
背景資訊工程師 (資料工程師):自動匯總資料庫和 Cloud Storage 的中繼資料、透過歷程追蹤轉換作業,以及建構充實和評估工作流程。
資料監管員 (管理團隊)。監督中繼資料品質,包括人工介入迴路審查 AI 生成的說明、使用詞彙表標準化組織詞彙,以及定義自訂面向,將特定領域的背景資訊附加至目錄項目。
AI 開發人員。使用 MCP 伺服器或內容擷取 API,以可靠的企業資料架構建立 LLM 和 AI 應用程式的基準。
產業應用實例
下表說明實務上會遇到的複雜問題、這些問題如何跨越技術界線,以及 Knowledge Catalog 如何協助組織解決這些問題:
| 產業別 | 資料和營運挑戰 | 要解決的業務問題 | Knowledge Catalog 如何解決問題 |
|---|---|---|---|
| 電子商務 |
|
「找出退貨率高,且顧客相片顯示送達時有損壞跡象的電子產品。」 | 跨資料格式的語意基準:自動探索交易資料庫的中繼資料,並連結至 Cloud Storage 儲存空間值區中的非結構化圖片,讓 AI 工具能跨不同儲存系統解析查詢。 |
| 製造業 |
|
「生成摘要,列出上季未通過安全檢查的西部地區機器相關檢查報告。」 | 區域和非結構化檢索:檢索非結構化 PDF 檢查報告和資產中繼資料,並建立目錄,讓生成式 AI 代理能依區域找出、彙整及摘要報告。 |
| 醫療照護業 |
|
「根據最近的實驗室生命徵象和看診頻率,哪些病患在 30 天內再次入院的風險最高?」 | 資料品質和歷程:計算電子健康記錄動態饋給中的行層級資料品質剖析和歷程圖,確保臨床預測模型只依賴經過驗證的高品質病患生命徵象。 |
| 金融服務 |
|
「哪些前 10 大收益客戶曾抱怨『效能問題』?這對第 3 季預測有何影響?」 | 統合式情境圖:整合客戶記錄、支援意見回饋和財務表格,讓自然語言查詢結合客戶收益統計資料和非結構化意見回饋檔案,預測財務影響。 |
為解決這些營運難題,Knowledge Catalog 提供重要功能,協助資料工程師、資料科學家和 AI 開發人員建構受控管的資料系統:
使用 Model Context Protocol (MCP) 建立 AI 代理的基準。使用本機或遠端 MCP 伺服器,直接向 AI 代理公開中繼資料、結構定義、歷程和業務規則。這些伺服器可讓模型在提出動作前,先驗證作業預期。
加速 AI 和數據分析的探索。使用自然語言語意搜尋功能,找出相關資料資產。生成式摘要和建議可協助使用者找到資料,不必等待人工審查文件。
大規模管理資料產品。將資產集合與服務水準協議 (SLA)、合約、擁有權詳細資料和使用注意事項,封裝成單一受控管的單元,方便搜尋和訂閱。
Knowledge Catalog 的運作方式
Knowledge Catalog 透過三大支柱生命週期,整合資料管理和背景資訊。下圖說明這項服務如何將實體資料資產對應至業務語意,為 AI 代理建立基準:
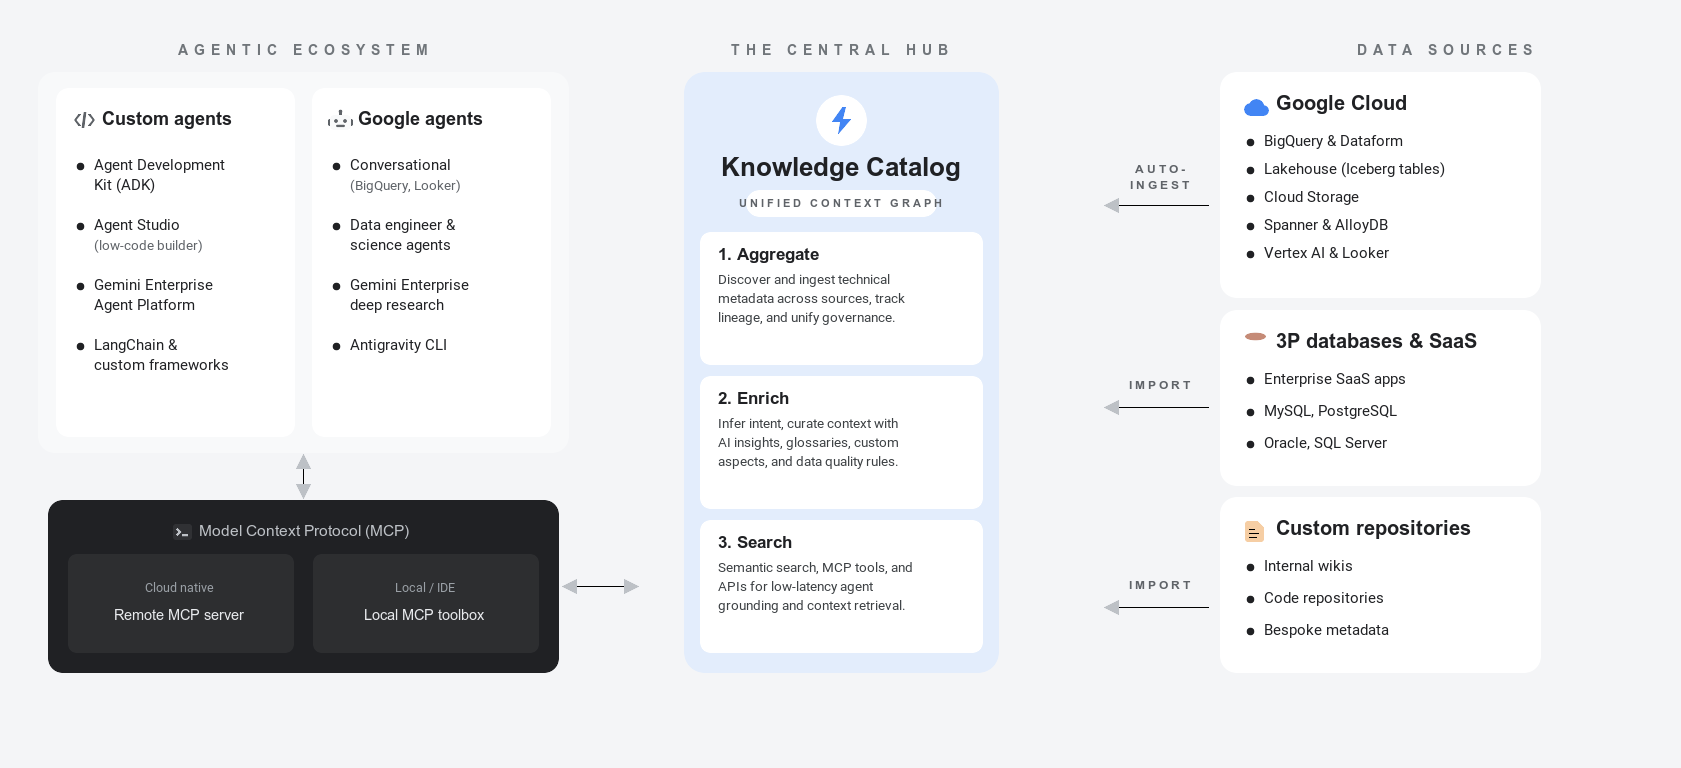
如要進一步瞭解這些中繼資料概念,請參閱「關於中繼資料」。
以下各節將說明中繼資料生命週期的三大要素,並說明零售公司如何將這些要素套用至資料庫資料表、檔案和外部目錄項目:
匯總 (探索及擷取)。Knowledge Catalog 會自動檢索及索引整個資料資產中的技術中繼資料,不需移動基礎資料:
- 內建資料庫:自動編目功能可擷取 BigQuery、AlloyDB for PostgreSQL 和 Spanner 等平台的結構定義和屬性。
- 代管連線。從外部系統 (例如 Oracle 或 PostgreSQL) 或合作夥伴註冊資料庫 (例如 Collibra) 擷取定義,不必編寫自訂管道。
- 資料歷程。追蹤各管道的資料欄層級轉換,瞭解資料來源和變化。
- 範例:某零售公司自動擷取交易資料庫中繼資料 (例如
orders和order_items資料表),並為儲存在 Cloud Storage bucket 中的非結構化產品檔案建立索引。他們連結外部資料庫,在可供探索的目錄下建立統一的中繼資料索引。
擴充 (整理背景資訊並驗證信任)。Knowledge Catalog 會將業務含意附加至技術結構,並建立信任信號:
- AI 生成的洞察資料:Gemini 會分析查詢記錄,生成資料欄說明、資料表摘要和建議的 join。
- 詞彙表和切面。使用業務字詞和邏輯範本,將內部指標名稱對應至共用詞彙。
- 資料品質和異常偵測。強制執行整潔度指南,並執行機器學習掃描,偵測統計離群值或資料更新間隔問題,產生關鍵信任信號。
- 管理審查:使用工作流程審查程序,在發布前驗證中繼資料更新,藉此管理風險。
- 範例:零售團隊觸發資料洞察,建議資料欄說明並執行資料品質規則,藉此充實資產。他們會建立詞彙表和切面,將業務定義對應至有效訂單。
進一步瞭解中繼資料擴充和信任驗證 (按一下即可展開)
- 設定資料洞察:說明如何自動生成資料集說明和摘要。
- 管理組織詞彙:說明如何自訂標準字詞和組織詞彙。
- 使用切面擴充中繼資料:說明如何將結構化中繼資料屬性附加至邏輯資產。
- 重複使用資料品質規則:說明如何建立及重複使用資料庫驗證規則。
- 資料剖析總覽:說明如何設定掃描作業,找出結構定義異常和統計資料偏移。
搜尋與檢索 (存取及建立基準)。AI 應用程式和企業使用者可查詢統合的 Context Graph,安全存取資料:
- 建立代理基準。將 LLM 應用程式和代理連結至目錄。
- Context API。執行低延遲基準酬載要求。
- 語意搜尋:使用自然語言查詢,找出合適的素材資源。
- 資料封裝。將資料表、授權詳細資料和服務水準協議組合,彙整成安全的自助式資料套件。
- 範例:分析人員使用自然語言語意搜尋功能尋找資產。AI 應用程式會使用 MCP 伺服器或 Context Retrieval API 安全地取用這個索引,並將優質資產封裝至安全檢視畫面。
進一步瞭解情境檢索和代理基準建立 (按一下即可展開)
- Model Context Protocol (MCP) 總覽:說明如何將生成式 AI 代理和應用程式層,連結至 Knowledge Catalog 情境。
- 使用 LookupContext 擷取情境:說明如何擷取重要作業酬載,用於代理提示。
- 搜尋資產:說明如何使用自然語言語意查詢語法查詢資產。
Google Cloud 中的 Knowledge Catalog 和 AI 生態系統
建立資料基礎時,必須瞭解 Knowledge Catalog 如何與相關服務整合。
Google Cloud 資料庫和模型
- BigQuery。Knowledge Catalog 會自動檢索 BigQuery 資料集、資料表和檢視表,並建立索引。這項功能會觸發 Gemini 輔助的資料洞察,分析查詢記錄、發布說明,並建議經過驗證的查詢範例。
- Looker (Google Cloud Core)。Knowledge Catalog 會擷取 Looker 資訊主頁、Look 圖表和 LookML 結構,例如檢視表、探索、維度和測量指標。這項擷取作業會建立歷程對應,追蹤作業值如何對應至業務語意。
- Lakehouse 執行階段目錄。Knowledge Catalog 與 Lakehouse 執行階段目錄整合,後者是開放原始碼 Iceberg 工作負載的執行階段 metastore。這項服務會自動為 Lakehouse 執行階段目錄工作負載的技術中繼資料建立索引,提供統一的 Active Context。
AI 代理平台和助理
- 對話式數據分析:分析介面會使用目錄字詞和查詢工具,讓使用者以自然語言查詢業務指標,並提供經過驗證的基準。
- Gemini for AI 代理。高精確度助理代理會使用目錄中繼資料執行資料庫查詢,減少幻覺。
- Gemini Enterprise Agent Platform。Knowledge Catalog 是目標平台環境中的中央資料治理標準。並與 Gemini Enterprise Agent Platform 交叉連結,將工具和情境資訊提供給平台的 Agent Registry。
Google Cloud 資料庫和 AI 服務整合
Knowledge Catalog 可與其他Google Cloud 產品搭配使用,構成資料基礎。下表說明 Knowledge Catalog 如何與相關服務整合及互補:
| 服務 | 主要角色 | 與 Knowledge Catalog 整合的方式 |
|---|---|---|
| Knowledge Catalog | 治理與代理功能脈絡資料 | 做為統合語意情境圖,執行資料品質檢查掃描,並向 AI 模型和應用程式公開基準結構定義。 |
| BigQuery | 企業資料倉儲 | 儲存、查詢及處理資料集;自動檢索、建立索引,並依業務分類面向充實這些資料表。 |
| Gemini Enterprise Agent Platform | AI 模型開發 | 建構、部署及託管基礎模型。自訂代理會擷取中繼資料脈絡,做為邏輯推論的依據。 |
| Cloud Storage | 非結構化檔案儲存空間 | 儲存原始非結構化檔案;自動執行非結構化探索掃描,剖析 PDF 和圖片,建立關係圖。 |
語意和資料格式
如要有效指示及建立代理系統,必須區分實體資料結構和語意:
- 語意。與資料相關的業務意義、意圖和關係。雖然技術結構定義會定義結構化儲存規格,例如資料庫類型、字元長度或整數限制,但語意會描述資料集實際代表的內容。舉例來說,您可以將名為
txn_qty的資料欄對應至「購買數量」的業務定義。 - 結構化資料。以定義的結構定義和關聯格式儲存的資訊。例如 BigQuery 資料表、Spanner 資料庫和作業用 Postgres 資料表。Knowledge Catalog 會自動檢索這項中繼資料,並記錄資料欄和限制。
代理式資料雲端脈絡自動化調度管理
在 Google 的代理式資料雲端架構中,Knowledge Catalog 是語意自動化調度管理層。開發人員不必手動將資料庫結構定義和規則硬式編碼至提示詞,脈絡引擎會動態提供精確的語意脈絡,讓代理做出智慧決策。
下圖顯示 Knowledge Catalog 如何自動調度及提供資料背景資訊:
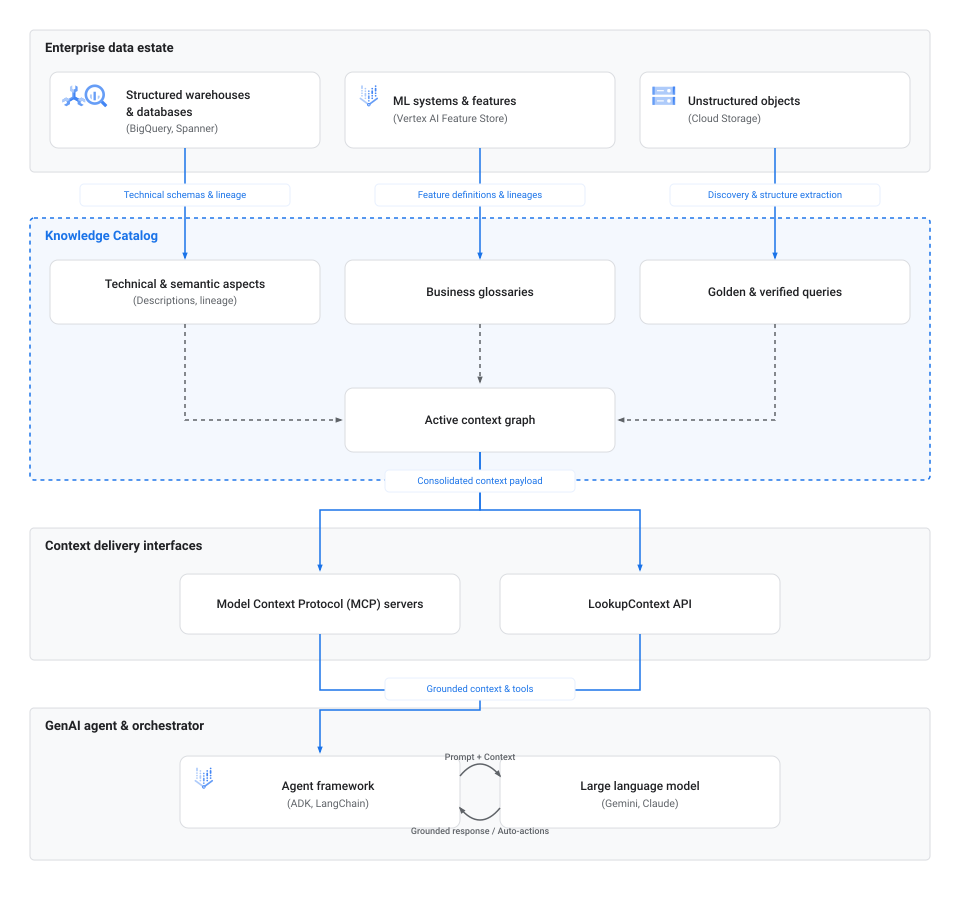
情境自動化調度管理工作流程包含下列階段:
- 擷取和探索。Spanner 和 BigQuery 等作業資料庫和資料倉儲、Cloud Storage 等非結構化物件儲存庫,以及 Lakehouse 執行階段目錄等執行階段 metastore,都會將技術結構定義、歷程圖和中繼資料定義直接饋送至 Knowledge Catalog。
- 內容對應。在 Knowledge Catalog 中,這些中繼資料屬性會連結至語意元素,包括技術層面、組織詞彙和已驗證的查詢,以組合出有效的脈絡圖。
- 提交介面。AI 應用程式和自動調度管理工具會使用標準連接器 (例如 MCP 或直接
LookupContextAPI 端點),以程式輔助方式擷取這個整合式情境圖。 - 代理建立基準。自動化調度管理框架 (例如 Agent Development Kit (ADK) 或 LangChain) 會將這類中繼資料情境直接插入 LLM 提示詞。這項注入作業會根據經過驗證的組織規則,為代理的推論奠定基礎,讓代理查詢資料庫或執行自動化動作,而不會產生幻覺。
AI 代理設定檔
您可以根據要自動執行的工作流程,建構由 Knowledge Catalog 提供技術支援的不同類別代理:
- 資料探索代理。這些助理可協助使用者搜尋及瀏覽資料資產。這類系統不會使用關鍵字比對,而是分析自然語言中的長篇意圖和限制,擷取最相關的實體資產。
- 中繼資料擴充代理。這些背景代理會從維基、README 檔案或對話記錄擷取非結構化文字,將文字剖析為正式中繼資料,並將中繼資料寫入 Knowledge Catalog 的切面,確保中繼資料保持最新狀態。
- 資料品質和管道代理。這些自主代理會評估品質規則、偵測結構定義偏移,並透過查詢資料歷程和設定檔統計資料,建構或修復資料轉換管道。
自動調度管理工具
如要建構及整合這些代理,可以使用下列工具:
- Model Context Protocol (MCP)。標準化的開放通訊協定,用於將代理連結至外部資源。您可以透過遠端 MCP 伺服器或本機 MCP 工具箱,設定代理連線至目錄。詳情請參閱「關於 Knowledge Catalog 中的 Model Context Protocol (MCP)」。
- Agent Development Kit (ADK):Google 的架構,可簡化生成式 AI 代理的建構、執行和測試作業,並提供 Catalog Service API 的內建繫結。詳情請參閱 ADK 首頁。
- LookupContext API。REST 和 gRPC API 端點,可擷取資料資產的統一 YAML 或 JSON 情境酬載,直接插入 LLM 提示。詳情請參閱「使用 LookupContext API 擷取情境」。
使用 MCP 存取情境
Model Context Protocol (MCP) 是標準化橋梁,可讓 AI 代理和工具順暢連結至 Knowledge Catalog 等資料來源。請參考下方的比較表,判斷最適合的整合方式:
| 實作 | 適用情境 | 金鑰詳細資料 | 端點或設定 |
|---|---|---|---|
| 遠端 MCP 伺服器 | 雲端優先部署、Cloud Run 等無伺服器環境,以及代管外部服務。 | 由 Google 代管的端點,不需要管理本機伺服器。 | 端點:https://dataplex.googleapis.com/mcp如要設定,請參閱「使用遠端 MCP 伺服器」。 |
| 本機 MCP 工具箱 | 本機代理開發、快速原型設計,以及 VS Code 或 Cursor 等桌面 IDE 整合。 | 指令列工具,可做為工作區環境和 Knowledge Catalog 之間的本機 Proxy。 | 必須安裝二進位檔並調整 .mcp.json 設定。如要設定,請參閱「使用本機 MCP 伺服器」。 |
代理資料情境的最佳做法
為打造可靠的代理服務,在 Knowledge Catalog 整理及查詢中繼資料時,請務必遵循下列最佳做法:
- 新增切面。AI 代理無法單憑名稱區分正式版資料表和臨時沙箱模擬。定義並套用自訂信任信號,認證權威資料產品,確保代理優先處理或限制對這些資源的查詢。
- 使用情境預算最佳化查詢。呼叫
LookupContextAPI 時,請指定context_budget參數。API 會在指定的權杖限制內,優先最佳化及調整最重要的中繼資料,例如歷程和主要說明。 - 提供相關資源,公開彙整路徑。在情境查詢中,最多可列出 10 個相關資料表或資產。提供一組資產後,情境引擎會自動填入彙整路徑和關係,協助代理瞭解資料表的介面。
- 建構語意詞彙表。在組織詞彙中標準化字詞和縮寫。這項標準化作業有助於對話式工具準確解析業務專屬的同義詞和指標。
- 發布精確查詢。直接將經過驗證的自然語言查詢和正確的 SQL 對應項目,附加至 Knowledge Catalog 項目。將推論依據建立在這些經過驗證的範本上,即可避免文字轉 SQL 代理發生 SQL 轉換錯誤。
從 Dataplex Universal Catalog 升級至 Knowledge Catalog
Dataplex Universal Catalog 已升級為 Knowledge Catalog。如要進一步瞭解這項轉換作業,請參閱「從 Dataplex Universal Catalog 升級至 Knowledge Catalog」。
限制
規劃部署作業時,請考量下列限制:
支援的整合功能。雖然 Knowledge Catalog 支援主要的第三方系統,但某些自動語意擷取功能可能僅限於內建的 Google Cloud 服務。
配額限制。內容擷取和中繼資料擷取作業適用標準 Google Cloud API 配額。
安全範圍。建立資源前,您必須手動建立 VPC Service Controls 安全範圍。否則資源不會受到 perimeter 保護。詳情請參閱「搭配使用 VPC Service Controls 與 Knowledge Catalog」。