


本頁提供指南,說明建構及執行 Dataflow HPC 高度平行工作流程時應遵循的最佳做法,包括如何在管道中使用外部程式碼、如何執行管道,以及如何管理錯誤處理。
在管道中加入外部程式碼
高度平行管道的主要差異在於,這類管道會在 DoFn 中使用 C++ 程式碼,而不是標準 Apache Beam SDK 語言。如果是 Java 管道,建議您使用外部程序呼叫,方便在管道中使用 C++ 程式庫。本節說明在 Java 管道中執行外部 (C++) 程式碼的一般方法。
Apache Beam pipeline 定義包含幾個重要元件:
PCollections是同質元素的不可變動集合。PTransforms用於定義PCollection的轉換,產生另一個PCollection。- 管道是一種建構體,可讓您透過程式碼宣告
PTransforms和PCollections之間的互動。管道會以有向無環圖 (DAG) 表示。
如果使用的程式碼語言不是標準 Apache Beam SDK 語言,請將程式碼放在 DoFn 內的 PTransform 中,並使用其中一種標準 SDK 語言定義管道本身。建議使用 Apache Beam Python SDK 定義管道,因為 Python SDK 具有實用程式類別,可簡化其他程式碼的使用方式。不過,您可以使用其他 Apache Beam SDK。
您可以先使用上述程式碼立即進行實驗,不需從無到有建構程式。在實際運作系統中,通常會建立自己開發的二進位檔,讓您可以視自己的需要自由調整處理邏輯。
下列圖表說明了管道資料的兩種用法:
- 資料用以驅動程序。
- 在程序進行的過程以及與驅動程式資料彙整時取得資料。
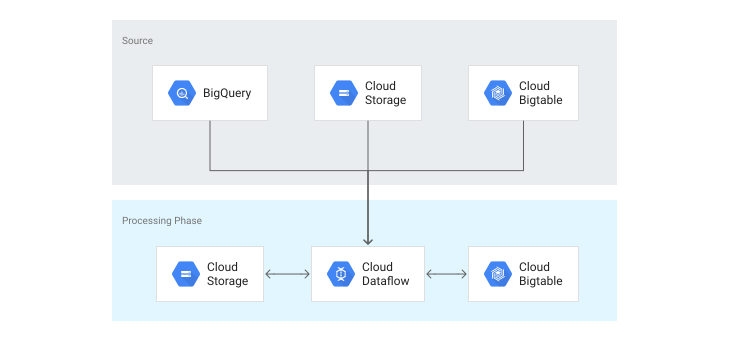
在本頁面中,主要資料 (來自來源) 稱為「駕駛資料」,次要資料 (來自處理階段) 稱為「聯結資料」。
以金融業為例,驅動資料可能包含數十萬筆交易。每筆交易都必須與市場資料一併處理。在這種情況下,市場資料就是彙整資料。在媒體用途中,驅動資料可能是需要處理但不需要其他資料來源的圖片檔案,因此不會使用聯結資料。
驅動資料大小的考慮因素
如果驅動資料元素的大小在低百萬位元組範圍內,請使用一般的 Apache Beam 範例,從來源建立 PCollection 物件,並將該物件傳送至 Apache Beam 轉換進行處理。
如果驅動資料元件大小落在高 MB 量或甚至 GB 量級,通常是媒體類的資料,您可將此驅動資料存入 Cloud Storage。接著,在起始 PCollection 物件中參照儲存空間 URI,系統只會使用該資料的 URI 參照。
彙整資料大小的考慮因素
如果要加入的資料大小為幾百 MB 以下,請使用側邊輸入,將資料傳送至 Apache Beam 轉換。側邊輸入會將資料封包傳送給每個需要資料的 worker。
如果要聯結的資料大小在 GB 或 TB 範圍內,請視資料性質,使用 Bigtable 或 Cloud Storage 將要聯結的資料合併至主導資料。Bigtable 非常適合金融情境,因為市場資料通常會以鍵值查詢的形式從 Bigtable 存取。如要進一步瞭解如何設計 Bigtable 結構定義,包括處理時間序列資料的建議,請參閱下列 Bigtable 說明文件:
執行外部程式碼
您可以使用多種方式在 Apache Beam 中執行外部程式碼。
在 Dataflow 轉換中,從
DoFn物件內呼叫的程序。搭配 Java SDK 使用 JNI。
直接從
DoFn物件建立子程序。雖然這種做法並非最有效率,但實用且容易導入。由於使用 JNI 可能會發生問題,因此本頁面會示範如何使用子程序呼叫。
設計工作流程時,請考量完整的端對端管道。由於資料從來源到接收器都是透過單一管道移動,因此可抵銷程序執行方式的任何效率不彰之處。如要比較這種方法與其他方法,請查看管道的端對端時間和端對端成本。
將二進位檔拉到主機
使用支援的 Apache Beam 語言時,Apache Beam SDK 會自動將所有必要程式碼移至 Worker。不過,如果您要呼叫外部程式碼,就必須手動移動程式碼。
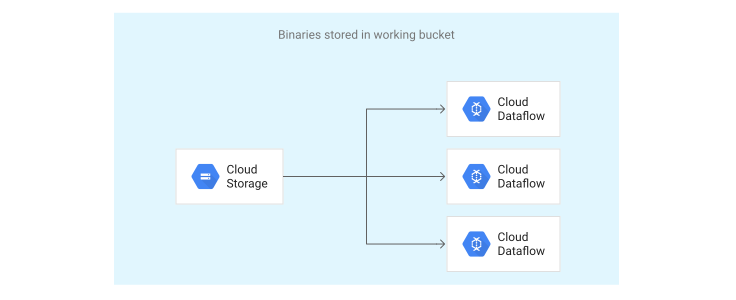
如要移動程式碼,請按照下列步驟操作。這個範例會示範 Apache Beam Java SDK 的步驟。
- 將已編譯的外部程式碼以及版本訊息儲存在 Cloud Storage 中。
- 在
@Setup方法中,建立同步區塊,檢查程式碼檔案是否位於本機資源。第一個執行緒結束時,您可以使用一個靜態變數來確認可用性,而非實作實際檢查。 - 如果檔案無法使用,請使用 Cloud Storage 用戶端程式庫,將檔案從 Cloud Storage bucket 提取至本機工作站。建議使用 Apache Beam
FileSystems類別執行這項工作。 - 檔案移動後,確認程式碼檔案上的執行位元已被設定。
- 在實際運作系統中,檢查二進位檔的雜湊碼,確保已正確複製檔案。
您也可以使用 Apache Beam filesToStage 函式,但這樣會失去部分優勢,例如無法自動封裝及移動 Java 程式碼。此外,由於對子程序的呼叫需要絕對檔案位置,因此您需要使用程式碼判斷類別路徑,進而判斷 filesToStage 移動的檔案位置。我們不建議採用這種做法。
執行外部二進位檔
在您執行外部程式碼前,您必須先為其建構一個包裝函式。以與外部程式碼相同的語言 (例如 C++) 或以殼層指令碼撰寫這個包裝函式。您可以透過包裝函式傳遞檔案控制代碼,並實作最佳化作業,如本頁的「設計小型 CPU 週期處理程序」一節所述。包裝不必太精緻,底下的程式碼片段概略呈現了用 C++ 所寫的包裝函式。
int main(int argc, char* argv[])
{
    if(argc < 3){
        std::cerr << "Required return file and data to process" << '\n';
        return 1;
    }

    std::string returnFile = argv[1];
    std::string word = argv[2];

    std::ofstream myfile;
    myfile.open (returnFile);
    myfile << word;
    myfile.close();
    return 0;
}
此程式碼從傳入引數清單中讀取兩個參數值。第一個參數是資料推送的傳回檔案位置。第二個參數是程式碼回傳給使用者的資料。在實際的實作中,這段程式碼的功能不只是回應「Hello, world」!
撰寫包裝函式程式碼後,請執行下列步驟來執行外部程式碼:
- 將資料傳送給外部程式碼的二進位檔。
- 執行二進位檔、擷取任何錯誤,並記錄錯誤和結果。
- 處理記錄資訊。
- 取得處理完成後得到的資料。
將資料傳輸至二進位檔
如要開始執行程式庫,請將資料傳輸至 C++ 程式碼。 您可以在這個步驟中,利用 Dataflow 與其他 Google Cloud 工具的整合功能。Bigtable 等工具可處理非常大的資料集,並處理低延遲和高並行存取作業,讓數千個核心同時存取資料集。此外,Bigtable 還能預先處理資料,進行資料塑形、擴充及篩選。您可以在執行外部程式碼前,透過 Apache Beam 轉換完成所有這些工作。
在正式版系統中,建議使用通訊協定緩衝區封裝輸入資料。您可以先將輸入資料轉換為位元組,並進行 base64 編碼,再傳遞至外部程式庫。將這項資料傳遞至外部程式庫的方式有兩種:
- 小型輸入資料:如果資料量不大,且不超過系統為指令引數設定的最大長度,請在以
java.lang.ProcessBuilder建構的程序中,將引數傳遞至位置 2。 - 大型輸入資料:如果資料量較大,請建立名稱包含 UUID 的檔案,以便存放程序所需的資料。
執行 C++ 程式碼、擷取錯誤並記錄
擷取及處理錯誤資訊是管道的重要環節。Dataflow 執行器使用的資源是暫時性的,因此通常很難檢查工作站記錄檔。請務必擷取所有實用資訊並推送至 Dataflow 執行器記錄,且將記錄資料儲存在一或多個 Cloud Storage bucket 中。
建議您將 stdout 和 stderr 重新導向至檔案,這樣就不必考慮記憶體不足的問題。舉例來說,在呼叫 C++ 程式碼的 Dataflow 執行器中,您可以加入下列程式碼行:
Java
  import java.lang.ProcessBuilder.Redirect;
  ...
      processbuilder.redirectError(Redirect.appendTo(errfile));
      processbuilder.redirectOutput(Redirect.appendTo(outFile));
Python
# Requires Apache Beam 2.34 or later.
stopping_times, bad_values = (
    integers
    | beam.Map(collatz.total_stopping_time).with_exception_handling(
        use_subprocess=True))

# Write the bad values to a side channel.
bad_values | 'WriteBadValues' >> beam.io.WriteToText(
    os.path.splitext(output_path)[0] + '-bad.txt')
處理記錄資訊
有許多用途都會處理上百萬個元素。程序執行成功通常只會產生少量記錄,或甚至不會產生記錄,因此您必須做出關於保留記錄資料的業務決策。舉例來說,您可以考慮採用下列替代方案,不必保留所有記錄資料:
- 如果記錄中來自執行成功的訊息沒有價值,那就不必保留。
- 建立對記錄資料的取樣機制,比如每一萬筆記錄項目時取樣一次。如果處理作業是同質的,例如程式碼的許多疊代作業基本上會產生相同的記錄資料,這個方法就能有效平衡記錄資料的保留和處理作業的最佳化。
如果發生失敗情況,傾印至記錄檔的資料量可能會很大。處理大量錯誤記錄資料的有效策略是讀取記錄項目的前幾行,然後只將這些行推送至 Cloud Logging。您可以將其餘記錄檔載入 Cloud Storage bucket。 這樣一來,您稍後就能查看錯誤記錄檔的第一行,並視需要從 Cloud Storage 參照整個檔案。
檢查記錄檔大小也很有用。如果檔案大小為零,可以放心忽略,或記錄檔案沒有資料的記錄訊息。
擷取已完成處理的資料
不建議使用 stdout 將運算結果傳回 DoFn 函式。C++ 程式碼呼叫的其他程式碼,甚至是您自己的程式碼,也可能會將訊息傳送至 stdout,進而汙染原本包含記錄資料的 stdoutput 串流。建議您變更 C++ 包裝函式程式碼,讓程式碼接受參數,指出要建立儲存值的檔案位置。理想情況下,這個檔案應使用通訊協定緩衝區以語言中立的方式儲存,這樣 C++ 程式碼就能將物件傳回 Java 或 Python 程式碼。DoFn 物件可以直接從檔案讀取結果,並將結果資訊傳遞至自己的 output 呼叫。
經驗顯示,執行處理程序本身的單元測試非常重要。請務必導入單元測試,獨立於 Dataflow 管道執行程序。如果程式庫的除錯能獨立運作且不需執行整個管道的話,會非常有效率。
為小型 CPU 週期設計處理程序
呼叫子程序會產生額外負擔。視工作負載而定,您可能需要額外作業,才能減少正在執行的工作與啟動和關閉程序管理負擔之間的比例。
在媒體用途中,驅動資料元素的大小可能達到數百萬位元組或數十億位元組。因此,處理每個資料元素可能需要數分鐘。在這種情況下,與整體處理時間相比,呼叫子程序的成本微不足道。這種情況最好的處理方式,就是讓單一元素啟動自己所屬的程序。
不過,在其他用途 (例如金融) 中,處理作業只需要極少的 CPU 時間 (數十毫秒)。這種情形下,呼叫子程序的負擔就不成比例的高了。解決這個問題的方法是使用 Apache Beam 的 GroupByKey 轉換,建立 50 到 100 個元素之間的批次,然後饋送至程序。舉例來說,您可以按照下列步驟操作:
- 在
DoFn函式中建立鍵/值組合。如果您處理的是金融類的交易資訊,可以用交易序號作為鍵值。如果沒有可做為鍵的專屬號碼,可以從資料產生檢查碼,並使用模數函式建立 50 個元素的分割區。 - 將鍵傳送至
GroupByKey.create函式,該函式會傳回包含 50 個元素的KV<key,Iterable<data>>集合,然後您就可以將這些元素傳送至程序。
限制 worker 平行處理量
使用 Dataflow 執行器原生支援的語言時,您完全不必擔心工作站發生什麼事。Dataflow 有許多程序,可監控批次或串流模式中的流量控制和執行緒。
不過,如果您使用 C++ 等外部語言,請注意,啟動子程序是稍微不尋常的做法。在批次模式中,相較於串流模式,Dataflow 執行器使用的 CPU 工作執行緒比例較小。建議您在類別中建立信號,更直接地控制個別工作人員的平行處理作業,特別是在串流模式下。
舉例來說,在處理媒體檔時,您不會想看到上百個轉碼元素在單一工作站裡並行處理。在這種情況下,您可以建立公用程式類別,為執行的工作提供 DoFn 函式的許可。使用這個類別,即可直接控制管道中的工作執行緒。
在 Google Cloud中使用高容量資料接收器
資料處理完成後會傳送到資料接收器,此接收器必須能夠處理您的網格運算方案所產生的資料量。
下圖顯示 Dataflow 執行格線工作負載時, Google Cloud 中可用的部分接收器。
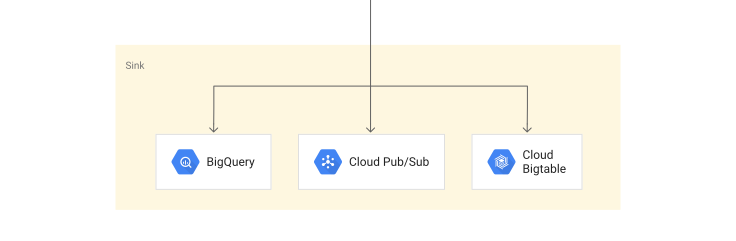
Bigtable、BigQuery 和 Pub/Sub 都能處理大量資料串流。舉例來說,每個 Bigtable 節點每秒可處理 10,000 次插入作業,大小最多 1K,並具備水平擴充性。因此,100 節點的 Bigtable 叢集每秒可吸收 Dataflow 格線產生的 1,000,000 則訊息。
管理記憶體區段錯誤
在管道中使用 C++ 程式碼時,您需要決定如何管理區段錯誤,因為如果處理不當,這些錯誤會造成非本機的影響。Dataflow 執行器會視需要在 Java、Python 或 Go 中建立程序,然後以套裝組合的形式將工作指派給程序。
如果使用緊密耦合的工具 (例如 JNI 或 Cython) 呼叫 C++ 程式碼,且 C++ 程序發生區段錯誤,呼叫程序和 Java 虛擬機器 (JVM) 也會當機。在此情境中,系統無法偵測到不良資料點。如要讓系統能偵測到不良資料點,請使用較鬆散的耦合,將不良資料分支出去,讓管道繼續運作。不過,如果 C++ 程式碼已臻成熟,且已針對所有資料變化完成全面測試,您可以使用 Cython 等機制。
後續步驟
請按照教學課程的說明,建立使用 C++ 程式庫搭配自訂容器的管道。
如要查看本頁面的範例程式碼,請前往 Apache Beam GitHub 存放區。
進一步瞭解如何使用 Apache Beam 建構管道。