


Esta página descreve como executar um pipeline no Cloud Data Fusion em relação a um cluster do Dataproc existente.
Por predefinição, o Cloud Data Fusion cria clusters efémeros para cada pipeline: cria um cluster no início da execução do pipeline e, em seguida, elimina-o após a conclusão da execução do pipeline. Embora este comportamento poupe custos, garantindo que os recursos só são criados quando necessário, este comportamento predefinido pode não ser desejável nos seguintes cenários:
Se o tempo necessário para criar um novo cluster para cada pipeline for proibitivo para o seu exemplo de utilização.
Se a sua organização exigir que a criação de clusters seja gerida centralmente; por exemplo, quando quer aplicar determinadas políticas a todos os clusters do Dataproc.
Para estes cenários, em vez disso, execute pipelines num cluster existente com os seguintes passos.
Antes de começar
Precisa do seguinte:
Uma instância do Cloud Data Fusion.
Um cluster do Dataproc existente.
Se executar os seus pipelines na versão 6.2 do Cloud Data Fusion, use uma imagem do Dataproc mais antiga que seja executada com o Hadoop 2.x (por exemplo, 1.5-debian10) ou atualize para a versão mais recente do Cloud Data Fusion.
Efetue a associação ao cluster existente
Nas versões 6.2.1 e posteriores do Cloud Data Fusion, pode estabelecer ligação a um cluster do Dataproc existente quando cria um novo perfil do Compute Engine.
Aceda à sua instância:
In the Google Cloud console, go to the Cloud Data Fusion page.
To open the instance in the Cloud Data Fusion Studio, click Instances, and then click View instance.
Clique em Administrador do sistema.
Clique no separador Configuração.
Clique em Perfis de computação do sistema.
Clique em Criar um novo perfil. É aberta uma página de aprovisionadores.
Clique em Dataproc existente.
Introduza as informações do perfil, do cluster e de monitorização.
Clique em Criar.
Configure o seu pipeline para usar o perfil personalizado
Aceda à sua instância:
In the Google Cloud console, go to the Cloud Data Fusion page.
To open the instance in the Cloud Data Fusion Studio, click Instances, and then click View instance.
Aceda à sua pipeline na página Studio.
Clique em Configurar.
Clique em Compute config.
Clique no perfil que criou.
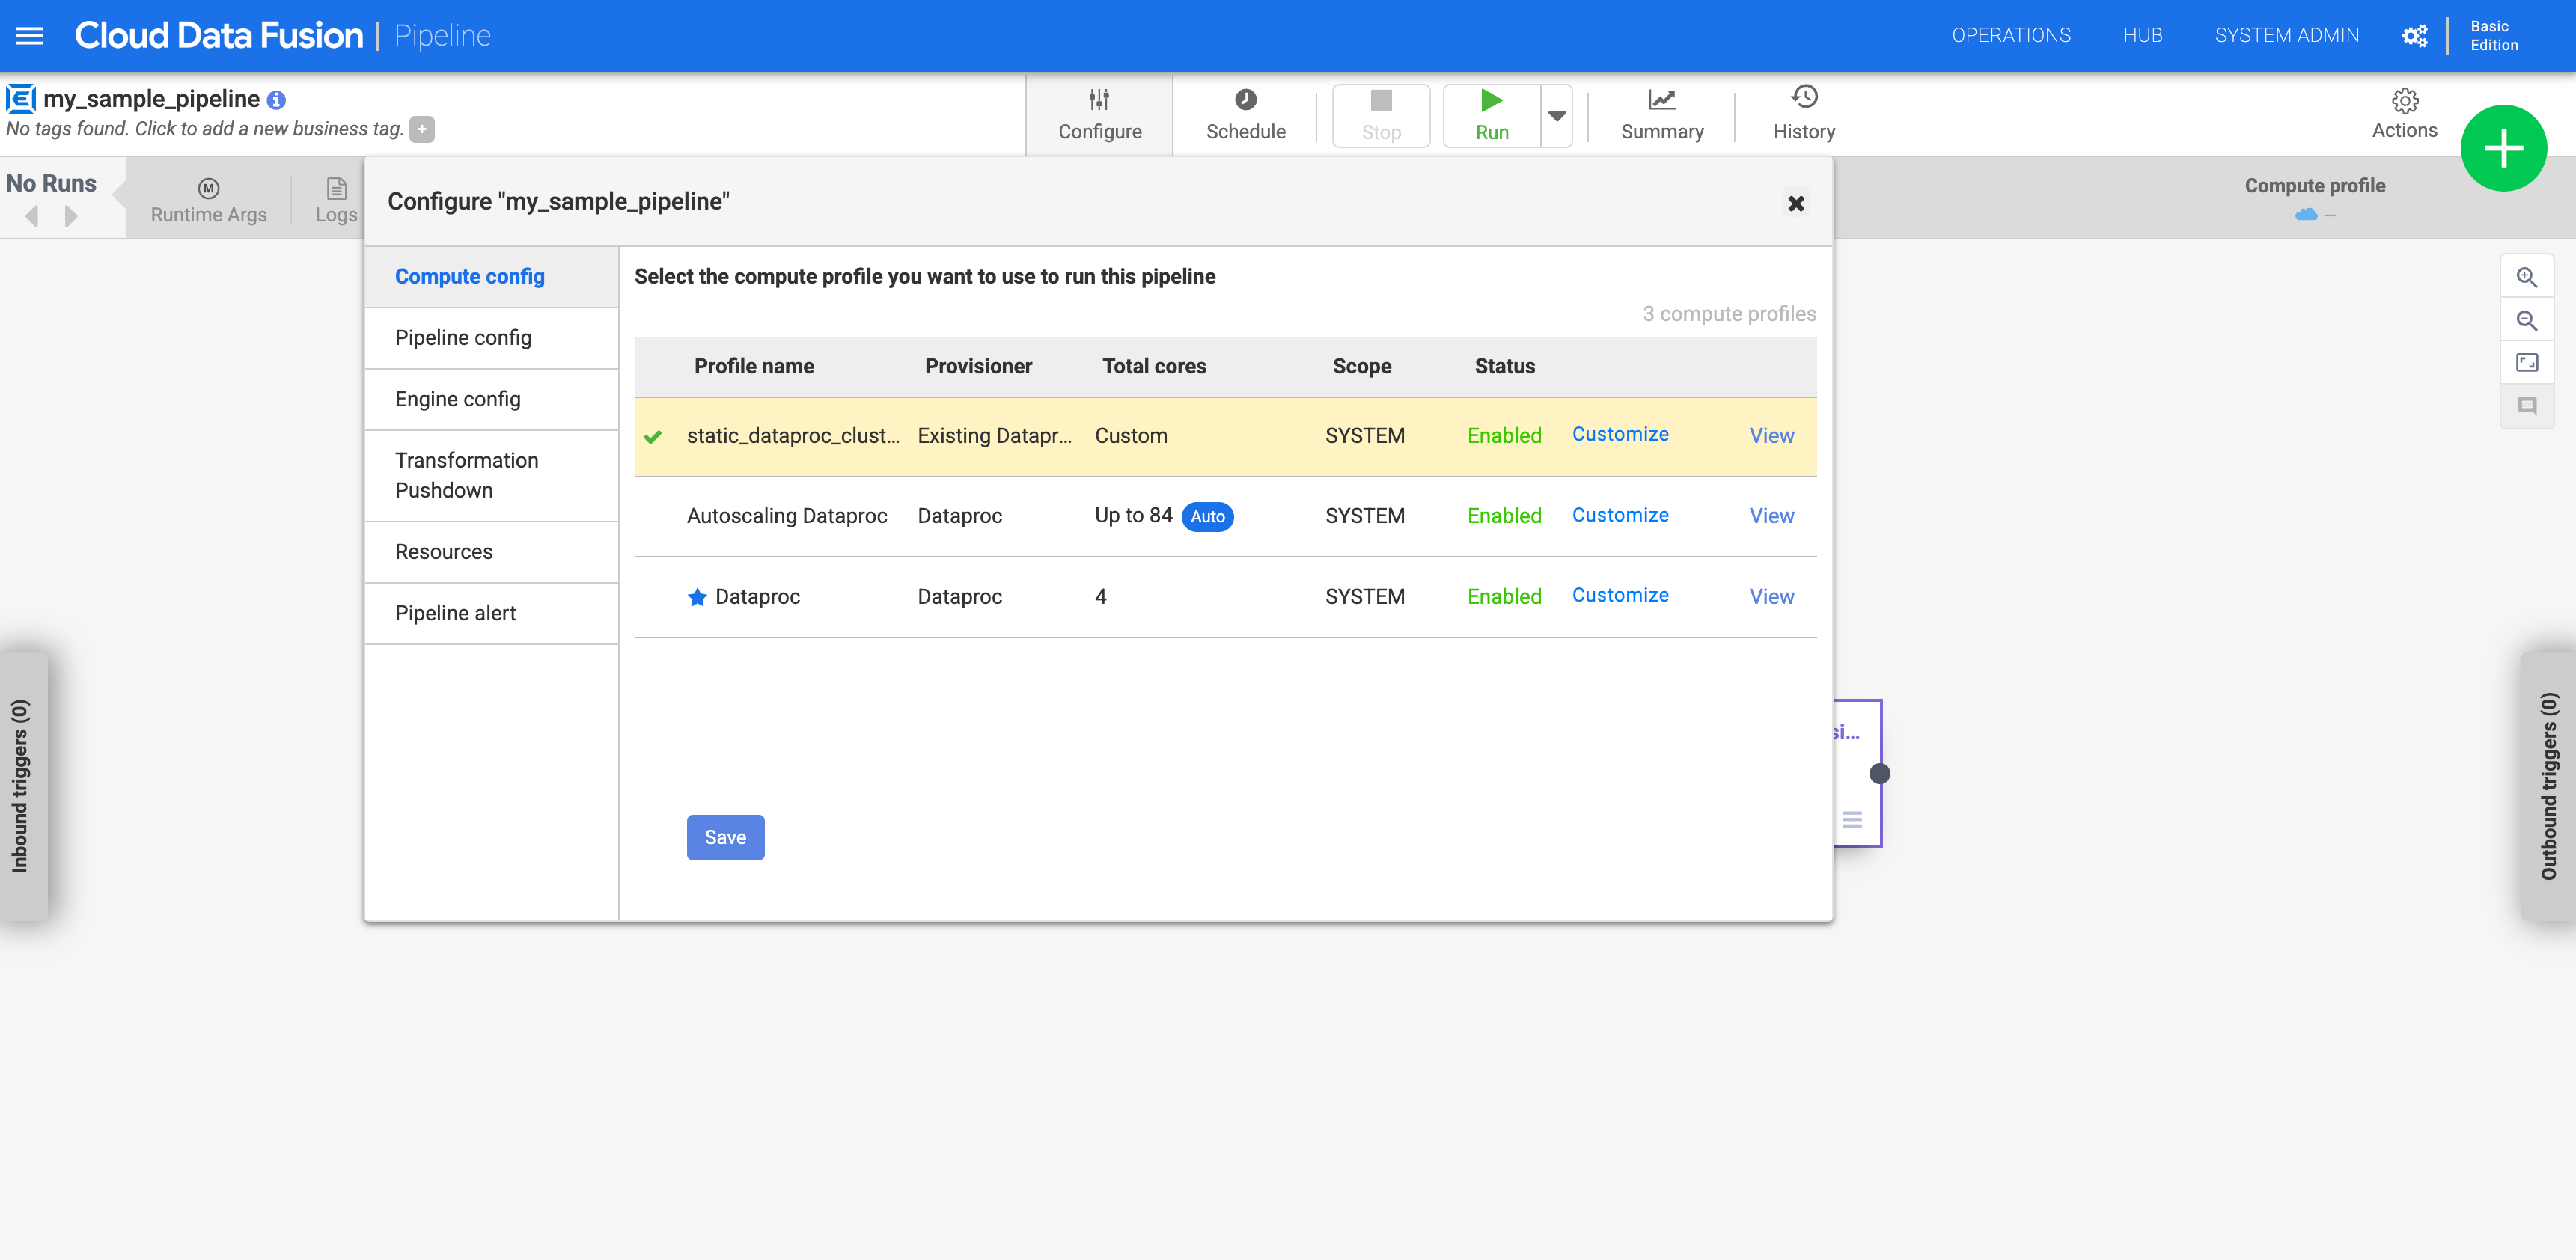
Figura 1: clique no perfil personalizado Execute a conduta. É executado no cluster do Dataproc existente.
O que se segue?
- Saiba mais sobre a configuração de clusters.
- Resolva problemas de eliminação de clusters.