


Auf dieser Seite wird beschrieben, wie Sie mit der Quelle Multi Table (Mehrere Tabellen) mehrere Tabellen aus einer Microsoft SQL Server-Datenbank lesen. Verwenden Sie die Quelle für mehrere Tabellen, wenn Ihre Pipeline aus mehreren Tabellen lesen soll. Wenn Ihre Pipeline Daten aus einer einzelnen Tabelle lesen soll, lesen Sie den Abschnitt Aus einer SQL Server-Tabelle lesen.
Die Multi-Table-Quelle gibt Daten mit mehreren Schemas aus und enthält ein Feld für den Tabellennamen, das angibt, aus welcher Tabelle die Daten stammen. Wenn Sie die Quelle „Mehrere Tabellen“ verwenden, nutzen Sie eine der Senken für mehrere Tabellen: BigQuery-Tabelle oder GCS-Datei.
Hinweis
- Melden Sie sich in Ihrem Google Cloud -Konto an. Wenn Sie mit Google Cloudnoch nicht vertraut sind, erstellen Sie ein Konto, um die Leistungsfähigkeit unserer Produkte in der Praxis sehen und bewerten zu können. Neukunden erhalten außerdem ein Guthaben von 300 $, um Arbeitslasten auszuführen, zu testen und bereitzustellen.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
Verify that billing is enabled for your Google Cloud project.
Aktivieren Sie die Cloud Data Fusion API, die Cloud Storage API, die BigQuery API und die Dataproc API, falls sie noch nicht aktiviert sind.
Rollen, die zum Aktivieren von APIs erforderlich sind
Zum Aktivieren von APIs benötigen Sie die Berechtigung
serviceusage.services.enable. Wenn Sie das Projekt erstellt haben, haben Sie diese Berechtigung wahrscheinlich bereits über die Rolle „Inhaber“ (roles/owner). Andernfalls können Sie diese Berechtigung über die Rolle „Service Usage-Administrator“ (roles/serviceusage.serviceUsageAdmin) erhalten. Informationen zum Zuweisen von Rollen- Erstellen Sie eine Cloud Data Fusion-Instanz.
- Prüfen Sie, ob Ihre SQL Server-Datenbank Verbindungen von Cloud Data Fusion akzeptieren kann. Daher empfehlen wir Ihnen, eine private Cloud Data Fusion-Instanz zu erstellen.
Cloud Data Fusion-Instanz ansehen
Wenn Sie mit Cloud Data Fusion arbeiten, verwenden Sie sowohl die Google Cloud Console als auch die separate Benutzeroberfläche von Cloud Data Fusion. In der Google Cloud Console können Sie ein Google Cloud Projekt erstellen sowie Cloud Data Fusion-Instanzen erstellen und löschen. In der Benutzeroberfläche von Cloud Data Fusion können Sie die verschiedenen Seiten wie Studio oder Wrangler nutzen, um Features von Cloud Data Fusion zu nutzen.
Rufen Sie in der Google Cloud Console die Seite „Cloud Data Fusion“ auf.
Wenn Sie die Instanz in Cloud Data Fusion Studio öffnen möchten, klicken Sie auf Instanzen und dann auf Instanz anzeigen.
SQL Server-Passwort als sicheren Schlüssel speichern
Fügen Sie Ihr SQL Server-Passwort als sicheren Schlüssel hinzu, um Ihre Cloud Data Fusion-Instanz zu verschlüsseln. Später in diesem Leitfaden sorgen Sie dafür, dass Ihr Passwort mit Cloud KMS abgerufen wird.
Klicken Sie rechts oben auf einer beliebigen Seite von Cloud Data Fusion auf Systemadministrator.
Klicken Sie auf den Tab Configuration (Konfiguration).
Klicken Sie auf HTTP-Aufrufe ausführen.
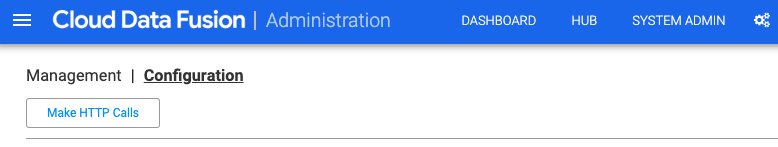
Wählen Sie im Drop-down-Menü PUT aus.
Geben Sie im Feld Pfad
namespaces/NAMESPACE_ID/securekeys/PASSWORDein.Geben Sie im Feld Body den Wert
{"data":"SQL_SERVER_PASSWORD"}ein.Klicken Sie auf Senden.

Achten Sie darauf, dass die Antwort, die Sie erhalten, der Statuscode 200 ist.
JDBC-Treiber für SQL Server abrufen
Hub verwenden
Klicken Sie in der Cloud Data Fusion-Benutzeroberfläche auf Hub.
Geben Sie in der Suchleiste
Microsoft SQL Server JDBC Driverein.Klicken Sie auf Microsoft SQL Server JDBC-Treiber.
Klicken Sie auf Herunterladen. Folgen Sie der Anleitung zum Herunterladen.
Klicken Sie auf Bereitstellen. Laden Sie die JAR-Datei aus dem vorherigen Schritt hoch.
Klicken Sie auf Beenden.
Studio verwenden
Rufen Sie Microsoft.com auf.
Wählen Sie einen Download aus und klicken Sie auf Herunterladen.
Klicken Sie in der Cloud Data Fusion-UI auf das Menü und rufen Sie die Seite Studio auf.
Klicken Sie auf Hinzufügen.
Klicken Sie unter Treiber auf Hochladen.
Laden Sie die in Schritt 2 heruntergeladene JAR-Datei hoch.
Klicken Sie auf Weiter.
Konfigurieren Sie den Treiber, indem Sie einen Namen eingeben.
Geben Sie im Feld Klassenname
com.microsoft.sqlserver.jdbc.SQLServerDriverein.Klicken Sie auf Beenden.
Multiple Table-Plug-ins bereitstellen
Klicken Sie in der Web-UI von Cloud Data Fusion auf Hub.
Geben Sie in der Suchleiste
Multiple table pluginsein.Klicken Sie auf Multiple Table-Plug-ins.
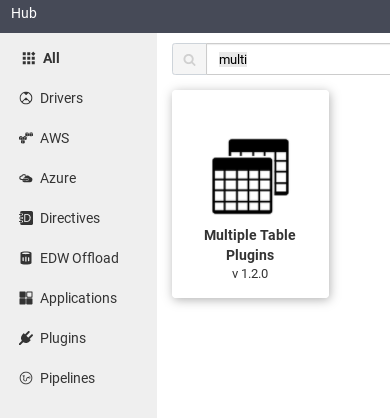
Klicken Sie auf Deploy.
Klicken Sie auf Beenden.
Klicken Sie auf Pipeline erstellen.
Mit SQL Server verbinden
Klicken Sie in der Cloud Data Fusion-UI auf das Menü und rufen Sie die Seite Studio auf.
Maximieren Sie in Studio das Menü Quelle.
Klicken Sie auf Multiple Database Tables.
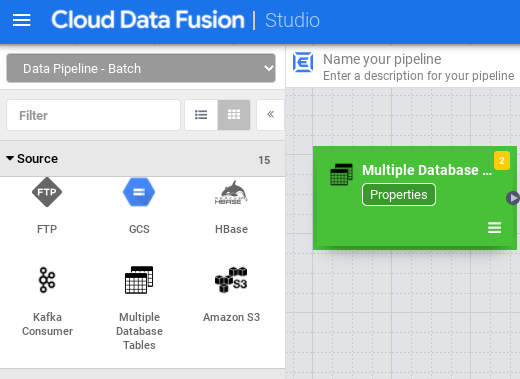
Bewegen Sie den Mauszeiger auf den Knoten Multiple Database Tables und klicken Sie auf Properties.
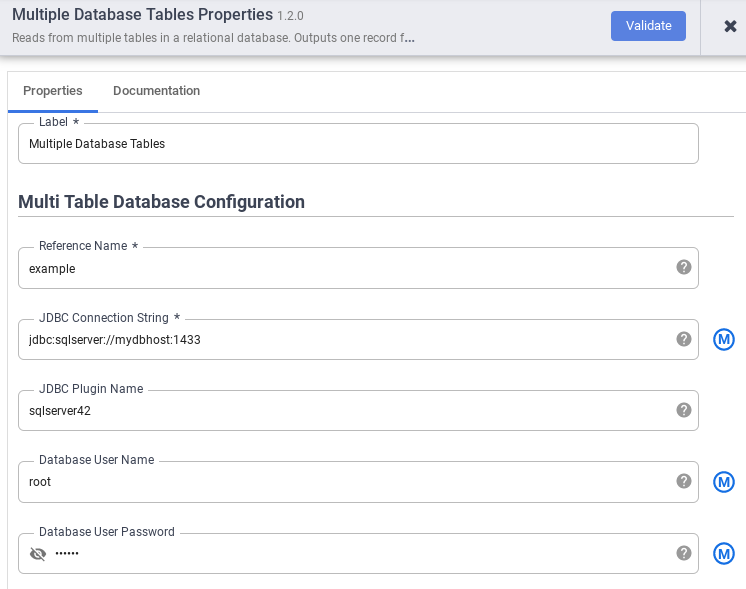
Geben Sie im Feld Referenzname einen Referenznamen an, der zur Identifizierung Ihrer SQL Server-Quelle verwendet wird.
Geben Sie im Feld JDBC-Verbindungsstring den JDBC-Verbindungsstring ein. Beispiel:
jdbc:sqlserver://mydbhost:1433. Weitere Informationen finden Sie unter Verbindungs-URL erstellen.Geben Sie den Name des JDBC-Plug-ins, den Datenbanknutzername und das Datenbanknutzerpasswort ein.
Klicken Sie auf Validieren.
Klicken Sie auf Schließen.
Verbindung zu BigQuery oder Cloud Storage herstellen
Klicken Sie in der Cloud Data Fusion-UI auf das Menü und rufen Sie die Seite Studio auf.
Maximieren Sie Sink.
Klicken Sie auf BigQuery Multi Table (BigQuery-Tabelle mit mehreren Tabellen) oder GCS Multi File (GCS-Datei mit mehreren Dateien).
Verbinden Sie den Knoten Multiple Database Tables mit BigQuery Multi Table oder GCS Multi File.
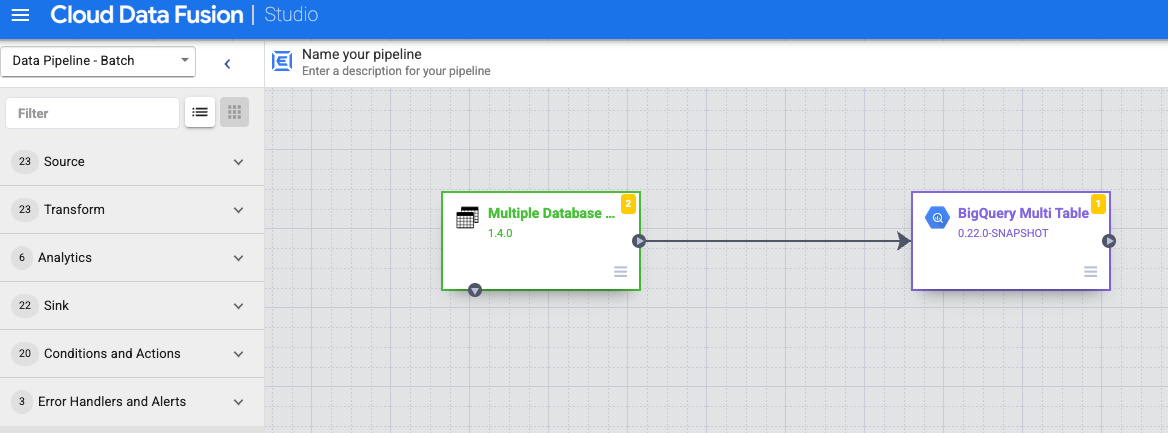
Bewegen Sie den Mauszeiger auf den Knoten BigQuery Multi Table (BigQuery-Tabelle mit mehreren Tabellen) oder GCS Multi File (GCS-Datei mit mehreren Dateien), klicken Sie auf Properties (Attribute) und konfigurieren Sie die Senke.
Weitere Informationen finden Sie unter Google BigQuery Multi Table Sink und Google Cloud Storage Multi File Sink.
Klicken Sie auf Validieren.
Klicken Sie auf Schließen.
Vorschau der Pipeline ausführen
Klicken Sie in der Cloud Data Fusion-UI auf das Menü und rufen Sie die Seite Studio auf.
Klicken Sie auf Vorschau.
Klicken Sie auf Ausführen. Warten Sie, bis die Vorschau erfolgreich abgeschlossen ist.
Stellen Sie die Pipeline bereit.
Klicken Sie in der Cloud Data Fusion-UI auf das Menü und rufen Sie die Seite Studio auf.
Klicken Sie auf Bereitstellen.
Pipeline ausführen
Klicken Sie in der Cloud Data Fusion-Benutzeroberfläche auf Menü.
Klicken Sie auf Liste.
Klicken Sie auf die Pipeline.
Klicken Sie auf der Seite mit den Pipelinedetails auf Ausführen.
Nächste Schritte
- Weitere Informationen zu Cloud Data Fusion
- Folgen Sie einer der Anleitungen.