


Protobuf-Schemas erstellen und verwalten
In diesem Dokument wird beschrieben, wie Sie Schemabündel erstellen und Vorgänge für sie ausführen.
In Bigtable können Sie Protocol Buffer-Schemas (Protobuf) verwenden, um einzelne Felder in Protobuf-Nachrichten abzufragen, die als Byte in Ihren Spalten gespeichert sind. Dazu laden Sie Ihre Schemas in einem Schemabundle hoch. Das ist eine Ressource auf Tabellenebene, die ein oder mehrere Ihrer Protobuf-Schemas enthält.
Die Verwendung von Schemabündeln bietet folgende Vorteile:
- Spart Zeit und Aufwand: Mit Protocol Buffers definieren Sie Ihre Datenstruktur einmal in einer Proto-Datei und verwenden dann den generierten Quellcode, um Ihre Daten zu schreiben und zu lesen.
- Verbessert die Datenkonsistenz: Wenn Sie eine Protobuf-Datei als einzige Quelle der Wahrheit verwenden, können Sie dafür sorgen, dass alle Anwendungen und Dienste dasselbe Datenmodell verwenden.
- Eliminiert Datenduplizierung: Sie können Protokollpuffer projektübergreifend verwenden, indem Sie Nachrichtentypen in Proto-Dateien definieren, die sich außerhalb der Codebasis eines bestimmten Projekts befinden.
Die Verwendung von Schemas in Bigtable beginnt mit Ihren Protobuf-Dateien. Eine Proto-Datei ist eine Textdatei, in der Sie die Struktur Ihrer Daten definieren. Mit dem Protobuf-Compiler-Tool, auch protoc genannt, generieren Sie einen Protobuf-Dateideskriptorsatz, ein maschinenlesbares Schema Ihrer Proto-Datei. Anschließend erstellen Sie mit diesem Deskriptorsatz ein Schemabundle.
Beispiele für Protobuf-Dateien und die entsprechenden Deskriptorsätze finden Sie unter Beispieldaten.
Das folgende Diagramm zeigt den Prozess der Verwendung von Schemas in Bigtable:
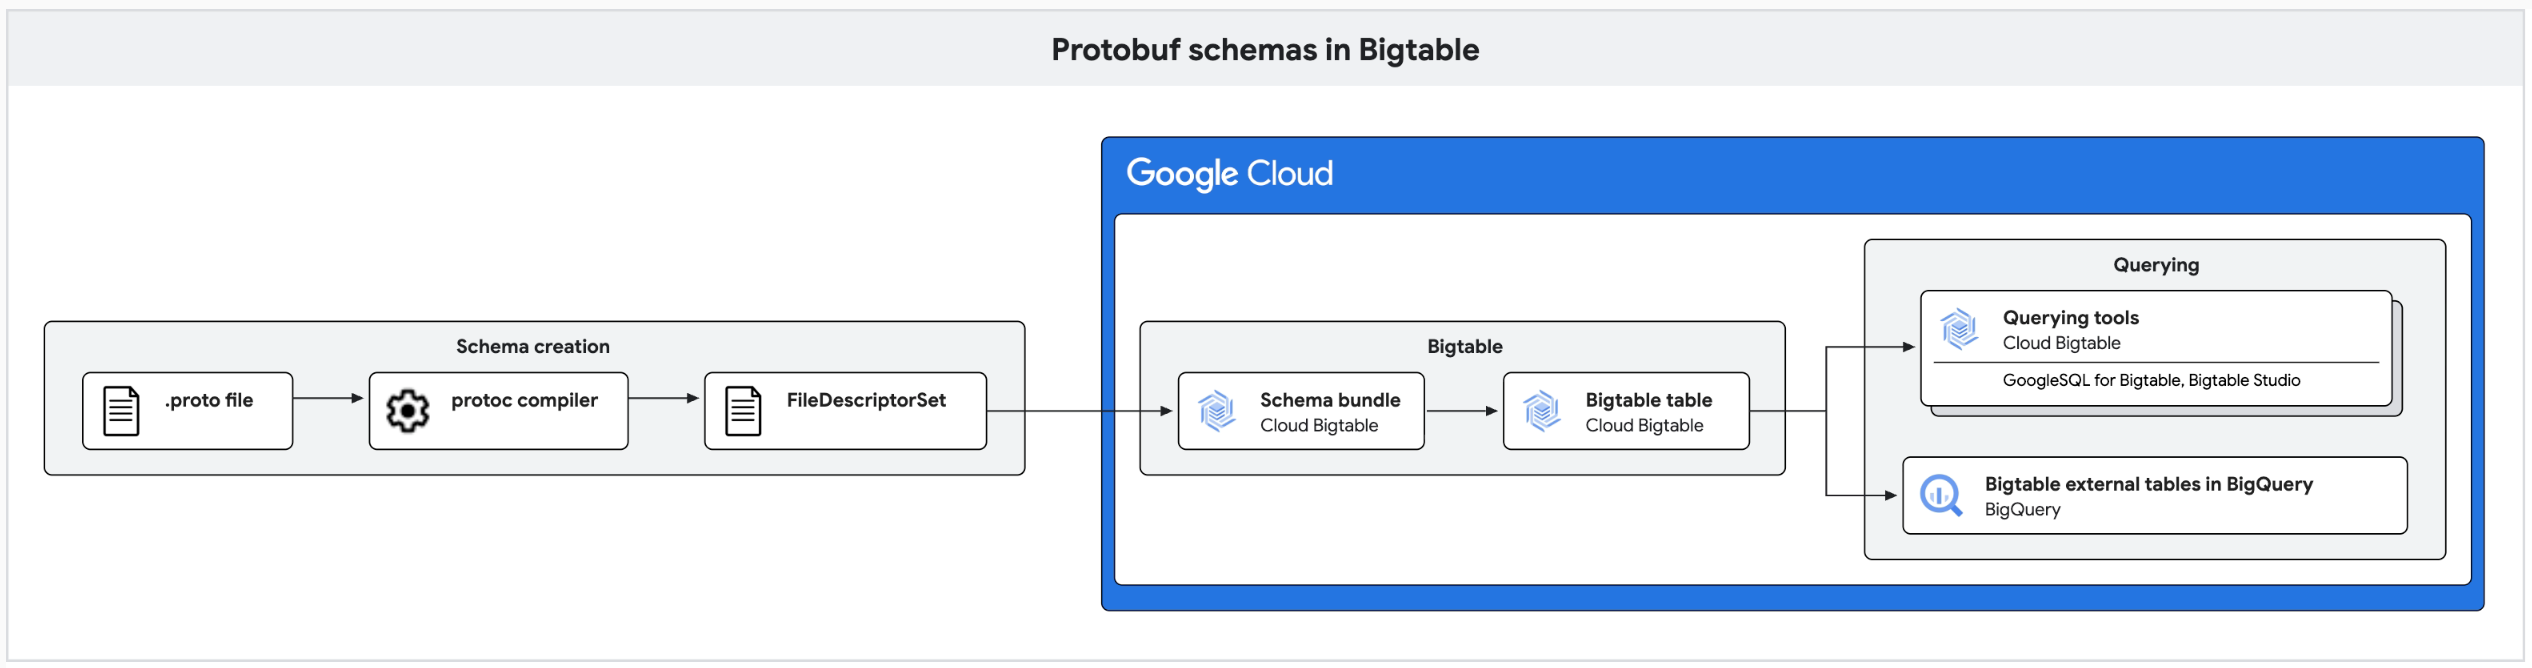
Sie können Schemabündel mit der Google Cloud Console oder der Google Cloud CLI erstellen. Nachdem Sie ein Schemabundle in Bigtable hochgeladen haben, können Sie Ihre Daten mit dem Bigtable Studio-Abfragegenerator, GoogleSQL für Bigtable oder externen Bigtable-Tabellen in BigQuery abfragen.
Hinweis
Wenn Sie die gcloud CLI verwenden möchten, führen Sie die folgenden Schritte aus:
- Installieren Sie die Google Cloud CLI.
Initialisieren Sie die gcloud CLI:
gcloud init
Erforderliche Rollen
Bitten Sie Ihren Administrator, Ihnen die IAM-Rolle Bigtable Admin (roles/bigtable.admin) für die Tabelle zuzuweisen, um die Berechtigungen zu erhalten, die Sie zum Erstellen und Verwalten von Schemabündeln benötigen.
Diese vordefinierte Rolle enthält die Berechtigungen, die Bigtable für die Arbeit mit Schemabundles benötigt. Maximieren Sie den Abschnitt Erforderliche Berechtigungen, um die genau erforderlichen Berechtigungen aufzurufen:
Erforderliche Berechtigungen
bigtable.schemaBundles.createbigtable.schemaBundles.updatebigtable.schemaBundles.deletebigtable.schemaBundles.getbigtable.schemaBundles.list
Sie können diese Berechtigungen auch mit benutzerdefinierten Rollen oder anderen vordefinierten Rollen erhalten.
Weitere Informationen zu Bigtable-Rollen und -Berechtigungen finden Sie unter Zugriffssteuerung mit IAM.
Satz von Protokollzwischenspeicher-Dateideskriptoren generieren
Bevor Sie ein Schemabundle erstellen können, müssen Sie mit dem Protobuf-Compiler-Tool einen Deskriptorsatz aus Ihren Protobuf-Dateien generieren.
- Laden Sie das Paket herunter und folgen Sie der Anleitung in der README-Datei, um den Compiler zu installieren.
Führen Sie den Compiler aus:
protoc --proto_path=IMPORT_PATH --include_imports \
   --descriptor_set_out=DESCRIPTOR_OUTPUT_LOCATION PATH_TO_PROTO
Ersetzen Sie Folgendes:
IMPORT_PATH: das Verzeichnis, in dem der protoc-Compiler nach Proto-Dateien sucht.DESCRIPTOR_OUTPUT_LOCATION: das Verzeichnis, in dem der protoc-Compiler das generierte Deskriptorset speichert.PATH_TO_PROTO: der Pfad zu Ihrer Proto-Datei.
Wenn Sie beispielsweise einen Deskriptorsatz mit dem Namen library.pb für die Datei library.proto im aktuellen Verzeichnis erstellen möchten, können Sie den folgenden Befehl verwenden:
protoc --include_imports --descriptor_set_out=library.pb
library.proto
Schema-Bundle erstellen
Console
Öffnen Sie in der Google Cloud Console die Liste der Bigtable-Instanzen.
Wählen Sie eine Instanz aus der Liste aus.
Klicken Sie im Navigationsbereich auf Bigtable Studio.
Klicken Sie im Bereich Explorer neben der Tabelle, für die Sie ein Schemabündel erstellen möchten, auf das Aktionsmenü more_vert und dann auf Schemabündel erstellen.
Geben Sie im Dialogfeld Schema-Bundle erstellen im Feld Schema-Bundle-ID eine eindeutige ID für das Schema-Bundle ein.
Die ID muss 1 bis 50 Zeichen lang sein und darf nur Buchstaben, Ziffern, Unterstriche und Bindestriche enthalten. Sie darf nicht mit einem Bindestrich beginnen und nicht den Punkt (
.) enthalten.Klicken Sie im Feld Dateideskriptor-Set (.pb-Datei) auf Durchsuchen, um das Protobuf-Dateideskriptor-Set auszuwählen, das Sie im Abschnitt Protobuf-Dateideskriptor-Set generieren dieses Dokuments erstellt haben. Die Datei darf nicht größer als 4 MB sein.
Klicken Sie auf Erstellen.
Das Schemabundle wird in einem neuen Tab geöffnet.
gcloud
Verwenden Sie den Befehl gcloud bigtable schema-bundles create, um ein Schemabündel zu erstellen:
gcloud bigtable schema-bundles create SCHEMA_BUNDLE_ID \
    --instance=INSTANCE_ID \
    --table=TABLE_ID \
    --proto-descriptors-file=PROTO_DESCRIPTORS_FILE
Ersetzen Sie Folgendes:
SCHEMA_BUNDLE_ID: Eine eindeutige ID für das neue Schemabündel, die keine Punkte („.“) enthalten darf.INSTANCE_ID: die ID der Instanz, in der Sie das Schemabündel erstellen.TABLE_ID: die ID der Tabelle, in der Sie das Schemabundle erstellen.PROTO_DESCRIPTORS_FILE: Der Pfad zum Deskriptorsatz, den Sie im Abschnitt Satz von Protokollzwischenspeicher-Dateideskriptoren generieren dieses Dokuments erstellt haben.
Java
Verwenden Sie zum Erstellen eines Schemabundles die Methode createSchemaBundle:
Informationen zum Installieren und Verwenden der Clientbibliothek für Bigtable finden Sie unter Bigtable-Clientbibliotheken.
Richten Sie zur Authentifizierung bei Bigtable die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Informationen zu Schemabündeln ansehen
Bevor Sie Informationen zu Schemabündeln aufrufen können, benötigen Sie eine Bigtable-Tabelle mit mindestens einem Schemabündel. Sie können Informationen zu Schema-Bundles in einer Tabelle abrufen, indem Sie die Definition eines einzelnen Schema-Bundles abrufen oder alle Schema-Bundles in einer Tabelle auflisten.
Schemabundle-Definition abrufen
Console
Öffnen Sie in der Google Cloud Console die Liste der Bigtable-Instanzen.
Wählen Sie eine Instanz aus der Liste aus.
Klicken Sie im Navigationsbereich auf Bigtable Studio.
Maximieren Sie im Bereich Explorer die Tabelle, die das Schemabündel enthält, und maximieren Sie dann Schemabündel.
Klicken Sie auf das Schemabündel, das Sie aufrufen möchten, oder auf das Aktionsmenü more_vert neben dem Schemabündel und dann auf Details ansehen.
Ein Tab mit der Definition des Schemabundles wird geöffnet.
Optional: Wenn Sie einen Tab mit dem SQL-Abfrageeditor und einer Beispielabfrage öffnen möchten, in der das Schemabündel verwendet wird, klicken Sie neben dem Schemabündel auf das more_vert Aktionsmenü und dann auf Beispielabfrage.
gcloud
Mit dem Befehl gcloud bigtable schema-bundles describe können Sie Details zu einem Schemabündel abrufen:
gcloud bigtable schema-bundles describe SCHEMA_BUNDLE_ID \
    --instance=INSTANCE_ID \
    --table=TABLE_ID
Ersetzen Sie Folgendes:
SCHEMA_BUNDLE_ID: die ID des Schemabundles.INSTANCE_ID: die ID der Instanz.TABLE_ID: Die ID der Tabelle.
Java
Verwenden Sie die Methode getSchemaBundle, um die Definition eines Schemabundles abzurufen.
Diese Methode gibt ein SchemaBundle-Objekt zurück, das die Schemadefinition enthält.
Das folgende Beispiel zeigt, wie Sie ein Schemabundle abrufen und den Deskriptorsatz deserialisieren, um den Inhalt des Schemas auszugeben:
Informationen zum Installieren und Verwenden der Clientbibliothek für Bigtable finden Sie unter Bigtable-Clientbibliotheken.
Richten Sie zur Authentifizierung bei Bigtable die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Die Ausgabe sieht etwa so aus:
--------- Deserialized FileDescriptorSet ---------
File: my_schema.proto
Package: my_package
Message: MyMessage
--------------------------------------------------
Schemabündel in einer Tabelle auflisten
Console
Öffnen Sie in der Google Cloud Console die Liste der Bigtable-Instanzen.
Wählen Sie eine Instanz aus der Liste aus.
Klicken Sie im Navigationsbereich auf Bigtable Studio.
Maximieren Sie im Bereich Explorer die Tabelle, die die Schemabündel enthält, die Sie ansehen möchten.
Maximieren Sie Schema-Bundles.
Die Liste der Schemabündel wird in der Tabelle angezeigt. Wenn die Tabelle keine Schemabündel enthält, wird die Liste Schema Bundles nicht angezeigt.
gcloud
Verwenden Sie den Befehl gcloud bigtable schema-bundles list, um eine Liste der Schemabündel für eine Tabelle aufzurufen:
gcloud bigtable schema-bundles list \
    --instance=INSTANCE_ID \
    --table=TABLE_ID
Ersetzen Sie Folgendes:
INSTANCE_ID: die ID der Instanz.TABLE_ID: Die ID der Tabelle.
Java
Wenn Sie eine Liste aller Schemabündel in einer Tabelle aufrufen möchten, verwenden Sie die Methode listSchemaBundles. Diese Methode gibt eine Liste von Schema-Bundle-IDs zurück.
Im folgenden Beispiel wird gezeigt, wie die Schemabündel in einer Tabelle aufgelistet werden:
Informationen zum Installieren und Verwenden der Clientbibliothek für Bigtable finden Sie unter Bigtable-Clientbibliotheken.
Richten Sie zur Authentifizierung bei Bigtable die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Die Ausgabe sieht etwa so aus:
my-schema-bundle-1
my-schema-bundle-2
Schema-Bundle aktualisieren
Wenn Sie ein Schemabündel aktualisieren, prüft Bigtable, ob der neue Deskriptorsatz abwärtskompatibel mit dem vorhandenen ist. Wenn Bigtable Inkompatibilität erkennt, schlägt das Update mit einem FailedPrecondition-Fehler fehl. Wir empfehlen, gelöschte Feldnummern zu reservieren, um eine Wiederverwendung zu verhindern. Weitere Informationen finden Sie in der Protobuf-Dokumentation unter Proto Best Practices.
Wenn Sie sicher sind, dass die inkompatiblen Änderungen sicher sind und Sie ein Update erzwingen möchten, können Sie das Flag --ignore-warnings mit der gcloud CLI verwenden.
Sie können jedoch keine inkompatiblen Änderungen erzwingen, wenn das Schemabundle von einer kontinuierlichen materialisierten Ansicht oder einer logischen Ansicht verwendet wird. Ansichten sind von den Nachrichtendefinitionen des Schemabundles abhängig, um Daten zu parsen und abzufragen. Inkompatible Änderungen würden daher Abfragen für logische Ansichten unterbrechen und dazu führen, dass kontinuierliche materialisierte Ansichten während der Datenverarbeitung fehlschlagen. Wenn Sie abwärtsinkompatible Änderungen an einem Schemabundle vornehmen möchten, auf das in einer Ansicht verwiesen wird, müssen Sie zuerst die Ansichten aktualisieren oder löschen, in denen darauf verwiesen wird.
Console
Öffnen Sie in der Google Cloud Console die Liste der Bigtable-Instanzen.
Wählen Sie eine Instanz aus der Liste aus.
Klicken Sie im Navigationsbereich auf Bigtable Studio.
Maximieren Sie im Bereich Explorer die Tabelle, die das Schemabündel enthält, und maximieren Sie dann Schemabündel.
Klicken Sie neben dem Schemabündel, das Sie aktualisieren möchten, auf das Aktionsmenü more_vert und dann auf Aktualisieren.
Wählen Sie im Dialogfeld Schemabundle aktualisieren im Feld Dateideskriptor-Set (.pb-Datei) das neue Protobuf-Dateideskriptor-Set aus. Die Datei darf nicht größer als 4 MB sein.
Klicken Sie auf Speichern.
gcloud
Verwenden Sie den Befehl gcloud bigtable schema-bundles update, um ein Schemabundle für die Verwendung eines anderen Deskriptorsatzes zu aktualisieren:
gcloud bigtable schema-bundles update SCHEMA_BUNDLE_ID \
    --instance=INSTANCE_ID \
    --table=TABLE_ID \
    --proto-descriptors-file=PROTO_DESCRIPTORS_FILE
Ersetzen Sie Folgendes:
SCHEMA_BUNDLE_ID: Die ID des zu aktualisierenden Schemabundles.INSTANCE_ID: Die ID der Instanz, die das Schemabündel enthält.TABLE_ID: Die ID der Tabelle, die das Schemabundle enthält.PROTO_DESCRIPTORS_FILE: der Pfad zur neuen Deskriptorsatzdatei.
Optional: Wenn Sie das Update auch bei inkompatiblen Änderungen erzwingen möchten, hängen Sie das Flag --ignore-warnings an den Befehl an. Sie können keine inkompatiblen Änderungen erzwingen, wenn das Schemabundle von einer kontinuierlichen materialisierten Ansicht oder einer logischen Ansicht verwendet wird.
Java
Informationen zum Installieren und Verwenden der Clientbibliothek für Bigtable finden Sie unter Bigtable-Clientbibliotheken.
Richten Sie zur Authentifizierung bei Bigtable die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Schema-Bundle löschen
Sie können ein Schema-Bundle nicht löschen, wenn es von einer kontinuierlichen materialisierten Ansicht oder einer logischen Ansicht verwendet wird. Wenn Sie das Bündel löschen, schlagen Abfragen für logische Ansichten fehl und die Verarbeitung eingehender Daten durch kontinuierliche materialisierte Ansichten wird verhindert. Wenn Sie das Schemabündel löschen möchten, müssen Sie zuerst alle Ansichten löschen, die darauf verweisen, oder die Verweise entfernen.
Console
Öffnen Sie in der Google Cloud Console die Liste der Bigtable-Instanzen.
Wählen Sie eine Instanz aus der Liste aus.
Klicken Sie im Navigationsbereich auf Bigtable Studio.
Maximieren Sie im Bereich Explorer die Tabelle, die das Schemabündel enthält, und maximieren Sie dann Schemabündel.
Klicken Sie neben dem Schemabündel, das Sie löschen möchten, auf das Aktionsmenü more_vert und dann auf Löschen.
Klicken Sie im Bestätigungsdialogfeld auf Löschen.
gcloud
Verwenden Sie den Befehl gcloud bigtable schema-bundles delete, um ein Schemabündel zu löschen:
gcloud bigtable schema-bundles delete SCHEMA_BUNDLE_ID \
    --instance=INSTANCE_ID \
    --table=TABLE_ID
Ersetzen Sie Folgendes:
SCHEMA_BUNDLE_ID: Die ID des zu löschenden Schemabündels.INSTANCE_ID: die ID der Instanz, die das Schemabündel enthält.TABLE_ID: Die ID der Tabelle, die das Schemabundle enthält.
Java
Informationen zum Installieren und Verwenden der Clientbibliothek für Bigtable finden Sie unter Bigtable-Clientbibliotheken.
Richten Sie zur Authentifizierung bei Bigtable die Standardanmeldedaten für Anwendungen ein. Weitere Informationen finden Sie unter Authentifizierung für eine lokale Entwicklungsumgebung einrichten.
Beschränkungen
Für Schemabündel gelten die folgenden Einschränkungen:
- Sie können maximal 10 Schema-Bundles pro Tabelle erstellen.
- Die Gesamtgröße der serialisierten Protocol Buffer-Deskriptoren in einem Schemabundle darf 4 MB nicht überschreiten. Es gibt kein direktes Limit für die Anzahl der einzelnen Schemas, die Sie in ein Bundle aufnehmen können, solange die Gesamtgröße des Bundles dieses Limit nicht überschreitet.
Nächste Schritte
- Protobuf-Daten abfragen
- Weitere Informationen zu wechselnden oder unsicheren Abfragen
- Weitere Informationen finden Sie unter GoogleSQL für Bigtable – Übersicht.