


שיטות מומלצות לעומסי עבודה מרובי-דיירים ב-BigQuery
במסמך הזה מפורטות שיטות ושיטות מומלצות לדפוסים נפוצים שמשמשים בפלטפורמות של נתונים עם כמה דיירים וב-data marts ארגוניים.
חברות מסחריות, ספקי תוכנה כשירות (SaaS) וארגונים ממשלתיים צריכים לעיתים קרובות לארח באופן מאובטח גם נתונים פנימיים וגם נתונים של צד שלישי, מעבר לגבולות גיאוגרפיים ומנהליים. BigQuery הוא כלי רב-עוצמה שיכול לענות באופן עקבי על הדרישות של פלטפורמה מרובת דיירים, עם אקסה-בייטים של נתונים ומאות אלפי צרכני נתונים ביחידות עסקיות שונות. המאמר הזה מיועד לארגונים שפורסים פלטפורמות עם כמה דיירים ב-BigQuery, ורוצים להבין את אמצעי בקרת הגישה ואת התכונות לניהול הביצועים שזמינים.
מפתחי פלטפורמות עם כמה דיירים צריכים לעיתים קרובות לאזן בין השיקולים הבאים:
- בידוד נתונים: הטמעת אמצעי בקרה חזקים כדי למנוע דליפת נתונים בין דיירים.
- ביצועים עקביים: מגדירים ומקצים הזמנות ב-BigQuery כדי לשמור על ביצועים עקביים בכל הדיירים.
- ניהול משאבים: תכנון ההשפעה של מכסות ומגבלות.
- התפלגות גיאוגרפית: אחסון נתונים במיקומים גיאוגרפיים ייעודיים ונדרשים. אם יש לכם שאלות בנושא תאימות, תוכלו לעיין ב Google Cloud הצעות של לשמירה על תאימות.
- ביקורת ואבטחה: הגנה על נתוני הדייר מפני גישה לא הולמת וזליגת נתונים.
- ניהול עלויות: לוודא שהעלויות של BigQuery לאירוח כל דייר יהיו עקביות.
- מורכבות תפעולית: צמצום מספר השינויים במערכת שנדרשים כדי לארח דיירים חדשים.
ספק SaaS עם תשתית דיירים משותפת
ספקי SaaS שמארחים נתונים של צד שלישי צריכים להבטיח את האמינות והבידוד של כל הלקוחות שלהם. יכול להיות שיהיו עשרות אלפי לקוחות כאלה, ושהגישה לנתוני הלקוחות תתבצע דרך תשתית שירותים משותפת. חלק מספקי ה-SaaS גם מתחזקים מאגר נתונים מרכזי שעבר הסרת תוכן זדוני או רגיש, כדי לבצע ניתוח נתונים בכל הדיירים שלהם.
תכנון של מערך נתונים לכל דייר עוזר לצמצם את החששות הבאים של ארגון שמתרחב לאלפי דיירים:
- מורכבות ניהולית: המספר הכולל של פרויקטים חדשים ומשאבי ענן לכל לקוח
- זמן אחזור מקצה לקצה: עד כמה מאגר הנתונים עדכני גם לדיירים וגם לפתרונות ניתוח נתונים של לקוחות שונים
- ציפיות לגבי הביצועים: לוודא שהביצועים של הדייר נשארים בטווחים המקובלים
הגדרת מערכי נתונים לכל דייר (tenant)
בפרויקט שמיועד לאחסון נתוני לקוחות, הנתונים של כל לקוח מופרדים לפי מערכי נתונים ב-BigQuery. בארגון המארח, אתם משתמשים בפרויקט שני כדי לפרוס ניתוח נתונים ולמידת מכונה על נתוני לקוחות משולבים. לאחר מכן תוכלו להגדיר את מנוע עיבוד הנתונים, Dataflow, כך שיכתוב את הנתונים הנכנסים גם לטבלאות הפנימיות וגם לטבלאות הספציפיות לדייר. ההגדרה של Dataflow משתמשת בטבלאות שנכתבו במלואן במקום בתצוגות מורשות. שימוש בטבלאות שכתובות במלואן מאפשר טיפול אחיד בהפצה גיאוגרפית, ועוזר להימנע מהגעה למגבלות של תצוגות מורשות כשמספר הדיירים גדל.
ההפרדה בין האחסון למחשוב ב-BigQuery מאפשרת להגדיר פחות פרויקטים בהשוואה למחסני נתונים שמבוססים על אשכולות, כדי לטפל בבעיות כמו רמות שירות ובידוד נתונים. אם אתם לא צריכים להגדיר לדיירים משאבים נוספים של ענן ייעודי, מומלץ להשתמש בהגדרת ברירת המחדל של קבוצת נתונים ייעודית לכל דייר. בתרשים הבא מוצגת דוגמה להגדרת פרויקט שמבוססת על העיצוב המומלץ:
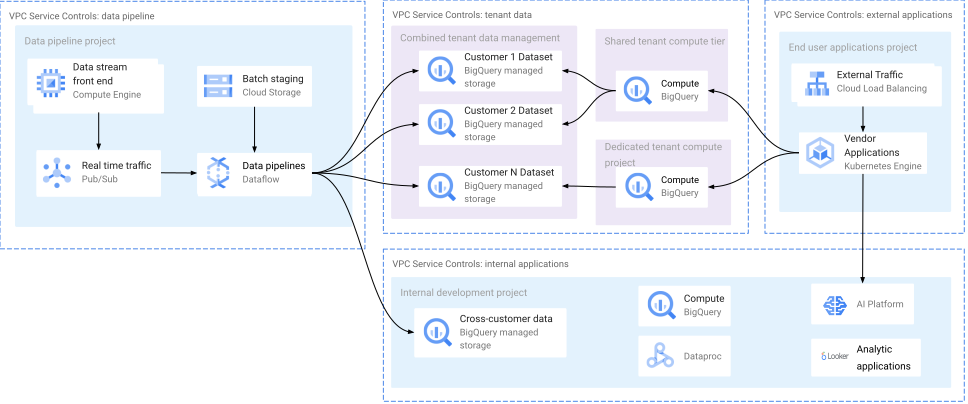
איור 1. מספר קבוע של פרויקטים מטפל בנתונים ובצרכי העיבוד ככל שמספר הדיירים גדל.
הגדרת הפרויקט באיור 1 כוללת את הפרויקטים הבאים:
- פייפליין נתונים: רכיבי התשתית העיקריים שמקבלים, מעבדים ומפיצים את נתוני הדיירים, ארוזים כולם בפרויקט אחד.
- פרויקט נתונים משולב של דיירים: פרויקט הנתונים המרכזי שבו נשמר מערך נתונים לכל לקוח. הגישה לנתוני הדייר צפויה להתבצע דרך פרויקטים של שכבת המחשוב.
- פרויקטים של פיתוח פנימי: פרויקטים שמייצגים את המשאבים בניהול עצמי שצוותי ניתוח הנתונים משתמשים בהם כדי להעריך את נתוני הדיירים ולפתח תכונות חדשות.
- פרויקטים של אפליקציות למשתמשי קצה: פרויקטים שמכילים משאבים שמיועדים לאינטראקציה עם משתמשי קצה. מומלץ להשתמש בחשבונות שירות ברמת הדייר כדי לגשת למערכי הנתונים של הדייר, ולהשתמש בצינור עיבוד נתונים חזק ומאובטח כדי לפרוס אפליקציות.
- פרויקטים של שכבת המחשוב של ההזמנה: הפרויקטים שממפים את פעילות השאילתות של הדייר להזמנות ב-BigQuery.
שיתוף הזמנות
ההקצאות בגישה הזו מסתמכות על אלגוריתם התזמון ההוגן שמובנה בהקצאות ב-BigQuery. כל הקצאה של רמת מחשוב משויכת לפרויקט אחד. השאילתות של הדיירים משתמשות במשבצות תזמון הוגנות שזמינות לכל פרויקט ברמת המחשוב, ומשבצות שלא נוצלו בכל רמה שהיא מנוצלות באופן אוטומטי ברמה אחרת. אם לדייר יש דרישות תזמון ספציפיות, אתם יכולים להשתמש בצמד פרויקט-הזמנה שמיועד לספק מספר מדויק של משבצות.
הגדרת גבולות גזרה של VPC Service Controls
במצב כזה, מומלץ להשתמש בהיקפי שירות של VPC Service Controls כדי למנוע חשיפה מקרית של מערכי הנתונים של הדייר מחוץ לארגון ב- Google Cloud , וכדי למנוע איחוד נתונים לא מורשה בתוך הארגון.
גבולות גזרה
במצב כזה, מומלץ ליצור את גבולות הגזרה לשירות הבאים:
- פייפליין: גבולות גזרה סביב הפרויקטים של פייפליין צריכים לאכוף את כל השירותים שלא צריכים לקבל נתוני דיירים.
- נתוני הדייר: גבולות גזרה סביב הפרויקט של קבוצת הנתונים של הדייר וסביב הפרויקטים של משאבי המחשוב ב-BigQuery של הדייר. אוכפים את כל השירותים כדי למנוע גישה מחוץ לארגון.
- אפליקציות פנימיות: אוכפים את כל השירותים ומשתמשים ברמות גישה כדי לתת לצוותים במחלקה גישה למשאבים.
- אפליקציות חיצוניות: גבול סביב אפליקציות ה-SaaS שלכם. אוכפים את כל השירותים שלא נחוצים לפעולת האפליקציות.
גבולות גזרה מגושרים
במצב כזה, מומלץ ליצור את גבולות הגזרה המגושרים הבאים:
- פייפליין ונתוני דייר (tenant): מאפשרים לפייפליין לכתוב נתונים במערכי הנתונים של הדייר.
- צינור עיבוד נתונים ואפליקציות פנימיות: מאפשרים לצינור עיבוד הנתונים לכתוב נתונים במערך הנתונים של כל הלקוחות.
- אפליקציות חיצוניות ונתוני דיירים: מאפשרים לאפליקציות שפונות החוצה לשלוח שאילתות לנתוני דיירים.
- אפליקציות חיצוניות ואפליקציות פנימיות: מאפשרות לאפליקציות שפונות החוצה לעבד נתונים באמצעות מודלים שהאפליקציות הפנימיות מפתחות ופורסות.
ספק SaaS עם תשתית דיירים ייעודית
בתרחישים מורכבים יותר, ספקי SaaS יכולים לפרוס תשתית מחשוב ייעודית לכל דייר. בתרחיש הזה, תשתית ייעודית אחראית על הטיפול בבקשות לנתוני דיירים ב-BigQuery.
תכנון תשתית ייעודית לדייר בענן נותן מענה לבעיות הנפוצות הבאות, שקשורות לפריסת תשתית לכל דייר בענן לצד BigQuery:
- אחריות על החיוב: מעקב אחרי עלויות התשתית שמשויכות לכל דייר שנוסף.
- זמן אחזור מקצה לקצה: עד כמה מאגר הנתונים עדכני גם לדיירים וגם לפתרונות ניתוח נתונים של לקוחות שונים.
- ציפיות לגבי הביצועים: לוודא שהביצועים של הדייר נשארים בטווחים מקובלים.
מיקום משותף של מערכי נתונים עם משאבים ייעודיים
כשפורסים תשתית ייעודית לדייר, מומלץ ליצור תיקיית הורה לפרויקטים הספציפיים לדייר. לאחר מכן, ממקמים את מערכי הנתונים של הדייר ב-BigQuery בפרויקטים עם המשאבים הייעודיים שניגשים לנתונים האלה בשם הדייר. כדי לצמצם את זמן האחזור מקצה לקצה של נתוני הדיירים, צינורות עיבוד הנתונים של Dataflow מוסיפים נתונים ישירות למערכי הנתונים של הדיירים.
העיצוב הזה מטפל בעיבוד נתונים והפצה במעלה הזרם, בדומה לעיצוב התשתית המשותפת הקודם. עם זאת, הנתונים והאפליקציות של הדיירים שניגשים לנתוני הדיירים מאורגנים בפרויקטים ספציפיים לדיירים (ואפשר גם לארגן אותם בתיקיות ייעודיות לדיירים) כדי לפשט את החיוב ואת ניהול המשאבים. בתרשים הבא מוצגת דוגמה להגדרת פרויקט שמבוססת על העיצוב המומלץ:
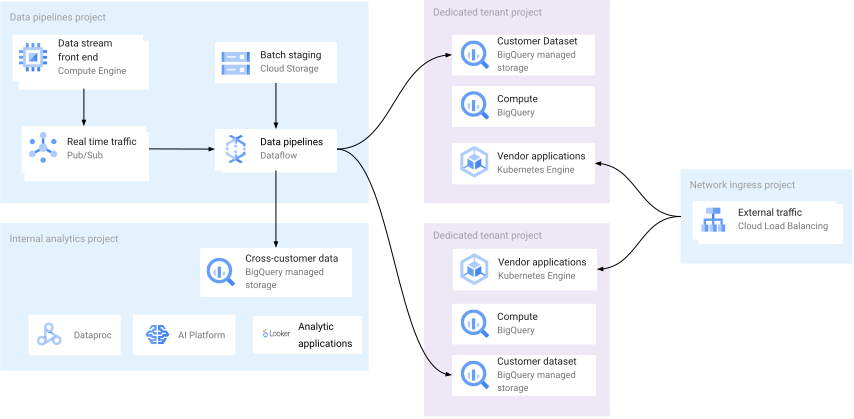
איור 2. פרויקט של Data pipelines מטפל בנתונים של דייר יחיד מכמה פרויקטים אחרים.
הגדרת הפרויקט באיור 2 כוללת את הפרויקטים הבאים:
- פייפליינים: רכיבי התשתית העיקריים שמקבלים, מעבדים ומפיצים את נתוני הדיירים, כולם ארוזים בפרויקט אחד.
- פרויקטים ייעודיים לדיירים: פרויקטים שמכילים את כל משאבי הענן שמיועדים לדייר אחד, כולל מערכי נתונים ב-BigQuery. אנחנו ממליצים להשתמש בניהול זהויות והרשאות גישה (IAM) כדי להגביל מאוד את היקף החשבונות וחשבונות השירות שיכולים לגשת למערכי הנתונים של הלקוחות.
- פרויקטים של ניתוח פנימי: פרויקטים שמייצגים את המשאבים בניהול עצמי שצוותי הניתוח משתמשים בהם כדי להעריך את נתוני הדיירים ולפתח תכונות חדשות.
- פרויקט רשת חיצוני: פרויקט שמטפל בבקשות של דיירים ומנתב אותן לקצוות העורפיים הייעודיים שלהם.
שיתוף הזמנות
הזמנות בגישה הזו מסתמכות על אלגוריתם התזמון ההוגן שמובנה בהזמנות ב-BigQuery. בהגדרה הזו, הקצאות של רמות מחשוב מוקצות לכל פרויקט דייר שמשתמש ברמה הזו. אם לדייר יש דרישות תזמון ספציפיות, אתם יכולים ליצור הזמנה ייעודית כדי לספק מספר מדויק של משבצות לפרויקט של הדייר.
שימוש באמצעי הבקרה של IAM והשבתת היצירה של מפתחות
יכול להיות שהיקפי האבטחה של VPC Service Controls לא מתאימים לתרחיש הזה. המגבלות שקשורות לפרויקטים מונעות מהארגון להשתמש בגבולות היקפיים סביב פרויקטים שמקיימים אינטראקציה עם הפרויקטים של הדיירים. במקום זאת, מומלץ להשתמש באמצעי בקרה מחמירים של IAM ולהשבית את יצירת המפתחות כדי להגן מפני גישה חיצונית לא רצויה.
Data mart עם רשות מרכזית
Data marts הם נושא עיצובי נפוץ שבו נתוני ניתוח ליבה מאוחסנים במאגר מרכזי, וקבוצות משנה משותפות לאורך ענפים כלכליים (LOB). ב-data mart יש בדרך כלל עשרות או מאות דיירים (tenants), שמיוצגים כענפים כלכליים (LOB) שצריך להביא בחשבון.
עיצוב של data mart ב-BigQuery נותן מענה לצרכים הבאים:
- שיתוף נתונים מאובטח: שיתוף נתונים עם אמצעי בקרה טכניים כדי לצמצם גישה לא הולמת בין צוותים.
- משילות מידע מרכזית: כדי לוודא שנכסי הנתונים העיקריים שמשמשים לדוחות עסקיים קריטיים עוברים סטנדרטיזציה ואימות.
- שיוך עלויות ליחידות עסקיות: מעקב אחרי השימוש במשאבי המחשוב והתאמה שלו לפי יחידות עסקיות.
שימוש במאגר שמנוהל באופן מרכזי
בעיצוב הזה, נתוני הליבה נשמרים במאגר שמנוהל באופן מרכזי. תצוגות מורשות, פונקציות מורשות בהגדרת המשתמש (UDF) וכללי מדיניות של עמודות משמשים לעיתים קרובות יחד כדי לשתף נתונים עם ענפים כלכליים, תוך מניעת הפצה מקרית של נתונים רגישים.
צוותים בפרויקטים של דיירים יכולים לגשת למערכי נתונים שמנוהלים באופן מרכזי, על סמך הרשאות החשבון שלהם. הצוותים משתמשים במשבצות שהוקצו לפרויקטים שלהם כדי ליצור דוחות ומערכי נתונים נגזרים. צוות הנתונים המרכזי משתמש בתצוגות מורשות כדי לשמור על בעלות מלאה על בקרת הגישה לנכסים של ה-data mart. במצב כזה, מומלץ להימנע מיצירת כמה שכבות של תצוגות מעל האובייקטים שמוצגים בפרויקט של נתוני הליבה. בתרשים הבא מוצגת דוגמה להגדרת פרויקט שמבוססת על העיצוב המומלץ:
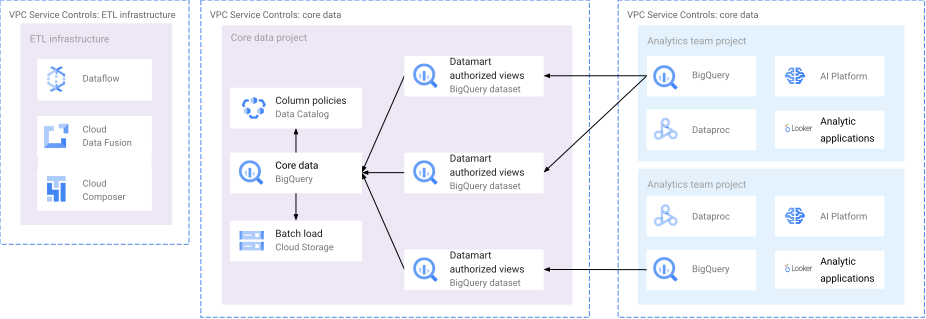
איור 3. בפרויקט של נתוני ליבה יש data mart מרכזי שאפשר לגשת אליו מכל מקום בארגון.
הגדרת הפרויקט באיור 3 כוללת את הפרויקטים הבאים:
- פרויקט נתוני ליבה: היקף הפיקוח לניהול הגישה לנתוני הליבה ולתצוגות של ה-data mart. אתם מנהלים תצוגות מורשות בתוך מערכי נתונים בפרויקט הזה, ונותנים תצוגות מורשות לצוותי הניתוח שלכם על סמך החברות בקבוצה.
- תשתית חילוץ, טרנספורמציה וטעינה (ETL): תשתית לעיבוד מקורות נתונים במעלה הזרם לנתוני הליבה. בהתאם לצורכי ההפרדה האדמיניסטרטיבית, תוכלו לפרוס את תשתית ה-ETL כפרויקט נפרד או כחלק מפרויקט הנתונים העיקרי.
- פרויקטים של צוות ניתוח הנתונים: צרכני ה-data mart משתמשים בפרויקטים האלה, ומשתמשים בגישה לתשתית שהוקצתה להם כדי לעבד נתונים ב-data mart. פרויקטים של צוות ניתוח הנתונים אמורים להיות מסוגלים ליצור מערכי נתונים נגזרים לשימוש מקומי.
שימוש בעיצוב של שמירת מקום בשתי רמות
כשעובדים עם data marts, מומלץ להשתמש בעיצוב דו-שכבתי. בתכנון דו-שכבתי, מקצים למשאב הארגון הזמנה עם מספר קטן של משבצות לשימוש כללי. אם לצוותים יש צרכים גדולים יותר, אפשר להקצות הזמנות ברמת הפרויקט או התיקייה.
הגדרת גבולות גזרה של VPC Service Controls
בהגדרה הזו, מומלץ להשתמש בהיקפי VPC Service Controls כדי למנוע חשיפה מקרית של מערכי הנתונים ב-BigQuery מחוץ לארגון ב-Google Cloud .
גבולות גזרה
במצב כזה, מומלץ ליצור את גבולות הגזרה הבאים לשירות:
- נתוני ליבה: גבולות גזרה להגנה על מערכי הנתונים של מחסן הנתונים ושל ה-data mart.
- Data pipelines: היקף לפרויקט של תשתית ה-ETL. אם צריך לשלוח בקשות מחוץ לארגון ב- Google Cloudדרך פייפליינים, מומלץ להפריד את גבולות הגזרה הזה מגבולות גזרת הנתונים העיקריים.
- ניתוח נתונים: מתחם שבו אפשר ליצור ולפרוס נכסי ניתוח נתונים פנימיים בארגון. למתחם הזה צפויה להיות מדיניות גישה מתירנית יותר מאשר למתחם הנתונים המרכזי שאליו הוא מחובר.
גבולות גזרה מגושרים
במצב כזה, מומלץ ליצור את גבולות הגזרה המגושרים הבאים:
- Data pipelines ונתוני ליבה: מאפשרים ל-Data pipelines לכתוב בפרויקט של נתוני הליבה.
- נתונים וניתוח נתונים ב-Core: מאפשרים למשתמשים בפרויקטים של ניתוח הנתונים לשלוח שאילתות לתצוגות המורשות.
העתקת מערכי נתונים להגדרות בכמה אזורים
ב-BigQuery אי אפשר להריץ שאילתות בין אזורים שונים, ולכן אי אפשר להשתמש באסטרטגיה של פילוח נתונים באמצעות תצוגות מורשות כש-data marts צריכים להיות בכמה אזורים. במקום זאת, אתם יכולים להשתמש בשירות העברת הנתונים ל-BigQuery כדי להעתיק מערכי נתונים רלוונטיים לאזור אחר. בתרחיש הזה, יוצרים כללי מדיניות לעמודות בקטלוג הנתונים לכל אזור נוסף שבו מיקום אחסון הנתונים. בתרשים הבא מוצגת הגדרה בכמה אזורים:
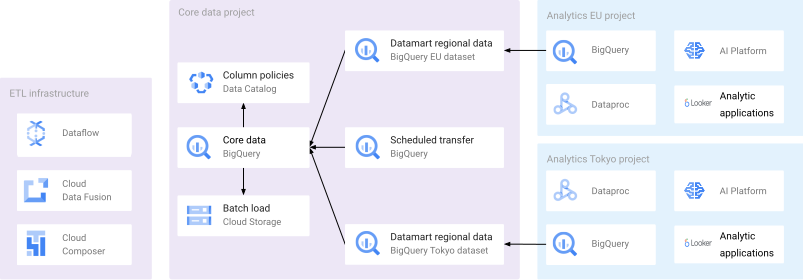
איור 4. בהגדרה של מספר אזורים, שירות העברת הנתונים ל-BigQuery משמש להעתקת מערכי נתונים בין אזורים.
הגדרת הפרויקט באיור 4 כוללת את הפרויקטים הבאים.
- פרויקט נתוני ליבה: היקף הפיקוח לניהול הגישה לנתוני הליבה ולתצוגות של ה-data mart. הנתונים מועתקים ונשמרים בקבוצות נתונים אזוריות שיכולות לשמש צוותים ברחבי העולם.
- תשתית ETL: תשתית לעיבוד מקורות נתונים במעלה הזרם לנתוני הליבה. בהתאם לצורכי ההפרדה האדמיניסטרטיבית, תוכלו לפרוס את תשתית ה-ETL כפרויקט נפרד או כחלק מפרויקט הנתונים העיקרי.
- פרויקטים של צוות ניתוח הנתונים: צרכני ה-data mart משתמשים בפרויקטים האלה, ובתשתית שהוקצתה להם כדי לעבד נתונים במערכי נתונים אזוריים של ה-data mart. פרויקטים של צוות ניתוח הנתונים אמורים להיות מסוגלים ליצור מערכי נתונים נגזרים לשימוש מקומי.
שירות העברת הנתונים ל-BigQuery הוא רכיב מתוזמן נוסף עם כמה מגבלות. התזמון המובנה של השירות מוגבל למרווח זמן מינימלי של 15 דקות, והוא חייב להעתיק את כל הטבלאות ממערך הנתונים של המקור. אי אפשר להטמיע סקריפטים נוספים כדי ליצור קבוצות משנה של נתונים ספציפיים לאזור בתזמון של שירות העברת הנתונים ל-BigQuery.
אם הארגון שלכם צריך יותר גמישות, אתם יכולים להשתמש באפשרויות הבאות:
- משימות של Managed Service for Apache Airflow: אתם יכולים לתזמן משימות של Managed Service for Apache Airflow כדי להנפיק משימות ETL שיוצרות קבוצות משנה אזוריות, לפני הפעלת שירות העברת הנתונים ל-BigQuery באמצעות ממשק ה-API של הלקוח. אם הארגון שלכם יכול לתמוך בזמן אחזור נוסף, אנחנו ממליצים על האפשרות הזו.
- תשתית ETL: תשתית ETL, כמו Dataflow, יכולה לכתוב קבוצות משנה אזוריות בשני אזורי יעד. אם הארגון שלכם דורש זמן אחזור מינימלי של נתונים בין אזורים, אנחנו ממליצים על האפשרות הזו.
מאגרי נתונים עם סמכות מבוזרת
כדאי להשתמש בסמכות מבוזרת כשצריך הפרדה אדמיניסטרטיבית לפי בעלי המערכת, ענפים כלכליים או שיקולים גיאוגרפיים.
ב-data mart מבוזר יש כמה הבדלים בהשוואה ל-data mart רגיל:
- שיתוף נתונים מאובטח: שיתוף נתונים עם אמצעי בקרה טכניים כדי לצמצם גישה לא הולמת בין צוותים.
- יכולת גילוי נתונים: הצוותים צריכים להיות מסוגלים לגלות מערכי נתונים ולבקש גישה אליהם.
- מקור הנתונים: בלי צוות מרכזי של אוצרי נתונים, הצוותים צריכים להיות מסוגלים לסמוך על מקור הנתונים שנכנסים למוצרי הניתוח שלהם.
הקצאת הרשאות לניהול נתוני ליבה
העיצוב הזה שונה מגישה רגילה של data mart, כי סמכות מבוזרת מאצילה החלטות ניהול של נתוני ליבה לקבוצות משנה של רכיבים בארגון. כשמשתמשים בסמכות מבוזרת, שומרים על שליטה מרכזית באבטחה ובקיבולת של BigQuery באמצעות Cloud Key Management Service (Cloud KMS), כללי מדיניות של עמודות, VPC Service Controls והזמנות. כך אתם נמנעים מהתפשטות הנתונים שמאפיינת מחסני נתונים בניהול עצמי. בתרשים הבא מוצגת ארכיטקטורה שמשתמשת בסמכות מבוזרת:
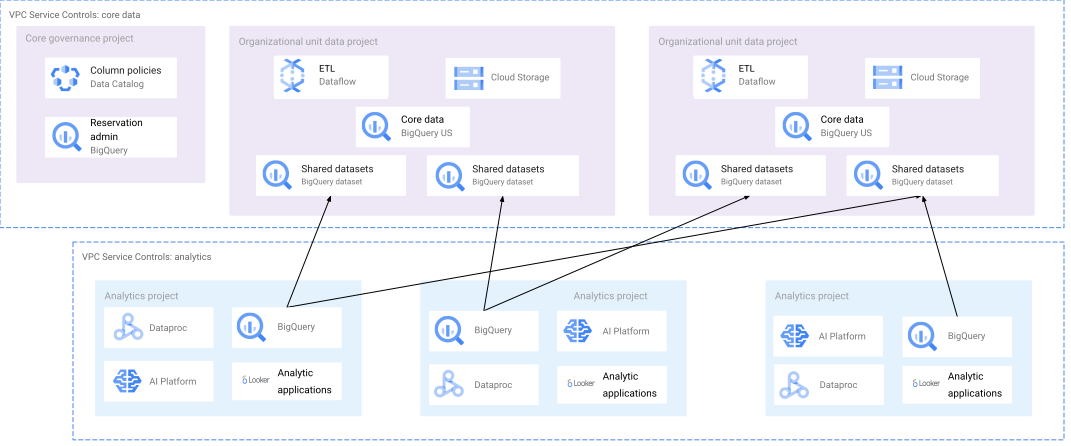
איור 5. פרויקט פיקוח מרכזי עוזר להבטיח אבטחה עקבית, בזמן שקבוצות נפרדות מנהלות את פעולות הנתונים שלהן.
הגדרת הפרויקט באיור 5 כוללת את הפרויקטים הבאים:
- פרויקט משילות ליבה: הפרויקט שאחראי על ניהול נושאים שקשורים לכל הארגון. בפרויקט הזה יוצרים משאבי אבטחה כמו אוספי מפתחות של Cloud KMS ומדיניות עמודות של קטלוג נתונים. הפרויקט הזה משמש כפרויקט לניהול ההזמנות ב-BigQuery, ומאפשר שיתוף של משבצות ברמת הארגון.
- פרויקטים של נתונים ביחידה ארגונית: הבעלים של data marts בניהול עצמי בארגון הרחב יותר. פרויקט המשילות המרכזי מנהל את ההיקף המוגבל של פרויקטי הנתונים של היחידה הארגונית.
- פרויקטים של צוות ניתוח הנתונים: הפרויקטים שמשמשים את צרכני ה-data marts. בפרויקטים האלה משתמשים בתשתית וב-slots שהוקצו להם כדי לגשת לנתונים ב-data mart ולעבד אותם.
שימוש בעיצוב של שמירת מקום בשתי רמות
אנחנו ממליצים שמאגרי הנתונים המבוזרים ישתמשו באותו עיצוב דו-שכבתי כמו מאגרי נתונים רגילים. בהגדרה הזו, מקצים למשאב הארגון הזמנה עם מספר קטן של משבצות כדי לכסות את השימוש הכללי. אם לצוותים יש צרכים גדולים יותר, אפשר להקצות הזמנות ברמת הפרויקט או התיקייה.
שימוש בקטלוג נתונים
קטלוג נתונים מספק גילוי ברמת הארגון, תיוג מטא-נתונים והגדרת מדיניות עמודות. החיפוש ב-Knowledge Catalog יוצר באופן אוטומטי רשומות של מטא-נתונים לכל הטבלאות החדשות ב-BigQuery בארגון. היכולות של Knowledge Catalog גם עוזרות לאדמינים של משילות מידע (data governance) לזהות במהירות נכסי נתונים חדשים ולהפעיל אמצעי בקרה מתאימים.
הגדרת גבולות גזרה של VPC Service Controls
בהגדרה הזו, מומלץ להשתמש בהיקפי VPC Service Controls כדי למנוע חשיפה מקרית של מערכי הנתונים ב-BigQuery מחוץ לארגון ב-Google Cloud .
גבולות גזרה
במצב כזה, מומלץ ליצור את גבולות הגזרה הבאים לשירות:
- נתוני ליבה: גבולות גזרה להגנה על מערכי הנתונים של מחסן הנתונים ושל ה-data mart. ההיקף הזה צריך לכלול את כל הפרויקטים של היחידה הארגונית ואת הפרויקט של משילות המידע.
- Analytics: מתחם לבנייה ולפריסה של נכסי ניתוח נתונים פנימיים בארגון. למתחם הזה צפויה להיות מדיניות גישה פחות מחמירה מאשר למתחם הנתונים המרכזי שאליו הוא מחובר.
גבולות גזרה מגושרים
במצב כזה, מומלץ ליצור את גבולות הגזרה המגושרים הבאים:
- נתונים וניתוח נתונים ב-Core: מאפשרים למשתמשים בפרויקטים של ניתוח הנתונים לשלוח שאילתות לתצוגות המורשות.
שיתוף נתונים בין כמה ארגונים
שיתוף בין כמה ארגונים הוא שיקול מיוחד בתכנון של data mart. התכנון הזה של שיתוף נתונים מיועד לארגונים שרוצים לשתף באופן מאובטח את מערכי הנתונים שלהם עם ישות אחרת שיש לה ארגון משלה ב-Google.
שיתוף נתונים בין כמה ארגונים נותן מענה לחששות הבאים של משתף הנתונים:
- סודיות השיתוף: רק הגורם המיועד יכול לגשת לנתונים המשותפים.
- הגנה מפני גישה לא הולמת: אפשר לגשת באופן חיצוני רק למשאבים שמיועדים לגישה.
- הפרדת חישובים: גורמים חיצוניים מחויבים על שאילתות שהם יוזמים.
הגנה על פרויקטים פנימיים מפני פרויקטים של נתונים משותפים
העיצוב של שיתוף נתונים בין כמה ארגונים מתמקד בהגנה על הפרויקטים הפנימיים של הארגון מפני פעילות בפרויקטים של נתונים משותפים. הפרויקט של מערך הנתונים המשותף משמש כחוצץ שמונע גישה לעיבוד נתונים פנימיים רגישים, ומאפשר לשתף נתונים באופן חיצוני.
שאילתות שמתחילות מהפרויקט החיצוני משתמשות במשאבי המחשוב של הפרויקט שמפעיל את השאילתה. אם כל מערכי הנתונים שנשלחו אליהם שאילתות נמצאים באותו אזור של Google Cloud, השאילתות האלה יכולות לאחד נתונים בין ארגונים. בתרשים הבא מוצג איך קבוצות נתונים משותפות בהגדרת פרויקט עם כמה ארגונים:
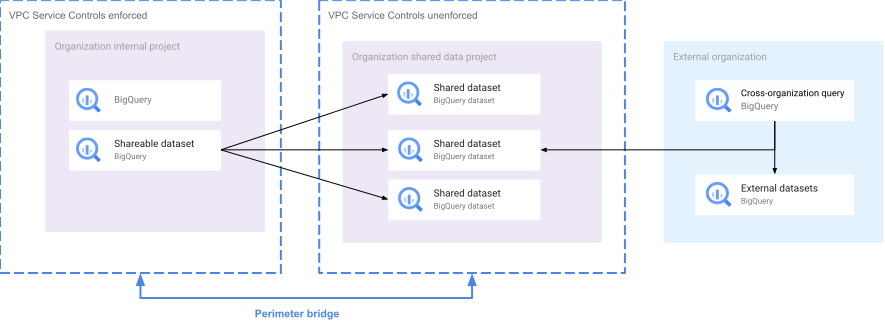
איור 6. ארגון חיצוני שולח שאילתות לנתונים מכמה מערכי נתונים בפרויקטים משותפים.
הגדרת הפרויקט באיור 6 כוללת את הפרויקטים הבאים:
- פרויקט פנימי של הארגון: הפרויקט שמכיל מידע פנימי רגיש. הפרויקט הפנימי יכול לשתף נתונים עם גורמים חיצוניים על ידי העתקת נתונים שעברו הסרת תוכן זדוני או רגיש למערכי הנתונים של פרויקט הנתונים המשותפים. הפרויקט הפנימי צריך להיות הבעלים של חשבון השירות שאחראי לעדכון הנתונים המשותפים.
- פרויקט נתונים משותפים: הפרויקט שמכיל את המידע שעבר הסרת תוכן זדוני או רגיש, שהועתק מהפרויקט הפנימי. כדי לנהל את הגישה של גורמים חיצוניים, השתמשו בקבוצות של משתמשים חיצוניים. בתרחיש הזה, אתם מנהלים את החברות בקבוצה כפונקציה אדמיניסטרטיבית, ונותנים לחשבונות חיצוניים הרשאת צפייה כדי שהם יוכלו לגשת למערך הנתונים דרך הקבוצות האלה.
הגדרת גבולות גזרה של VPC Service Controls
במצב כזה, מומלץ להשתמש בגבולות גזרה של VPC Service Controls כדי לשתף נתונים משותפים עם גורמים חיצוניים ולמנוע חשיפה מקרית של מערכי נתונים ב-BigQuery מחוץ לפרויקטים הפנימיים.
גבולות גזרה
במצב כזה, מומלץ ליצור את גבולות הגזרה הבאים לשירות:
- נתונים פנימיים: מתחם להגנה על נכסי נתונים מרכזיים. VPC Service Controls אוכף את הגישה ל-BigQuery.
- נתונים ששותפו עם גורמים מחוץ לארגון: מתחם לאירוח מערכי נתונים שאפשר לשתף עם ארגונים חיצוניים. במתחם הזה מושבתת אכיפת הגישה ל-BigQuery.
גבולות גזרה מגושרים
במצב כזה, מומלץ ליצור את גבולות הגזרה המגושרים הבאים:
- נתונים פנימיים לנתונים חיצוניים: גבולות גזרה מגושרים מאפשרים לפרויקטים של נתונים פנימיים מוגנים יותר להעביר נתונים לפרויקטים של שיתוף נתונים חיצוניים.
שיקולים נוספים במערכות עם כמה דיירים
בקטע הזה נתעמק במקרים מיוחדים שאפשר להביא בחשבון, בנוסף לשיטות המומלצות שצוינו קודם.
Google Cloud מגבלות ומכסות של משאבים
- בכל פרויקט יש מכסה גמישה של 100 חשבונות שירות. בפרויקטים שבהם יש חשבונות שירות של דיירים, אתם יכולים לבקש מכסה באמצעות מסוף Google Cloud .
- כברירת מחדל, אפשר להריץ ב-BigQuery עד 100 שאילתות בו-זמנית בכל פרויקט שמנפיק שאילתות (בפרויקטים שמכילים מערכי נתונים אין מגבלות כאלה). כדי להגדיל את המכסה הגמישה הזו, צריך לפנות לנציג המכירות.
- ב-VPC Service Controls יש מגבלה של 10,000 פרויקטים בגבולות גזרה לשירות בכל הארגון. אם אתם צריכים להגדיל את קנה המידה של הפרויקטים לכל דייר, מומלץ להשתמש במקום זאת במערך נתונים לכל דייר.
- ב-VPC Service Controls יש מגבלה של 100 גבולות גזרה לכל ארגון, כולל גשרים.
שימוש בתצוגות מורשות או בטבלאות של קבוצות משנה מנוהלות
כדי לנהל את הגישה של הדיירים לקבוצות משנה של טבלאות עובדות גדולות, אתם יכולים להשתמש בתצוגות מורשות ספציפיות לדייר או ליצור טבלאות של קבוצות משנה ספציפיות לדייר. בטבלה הבאה מוצגת השוואה בין הגישות האלה:
| תכונה | תצוגות מורשות | טבלאות משנה |
|---|---|---|
| מספר הדיירים הנתמכים | יש מגבלה של 2,500 משאבים מורשים לכל מערך נתונים. | משאבים מורשים כוללים תצוגות מורשות, מערכי נתונים מורשים ופונקציות מורשות.אין הגבלה על מספר מערכי הנתונים בפרויקט או על מספר הטבלאות במערך נתונים. |
| חלוקה למחיצות (partitioning) ואשכולות |
תצוגות מורשות חייבות להיות בעלות אותה סכימת חלוקה למחיצות ואשכולות כמו של מסד הנתונים הטבלאי. כדי לשפר את הביצועים של פילוח הדיירים, מומלץ לאסוף את טבלת ההורה לפי מזהה הדייר. |
אפשר לחלק את טבלת המשנה למחיצות וליצור אשכולות לפי הצרכים של הדייר. |
| התאמה לאזורים | תצוגות מורשות לא יכולות להיות באזורים שונים, והן חייבות להיות באזור Google Cloud של מסד הנתונים הטבלאי. האזורים משפיעים על דיירים שנמצאים במקומות גיאוגרפיים מרוחקים. | טבלאות משנה יכולות להיות באזור שהכי מתאים לדייר. יכול להיות שיחולו עלויות נוספות. |
| אכיפת מדיניות בעמודות | כללי מדיניות של עמודות שחלים על מסד נתונים טבלאי חלים על כל התצוגות המורשות, בלי קשר להרשאות בתצוגות האלה. | כדי שמדיניות העמודה תיכנס לתוקף, צריך להחיל אותה על כל טבלת משנה. |
| רישום ביומן של גישה לנתונים | יומני הגישה לנתונים משתקפים ביומנים של מסד הנתונים הטבלאי. | הגישה לכל טבלת משנה מתועדת בנפרד. |
| גמישות בטרנספורמציה | תצוגות מורשות מאפשרות לעצב מחדש באופן מיידי את האובייקט שהדיירים ניגשים אליו. | כדי לשנות טבלאות של קבוצות משנה, צריך לבצע שינויים מורכבים בסכימה. |
שליטה במידע אישי רגיש
כדי למנוע גישה לא מורשית לנתונים, ב-BigQuery יש כמה תכונות נוספות מעבר להרשאות הרגילות של IAM.
הצפנה באספקת הלקוח
הצפנת נתונים של לקוחות כוללת מקרים שבהם ארגון מארח מאחסן ומעבד נתונים בשם דייר, אבל לא יכול לגשת לחלק מתוכן הנתונים. לדוגמה, יכול להיות שהארגון המארח לא יוכל לגשת לנתונים אישיים או לנתוני מכשיר שנחשבים רגישים.
כדי להצפין מידע רגיש, מומלץ לשולח הנתונים להשתמש במפתחות הצפנה מסוג AEAD מספריית Tink בקוד פתוח. מפתחות ההצפנה של AEAD בספריית Tink תואמים לפונקציות AEAD של BigQuery. לאחר מכן, הדייר יכול לפענח את הנתונים על ידי גישה לחומר המפתחות בפונקציה מוגדרת-משתמש (UDF) מורשית, או על ידי העברת חומר המפתחות כפרמטר של שאילתה ל-BigQuery, שבה הארגון המארח לא יכול לתעד את המפתח ביומן.
כללי מדיניות גישה לעמודות
ב-data marts מרובי דיירים, כללי מדיניות של עמודות משמשים לעתים קרובות כדי למנוע דליפה מקרית של תוכן רגיש בין צוותים שמשתפים פעולה. תצוגות מורשות הן המנגנון המועדף לשיתוף נתונים משותפים בין צוותים בתרחיש של data mart. תצוגות מורשות לא יכולות לתת גישה לעמודה מוגנת.
כשמגדירים את המדיניות לאכיפת בקרת גישה, מונעים גישה ממשתמשים שלא קיבלו את התפקיד קורא ברמת פירוט גבוהה במדיניות. גם כשהמדיניות לא נאכפת, היא מתעדת ביומן את כל הגישה של המשתמשים לעמודה המסווגת.
Sensitive Data Protection
Sensitive Data Protection מספק ממשקי API וכלי סריקה שעוזרים לזהות תוכן רגיש שמאוחסן במערכי נתונים של BigQuery או של Cloud Storage, ולצמצם את הסיכונים שקשורים אליו. ארגונים בתרחישים של ריבוי דיירים משתמשים לעיתים קרובות ב-DLP API (חלק מ-Sensitive Data Protection) כדי לזהות מידע רגיש, ולפעמים גם להמיר אותו לאסימונים, לפני שהוא נשמר.
ניהול הזמנות של יחידות קיבולת (Slot)
ניהול ההזמנות במערכות עם כמה דיירים עוזר לשלוט בעלויות כשהדיירים מתרחבים, ומבטיח את הביצועים לכל דייר.
כדי לנהל את ההזמנות, מומלץ ליצור פרויקט אדמיניסטרטיבי אחד להזמנות. אפשר לשתף התחייבויות ל-slots שנרכשו באותו פרויקט אדמין בין כל ההזמנות שמקורן בפרויקט האדמין. אפשר להקצות פרויקט שמשתמש בהתחייבויות ל-slots רק להזמנה אחת בכל פעם. כל השאילתות שמקורן בפרויקט חולקות משבצות על סמך המשאבים הזמינים.
כדי לוודא שהיעדים למדידת רמת השירות (SLO) של הדיירים מתקיימים, אתם יכולים לעקוב אחרי ההזמנות באמצעות Cloud Logging וסכימת המידע של BigQuery. ארגונים שבהם יש תקופות עמוסות של פעילות ניתוח נתונים או משימות בעדיפות גבוהה יכולים להקצות קיבולת נוספת באמצעות יחידות קיבולת גמישות.
הזמנות כמדרגות מחשוב של דיירים
ספקי SaaS שיש להם עשרות עד אלפי דיירים בדרך כלל מגדירים מספר סופי של הזמנות ב-BigQuery כמשאבים משותפים.
אם אתם ספקי SaaS עם תשתית משותפת לדיירים, מומלץ להקצות כל הזמנה לפרויקט אחד ולקבץ דיירים כדי לשתף את הפרויקט הזה לצורך מחשוב ב-BigQuery. העיצוב הזה מפחית את התקורה הניהולית של אלפי פרויקטים והזמנות נוספים, ומאפשר לארגון להקצות קיבולת מינימלית של משבצות שנדרשת כדי לעמוד בצרכי הביצועים הצפויים של ההזמנה.
אם עיבוד נתוני ELT בזמן הוא בעדיפות עליונה, מומלץ להקצות הזמנה לטיפול בעיבוד. כדי למנוע שימוש במשבצות נוספות שאפשר להשתמש בהן לעומסי עבודה אד-הוק, הגדירו את ההזמנה להתעלמות ממשבצות לא פעילות.
בדוגמה הבאה מוסבר איך להגדיר הזמנות כשכבות מחשוב של דיירים:
- עיבוד נתונים: 2,000 משבצות, התעלמות ממשבצות לא פעילות. ההזמנה הזו מוגדרת כך שתעמוד ביעדי ה-SLO של עיבוד הנתונים.
- פרויקטים פנימיים: 1,000 משבצות, עם אפשרות לניצול משבצות לא פעילות. ההקצאה הזו חלה על הפרויקטים שמשמשים לניתוח פנימי.אם נשארים משבצות מעיבוד הנתונים או משכבות המחשוב, נעשה בהן שימוש חוזר.
- רמת מחשוב נמוכה: 2,000 משבצות, התעלמות ממשאבים פנויים. ההקצאה הזו חלה על דיירים שקיבלו מעט משאבים. בניגוד לרמה הגבוהה, ההזמנה הזו מתעלמת ממשבצות לא פעילות.
- רמת מחשוב גבוהה: 3,000 משבצות, מאפשרת מצב חוסר פעילות. ההקצאה הזו חלה על דיירים שקיבלו משאבים רבים. כדי להאיץ את השאילתות, המערכת משתמשת באופן אוטומטי במשבצות לא פעילות מהזמנות אחרות.
אם הדיירים שלכם פועלים בתשתית ייעודית, מומלץ להקצות את התיקייה או הפרויקט הייעודיים להזמנה המשותפת המתאימה.
הזמנות לכל צוות
כשעובדים עם צוותים בהגדרת data mart, מומלץ ליצור הזמנה לכל צוות שזקוק למשאבי מחשוב נוספים. לאחר מכן מקצים את ההזמנה הזו לתיקיית ההורה שמכילה את הפרויקטים של הצוות. כל הפרויקטים החדשים של הצוות הזה משתמשים במשבצות של תזמון הוגן מאותה הקצאת משאבים.
הדוגמה הבאה ממחישה איך להגדיר הזמנות לכל צוות:
- הקצאה ברמת הארגון: 500 משבצות, עם הרשאה לשימוש במשבצות לא פעילות. ההקצאה הזו מוקצית לארגון ברמה העליונה, והיא נותנת משבצות לכל משתמש ב-BigQuery שלא משתמש בפרויקט עם הקצאה ייעודית.
- עיבוד נתונים: 1,000 חריצי זמן, התעלמות מחוסר פעילות. ההזמנה הזו מוגדרת כך שתעמוד ביעדי ה-SLO המינימליים של עיבוד נתונים.
- ניהול נתוני ליבה: 500 משבצות, עם הרשאה לזמן חוסר פעילות. ההזמנה הזו חלה על הפרויקטים שמשמשים לניהול פנימי. אם נשארים משבצות מעיבוד נתונים או מרמות מחשוב, נעשה בהן שימוש חוזר.
- הזמנות לעיבוד ב-Analytics: 500 משבצות, מאפשרות מצב חוסר פעילות. זהו מקום שמור ייעודי שניתן לצוות ניתוח נתונים.
דרישות לאירוח במספר אזורים
הדרישות לאירוח במספר אזורים נובעות בדרך כלל מהצורך לצמצם את זמן האחזור של הנתונים לצרכנים, או כדי לעמוד בדרישות רגולטוריות.
פרויקטים ב- Google Cloud נחשבים גלובליים, ואפשר להקצות בהם משאבים בכל אזור. ב-BigQuery, מערכי נתונים, מדיניות עמודות והתחייבויות ל-slots נחשבים למשאבים אזוריים. ה-slots יכולים לגשת רק למערכי נתונים באזור המקומי, ואפשר להחיל כללי מדיניות של עמודות רק על טבלאות בתוך מערכי נתונים מקומיים. כדי להשתמש בתמחור מבוסס-קיבולת, צריך לרכוש משבצות בכל אזור שמכיל מערכי נתונים.
כדי לקבל הנחיות לגבי עמידה בדרישות הרגולטוריות, אפשר לפנות לנציג המכירות.