


הקטלוג הייעודי לזמן ריצה של Lakehouse מאפשר לכם לרכז את המטא-נתונים של הטבלאות במטא-נתונים מנוהלים לחלוטין, ללא שרת, שמשמשים כמקור אמת יחיד לנתונים שלכם ב-Lakehouse ללא גבולות. בעזרת מטא-נתונים מרוכזים, מנועי עיבוד – כולל Apache Spark, Apache Flink, Apache Hive ו-BigQuery – יכולים לשתף טבלאות ישירות בלי לשכפל קבצים.
כשמגדירים נקודת קצה של לקוח, כמו נקודת הקצה של קטלוג REST של Apache Iceberg, היא פועלת כממשק ניהול שמחבר בין מנועי שאילתות לקטלוג הייעודי לזמן ריצה של Lakehouse. נקודת הקצה מטפלת במטא-נתונים של הטבלה, וב-Cloud Storage מאוחסנים המטא-נתונים וקובצי הנתונים הבסיסיים.
הקטלוג הייעודי לזמן ריצה של Lakehouse הוא רכיב ליבה של Lakehouse, והוא מספק יכולת פעולה הדדית של ממשקי API פתוחים ותומך בעומסי עבודה של ניתוח נתונים, סטרימינג ו-AI בשילוב עם BigQuery. למידע נוסף על היתרונות האלה, קראו את המאמר מה זה Borderless Lakehouse?
איך Lakehouse משתלב עם Google Cloud
כדי להבין איך הנתונים מנוהלים ב-Lakehouse, אתם יכולים לקרוא איך הארכיטקטורה של Lakehouse משתלבת עם שירותי Google Cloud . ב-Apache Iceberg הנתונים לא מאוחסנים בטבלאות מונוליתיות. במקום זאת, הוא משתמש בארכיטקטורה שכבתית של קובצי מטא-נתונים כדי לארגן קובצי נתונים במבנה טבלה אחיד עם תמיכה בטרנזקציות ACID.
בתרשים הבא אפשר לראות איך מנועי מחשוב כמו Managed Service for Apache Spark משתמשים בקטלוג הייעודי לזמן ריצה של Lakehouse כדי לנהל מטא-נתונים של טבלאות, במטרה לקרוא ולכתוב קובצי נתונים בפורמט Parquet ישירות ב-Cloud Storage.
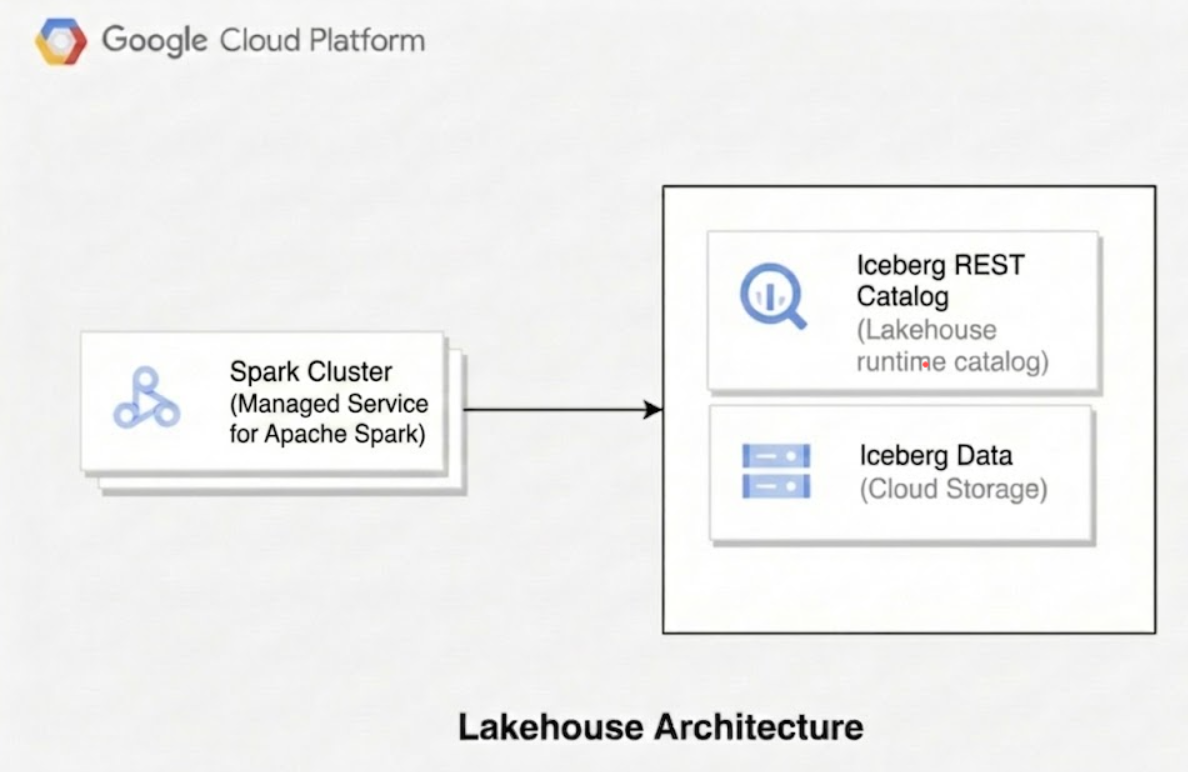
כשמשתמשים ב-Lakehouse, הארכיטקטורה הטכנית מורכבת משלוש שכבות נפרדות:
שכבת הקטלוג:
- מושג ליבה ב-Iceberg: הקטלוג שומר את המצב הנוכחי של הטבלה על ידי שמירת מצביע לקובץ המטא-נתונים האחרון. השכבה הזו מאפשרת תאימות ל-ACID ובידוד של טרנזקציות, כדי לוודא שפעולות כתיבה בו-זמניות לא מפריעות זו לזו.
- הטמעה של Lakehouse: הקטלוג הייעודי לזמן ריצה של Lakehouse משמש כשירות המטא-נתונים האזורי ברמה העליונה. בתוך השירות הזה, אתם יוצרים קטלוגים נפרדים כדי לנהל את היררכיית הנתונים. מנועי שאילתות של לקוחות מתחברים לקטלוגים האלה באמצעות סוגים ספציפיים של קטלוגים של נקודות קצה, כמו נקודת הקצה של קטלוג REST של Apache Iceberg. מאגר המטא-נתונים מנהל את אישורי הטרנזקציות, הנפקת פרטי הכניסה להקצאת גישה לאחסון וניהול המצביעים בקטלוגים.
שכבת מטא-נתונים:
- מושג הליבה של Iceberg: השכבה הזו עוקבת אחרי מבנה הטבלה, תמונות המצב ומיקומי הקבצים באמצעות היררכיה של שלושה סוגי קבצים:
- קובצי מטא-נתונים: מאחסנים את הסכימה של הטבלה, את מפרט המחיצה ואת יומן המצביעים של תמונת המצב.
- רשימות מניפסטים: מייצגות תמונת מצב אחת של הטבלה על ידי קיבוץ של אוסף קובצי מניפסט.
- קובצי מניפסט: מעקב אחרי נתונים ברמת הקובץ הבודד, אחסון נתיבי קבצים, מידע על מחיצות ונתונים סטטיסטיים ברמת העמודה, למשל ספירת שורות וערכי מינימום ומקסימום, שמשמשים לאופטימיזציה של שאילתות ולגיזום מחיצות.
- הטמעה של Lakehouse: בתוך מאגר קטלוג, אתם מארגנים את הנתונים במרחבי שמות לוגיים (בדומה למערכי נתונים) ובטבלאות. בכל טבלה, הקטלוג הייעודי לזמן ריצה של Lakehouse יוצר ומנהל את היררכיית המטא-נתונים הבסיסית של Iceberg, החל מקובץ
metadata.jsonבסיסי שמפנה לרשימות המניפסטים ולקובצי המניפסטים. הקטלוג הייעודי לזמן ריצה של Lakehouse שומר את הקבצים האלה ישירות במיקום האחסון שהגדרתם במחסן הנתונים.
- מושג הליבה של Iceberg: השכבה הזו עוקבת אחרי מבנה הטבלה, תמונות המצב ומיקומי הקבצים באמצעות היררכיה של שלושה סוגי קבצים:
שכבת נתונים:
- מושג ליבה של Iceberg: הרכיב הזה הוא האחסון הבסיסי שבו נמצאות רשומות הנתונים הגולמיים בפועל, בדרך כלל בפורמטים של קבצים פתוחים שמבוססים על עמודות או על שורות, כמו Parquet, ORC או Avro.
- הטמעה של Lakehouse: כשמגדירים מיקומים של מחסני נתונים ב-Cloud Storage (
gs://), קובצי הנתונים הפיזיים שהטבלאות מפנות אליהם מאוחסנים באופן מאובטח בקטגוריות. הקטלוג הייעודי לזמן ריצה של Lakehouse מנהל את הגישה באמצעות הקצאת גישה לאחסון (הנפקת פרטי כניסה), ומנפיק טוקני גישה לטווח קצר ישירות למנועי הלקוח. כך המנועים יכולים לקרוא ולכתוב קובצי נתונים בצורה מאובטחת, בלי לדרוש הרשאות IAM רחבות וישירות בקטגוריות הבסיסיות.
איך Lakehouse מטמיע את Apache Iceberg REST Catalog API
הקטלוג הייעודי לזמן ריצה של Lakehouse מטמיע את Apache Iceberg REST Catalog API בקוד פתוח כדי לנהל מרחבי שמות וטבלאות. הוא גם מספק API של תוספים במיוחד לניהול קטלוגים.
מנועי שאילתות של לקוחות יוצרים אינטראקציה עם המטא-נתונים באמצעות ממשקי ה-API הרגילים האלה של קטלוג REST. לפרטים על משאבים ונקודות קצה (endpoints) ב-Google Cloud, קראו את מאמרי העזרה של Lakehouse REST API.
אפשר ליצור, להגדיר ולנהל את המשאבים האלה באמצעות מסוףGoogle Cloud , ה-CLI של gcloud, ה-API בארכיטקטורת REST או Terraform. מידע נוסף זמין בדפים הבאים:
- ניהול משאבים של קטלוג REST של Iceberg
- ניהול טבלאות Apache Iceberg
- שימוש ב-Terraform עם Lakehouse
- שימוש בנקודות קצה אזוריות עם קטלוג ייעודי לזמן ריצה של Lakehouse
תאימות והגדרה של מנוע השאילתות
כדי לנתח ולנהל נתונים בקטלוג הייעודי לזמן ריצה של Lakehouse, אתם יכולים לחבר מנועי שאילתות שונים בקוד פתוח ובגרסת Enterprise. בהתאם לארכיטקטורה הקיימת ולדרישות של עומס העבודה, אתם יכולים לבחור מבין כמה מנועים נתמכים ולהגדיר את נקודת הקצה המתאימה של הקטלוג.
מנועים נתמכים
הקטלוג הייעודי לזמן ריצה של Lakehouse תואם לכמה מנועי שאילתות, כולל (בין היתר) Apache Spark, Apache Flink, Apache Hive ו-Trino. בטבלה הבאה מופיעים קישורים למסמכי התיעוד של כל מנוע:
| מנוע | מסמכי תיעוד |
|---|---|
| Apache Spark | שימוש עם Apache Spark |
| Apache Hive | שימוש עם Spark וקטלוג Hive |
| Apache Flink | שימוש עם Apache Flink |
| Trino | שימוש עם Trino |
סוגי קטלוגים והגדרת נקודות קצה (endpoints)
כשמגדירים מנועי לקוח להתחבר למאגר המטא-נתונים של הקטלוג הייעודי לזמן ריצה של Lakehouse, בוחרים נקודת קצה ספציפית של קטלוג, כמו נקודת הקצה של קטלוג Apache Iceberg REST או נקודת הקצה של Apache Hive. האפשרות הכי טובה תלויה בתרחיש לדוגמה, כמו שמוצג בטבלה הבאה:
| תרחיש לדוגמה | המלצה |
|---|---|
| משתמשים חדשים בקטלוג ייעודי לזמן ריצה של Lakehouse שרוצים שמנוע הקוד הפתוח שלהם יוכל לגשת לנתונים ב-Cloud Storage, וצריכים יכולת פעולה הדדית עם מנועים אחרים, כולל BigQuery ו-AlloyDB ל-PostgreSQL. | משתמשים בנקודת הקצה של קטלוג REST של Apache Iceberg. |
| משתמשים שמריצים עומסי עבודה של Apache Hive או Spark שתלויים בממשק של Hive Metastore, ורוצים שירות metastore מנוהל. | משתמשים בנקודת הקצה של קטלוג Apache Hive. |
| משתמשים קיימים בקטלוג ייעודי לזמן ריצה של Lakehouse, שיש להם טבלאות שנוצרו באמצעות הקטלוג המותאם אישית של Apache Iceberg לנקודת הקצה של BigQuery. | להמשיך להשתמש בנקודת הקצה של קטלוג Apache Iceberg בהתאמה אישית ל-BigQuery, אבל להשתמש בקטלוג Apache Iceberg REST לתהליכי עבודה חדשים. |
המגבלות של קטלוג ייעודי לזמן ריצה ב-Lakehouse
אלה המגבלות הכלליות שחלות על טבלאות בקטלוג הייעודי לזמן ריצה של Lakehouse כששולחים אליהן שאילתות דרך BigQuery. יכול להיות שלנקודות קצה ספציפיות של קטלוגים (כמו Apache Iceberg REST או Apache Hive) יהיו מגבלות נוספות שספציפיות לנקודת הקצה.
ניהול טבלאות
- יש תמיכה בטבלאות Apache Iceberg V2 (זמינות לכולם) ובטבלאות V3 (גרסת טרום-השקה). אין תמיכה בטבלאות Iceberg V1. כדי להשתמש בטבלאות קיימות מגרסה 1 עם קטלוג ייעודי לזמן ריצה של Lakehouse, צריך לשדרג אותן לגרסה נתמכת. מידע נוסף זמין במאמר שדרוג טבלאות Iceberg מגרסה 1 לגרסה 2.
- בטבלאות בקטלוג הייעודי לזמן ריצה של Lakehouse אי אפשר לשנות שמות או להשתמש בהצהרת SQL
ALTER TABLE ... RENAME TO. - טבלאות בקטלוג הייעודי לזמן ריצה של Lakehouse לא תומכות באשכולות.
- טבלאות בקטלוג הייעודי לזמן ריצה של Lakehouse לא תומכות במשימות חילוץ. המגבלה הזו חלה גם על הצהרות
EXPORT DATAוגם על פקודת ה-CLIbq extract. - הקטלוג הייעודי לזמן ריצה של Lakehouse לא תומך בתצוגות של מסדי נתונים או של מאגרי מטא-נתונים.
- הקטלוג הייעודי לזמן ריצה של Lakehouse לא תומך בתצוגות של Apache Iceberg.
שאילתות
- יכול להיות שביצועי השאילתות בטבלאות בקטלוג ייעודי לזמן ריצה של Lakehouse ממנוע BigQuery יהיו איטיים יותר בהשוואה לשליחת שאילתות על נתונים בטבלאות ב-BigQuery רגילות. באופן כללי, מהירות השאילתה אמורה להיות זהה למהירות של קריאת נתונים מ-Cloud Storage.
- בהרצה יבשה של BigQuery של שאילתה שמשתמשת בטבלה בקטלוג הייעודי לזמן ריצה של Lakehouse, יכול להיות שידווח גבול תחתון של 0 בייטים של נתונים, גם אם מוחזרות שורות. התוצאה הזו מתקבלת כי אי אפשר לקבוע את כמות הנתונים שעובדו מהטבלה עד להרצת השאילתה המלאה. הרצת השאילתה כרוכה בעלות על עיבוד הנתונים האלה.
- אי אפשר להפנות לטבלה בקטלוג הייעודי לזמן ריצה של Lakehouse בשאילתה של טבלת תווים כלליים לחיפוש.
API ומטא-נתונים
- אי אפשר להשתמש ב-method
tabledata.listכדי לאחזר נתונים מטבלאות בקטלוג הייעודי לזמן ריצה של Lakehouse. במקום זאת, אתם יכולים לשמור את תוצאות השאילתה בטבלה ב-BigQuery, ואז להשתמש ב-methodtabledata.listבטבלה הזו. - אי אפשר להציג נתונים סטטיסטיים של נפח האחסון של טבלאות בקטלוג הייעודי לזמן ריצה של Lakehouse.
מכסות ומגבלות
- על טבלאות בקטלוג הייעודי לזמן ריצה של Lakehouse ב-BigQuery חלות אותן מכסות ומגבלות כמו על טבלאות רגילות.
ההבדלים לעומת המטא-נתונים של BigLake (הגרסה הקלאסית)
אלה ההבדלים העיקריים בין הקטלוג הייעודי לזמן ריצה של Lakehouse לבין המטא-נתונים של BigLake (הגרסה הקלאסית):
- הקטלוג הייעודי לזמן ריצה של Lakehouse תומך בשילוב ישיר עם מנועי קוד פתוח כמו Spark, וכך עוזר לצמצם את היתירות כשמאחסנים מטא-נתונים ומריצים משימות. אפשר לגשת לטבלאות בקטלוג הייעודי לזמן ריצה של Lakehouse ישירות מכמה מנועי קוד פתוח ומ-BigQuery.
- הקטלוג הייעודי לזמן ריצה של Lakehouse תומך בנקודת הקצה של קטלוג REST של Apache Iceberg, אבל המטא-נתונים של BigLake (הגרסה הקלאסית) לא תומכים בה.
המאמרים הבאים
- להבין את נקודת הקצה של קטלוג REST של Apache Iceberg.
- מגדירים נקודות קצה אזוריות.