


O catálogo do ambiente de execução do Lakehouse permite centralizar os metadados de tabelas em um metastore totalmente gerenciado e sem servidor que serve como uma única fonte de verdade para seus dados no Lakehouse sem fronteiras. Com metadados centralizados, os mecanismos de processamento, incluindo Apache Spark, Apache Flink, Apache Hive e BigQuery, podem compartilhar tabelas diretamente sem duplicar arquivos.
Quando você configura um endpoint de cliente, como o endpoint do catálogo REST do Apache Iceberg, ele atua como uma interface de gerenciamento que conecta mecanismos de consulta ao catálogo do ambiente de execução do Lakehouse. O endpoint processa os metadados da tabela, e o Cloud Storage armazena os metadados e os arquivos de dados subjacentes.
Como um componente principal do Lakehouse, o catálogo de ambiente de execução do Lakehouse oferece interoperabilidade de API aberta e é compatível com cargas de trabalho de análise, streaming e IA quando pareado com o BigQuery. Para mais informações sobre esses benefícios arquitetônicos, consulte O que é o Lakehouse sem fronteiras?
Como o Lakehouse se integra ao Google Cloud
Para entender como o Lakehouse gerencia seus dados, veja como a arquitetura do Lakehouse se integra aos serviços do Google Cloud . O Apache Iceberg não armazena dados em tabelas monolíticas. Em vez disso, ele usa uma arquitetura em camadas de arquivos de metadados para organizar arquivos de dados em uma estrutura de tabela coesa com suporte a transações ACID.
O diagrama a seguir ilustra como os mecanismos de computação, como o Serviço Gerenciado para Apache Spark, usam o catálogo do ambiente de execução do Lakehouse para gerenciar metadados de tabela para ler e gravar arquivos de dados do Parquet diretamente no Cloud Storage.
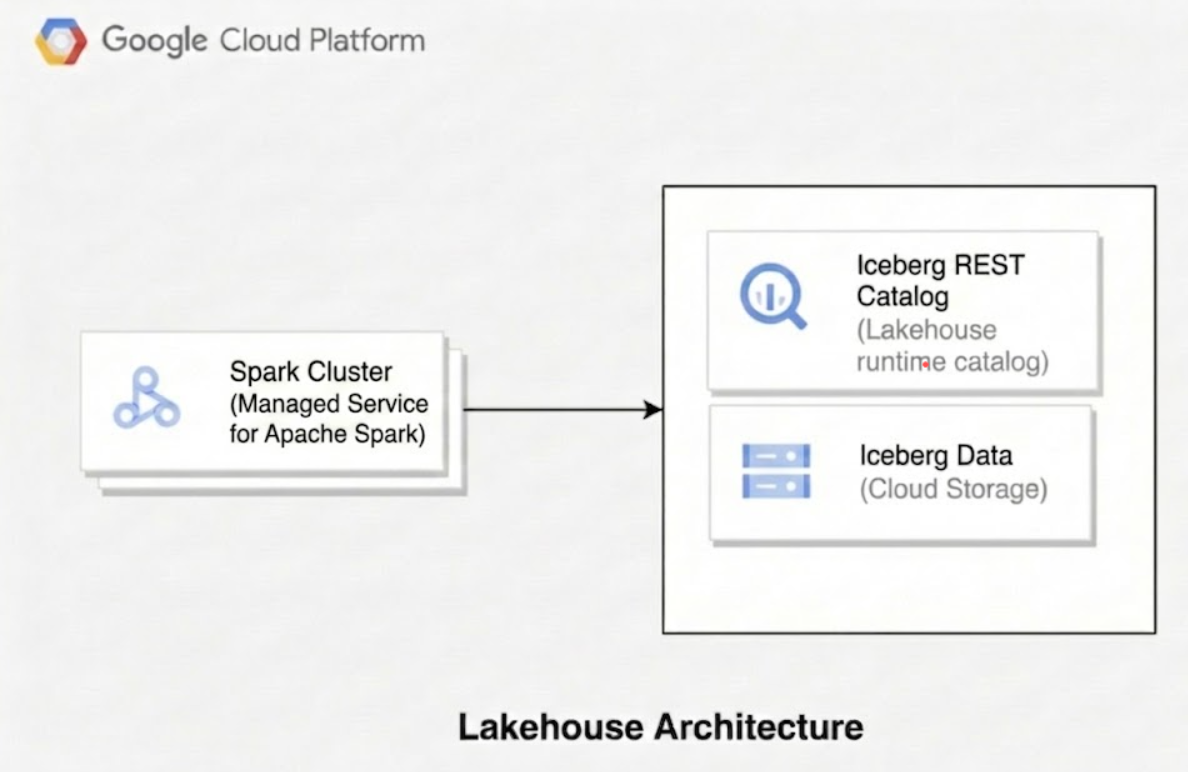
Quando você usa o Lakehouse, a arquitetura técnica consiste em três camadas distintas:
Camada de catálogo:
- Conceito principal do Iceberg: o catálogo armazena o estado atual da tabela mantendo um ponteiro para o arquivo de metadados mais recente. Essa camada facilita a conformidade com ACID e o isolamento da transação para garantir que as gravações simultâneas não interfiram umas nas outras.
- Implementação do Lakehouse: o catálogo do ambiente de execução do Lakehouse atua como o serviço de metastore regional de nível superior. Nesse serviço, você cria catálogos individuais para gerenciar sua hierarquia de dados. Os mecanismos de consulta do cliente se conectam a esses catálogos usando tipos de catálogo de endpoint específicos, como o endpoint do catálogo REST do Apache Iceberg. O metastore gerencia confirmações de transações, venda de credenciais para delegação de acesso ao armazenamento e gerenciamento de ponteiros nos seus catálogos.
Camada de metadados:
- Conceito principal do Iceberg: essa camada rastreia a estrutura da tabela,
os snapshots e os locais dos arquivos usando uma hierarquia de três tipos de arquivo:
- Arquivos de metadados: armazenam o esquema da tabela, a especificação de partição e um registro de ponteiros de snapshot.
- Listas de manifestos: representam um único snapshot da tabela agrupando uma coleção de arquivos de manifesto.
- Arquivos de manifesto: rastreiam dados no nível do arquivo individual, armazenando caminhos de arquivo, informações de partição e estatísticas no nível da coluna, por exemplo, contagens de linhas e valores mínimos e máximos, que são usados para otimização de consultas e remoção de partições.
- Implementação do Lakehouse: em um contêiner de catálogo,
você organiza seus dados em namespaces lógicos (semelhantes a
conjuntos de dados) e tabelas. Para cada tabela, o
catálogo do ambiente de execução do Lakehouse gera e gerencia a
hierarquia de metadados do Iceberg, começando com um arquivo
metadata.jsonraiz que aponta para as listas e os arquivos de manifesto. O catálogo do ambiente de execução do Lakehouse mantém esses arquivos diretamente no local de armazenamento designado do warehouse.
- Conceito principal do Iceberg: essa camada rastreia a estrutura da tabela,
os snapshots e os locais dos arquivos usando uma hierarquia de três tipos de arquivo:
Camada de dados:
- Conceito principal do Iceberg: esse componente é o armazenamento subjacente em que os registros de dados brutos reais residem, normalmente em formatos de arquivo aberto otimizados em colunas ou linhas, como Parquet, ORC ou Avro.
- Implementação do Lakehouse: ao configurar os locais do data warehouse do Cloud Storage (
gs://), os arquivos de dados físicos referenciados pelas tabelas são armazenados com segurança nos buckets. O catálogo do ambiente de execução do Lakehouse gerencia o acesso por meio da delegação de acesso ao armazenamento (distribuição de credenciais), distribuindo tokens de acesso de curta duração diretamente para os mecanismos do cliente. Isso permite que os mecanismos leiam e gravem arquivos de dados com segurança, sem exigir permissões do IAM amplas e diretas nos buckets subjacentes.
Como o Lakehouse implementa a API Apache Iceberg REST Catalog
O catálogo do ambiente de execução do Lakehouse implementa a API Apache Iceberg REST Catalog de código aberto para gerenciar namespaces e tabelas. Ele também fornece uma API de extensões especificamente para o gerenciamento de catálogos.
Os mecanismos de consulta do cliente interagem com o metastore usando essas APIs de catálogo REST padrão. Para detalhes sobre os recursos e endpoints do Google Cloud, consulte a referência da API REST do Lakehouse.
É possível criar, configurar e gerenciar esses recursos usando o console doGoogle Cloud , a CLI gcloud, a API REST ou o Terraform. Para mais informações, consulte as seguintes páginas:
- Gerenciar recursos do catálogo REST do Iceberg
- Gerenciar tabelas do Apache Iceberg
- Usar o Terraform com o Lakehouse
- Usar endpoints regionais com o catálogo do ambiente de execução do Lakehouse
Compatibilidade e configuração do mecanismo de consulta
Para analisar e gerenciar dados no catálogo do ambiente de execução do Lakehouse, é possível conectar diferentes mecanismos de consulta corporativos e de código aberto. Dependendo da arquitetura e dos requisitos de carga de trabalho, é possível escolher entre vários mecanismos compatíveis e configurar o endpoint de catálogo apropriado.
Mecanismos compatíveis
O catálogo do ambiente de execução do Lakehouse é compatível com vários mecanismos de consulta, incluindo (mas não se limitando a) Apache Spark, Apache Flink, Apache Hive e Trino. A tabela a seguir fornece links para a documentação de cada mecanismo:
| Engine | Documentação |
|---|---|
| Apache Spark | Usar com o Apache Spark |
| Apache Hive | Usar com o Spark e o catálogo do Hive |
| Apache Flink | Usar com o Apache Flink |
| Trino | Usar com o Trino |
Tipos de catálogo e configuração de endpoint
Ao configurar mecanismos de cliente para se conectar ao metastore do catálogo do ambiente de execução do Lakehouse, selecione um endpoint de catálogo específico, como o endpoint do catálogo REST do Apache Iceberg ou o endpoint do Apache Hive. A melhor opção depende do seu caso de uso, conforme mostrado na tabela a seguir:
| Caso de uso | Recomendação |
|---|---|
| Novos usuários do catálogo do ambiente de execução do Lakehouse que querem que o mecanismo de código aberto acesse dados no Cloud Storage e precisam de interoperabilidade com outros mecanismos, incluindo o BigQuery e o AlloyDB para PostgreSQL. | Use o endpoint do catálogo REST do Apache Iceberg. |
| Usuários que executam cargas de trabalho do Apache Hive ou Spark que dependem da interface do Hive Metastore e querem um serviço de metastore totalmente gerenciado. | Use o endpoint do catálogo do Apache Hive. |
| Usuários atuais do catálogo do ambiente de execução do Lakehouse que têm tabelas criadas com o catálogo personalizado do Apache Iceberg para o endpoint do BigQuery. | Continue usando o catálogo personalizado do Apache Iceberg para o endpoint do BigQuery, mas use o catálogo REST do Apache Iceberg para novos fluxos de trabalho. |
Limitações do catálogo do ambiente de execução do Lakehouse
As seguintes limitações gerais se aplicam às tabelas no catálogo do ambiente de execução do Lakehouse ao consultá-las pelo BigQuery. Os endpoints de catálogo individuais (como Apache Iceberg REST ou Apache Hive) podem ter outras limitações específicas.
Gerenciamento de tabelas
- As tabelas Apache Iceberg V2 (GA) e V3 (pré-lançamento) são compatíveis. As tabelas do Iceberg V1 não são compatíveis. Antes de usar as tabelas V1 com o catálogo do ambiente de execução do Lakehouse, faça upgrade delas para uma versão compatível. Para mais informações, consulte Fazer upgrade de tabelas do Iceberg V1 para V2.
- As tabelas no catálogo do ambiente de execução do Lakehouse não são compatíveis com
operações de renomeação ou com a
instrução SQL
ALTER TABLE ... RENAME TOSpark. - As tabelas no catálogo do ambiente de execução do Lakehouse não são compatíveis com clustering.
- As tabelas no catálogo do ambiente de execução do Lakehouse não são compatíveis com
jobs de extração. Essa limitação se aplica às instruções
EXPORT DATAe ao comandobq extractda CLI. - O catálogo do ambiente de execução do Lakehouse não é compatível com visualizações de banco de dados ou metastore.
- O catálogo do ambiente de execução do Lakehouse não é compatível com as visualizações do Apache Iceberg.
Consulta
- O desempenho da consulta para tabelas no catálogo do ambiente de execução do Lakehouse no mecanismo do BigQuery pode ser lento em comparação com a consulta de dados em tabelas padrão do BigQuery. Em geral, a velocidade da consulta deve ser equivalente à leitura de dados do Cloud Storage.
- Uma simulação do BigQuery de uma consulta que usa uma tabela no catálogo do ambiente de execução do Lakehouse pode informar um limite inferior de 0 bytes de dados, mesmo que as linhas sejam retornadas. Esse resultado ocorre porque a quantidade de dados processados da tabela não pode ser determinada até que a consulta completa seja executada. Executar a consulta gera custos para o processamento desses dados.
- Não é possível referenciar uma tabela no catálogo do ambiente de execução do Lakehouse em uma consulta de tabela curinga.
API e metadados
- Não é possível usar o método
tabledata.listpara recuperar dados de tabelas no catálogo do ambiente de execução do Lakehouse. Em vez disso, salve os resultados da consulta em uma tabela do BigQuery e use o métodotabledata.listnessa tabela. - Não é possível exibir estatísticas de armazenamento de tabelas no catálogo do ambiente de execução do Lakehouse.
Cotas e limites
- As tabelas no catálogo do ambiente de execução do Lakehouse no BigQuery estão sujeitas às mesmas cotas e limites das tabelas padrão.
Diferenças com o metastore do BigLake (clássico)
As principais diferenças entre o catálogo do ambiente de execução do Lakehouse e o metastore do BigLake (clássico) incluem:
- O catálogo do ambiente de execução do Lakehouse é compatível com uma integração direta com mecanismos de código aberto, como o Spark, o que ajuda a reduzir a redundância ao armazenar metadados e executar jobs. As tabelas no catálogo do ambiente de execução do Lakehouse podem ser acessadas diretamente de vários mecanismos de código aberto e do BigQuery.
- O catálogo do ambiente de execução do Lakehouse é compatível com o endpoint do catálogo REST do Apache Iceberg, enquanto o metastore do BigLake (clássico) não é.
A seguir
- Entenda o endpoint do catálogo REST do Apache Iceberg.
- Configurar endpoints regionais.