


O catálogo de ambiente de execução do Lakehouse permite compartilhar dados entre o Apache Spark, o Apache Hive e o BigQuery, fornecendo um metastore unificado e sem servidor. Essa camada de metadados totalmente gerenciada elimina a necessidade de metastores do Hive separados e auto-hospedados para cargas de trabalho de código aberto.
Otimizada para a compatibilidade do ExternalCatalog do Apache Spark, essa integração oferece suporte a um subconjunto da interface do metastore do Hive. Para determinar se suas
cargas de trabalho dependem de recursos sem suporte, como transações, compactações ou
Kerberos, consulte a comparação de recursos e
limitações.
Como o Hive se integra ao catálogo do ambiente de execução do Lakehouse
O endpoint do metastore do Hive gerencia tabelas padrão do Apache Hive e do Spark (usando SerDes do Hive ou fontes de dados do Spark), em vez de tabelas do Apache Iceberg. Para simplificar a conexão dos jobs do Spark a esse endpoint, as imagens do Serviço Gerenciado para Apache Spark são pré-configuradas com as bibliotecas de cliente e dependências necessárias.
A sequência a seguir descreve como o Spark se conecta ao metastore:
- O Apache Spark se conecta a catálogos de metadados externos usando a interface
IMetastoreClientpadrão do Apache Hive. - O catálogo de ambiente de execução do Lakehouse implementa um
IMetastoreClientpersonalizado para fornecer um serviço de metastore totalmente gerenciado para os metadados do Spark e do Hive. - Os ambientes de execução pré-configurados do Serviço Gerenciado para Apache Spark usam automaticamente esse cliente personalizado para encaminhar operações de metadados diretamente ao metastore.
Após a configuração, é possível consultar as tabelas criadas pelo Spark diretamente no BigQuery. Essa integração oferece suporte a vários formatos de armazenamento, como Parquet, ORC, Avro e Delta Lake, além de mapeamentos de tipo de dados específicos entre o Spark e o BigQuery, e chaves de criptografia gerenciadas pelo cliente (CMEK, na sigla em inglês) para dados armazenados no Cloud Storage.
Como o endpoint do catálogo do Hive se integra aos Google Cloud serviços
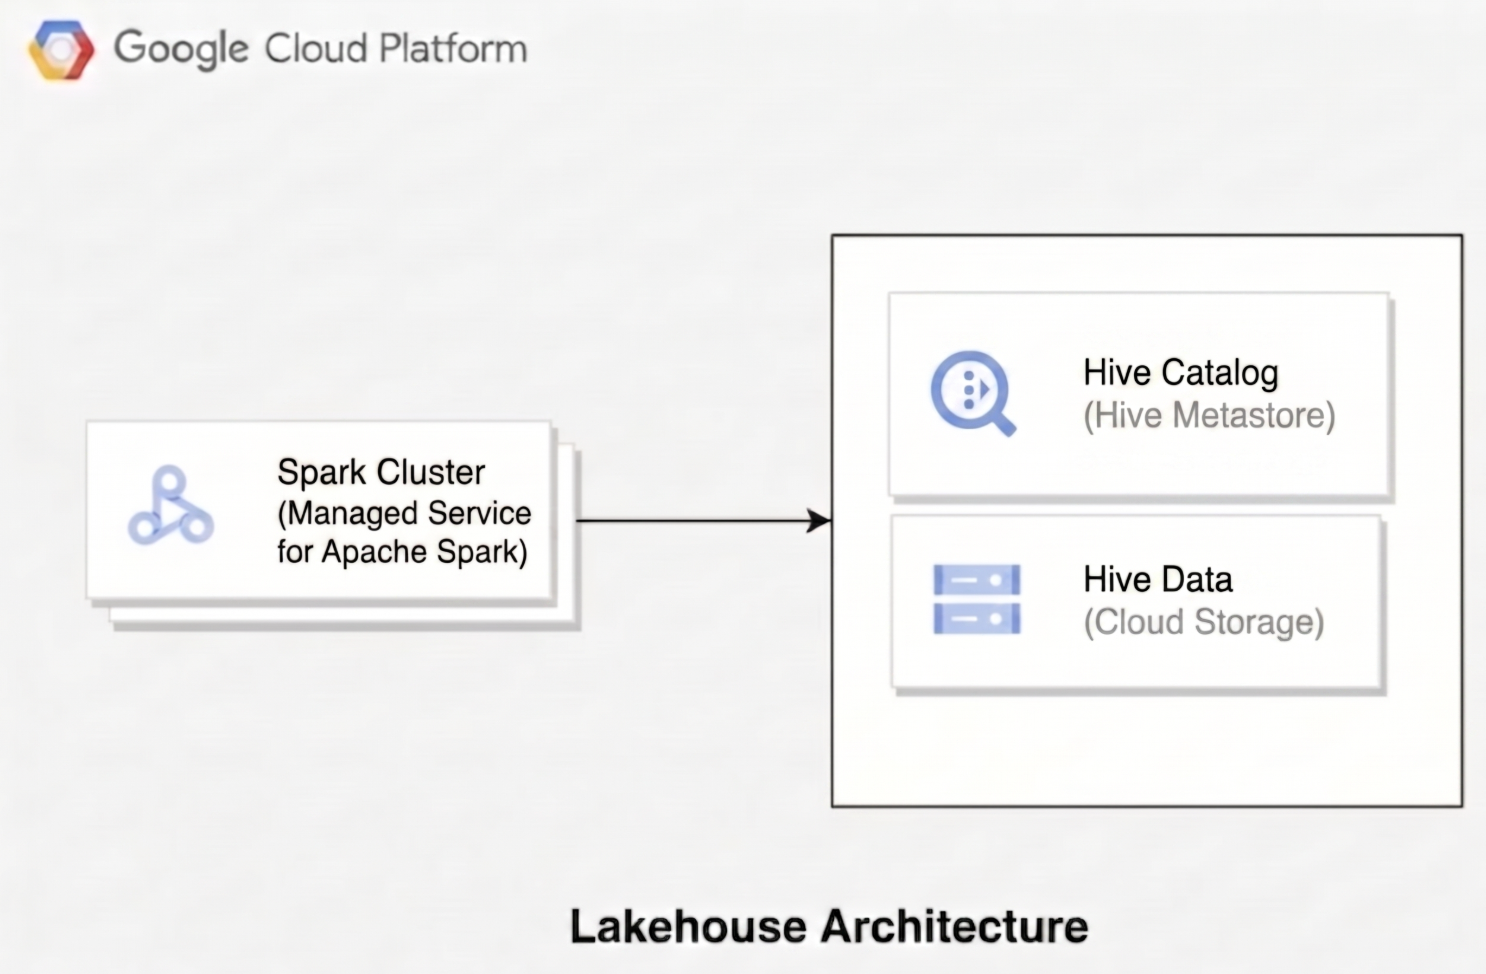
Para entender como o Lakehouse sem fronteiras gerencia seus dados, consulte Como a arquitetura do catálogo do Hive se integra aos Google Cloud serviços. Em vez de manter metastores auto-hospedados, suas cargas de trabalho de código aberto se conectam ao catálogo de ambiente de execução do Lakehouse para gerenciar definições de banco de dados e tabelas do Hive, enquanto armazenam os arquivos de dados subjacentes diretamente nos diretórios do data warehouse do Cloud Storage.
O diagrama a seguir ilustra como mecanismos de computação, como o Serviço Gerenciado para Apache Spark, usam o catálogo de ambiente de execução do Lakehouse para gerenciar metadados de tabelas ao ler e gravar arquivos de dados subjacentes diretamente no Hive.
Comparação de recursos com o metastore do Hive
A tabela a seguir compara entidades e operações no metastore do Hive e no Lakehouse:
| Entidade ou operação | Metastore do Hive | Catálogo do ambiente de execução do Lakehouse |
|---|---|---|
| Catálogo | ✅ | ✅ |
| Banco de dados (criar, excluir, atualizar) | ✅ | ✅ |
| Tabela (criar, excluir, atualizar) | ✅ | ✅ |
| Partição (adicionar, remover, atualizar) | ✅ | ✅ |
| Privilégios da tabela | ✅ | ✅ (pelo Identity and Access Management (IAM)) |
| Privilégios de partição | ✅ | ✅ (pelo IAM) |
| Funções definidas pelo usuário | ✅ | Sem suporte |
| Colunas de bucket / inclinação | ✅ | Sem suporte |
| Estatísticas de colunas de tabelas e partições | ✅ | Sem suporte |
| Principais limitações | ✅ | Sem suporte |
| Tokens de delegação (Kerberos) | ✅ | Sem suporte |
| Privilégios de coluna | ✅ | Sem suporte |
| Papéis | ✅ | Sem suporte |
| Planos de recursos do Workload Manager | ✅ | Sem suporte |
| Transações e compactações | ✅ | Sem suporte |
Migrar do metastore do Dataproc
Para fazer upgrade e migrar seus metadados do metastore do Dataproc para o catálogo do ambiente de execução do Lakehouse, consulte Migrar metadados do metastore do Dataproc para o Lakehouse.
A seguir
- Usar o Spark e o Hive com o catálogo do ambiente de execução do Lakehouse.
- Configurar o Spark com tabelas Delta.
- Usar endpoints regionais do Lakehouse.