


Kasus penggunaan
Arsitektur referensi ini mendukung skenario berikut:
- Anda memiliki database yang dapat menoleransi beberapa periode nonaktif dan kehilangan data sejak pencadangan terakhir.
- Anda ingin melindungi database AlloyDB Omni dari error pengguna, kerusakan, atau kegagalan fisik di tingkat database, bukan snapshot image server atau VM.
- Anda ingin memulihkan database di tempat atau dari jarak jauh, mungkin hingga titik waktu tertentu.
Cara kerja arsitektur referensi
Arsitektur referensi Ketersediaan Standar mencakup pencadangan dan pemulihan database AlloyDB Omni Anda.
Meskipun Ketersediaan Standar adalah implementasi dasar dan meminimalkan hardware atau layanan tambahan yang diperlukan, Batas Waktu Pemulihan (RTO) meningkat seiring bertambahnya ukuran database. Makin banyak data yang perlu dicadangkan, makin lama waktu yang diperlukan untuk memulihkan dan memulihkan database. Kehilangan data bergantung pada jenis cadangan. Jika hanya file data yang dicadangkan secara berkala, saat Anda memulihkan, Anda akan mengalami kehilangan data sejak pencadangan terakhir.
Mengurangi RPO
Fitur pengarsipan berkelanjutan PostgreSQL memungkinkan Anda mencapai Toleransi Jumlah Data yang Hilang (RPO) yang rendah dan mengaktifkan pemulihan point-in-time melalui pencadangan. Proses ini melibatkan pengarsipan file Write-Ahead Logging (WAL) dan streaming data WAL, yang berpotensi ke lokasi penyimpanan jarak jauh.
Jika file WAL hanya diarsipkan saat penuh atau pada interval tertentu, kehilangan database secara menyeluruh (termasuk file WAL saat ini) akan membatasi pemulihan ke file WAL terakhir yang diarsipkan, yang berarti RPO Anda harus memperhitungkan potensi kehilangan data. Sebaliknya, transfer data WAL berkelanjutan meminimalkan potensi kehilangan data.
Saat mengonfigurasi pencadangan berkelanjutan, Anda dapat melakukan pemulihan ke titik waktu tertentu. Pemulihan point-in-time memungkinkan Anda memulihkan database ke status sebelum terjadi error, seperti penghapusan tabel yang tidak disengaja atau update batch yang salah. Namun, metode pemulihan ini memengaruhi RPO dan RTO, kecuali jika Anda menggunakan database tambahan sementara. Memulihkan seluruh database secara langsung akan me-roll back transaksi berikutnya pada tabel yang tidak terpengaruh dan membuat database offline, sedangkan memulihkan ke database tambahan sementara memungkinkan Anda hanya menyalin data yang dipulihkan.
Strategi pencadangan
AlloyDB Omni mendukung strategi perlindungan data seperti pencadangan fisik berkala, pemulihan point-in-time, pengarsipan dan streaming WAL, serta penyimpanan cadangan di lokasi yang berbeda. Atau, untuk database kecil, Anda dapat melakukan pencadangan logis menggunakan pg_dump untuk satu database atau pg_dumpall untuk seluruh cluster, dan memulihkan menggunakan pg_restore.
Alat pencadangan
Untuk deployment container dan Linux, Anda dapat menjadwalkan dan mengelola pencadangan menggunakan alat PostgreSQL berikut:
- pgBackRest: untuk mengetahui informasi selengkapnya, lihat Menyiapkan pgBackRest untuk AlloyDB Omni.
- Barman: untuk mengetahui informasi selengkapnya, lihat Menyiapkan Barman untuk AlloyDB Omni.
Bergantung pada opsi deployment, Anda dapat mengonfigurasi AlloyDB Omni untuk menyimpan cadangan di penyimpanan lokal atau jarak jauh, seperti Cloud Storage atau opsi penyimpanan yang disediakan oleh vendor cloud mana pun. Meskipun penyimpanan lokal mungkin lebih cepat untuk pencadangan dan pemulihan, penyimpanan jarak jauh biasanya lebih andal untuk menangani kegagalan saat seluruh host atau VM gagal. Untuk mengetahui informasi selengkapnya, lihat Gambar 1, yang menunjukkan potensi tujuan cadangan.
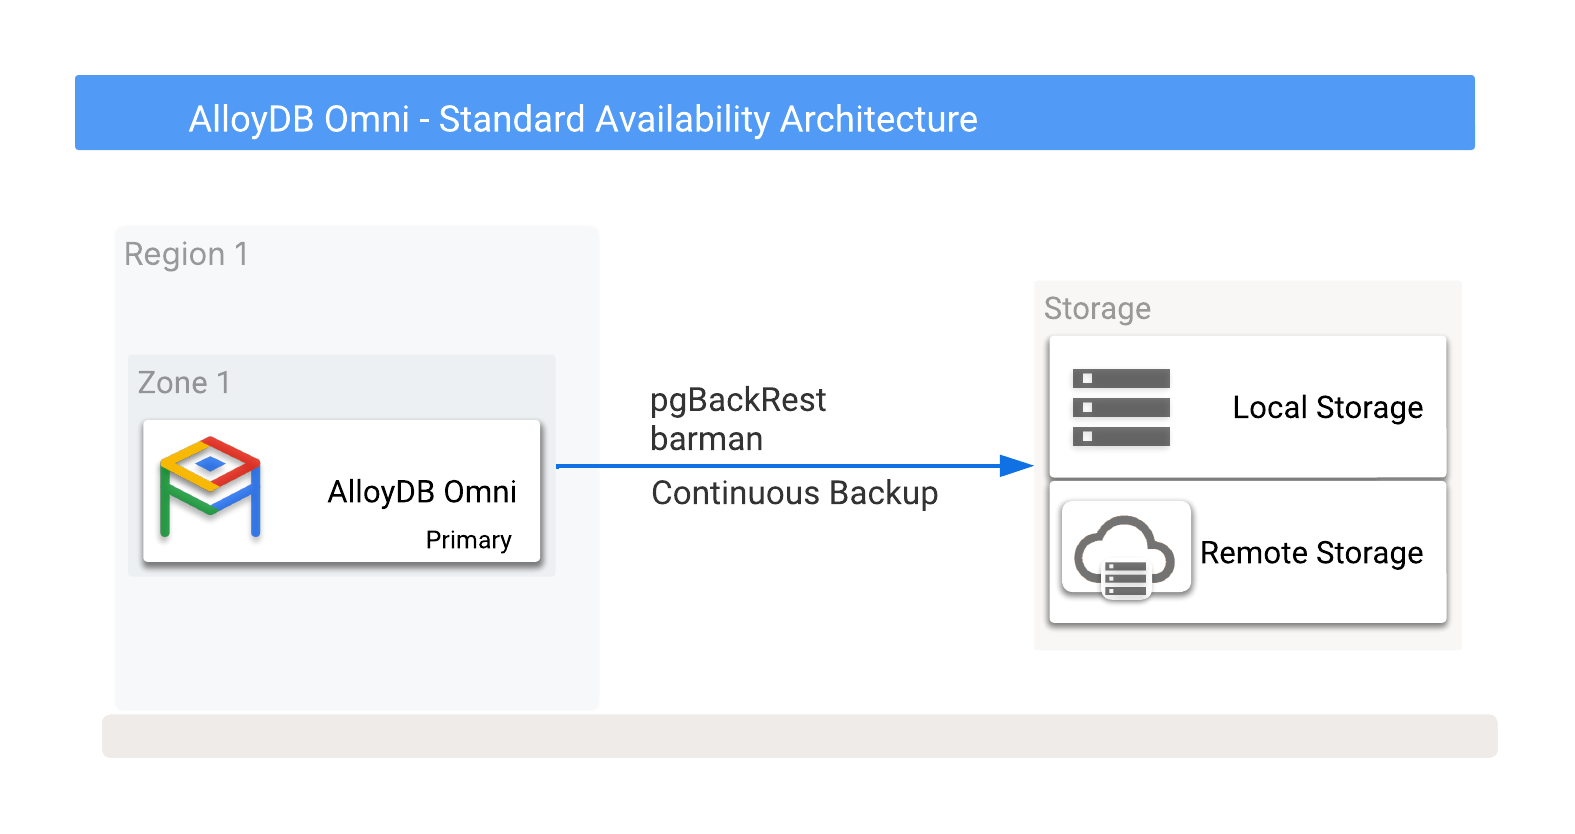
Gambar 1. AlloyDB Omni dengan opsi pencadangan.
Anda dapat melakukan pencadangan ke opsi penyimpanan lokal atau jarak jauh. Pencadangan lokal cenderung lebih cepat karena hanya mengandalkan throughput I/O, sedangkan pencadangan jarak jauh biasanya memiliki latensi yang lebih tinggi dan bandwidth jaringan yang lebih rendah. Namun, pencadangan jarak jauh memberikan perlindungan yang lebih baik terhadap kegagalan host dan zona daripada pencadangan lokal.
Anda juga dapat membagi cadangan lokal menjadi penyimpanan lokal atau penyimpanan bersama. Meskipun penyimpanan lokal tidak memiliki opsi pemulihan dari bencana (disaster recovery) saat host database gagal, penyimpanan bersama memungkinkan Anda merelokasi penyimpanan tersebut ke server lain dan menggunakannya untuk pemulihan. Artinya, penyimpanan bersama berpotensi menawarkan RTO yang lebih cepat.
Untuk deployment penyimpanan lokal, bersama, dan jarak jauh, Anda dapat menjadwalkan jenis pencadangan berikut atau melakukannya secara manual sesuai permintaan:
- Pencadangan penuh: pencadangan lengkap semua file database yang diperlukan untuk pemulihan data.
- Pencadangan diferensial: pencadangan hanya perubahan file sejak pencadangan penuh terakhir.
- Pencadangan inkremental: pencadangan hanya untuk perubahan file sejak pencadangan terakhir dari jenis apa pun.
Pemulihan point-in-time
Pencadangan berkelanjutan file WAL PostgreSQL mendukung pemulihan point-in-time. Jika, setelah peristiwa kegagalan, file WAL masih utuh dan dapat digunakan, Anda dapat menggunakan file ini untuk memulihkan ke titik waktu tertentu dan membantu meminimalkan kehilangan data.
Melakukan streaming data WAL ke lokasi jarak jauh
Bergantung pada alat pencadangan (seperti Barman), Anda dapat mengonfigurasi data WAL untuk melakukan streaming secara real time ke lokasi jarak jauh guna membantu meminimalkan kehilangan data saat pemulihan. Bahkan dengan streaming real-time, ada kemungkinan kecil kehilangan transaksi yang di-commit karena penulisan streaming ke lokasi jarak jauh bersifat asinkron secara default. Namun, Anda dapat mengonfigurasi streaming WAL untuk menggunakan mode sinkron, yang menyimpan data WAL dan mengirim respons status kembali ke database sumber. Perlu diingat bahwa pendekatan ini dapat memperlambat transaksi jika harus menunggu penulisan ini selesai sebelum melanjutkan.
Jadwal pencadangan
Di sebagian besar lingkungan, pencadangan biasanya dijadwalkan setiap minggu. Berikut adalah jadwal pencadangan mingguan yang umum:
- Minggu: pencadangan penuh
- Senin, Selasa: pencadangan inkremental
- Rabu: pencadangan diferensial
- Kamis, Jumat: pencadangan inkremental
- Sabtu: pencadangan diferensial
Dengan menggunakan jadwal umum ini, periode pemulihan berkelanjutan selama satu minggu memerlukan ruang penyimpanan hingga tiga pencadangan penuh ditambah pencadangan inkremental atau pencadangan diferensial yang diperlukan. Pendekatan ini mendukung pemulihan untuk kegagalan yang terjadi selama pencadangan penuh pada hari Minggu, saat pemulihan database harus diperpanjang hingga hari Minggu sebelumnya sebelum pencadangan dimulai.
Untuk meminimalkan RTO dengan potensi RPO yang lebih tinggi, database tambahan dapat beroperasi dalam mode pemulihan berkelanjutan. Mode ini melibatkan pemutaran ulang cadangan dan terus memperbarui lingkungan sekunder dengan mengarsipkan dan memutar ulang file WAL baru. RPO sebenarnya, yang mencerminkan potensi kehilangan data, bergantung pada frekuensi transaksi, ukuran file WAL, dan penggunaan streaming WAL.
Pemulihan cadangan
Anda dapat memulihkan database AlloyDB Omni dari cadangan yang disimpan atau memulihkan ke titik waktu tertentu dalam periode retensi Anda. Bergantung pada lingkungan deployment dan kebutuhan pemulihan, Anda dapat memulihkan data di tempat atau memulihkan cadangan ke instance atau cluster database baru.
Untuk deployment container dan Linux, pemulihan database AlloyDB Omni biasanya melibatkan penghentian layanan atau container database dan pemulihan data ke direktori data yang ada, atau pemulihan data ke lokasi baru dan memulai instance database baru menggunakan data yang dipulihkan tersebut. Untuk mengetahui informasi selengkapnya, lihat Memulihkan cluster AlloyDB Omni menggunakan pgBackRest atau Memulihkan cluster AlloyDB Omni menggunakan Barman.
Penerapan
Saat Anda memilih arsitektur referensi ketersediaan, perhatikan manfaat, batasan, dan alternatif berikut.
Manfaat
- Mudah digunakan dan dikelola, serta cocok untuk database non-kritis dengan RTO dan RPO yang longgar.
- Memerlukan hardware tambahan minimal.
- Menyediakan cadangan dasar yang diperlukan untuk rencana pemulihan dari bencana.
- Mendukung pemulihan ke titik waktu mana pun dalam periode pemulihan.
Batasan
- Dapat memerlukan lebih banyak ruang penyimpanan daripada database itu sendiri, bergantung pada persyaratan retensi Anda.
- Pemulihan bisa lambat dan dapat menghasilkan RTO yang lebih tinggi.
- Dapat mengakibatkan beberapa kehilangan data, bergantung pada ketersediaan data WAL saat ini setelah kegagalan database, yang mungkin berdampak negatif pada RPO.
Alternatif
Pertimbangkan arsitektur referensi Ketersediaan yang Ditingkatkan atau Ketersediaan Premium untuk meningkatkan ketersediaan dan opsi pemulihan dari bencana (disaster recovery).
Langkah berikutnya
- Ringkasan arsitektur referensi ketersediaan AlloyDB Omni
- Ketersediaan yang Ditingkatkan AlloyDB Omni
- Ketersediaan AlloyDB Omni Premium
- Mencadangkan dan memulihkan AlloyDB Omni
- Menyiapkan pgBackRest untuk AlloyDB Omni
- Menyiapkan Barman untuk AlloyDB Omni
- Memulihkan cluster AlloyDB Omni menggunakan pgBackRest
- Memulihkan cluster AlloyDB Omni menggunakan Barman