


חיפוש וקטורי ב-AlloyDB ל-PostgreSQL מאפשר למצוא רשומות דומות מבחינה סמנטית על ידי אחסון הטמעות וקטורים במסד הנתונים ושליחת שאילתות לגביהן. במדריך הזה תגדירו טבלה במסד נתונים, תטענו הטמעות וקטורים לדוגמה, תיצרו אינדקס ScaNN ותריצו שאילתות דמיון וקטורי באמצעות מסוף Google Cloud . הדוגמאות במדריך הזה מיועדות להמחשה בלבד.
במאמר חיפוש וקטורי מסונן ב-AlloyDB ל-PostgreSQL מוסבר איך להשתמש בחיפוש וקטורי מסונן כדי למקד את החיפושים לפי דמיון.
במאמר קדימה, מתחילים: הטמעת וקטורים באמצעות AlloyDB AI מוסבר איך מבצעים חיפוש וקטורי באמצעות הטמעות של Gemini Enterprise Agent Platform.
מטרות
- יוצרים אשכול AlloyDB ומכונה ראשית.
- מתחברים למסד הנתונים ומתקינים את התוספים הנדרשים.
- יוצרים טבלה עם
productו-product inventory. - הוספת נתונים לטבלאות
productו-product inventoryוביצוע חיפוש וקטורי בסיסי. - יוצרים אינדקס ScaNN בטבלת המוצרים.
- לבצע חיפוש וקטורי בסיסי.
- מבצעים חיפוש וקטורי מורכב עם מסנן וצירוף.
עלויות
במסמך הזה משתמשים ברכיבים הבאים של Google Cloud, והשימוש בהם כרוך בתשלום:
בעזרת מחשבון העלויות אתם יכולים להעריך את העלויות בהתאם לשימוש הצפוי.
כשמסיימים את המשימות שמתוארות במסמך הזה אפשר למחוק את המשאבים שיצרתם כדי להימנע מחיובים נוספים. מידע נוסף זמין בקטע הסרת המשאבים.
לפני שמתחילים
הפעלת החיוב וממשקי ה-API הנדרשים
נכנסים לדף Clusters במסוף Google Cloud .
מפעילים את ממשקי ה-API של Cloud שנדרשים כדי ליצור מכונות של AlloyDB ל-PostgreSQL ולהתחבר אליהן.
- בשלב Confirm project, לוחצים על Next כדי לאשר את שם הפרויקט שבו רוצים לבצע שינויים.
בשלב Enable APIs, לוחצים על Enable כדי להפעיל את ממשקי ה-API הבאים:
- AlloyDB API
- Compute Engine API
- Service Networking API
- Agent Platform API
יצירת אשכול AlloyDB ומכונה ראשית
נכנסים לדף Clusters במסוף Google Cloud .
לוחצים על Create cluster.
בשדה Cluster ID, מזינים
my-cluster.מזינים סיסמה. שימו לב לסיסמה הזו, כי תשתמשו בה במדריך הזה.
בוחרים אזור, למשל
us-central1 (Iowa).בוחרים את רשת ברירת המחדל.
אם יש לכם חיבור גישה פרטית, המשיכו לשלב הבא. אם לא, לוחצים על הגדרת חיבור ופועלים לפי השלבים הבאים:
- בקטע Allocate an IP range, לוחצים על Use an automatically allocated IP range.
- לוחצים על המשך ואז על יצירת חיבור.
בקטע Zonal availability, בוחרים באפשרות Single zone.
בוחרים את סוג המכונה
2 vCPU,16 GB.בקטע Connectivity, בוחרים באפשרות Enable public IP.
לוחצים על Create cluster. יכול להיות שיעברו כמה דקות עד ש-AlloyDB ייצור את האשכול ויציג אותו בדף Overview של האשכול הראשי.
בקטע Instances in your cluster, מרחיבים את החלונית Connectivity. שימו לב לConnection URI כי תשתמשו בו במדריך הזה.
ה-URI של החיבור הוא בפורמט
projects/PROJECT_ID/locations/REGION_ID/clusters/my-cluster/instances/my-cluster-primary.
מתן הרשאת משתמש ב-Agent Platform לסוכן השירות של AlloyDB
כדי לאפשר ל-AlloyDB להשתמש במודלים של הטמעת טקסט ב-Agent Platform, צריך להוסיף הרשאות משתמש של Agent Platform לסוכן השירות של AlloyDB בפרויקט שבו נמצאים האשכול והמכונה.
למידע נוסף על הוספת ההרשאות, קראו את המאמר מתן הרשאת משתמש ב-Agent Platform לסוכן השירות של AlloyDB.
התחברות למסד הנתונים באמצעות דפדפן אינטרנט
נכנסים לדף Clusters במסוף Google Cloud .
בעמודה Resource name, לוחצים על שם האשכול,
my-cluster.בחלונית הניווט, לוחצים על AlloyDB Studio.
בדף Sign in to AlloyDB Studio, פועלים לפי השלבים הבאים:
- בוחרים את מסד הנתונים
postgres. - בוחרים את המשתמש
postgres. - מזינים את הסיסמה שיצרתם בקטע יצירת אשכול והמכונה הראשית שלו.
- לוחצים על אימות. בחלונית Explorer מוצגת רשימה של האובייקטים במסד הנתונים
postgres.
- בוחרים את מסד הנתונים
פותחים כרטיסייה חדשה בלחיצה על + New SQL editor tab או על + New tab.
התקנת התוספים הנדרשים
מריצים את השאילתה הבאה כדי להתקין את התוספים vector ו-alloydb_scann:
  CREATE EXTENSION IF NOT EXISTS vector;
  CREATE EXTENSION IF NOT EXISTS alloydb_scann;
הוספת נתונים של מוצרים ושל מלאי מוצרים וביצוע חיפוש וקטורי בסיסי
מריצים את ההצהרה הבאה כדי ליצור טבלת
productשמבצעת את הפעולות הבאות:- שומר פרטי מוצר בסיסיים.
- כוללת עמודת וקטור
embeddingשמחשבת ומאחסנת וקטור הטמעה לתיאור של כל מוצר.
  CREATE TABLE product (
    id INT PRIMARY KEY,
    name VARCHAR(255) NOT NULL,
    description TEXT,
    category VARCHAR(255),
    color VARCHAR(255),
    embedding vector(768) GENERATED ALWAYS AS (embedding('text-embedding-005', description)) STORED
  );
במקרה הצורך, אתם יכולים להשתמש ב-Logs Explorer כדי לצפות ביומנים ולפתור שגיאות.
מריצים את השאילתה הבאה כדי ליצור טבלת
product_inventoryשבה מאוחסן מידע על המלאי הזמין והמחירים המתאימים. במדריך הזה נשתמש בטבלאותproduct_inventoryו-productכדי להריץ שאילתות חיפוש וקטורי מורכבות.CREATE TABLE product_inventory ( id INT PRIMARY KEY, product_id INT REFERENCES product(id), inventory INT, price DECIMAL(10,2) );מריצים את השאילתה הבאה כדי להוסיף נתוני מוצרים לטבלה
product:INSERT INTO product (id, name, description,category, color) VALUES (1, 'Stuffed Elephant', 'Soft plush elephant with floppy ears.', 'Plush Toys', 'Gray'), (2, 'Remote Control Airplane', 'Easy-to-fly remote control airplane.', 'Vehicles', 'Red'), (3, 'Wooden Train Set', 'Classic wooden train set with tracks and trains.', 'Vehicles', 'Multicolor'), (4, 'Kids Tool Set', 'Toy tool set with realistic tools.', 'Pretend Play', 'Multicolor'), (5, 'Play Food Set', 'Set of realistic play food items.', 'Pretend Play', 'Multicolor'), (6, 'Magnetic Tiles', 'Set of colorful magnetic tiles for building.', 'Construction Toys', 'Multicolor'), (7, 'Kids Microscope', 'Microscope for kids with different magnification levels.', 'Educational Toys', 'White'), (8, 'Telescope for Kids', 'Telescope designed for kids to explore the night sky.', 'Educational Toys', 'Blue'), (9, 'Coding Robot', 'Robot that teaches kids basic coding concepts.', 'Educational Toys', 'White'), (10, 'Kids Camera', 'Durable camera for kids to take pictures and videos.', 'Electronics', 'Pink'), (11, 'Walkie Talkies', 'Set of walkie talkies for kids to communicate.', 'Electronics', 'Blue'), (12, 'Karaoke Machine', 'Karaoke machine with built-in microphone and speaker.', 'Electronics', 'Black'), (13, 'Kids Drum Set', 'Drum set designed for kids with adjustable height.', 'Musical Instruments', 'Blue'), (14, 'Kids Guitar', 'Acoustic guitar for kids with nylon strings.', 'Musical Instruments', 'Brown'), (15, 'Kids Keyboard', 'Electronic keyboard with different instrument sounds.', 'Musical Instruments', 'Black'), (16, 'Art Easel', 'Double-sided art easel with chalkboard and whiteboard.', 'Arts & Crafts', 'White'), (17, 'Finger Paints', 'Set of non-toxic finger paints for kids.', 'Arts & Crafts', 'Multicolor'), (18, 'Modeling Clay', 'Set of colorful modeling clay.', 'Arts & Crafts', 'Multicolor'), (19, 'Watercolor Paint Set', 'Watercolor paint set with brushes and palette.', 'Arts & Crafts', 'Multicolor'), (20, 'Beading Kit', 'Kit for making bracelets and necklaces with beads.', 'Arts & Crafts', 'Multicolor'), (21, '3D Puzzle', '3D puzzle of a famous landmark.', 'Puzzles', 'Multicolor'), (22, 'Race Car Track Set', 'Race car track set with cars and accessories.', 'Vehicles', 'Multicolor'), (23, 'RC Monster Truck', 'Remote control monster truck with oversized tires.', 'Vehicles', 'Green'), (24, 'Train Track Expansion Set', 'Expansion set for wooden train tracks.', 'Vehicles', 'Multicolor');אופציונלי: מריצים את השאילתה הבאה כדי לוודא שהנתונים נוספו לטבלה
product:SELECT * FROM product;מריצים את השאילתה הבאה כדי להוסיף את נתוני המלאי לטבלה
product_inventory:INSERT INTO product_inventory (id, product_id, inventory, price) VALUES (1, 1, 9, 13.09), (2, 2, 40, 79.82), (3, 3, 34, 52.49), (4, 4, 9, 12.03), (5, 5, 36, 71.29), (6, 6, 10, 51.49), (7, 7, 7, 37.35), (8, 8, 6, 10.87), (9, 9, 7, 42.47), (10, 10, 3, 24.35), (11, 11, 4, 10.20), (12, 12, 47, 74.57), (13, 13, 5, 28.54), (14, 14, 11, 25.58), (15, 15, 21, 69.84), (16, 16, 6, 47.73), (17, 17, 26, 81.00), (18, 18, 11, 91.60), (19, 19, 8, 78.53), (20, 20, 43, 84.33), (21, 21, 46, 90.01), (22, 22, 6, 49.82), (23, 23, 37, 50.20), (24, 24, 27, 99.27);מריצים את שאילתת החיפוש הווקטורי הבאה, שמנסה למצוא מוצרים שדומים למילה
music. כלומר, למרות שהמילהmusicלא מוזכרת במפורש בתיאור המוצר, בתוצאה מוצגים מוצרים שרלוונטיים לשאילתה:SELECT * FROM product ORDER BY embedding <=> embedding('text-embedding-005', 'music')::vector LIMIT 3;תוצאת השאילתה היא:
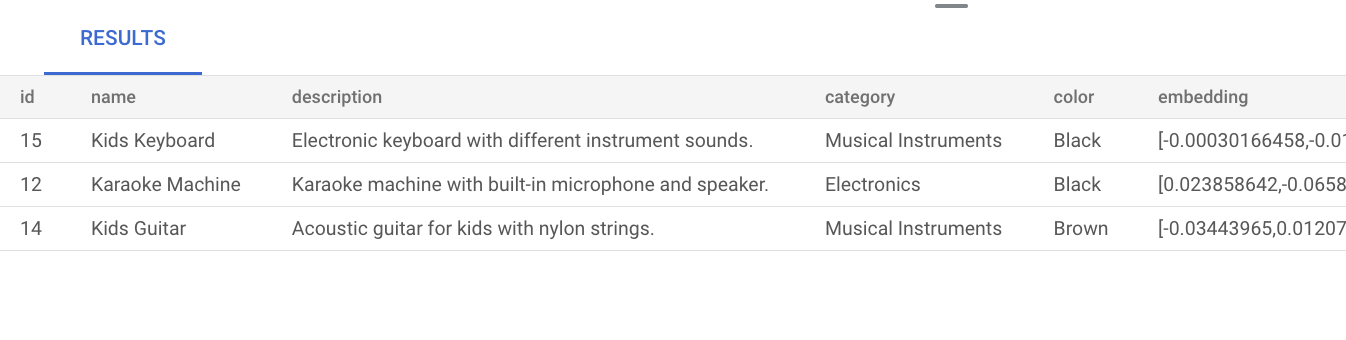
כשמבצעים חיפוש וקטורי בסיסי בלי ליצור אינדקס, המערכת משתמשת בחיפוש מדויק של השכן הקרוב ביותר (KNN), שמספק אחזור יעיל. בקנה מידה גדול, השימוש ב-KNN עלול להשפיע על הביצועים. כדי לשפר את ביצועי השאילתות, מומלץ להשתמש באינדקס ScaNN לחיפוש של השכן הקרוב ביותר (ANN), שמספק רמת זכירה גבוהה עם זמני אחזור קצרים.
אם לא יוצרים אינדקס, AlloyDB משתמש כברירת מחדל בחיפוש השכן הקרוב ביותר (KNN).
למידע נוסף על השימוש ב-ScaNN בקנה מידה גדול, קראו את המאמר קדימה, מתחילים: הטמעת וקטורים באמצעות AlloyDB AI.
יצירת אינדקס ScaNN בכוונון ידני בטבלת המוצרים
מריצים את השאילתה הבאה כדי ליצור אינדקס ScaNN של product_index בטבלה product:
CREATE INDEX product_index ON product
USING scann (embedding cosine)
WITH (mode='MANUAL', num_leaves=4);
למידע נוסף על יצירת אינדקס ScaNN, ראו יצירת אינדקס ScaNN.
ביצוע חיפוש וקטורי
מריצים את שאילתת החיפוש הווקטורי הבאה, שמנסה למצוא מוצרים שדומים לשאילתת השפה הטבעית music. למרות שהמילה music לא נכללת בתיאור המוצר, התוצאה מציגה מוצרים שרלוונטיים לשאילתה:
SET LOCAL scann.num_leaves_to_search = 2;
SELECT * FROM product
ORDER BY embedding <=> embedding('text-embedding-005', 'music')::vector
LIMIT 3;
אלה תוצאות השאילתה:
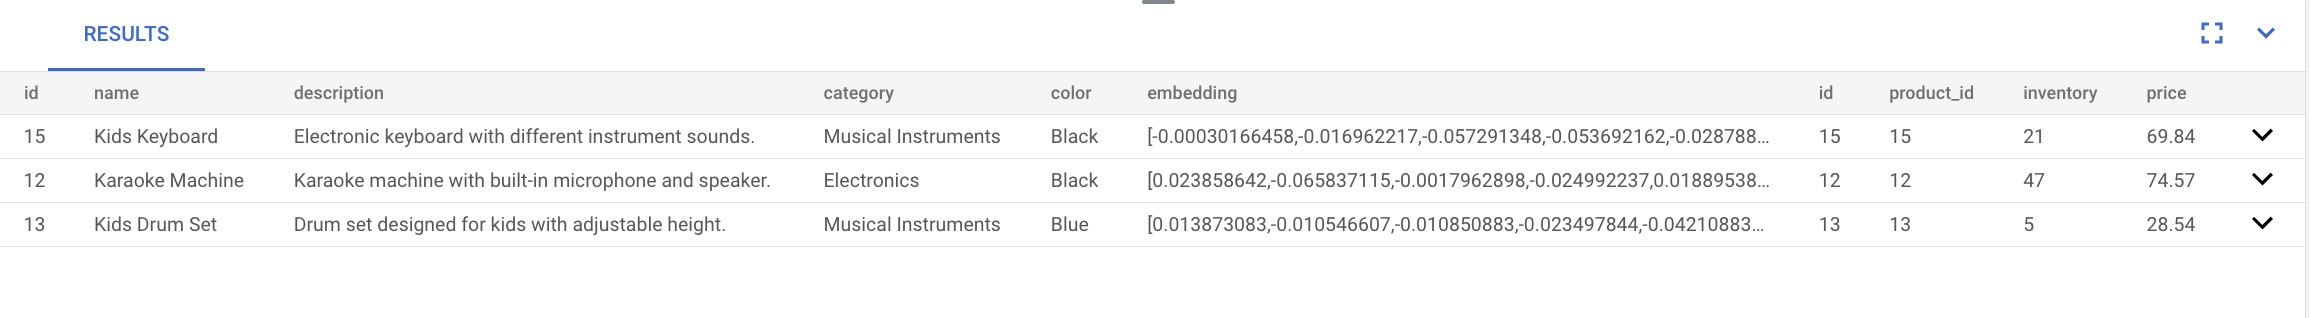
הפרמטר scann.num_leaves_to_search של השאילתה קובע את מספר צומתי העלים שבהם מתבצע חיפוש במהלך חיפוש דמיון. ערכי הפרמטרים num_leaves ו-scann.num_leaves_to_search עוזרים להשיג איזון בין הביצועים לבין ה-recall.
ביצוע חיפוש וקטורי באמצעות מסנן וצירוף
אתם יכולים להריץ ביעילות שאילתות חיפוש וקטורי מסוננות גם כשאתם משתמשים באינדקס ScaNN. מריצים את שאילתת החיפוש הווקטורי המורכבת הבאה, שמחזירה תוצאות רלוונטיות שעומדות בתנאי השאילתה, גם עם מסננים:
SET LOCAL scann.num_leaves_to_search = 2;

SELECT * FROM product p
JOIN product_inventory pi ON p.id = pi.product_id
WHERE pi.price < 80.00
ORDER BY embedding <=> embedding('text-embedding-005', 'music')::vector
LIMIT 3;
איך להאיץ את החיפוש הווקטורי המסונן
אתם יכולים להשתמש במאגר התוכן של המנוע מבוסס-העמודות כדי לשפר את הביצועים של חיפושי דמיון וקטורי, במיוחד חיפושי K-Nearest Neighbor (KNN), בשילוב עם סינון פרדיקטים סלקטיבי מאוד – לדוגמה, באמצעות LIKE – במסדי נתונים. בקטע הזה משתמשים בתוסף vector ובתוסף google_columnar_engine של AlloyDB.
למידע נוסף על אופן הפעולה של המנוע מבוסס-העמודות, קראו את המאמר מידע על המנוע מבוסס-העמודות של AlloyDB.
השיפורים בביצועים נובעים מהיעילות המובנית של המנוע מבוסס-העמודות בסריקת מערכי נתונים גדולים ובהחלת מסננים, כמו פרדיקטים של LIKE, בשילוב עם היכולת שלו לסנן שורות מראש באמצעות תמיכה בווקטורים. הפונקציונליות הזו מצמצמת את מספר קבוצות המשנה של הנתונים שנדרשות לחישובים הבאים של מרחק וקטורי ב-KNN, ועוזרת לבצע אופטימיזציה של שאילתות ניתוח מורכבות שכוללות סינון רגיל וחיפוש וקטורי.
במאגר הנתונים העמודתי יש שתי אפשרויות לניהול התוכן:
- ניהול אוטומטי של התוכן במאגר העמודות: במכונות חדשות של AlloyDB, הארגון האוטומטי בעמודות מופעל כברירת מחדל. לחלופין, אתם יכולים להפעיל באופן ידני את הפונקציונליות של ארגון אוטומטי בעמודות.
- ניהול ידני של התוכן במאגר העמודות: אם אתם צריכים לנהל באופן ידני את העמודות במאגר העמודות של עומס העבודה, אתם יכולים להשבית את הארגון האוטומטי בעמודות.
כדי להשוות את זמן הביצוע של חיפוש וקטורי של KNN שמסונן לפי פרדיקט LIKE לפני ואחרי שמפעילים את המנוע מבוסס-העמודות:
מפעילים את התוסף
vectorכדי לתמוך בסוגי נתונים ופעולות של וקטורים. מריצים את ההצהרות הבאות כדי ליצור טבלה לדוגמה (items) עם מזהה, תיאור טקסט ועמודה של הטמעת וקטורים עם 512 מאפיינים.CREATE EXTENSION IF NOT EXISTS vector; CREATE TABLE items ( id SERIAL PRIMARY KEY, description TEXT, embedding VECTOR(512) );כדי לאכלס את הנתונים, מריצים את ההצהרות הבאות כדי להוסיף מיליון שורות לטבלת הדוגמה
items.-- Simplified example of inserting matching (~0.1%) and non-matching data INSERT INTO items (description, embedding) SELECT CASE WHEN g % 1000 = 0 THEN 'product_' || md5(random()::text) || '_common' -- ~0.1% match ELSE 'generic_item_' || g || '_' || md5(random()::text) -- ~99.9% don't match END, random_vector(512) -- Assumes random_vector function exists FROM generate_series(1, 999999) g;מודדים את הביצועים הבסיסיים של חיפוש הדמיון הווקטורי בלי המנוע מבוסס-העמודות.
SELECT id, description, embedding <-> '[...]' AS distance
FROM items
WHERE description LIKE '%product_%_common%'
ORDER BY embedding <-> '[...]'
LIMIT 100;
כדי להפעיל את המנוע מבוסס-העמודות ואת התמיכה בווקטורים, מריצים את הפקודה הבאה ב-Google Cloud CLI. כדי להשתמש ב-CLI של gcloud, אתם יכולים להתקין ולהפעיל אותו.
gcloud alloydb instances update INSTANCE_ID \
    --cluster=CLUSTER_ID \
    --region=REGION_ID \
    --project=PROJECT_ID \
    --database-flags=google_columnar_engine.enabled=on,google_columnar_engine.enable_vector_support=on
מחליפים את מה שכתוב בשדות הבאים:
-
INSTANCE_ID: מזהה המכונה. -
CLUSTER_ID: מזהה האשכול. -
REGION_ID: האזור שבו נמצא האשכול. -
PROJECT_ID: מזהה הפרויקט שבו נמצא האשכול.
-
מוסיפים את הטבלה
itemsלמנוע מבוסס-העמודות:SELECT google_columnar_engine_add('items');מודדים את הביצועים של חיפוש הדמיון הווקטורי באמצעות המנוע מבוסס-העמודות. מריצים מחדש את השאילתה שהרצתם קודם כדי למדוד את הביצועים הבסיסיים.
SELECT id, description, embedding <-> '[...]' AS distance
FROM items
WHERE description LIKE '%product_%_common%'
ORDER BY embedding <-> '[...]'
LIMIT 100;
כדי לבדוק אם השאילתה הופעלה באמצעות המנוע מבוסס-העמודות, מריצים את הפקודה הבאה:
explain (analyze) SELECT id, description, embedding <-> '[...]' AS distance
FROM items
WHERE description LIKE '%product_%_common%'
ORDER BY embedding <-> '[...]'
LIMIT 100;
הסרת המשאבים
נכנסים לדף Clusters במסוף Google Cloud .
בעמודה Resource name, לוחצים על שם האשכול,
my-cluster.לוחצים על delete Delete cluster.
בתיבת הדו-שיח Delete cluster my-cluster, מזינים
my-clusterכדי לאשר את מחיקת האשכול.לוחצים על Delete.
אם יצרתם חיבור פרטי כשיצרתם אשכול, נכנסים לדף Networking במסוף Google Cloud ולוחצים על Delete VPC network.
המאמרים הבאים
- תרחישים לדוגמה של חיפוש וקטורי בעולם האמיתי
- קדימה, מתחילים: הטמעת וקטורים באמצעות AlloyDB AI
- איך מפתחים אפליקציות של AI גנרטיבי באמצעות AlloyDB AI
- יצירת אינדקס ScaNN.
- כוונון של אינדקסי ScaNN.
- איך יוצרים עוזר חכם לשופינג באמצעות AlloyDB, pgvector וניהול נקודות קצה של מודלים
- האצת החיפוש הווקטורי באמצעות המנוע מבוסס-העמודות.