זיהוי כתב יד בתמונות

זיהוי כתב יד באמצעות זיהוי תווים אופטי (OCR)

‫Vision API יכול לזהות ולחלץ טקסט מתמונות:

  • ‫DOCUMENT_TEXT_DETECTION שולף טקסט מתמונה (או מקובץ); התשובה עברה אופטימיזציה לטקסט ולמסמכים עמוסים. ה-JSON כולל מידע על הדף, הבלוק, הפסקה, המילה והמעבר.
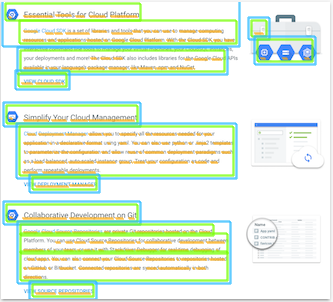
    צילום מסך שמדמה איך מערכת OCR יכולה לזהות ולחלץ טקסט, עם הדגשה של כותרות, פסקאות וסמלים.

    שימוש ספציפי אחד ב-DOCUMENT_TEXT_DETECTION הוא זיהוי כתב יד בתמונה.
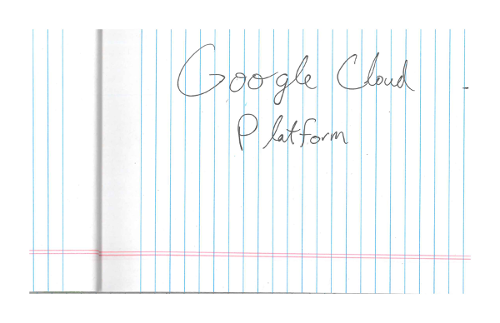
    דף משבצות עם הכיתוב Google Cloud Platform בכתב מחובר.

נסו בעצמכם

אנחנו ממליצים למשתמשים חדשים ב-Google Cloud ליצור חשבון כדי שיוכלו להעריך את הביצועים של Cloud Vision API בתרחישים מהעולם האמיתי. לקוחות חדשים מקבלים בחינם גם קרדיט בשווי 300 $להרצה, לבדיקה ולפריסה של עומסי העבודה.

התנסות ב-Cloud Vision API בחינם

בקשות לזיהוי טקסט במסמך

הגדרה של Google Cloud הפרויקט והאימות

זיהוי טקסט של מסמך בתמונה מקומית

אתם יכולים להשתמש ב-Vision API כדי לבצע זיהוי תכונות בקובץ תמונה מקומי.

בבקשות REST, שולחים את התוכן של קובץ התמונה כמחרוזת בקידוד base64 בגוף הבקשה.

בבקשות של gcloud וספריית הלקוח, צריך לציין את הנתיב לתמונה מקומית בבקשה.

REST

לפני שמשתמשים בנתוני הבקשה, צריך להחליף את הנתונים הבאים:

  • ‫BASE64_ENCODED_IMAGE: ייצוג base64 (מחרוזת ASCII) של נתוני התמונה הבינאריים. המחרוזת הזו צריכה להיראות כמו המחרוזת הבאה:
    • /9j/4QAYRXhpZgAA...9tAVx/zDQDlGxn//2Q==
    מידע נוסף זמין בנושא קידוד base64.
  • ‫PROJECT_ID: מזהה הפרויקט ב- Google Cloud .

ה-method של ה-HTTP וכתובת ה-URL:

POST https://vision.googleapis.com/v1/images:annotate

גוף בקשת JSON:

{
  "requests": [
    {
      "image": {
        "content": "BASE64_ENCODED_IMAGE"
      },
      "features": [
        {
          "type": "DOCUMENT_TEXT_DETECTION"
        }
      ]
    }
  ]
}

כדי לשלוח את הבקשה עליכם לבחור אחת מהאפשרויות הבאות:

curl

שומרים את גוף הבקשה בקובץ בשם request.json ומריצים את הפקודה הבאה:

curl -X POST \
-H "Authorization: Bearer $(gcloud auth print-access-token)" \
-H "x-goog-user-project: PROJECT_ID" \
-H "Content-Type: application/json; charset=utf-8" \
-d @request.json \
"https://vision.googleapis.com/v1/images:annotate"

PowerShell

שומרים את גוף הבקשה בקובץ בשם request.json ומריצים את הפקודה הבאה:

$cred = gcloud auth print-access-token
$headers = @{ "Authorization" = "Bearer $cred"; "x-goog-user-project" = "PROJECT_ID" }

Invoke-WebRequest `
-Method POST `
-Headers $headers `
-ContentType: "application/json; charset=utf-8" `
-InFile request.json `
-Uri "https://vision.googleapis.com/v1/images:annotate" | Select-Object -Expand Content

אם הבקשה מצליחה, השרת מחזיר קוד סטטוס 200 OK של HTTP ואת התשובה בפורמט JSON.

Go

לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Goהוראות ההגדרה שבמדריך לתחילת העבודה עם Vision באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של Vision Go API.

כדי לבצע אימות ב-Vision, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לסביבת פיתוח מקומית.


// detectDocumentText gets the full document text from the Vision API for an image at the given file path.
func detectDocumentText(w io.Writer, file string) error {
	ctx := context.Background()

	client, err := vision.NewImageAnnotatorClient(ctx)
	if err != nil {
		return err
	}

	f, err := os.Open(file)
	if err != nil {
		return err
	}
	defer f.Close()

	image, err := vision.NewImageFromReader(f)
	if err != nil {
		return err
	}
	annotation, err := client.DetectDocumentText(ctx, image, nil)
	if err != nil {
		return err
	}

	if annotation == nil {
		fmt.Fprintln(w, "No text found.")
	} else {
		fmt.Fprintln(w, "Document Text:")
		fmt.Fprintf(w, "%q\n", annotation.Text)

		fmt.Fprintln(w, "Pages:")
		for _, page := range annotation.Pages {
			fmt.Fprintf(w, "\tConfidence: %f, Width: %d, Height: %d\n", page.Confidence, page.Width, page.Height)
			fmt.Fprintln(w, "\tBlocks:")
			for _, block := range page.Blocks {
				fmt.Fprintf(w, "\t\tConfidence: %f, Block type: %v\n", block.Confidence, block.BlockType)
				fmt.Fprintln(w, "\t\tParagraphs:")
				for _, paragraph := range block.Paragraphs {
					fmt.Fprintf(w, "\t\t\tConfidence: %f", paragraph.Confidence)
					fmt.Fprintln(w, "\t\t\tWords:")
					for _, word := range paragraph.Words {
						symbols := make([]string, len(word.Symbols))
						for i, s := range word.Symbols {
							symbols[i] = s.Text
						}
						wordText := strings.Join(symbols, "")
						fmt.Fprintf(w, "\t\t\t\tConfidence: %f, Symbols: %s\n", word.Confidence, wordText)
					}
				}
			}
		}
	}

	return nil
}

Java

לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במאמר התחלת העבודה עם Vision API באמצעות ספריות לקוח. מידע נוסף מופיע ב מאמרי העזרה של Vision API Java.

public static void detectDocumentText(String filePath) throws IOException {
  List<AnnotateImageRequest> requests = new ArrayList<>();

  ByteString imgBytes = ByteString.readFrom(new FileInputStream(filePath));

  Image img = Image.newBuilder().setContent(imgBytes).build();
  Feature feat = Feature.newBuilder().setType(Type.DOCUMENT_TEXT_DETECTION).build();
  AnnotateImageRequest request =
      AnnotateImageRequest.newBuilder().addFeatures(feat).setImage(img).build();
  requests.add(request);

  // Initialize client that will be used to send requests. This client only needs to be created
  // once, and can be reused for multiple requests. After completing all of your requests, call
  // the "close" method on the client to safely clean up any remaining background resources.
  try (ImageAnnotatorClient client = ImageAnnotatorClient.create()) {
    BatchAnnotateImagesResponse response = client.batchAnnotateImages(requests);
    List<AnnotateImageResponse> responses = response.getResponsesList();
    client.close();

    for (AnnotateImageResponse res : responses) {
      if (res.hasError()) {
        System.out.format("Error: %s%n", res.getError().getMessage());
        return;
      }

      // For full list of available annotations, see http://g.co/cloud/vision/docs
      TextAnnotation annotation = res.getFullTextAnnotation();
      for (Page page : annotation.getPagesList()) {
        String pageText = "";
        for (Block block : page.getBlocksList()) {
          String blockText = "";
          for (Paragraph para : block.getParagraphsList()) {
            String paraText = "";
            for (Word word : para.getWordsList()) {
              String wordText = "";
              for (Symbol symbol : word.getSymbolsList()) {
                wordText = wordText + symbol.getText();
                System.out.format(
                    "Symbol text: %s (confidence: %f)%n",
                    symbol.getText(), symbol.getConfidence());
              }
              System.out.format(
                  "Word text: %s (confidence: %f)%n%n", wordText, word.getConfidence());
              paraText = String.format("%s %s", paraText, wordText);
            }
            // Output Example using Paragraph:
            System.out.println("%nParagraph: %n" + paraText);
            System.out.format("Paragraph Confidence: %f%n", para.getConfidence());
            blockText = blockText + paraText;
          }
          pageText = pageText + blockText;
        }
      }
      System.out.println("%nComplete annotation:");
      System.out.println(annotation.getText());
    }
  }
}

Node.js

לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Node.jsהוראות ההגדרה שבמדריך לתחילת העבודה עם Vision באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של Vision Node.js API.

כדי לבצע אימות ב-Vision, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לסביבת פיתוח מקומית.


// Imports the Google Cloud client library
const vision = require('@google-cloud/vision');

// Creates a client
const client = new vision.ImageAnnotatorClient();

/**
 * TODO(developer): Uncomment the following line before running the sample.
 */
// const fileName = 'Local image file, e.g. /path/to/image.png';

// Read a local image as a text document
const [result] = await client.documentTextDetection(fileName);
const fullTextAnnotation = result.fullTextAnnotation;
console.log(`Full text: ${fullTextAnnotation.text}`);
fullTextAnnotation.pages.forEach(page => {
  page.blocks.forEach(block => {
    console.log(`Block confidence: ${block.confidence}`);
    block.paragraphs.forEach(paragraph => {
      console.log(`Paragraph confidence: ${paragraph.confidence}`);
      paragraph.words.forEach(word => {
        const wordText = word.symbols.map(s => s.text).join('');
        console.log(`Word text: ${wordText}`);
        console.log(`Word confidence: ${word.confidence}`);
        word.symbols.forEach(symbol => {
          console.log(`Symbol text: ${symbol.text}`);
          console.log(`Symbol confidence: ${symbol.confidence}`);
        });
      });
    });
  });
});

Python

לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Pythonהוראות ההגדרה שבמדריך לתחילת העבודה עם Vision באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של Vision Python API.

כדי לבצע אימות ב-Vision, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לסביבת פיתוח מקומית.

def detect_document(path):
    """Detects document features in an image."""
    from google.cloud import vision

    client = vision.ImageAnnotatorClient()

    with open(path, "rb") as image_file:
        content = image_file.read()

    image = vision.Image(content=content)

    response = client.document_text_detection(image=image)

    for page in response.full_text_annotation.pages:
        for block in page.blocks:
            print(f"\nBlock confidence: {block.confidence}\n")

            for paragraph in block.paragraphs:
                print("Paragraph confidence: {}".format(paragraph.confidence))

                for word in paragraph.words:
                    word_text = "".join([symbol.text for symbol in word.symbols])
                    print(
                        "Word text: {} (confidence: {})".format(
                            word_text, word.confidence
                        )
                    )

                    for symbol in word.symbols:
                        print(
                            "\tSymbol: {} (confidence: {})".format(
                                symbol.text, symbol.confidence
                            )
                        )

    if response.error.message:
        raise Exception(
            "{}\nFor more info on error messages, check: "
            "https://cloud.google.com/apis/design/errors".format(response.error.message)
        )

שפות נוספות

‫C#‎: צריך לפעול לפי הוראות ההגדרה של C# ‎ בדף של ספריות הלקוח ואז לעבור אל מאמרי העזרה של Vision בנושא ‎ .NET.

‫PHP: פועלים לפי הוראות ההגדרה של PHP בדף של ספריות הלקוח ואז עוברים אל מסמכי העזר של Vision ל-PHP.

‫Ruby: פועלים לפי הוראות ההגדרה של Ruby בדף ספריות הלקוח, ואז עוברים אל מאמרי העזרה של Vision ל-Ruby.

זיהוי טקסט במסמך בתמונה מרוחקת

אתם יכולים להשתמש ב-Vision API כדי לבצע זיהוי תכונות בקובץ תמונה מרוחק שנמצא ב-Cloud Storage או באינטרנט. כדי לשלוח בקשה לקובץ מרוחק, צריך לציין את כתובת ה-URL או את ה-URI של Cloud Storage של הקובץ בגוף הבקשה.

REST

לפני שמשתמשים בנתוני הבקשה, צריך להחליף את הנתונים הבאים:

  • ‫CLOUD_STORAGE_IMAGE_URI: הנתיב לקובץ תמונה תקין בקטגוריה של Cloud Storage. צריכות להיות לכם לפחות הרשאות קריאה לקובץ. דוגמה:
    • gs://cloud-samples-data/vision/handwriting_image.png
  • ‫PROJECT_ID: מזהה הפרויקט ב- Google Cloud .

ה-method של ה-HTTP וכתובת ה-URL:

POST https://vision.googleapis.com/v1/images:annotate

גוף בקשת JSON:

{
  "requests": [
    {
      "image": {
        "source": {
          "imageUri": "CLOUD_STORAGE_IMAGE_URI"
        }
       },
       "features": [
         {
           "type": "DOCUMENT_TEXT_DETECTION"
         }
       ]
    }
  ]
}

כדי לשלוח את הבקשה עליכם לבחור אחת מהאפשרויות הבאות:

curl

שומרים את גוף הבקשה בקובץ בשם request.json ומריצים את הפקודה הבאה:

curl -X POST \
-H "Authorization: Bearer $(gcloud auth print-access-token)" \
-H "x-goog-user-project: PROJECT_ID" \
-H "Content-Type: application/json; charset=utf-8" \
-d @request.json \
"https://vision.googleapis.com/v1/images:annotate"

PowerShell

שומרים את גוף הבקשה בקובץ בשם request.json ומריצים את הפקודה הבאה:

$cred = gcloud auth print-access-token
$headers = @{ "Authorization" = "Bearer $cred"; "x-goog-user-project" = "PROJECT_ID" }

Invoke-WebRequest `
-Method POST `
-Headers $headers `
-ContentType: "application/json; charset=utf-8" `
-InFile request.json `
-Uri "https://vision.googleapis.com/v1/images:annotate" | Select-Object -Expand Content

אם הבקשה מצליחה, השרת מחזיר קוד סטטוס 200 OK של HTTP ואת התשובה בפורמט JSON.

Go

לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Goהוראות ההגדרה שבמדריך לתחילת העבודה עם Vision באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של Vision Go API.

כדי לבצע אימות ב-Vision, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לסביבת פיתוח מקומית.


// detectDocumentText gets the full document text from the Vision API for an image at the given file path.
func detectDocumentTextURI(w io.Writer, file string) error {
	ctx := context.Background()

	client, err := vision.NewImageAnnotatorClient(ctx)
	if err != nil {
		return err
	}

	image := vision.NewImageFromURI(file)
	annotation, err := client.DetectDocumentText(ctx, image, nil)
	if err != nil {
		return err
	}

	if annotation == nil {
		fmt.Fprintln(w, "No text found.")
	} else {
		fmt.Fprintln(w, "Document Text:")
		fmt.Fprintf(w, "%q\n", annotation.Text)

		fmt.Fprintln(w, "Pages:")
		for _, page := range annotation.Pages {
			fmt.Fprintf(w, "\tConfidence: %f, Width: %d, Height: %d\n", page.Confidence, page.Width, page.Height)
			fmt.Fprintln(w, "\tBlocks:")
			for _, block := range page.Blocks {
				fmt.Fprintf(w, "\t\tConfidence: %f, Block type: %v\n", block.Confidence, block.BlockType)
				fmt.Fprintln(w, "\t\tParagraphs:")
				for _, paragraph := range block.Paragraphs {
					fmt.Fprintf(w, "\t\t\tConfidence: %f", paragraph.Confidence)
					fmt.Fprintln(w, "\t\t\tWords:")
					for _, word := range paragraph.Words {
						symbols := make([]string, len(word.Symbols))
						for i, s := range word.Symbols {
							symbols[i] = s.Text
						}
						wordText := strings.Join(symbols, "")
						fmt.Fprintf(w, "\t\t\t\tConfidence: %f, Symbols: %s\n", word.Confidence, wordText)
					}
				}
			}
		}
	}

	return nil
}

Java

לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במדריך למתחילים של Vision API באמצעות ספריות לקוח. מידע נוסף מופיע ב מאמרי העזרה של Vision API Java.

public static void detectDocumentTextGcs(String gcsPath) throws IOException {
  List<AnnotateImageRequest> requests = new ArrayList<>();

  ImageSource imgSource = ImageSource.newBuilder().setGcsImageUri(gcsPath).build();
  Image img = Image.newBuilder().setSource(imgSource).build();
  Feature feat = Feature.newBuilder().setType(Type.DOCUMENT_TEXT_DETECTION).build();
  AnnotateImageRequest request =
      AnnotateImageRequest.newBuilder().addFeatures(feat).setImage(img).build();
  requests.add(request);

  // Initialize client that will be used to send requests. This client only needs to be created
  // once, and can be reused for multiple requests. After completing all of your requests, call
  // the "close" method on the client to safely clean up any remaining background resources.
  try (ImageAnnotatorClient client = ImageAnnotatorClient.create()) {
    BatchAnnotateImagesResponse response = client.batchAnnotateImages(requests);
    List<AnnotateImageResponse> responses = response.getResponsesList();
    client.close();

    for (AnnotateImageResponse res : responses) {
      if (res.hasError()) {
        System.out.format("Error: %s%n", res.getError().getMessage());
        return;
      }
      // For full list of available annotations, see http://g.co/cloud/vision/docs
      TextAnnotation annotation = res.getFullTextAnnotation();
      for (Page page : annotation.getPagesList()) {
        String pageText = "";
        for (Block block : page.getBlocksList()) {
          String blockText = "";
          for (Paragraph para : block.getParagraphsList()) {
            String paraText = "";
            for (Word word : para.getWordsList()) {
              String wordText = "";
              for (Symbol symbol : word.getSymbolsList()) {
                wordText = wordText + symbol.getText();
                System.out.format(
                    "Symbol text: %s (confidence: %f)%n",
                    symbol.getText(), symbol.getConfidence());
              }
              System.out.format(
                  "Word text: %s (confidence: %f)%n%n", wordText, word.getConfidence());
              paraText = String.format("%s %s", paraText, wordText);
            }
            // Output Example using Paragraph:
            System.out.println("%nParagraph: %n" + paraText);
            System.out.format("Paragraph Confidence: %f%n", para.getConfidence());
            blockText = blockText + paraText;
          }
          pageText = pageText + blockText;
        }
      }
      System.out.println("%nComplete annotation:");
      System.out.println(annotation.getText());
    }
  }
}

Node.js

לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Node.jsהוראות ההגדרה שבמדריך לתחילת העבודה עם Vision באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של Vision Node.js API.

כדי לבצע אימות ב-Vision, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לסביבת פיתוח מקומית.


// Imports the Google Cloud client libraries
const vision = require('@google-cloud/vision');

// Creates a client
const client = new vision.ImageAnnotatorClient();

/**
 * TODO(developer): Uncomment the following lines before running the sample.
 */
// const bucketName = 'Bucket where the file resides, e.g. my-bucket';
// const fileName = 'Path to file within bucket, e.g. path/to/image.png';

// Read a remote image as a text document
const [result] = await client.documentTextDetection(
  `gs://${bucketName}/${fileName}`
);
const fullTextAnnotation = result.fullTextAnnotation;
console.log(fullTextAnnotation.text);

Python

לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Pythonהוראות ההגדרה שבמדריך לתחילת העבודה עם Vision באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של Vision Python API.

כדי לבצע אימות ב-Vision, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לסביבת פיתוח מקומית.

def detect_document_uri(uri):
    """Detects document features in the file located in Google Cloud
    Storage."""
    from google.cloud import vision

    client = vision.ImageAnnotatorClient()
    image = vision.Image()
    image.source.image_uri = uri

    response = client.document_text_detection(image=image)

    for page in response.full_text_annotation.pages:
        for block in page.blocks:
            print(f"\nBlock confidence: {block.confidence}\n")

            for paragraph in block.paragraphs:
                print("Paragraph confidence: {}".format(paragraph.confidence))

                for word in paragraph.words:
                    word_text = "".join([symbol.text for symbol in word.symbols])
                    print(
                        "Word text: {} (confidence: {})".format(
                            word_text, word.confidence
                        )
                    )

                    for symbol in word.symbols:
                        print(
                            "\tSymbol: {} (confidence: {})".format(
                                symbol.text, symbol.confidence
                            )
                        )

    if response.error.message:
        raise Exception(
            "{}\nFor more info on error messages, check: "
            "https://cloud.google.com/apis/design/errors".format(response.error.message)
        )

gcloud

כדי לבצע זיהוי של כתב יד, משתמשים בפקודה gcloud ml vision detect-document כמו בדוגמה הבאה:

gcloud ml vision detect-document gs://cloud-samples-data/vision/handwriting_image.png

שפות נוספות

C#‎: פעלו לפי הוראות ההגדרה של C# ‎ בדף ספריות הלקוח, ואז עיינו ב מאמרי העזרה של Vision ל-‎ .NET.

‫PHP: פועלים לפי הוראות ההגדרה של PHP בדף של ספריות הלקוח ואז עוברים אל מסמכי העזר של Vision ל-PHP.

‫Ruby: פועלים לפי הוראות ההגדרה של Ruby בדף של ספריות הלקוח ואז עוברים אל מאמרי העזרה של Vision בנושא Ruby.

מציינים את השפה (אופציונלי)

שני סוגי הבקשות ל-OCR תומכים בשפה אחת או יותר (languageHints) שמציינות את שפת הטקסט בתמונה. עם זאת, בדרך כלל התוצאות הכי טובות מתקבלות כשמשאירים את הערך ריק, כי השמטת הערך מאפשרת זיהוי שפה אוטומטי. בשפות שמבוססות על האלפבית הלטיני, אין צורך להגדיר את languageHints. במקרים נדירים, כשהשפה של הטקסט בתמונה ידועה, הגדרת רמז עוזרת לקבל תוצאות טובות יותר (אם כי היא יכולה להפריע באופן משמעותי אם הרמז שגוי). זיהוי הטקסט מחזיר שגיאה אם אחת או יותר מהשפות שצוינו לא נכללות בשפות הנתמכות.

אם אתם רוצים לספק רמז לשפה, צריך לשנות את גוף הבקשה (קובץ request.json) כדי לספק את המחרוזת של אחת מהשפות הנתמכות בשדה imageContext.languageHints, כמו בדוגמה הבאה:

{
  "requests": [
    {
      "image": {
        "source": {
          "imageUri": "IMAGE_URL"
        }
      },
      "features": [
        {
          "type": "DOCUMENT_TEXT_DETECTION"
        }
      ],
      "imageContext": {
        "languageHints": ["en-t-i0-handwrit"]
      }
    }
  ]
}

תמיכה במספר אזורים

עכשיו אפשר לציין אחסון נתונים ועיבוד OCR ברמת היבשת. נכון לעכשיו, האזורים הבאים נתמכים:

  • ‫us: ארה"ב בלבד
  • eu: האיחוד האירופי

מיקומים

‫Cloud Vision מאפשר לכם לקבוע איפה המשאבים של הפרויקט יאוחסנו ויעובדו. בפרט, אתם יכולים להגדיר את Cloud Vision כך שיאחסן ויעבד את הנתונים שלכם רק באיחוד האירופי.

כברירת מחדל, Cloud Vision מאחסן ומעבד משאבים במיקום גלובלי, כלומר Cloud Vision לא מבטיח שהמשאבים יישארו במיקום או באזור מסוימים. אם תבחרו במיקום האיחוד האירופי, Google תאחסן את הנתונים שלכם ותעבד אותם רק באיחוד האירופי. אתם והמשתמשים שלכם יכולים לגשת לנתונים מכל מקום.

הגדרת המיקום באמצעות ה-API

‫Vision API תומך בנקודת קצה גלובלית של API ‏ (vision.googleapis.com) וגם בשתי נקודות קצה שמבוססות על אזורים: נקודת קצה של האיחוד האירופי (eu-vision.googleapis.com) ונקודת קצה של ארצות הברית (us-vision.googleapis.com). כדאי להשתמש בנקודות הקצה האלה לעיבוד נתונים שספציפיים לאזור. לדוגמה, כדי לאחסן ולעבד את הנתונים שלכם רק באיחוד האירופי, צריך להשתמש ב-URI eu-vision.googleapis.com במקום vision.googleapis.com בשיחות REST API:

  • https://eu-vision.googleapis.com/v1/projects/PROJECT_ID/locations/eu/images:annotate
  • https://eu-vision.googleapis.com/v1/projects/PROJECT_ID/locations/eu/images:asyncBatchAnnotate
  • https://eu-vision.googleapis.com/v1/projects/PROJECT_ID/locations/eu/files:annotate
  • https://eu-vision.googleapis.com/v1/projects/PROJECT_ID/locations/eu/files:asyncBatchAnnotate

כדי לאחסן ולעבד את הנתונים שלכם בארצות הברית בלבד, צריך להשתמש בנקודת הקצה בארה"ב (us-vision.googleapis.com) עם השיטות שצוינו למעלה.

הגדרת המיקום באמצעות ספריות הלקוח

ספריות הלקוח של Vision API ניגשות לנקודת הקצה הגלובלית של ה-API‏ (vision.googleapis.com) כברירת מחדל. כדי לאחסן ולעבד את הנתונים שלכם באיחוד האירופי בלבד, אתם צריכים להגדיר במפורש את נקודת הקצה (eu-vision.googleapis.com). בדוגמאות הקוד הבאות אפשר לראות איך מגדירים את ההגדרה הזו.

REST

לפני שמשתמשים בנתוני הבקשה, צריך להחליף את הנתונים הבאים:

  • ‫REGION_ID: אחד ממזהי המיקום האזוריים התקפים:
    • ‫us: ארה"ב בלבד
    • ‫eu: האיחוד האירופי
  • ‫CLOUD_STORAGE_IMAGE_URI: הנתיב לקובץ תמונה תקין בקטגוריה של Cloud Storage. צריכות להיות לכם לפחות הרשאות קריאה בקובץ. דוגמה:
    • gs://cloud-samples-data/vision/handwriting_image.png
  • ‫PROJECT_ID: מזהה הפרויקט ב- Google Cloud .

ה-method של ה-HTTP וכתובת ה-URL:

POST https://REGION_ID-vision.googleapis.com/v1/projects/PROJECT_ID/locations/REGION_ID/images:annotate

גוף בקשת JSON:

{
  "requests": [
    {
      "image": {
        "source": {
          "imageUri": "CLOUD_STORAGE_IMAGE_URI"
        }
       },
       "features": [
         {
           "type": "DOCUMENT_TEXT_DETECTION"
         }
       ]
    }
  ]
}

כדי לשלוח את הבקשה עליכם לבחור אחת מהאפשרויות הבאות:

curl

שומרים את גוף הבקשה בקובץ בשם request.json ומריצים את הפקודה הבאה:

curl -X POST \
-H "Authorization: Bearer $(gcloud auth print-access-token)" \
-H "x-goog-user-project: PROJECT_ID" \
-H "Content-Type: application/json; charset=utf-8" \
-d @request.json \
"https://REGION_ID-vision.googleapis.com/v1/projects/PROJECT_ID/locations/REGION_ID/images:annotate"

PowerShell

שומרים את גוף הבקשה בקובץ בשם request.json ומריצים את הפקודה הבאה:

$cred = gcloud auth print-access-token
$headers = @{ "Authorization" = "Bearer $cred"; "x-goog-user-project" = "PROJECT_ID" }

Invoke-WebRequest `
-Method POST `
-Headers $headers `
-ContentType: "application/json; charset=utf-8" `
-InFile request.json `
-Uri "https://REGION_ID-vision.googleapis.com/v1/projects/PROJECT_ID/locations/REGION_ID/images:annotate" | Select-Object -Expand Content

אם הבקשה מצליחה, השרת מחזיר קוד סטטוס 200 OK של HTTP ואת התשובה בפורמט JSON.

Go

לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Go במדריך למתחילים של Vision באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של Vision Go API.

כדי לבצע אימות ב-Vision, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לסביבת פיתוח מקומית.

import (
	"context"
	"fmt"

	vision "cloud.google.com/go/vision/apiv1"
	"google.golang.org/api/option"
)

// setEndpoint changes your endpoint.
func setEndpoint(endpoint string) error {
	// endpoint := "eu-vision.googleapis.com:443"

	ctx := context.Background()
	client, err := vision.NewImageAnnotatorClient(ctx, option.WithEndpoint(endpoint))
	if err != nil {
		return fmt.Errorf("NewImageAnnotatorClient: %w", err)
	}
	defer client.Close()

	return nil
}

Java

לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Java במדריך למתחילים של Vision API באמצעות ספריות לקוח. מידע נוסף מופיע ב מאמרי העזרה של Vision API Java.

ImageAnnotatorSettings settings =
    ImageAnnotatorSettings.newBuilder().setEndpoint("eu-vision.googleapis.com:443").build();

// Initialize client that will be used to send requests. This client only needs to be created
// once, and can be reused for multiple requests. After completing all of your requests, call
// the "close" method on the client to safely clean up any remaining background resources.
ImageAnnotatorClient client = ImageAnnotatorClient.create(settings);

Node.js

לפני שמנסים את הדוגמה הזו, צריך לפעול לפי הוראות ההגדרה של Node.js במדריך למתחילים של Vision באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של Vision Node.js API.

כדי לבצע אימות ב-Vision, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לסביבת פיתוח מקומית.

// Imports the Google Cloud client library
const vision = require('@google-cloud/vision');

async function setEndpoint() {
  // Specifies the location of the api endpoint
  const clientOptions = {apiEndpoint: 'eu-vision.googleapis.com'};

  // Creates a client
  const client = new vision.ImageAnnotatorClient(clientOptions);

  // Performs text detection on the image file
  const [result] = await client.textDetection('./resources/wakeupcat.jpg');
  const labels = result.textAnnotations;
  console.log('Text:');
  labels.forEach(label => console.log(label.description));
}
setEndpoint();

Python

לפני שמנסים את הדוגמה הזו, צריך לפעול לפי Pythonהוראות ההגדרה שבמדריך לתחילת העבודה עם Vision באמצעות ספריות לקוח. מידע נוסף מופיע במאמרי העזרה של Vision Python API.

כדי לבצע אימות ב-Vision, צריך להגדיר את Application Default Credentials. מידע נוסף זמין במאמר הגדרת אימות לסביבת פיתוח מקומית.

from google.cloud import vision

client_options = {"api_endpoint": "eu-vision.googleapis.com"}

client = vision.ImageAnnotatorClient(client_options=client_options)

התנסות בתכונה באמצעות Google APIs Explorer

נסו את זיהוי הטקסט וזיהוי הטקסט במסמכים ב-Google APIs Explorer. אפשר להשתמש בתמונה שכבר צוינה (gs://cloud-samples-data/vision/handwriting_image.png) בלחיצה על Execute, או לציין תמונה משלכם במקומה.

דף שורות עם הכיתוב Google Cloud Platform בכתב יד.

גוף הבקשה:

{
  "requests": [
    {
      "features": [
        {
          "type": "DOCUMENT_TEXT_DETECTION"
        }
      ],
      "image": {
        "source": {
          "imageUri": "gs://cloud-samples-data/vision/handwriting_image.png"
        }
      }
    }
  ]
}

פותחים את Google APIs Explorer ושולחים את הבקשה

  1. כדי לפתוח את Google APIs Explorer, לוחצים על Try it!‎.

  2. זה שינוי אופציונלי. משנים את גוף הבקשה הקיים.

  3. כדי לשלוח את הבקשה, לוחצים על Execute (ביצוע).