


Mit benutzerdefinierten Inferenzroutinen können Sie benutzerdefinierte Container mit Vor- und Nachverarbeitungscode erstellen, ohne sich mit den Details der Einrichtung eines HTTP-Servers oder der von Grund auf neuen Erstellung eines Containers befassen zu müssen. Mithilfe der Vorverarbeitung können Sie die Eingaben normalisieren und transformieren oder Aufrufe an externe Dienste senden, um zusätzliche Daten abzurufen. Mit der Nachbearbeitung können Sie die Modellinferenz formatieren oder Geschäftslogik ausführen.
Das folgende Diagramm zeigt den Nutzerworkflow mit und ohne benutzerdefinierte Inferenzroutinen.
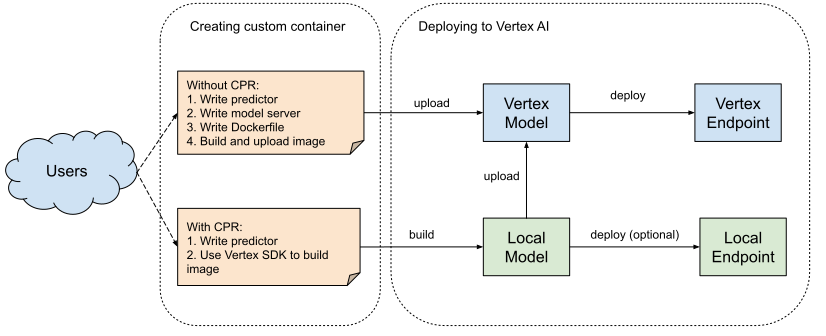
Die Hauptunterschiede sind:
Sie müssen keinen Modellserver und kein Dockerfile schreiben. Der Modell-Server, also der HTTP-Server, auf dem das Modell gehostet wird, wird für Sie bereitgestellt.
Sie können das Modell lokal bereitstellen und lokal Fehler beheben, um den Iterationszyklus während der Entwicklung zu beschleunigen.
Benutzerdefinierten Container erstellen und bereitstellen
In diesem Abschnitt wird beschrieben, wie Sie mit CPR einen benutzerdefinierten Container mit Vor- und Nachverarbeitungslogik erstellen und sowohl auf einem lokalen als auch auf einem Online-Endpunkt bereitstellen.
Einrichtung
In Ihrer Umgebung müssen das Agent Platform SDK für Python und Docker installiert sein.
Benutzerdefinierte Predictor-Inferenzschnittstelle schreiben
Predictor-Schnittstelle implementieren.
Weitere Informationen finden Sie zum Beispiel in der Predictor-Implementierung von Sklearn.
Benutzerdefinierten Handler schreiben (optional)
Benutzerdefinierte Handler haben Zugriff auf das Rohanfrageobjekt und sind daher in seltenen Fällen nützlich, in denen Sie die Webserverlogik anpassen müssen, z. B. für die Unterstützung zusätzlicher Anfrage-/Antwortheader oder für die Deserialisierung von nicht JSON-formatierten Inferenzanfragen.
Hier ist ein Beispielnotebook, das sowohl Predictor als auch Handler implementiert.
Es ist zwar nicht erforderlich, aber wir empfehlen, die Webserverlogik im Handler und die ML-Logik im Predictor zu implementieren, wie im Standard-Handler gezeigt. So lässt sich der Code besser organisieren und wiederverwenden.
Benutzerdefinierten Container erstellen
Legen Sie Ihren benutzerdefinierten Code und eine zusätzliche requirements.txt-Datei in einem Verzeichnis ab, wenn Sie Pakete in Ihren Images installieren müssen.
Verwenden Sie das Agent Platform SDK für Python, um benutzerdefinierte Container so zu erstellen:
from google.cloud.aiplatform.prediction import LocalModel

# {import your predictor and handler}

local_model = LocalModel.build_cpr_model(
    {PATH_TO_THE_SOURCE_DIR},
    f"{REGION}-docker.pkg.dev/{PROJECT_ID}/{REPOSITORY}/{IMAGE}",
    predictor={PREDICTOR_CLASS},
    handler={HANDLER_CLASS},
    requirements_path={PATH_TO_REQUIREMENTS_TXT},
)
In der Containerspezifikation finden Sie nützliche Informationen wie den Image-URI und Umgebungsvariablen.
local_model.get_serving_container_spec()
Container lokal ausführen (optional)
Dieser Schritt ist nur erforderlich, wenn Sie den Container lokal ausführen und testen möchten. Dies ist für eine schnellere Iteration nützlich. Im folgenden Beispiel stellen Sie das Modell auf einem lokalen Endpunkt bereit und senden eine Inferenzanfrage (Format für den Anfragetext).
with local_model.deploy_to_local_endpoint(
    artifact_uri={GCS_PATH_TO_MODEL_ARTIFACTS},
    credential_path={PATH_TO_CREDENTIALS},
) as local_endpoint:
    health_check_response = local_endpoint.run_health_check()
    predict_response = local_endpoint.predict(
        request_file={PATH_TO_INPUT_FILE},
        headers={ANY_NEEDED_HEADERS},
    )
Geben Sie die Systemdiagnose und die Inferenzantwort aus.
print(health_check_response, health_check_response.content)
print(predict_response, predict_response.content)
Geben Sie alle Containerlogs aus.
local_endpoint.print_container_logs(show_all=True)
In die Model Registry der Gemini Enterprise Agent Platform hochladen
Ihr Modell muss auf Ihre Modellartefakte zugreifen können (die Dateien aus dem Training). Stellen Sie daher sicher, dass Sie sie in Cloud Storage hochgeladen haben.
Laden Sie das Image per Push in die Artifact Registry:
local_model.push_image()
Laden Sie es dann in Model Registry hoch.
from google.cloud import aiplatform

model = aiplatform.Model.upload(
    local_model=local_model,
    display_name={MODEL_DISPLAY_NAME},
    artifact_uri={GCS_PATH_TO_MODEL_ARTIFACTS},
)
Sobald Ihr Modell in Model Registry hochgeladen wurde, kann es zum Abrufen von Batchinferenzen verwendet oder auf einem Agent Platform-Endpunkt bereitgestellt werden, um Onlineinferenzen zu erhalten.
Auf Agent Platform-Endpunkt bereitstellen
endpoint = model.deploy(machine_type="n1-standard-4")
Nachdem Ihr Modell bereitgestellt wurde, können Sie Online-Inferenz abrufen.
Notebook-Beispiele
Die Beispiele zeigen die verschiedenen Möglichkeiten, wie Sie ein Modell mit benutzerdefinierter Vor- und Nachverarbeitung mithilfe von Vertex AI Inference bereitstellen können.
- Benutzerdefinierter Predictor mit benutzerdefinierter Vor-/Nachverarbeitung für Sklearn, Erstellen eines eigenen Containers mit dem Agent Platform SDK für Python.
- Implementieren Sie nur das Laden von serialisierten Präprozessor-, Vorverarbeitungs- und Nachbearbeitungsmethoden im Predictor. Übernehmen Sie das Standard-Modellverhalten zum Laden und Vorhersagen des verteilten Agent Platform-
SklearnPredictor.
- Implementieren Sie nur das Laden von serialisierten Präprozessor-, Vorverarbeitungs- und Nachbearbeitungsmethoden im Predictor. Übernehmen Sie das Standard-Modellverhalten zum Laden und Vorhersagen des verteilten Agent Platform-
- Benutzerdefinierter Predictor, Erstellen Sie Ihren eigenen Container mit dem Agent Platform SDK für Python.
- Benutzerdefinierte Implementierung des gesamten Predictors.
- Benutzerdefinierter Predictor und Handler, Erstellen Sie Ihren eigenen Container mit dem Agent Platform SDK für Python.
- Benutzerdefinierte Implementierung von Predictor und Handler.
- Durch das Anpassen des Handlers kann der Modellserver CSV-Eingaben verarbeiten.
- Benutzerdefinierter Predictor, eigenen Container mit dem Agent Platform SDK für Python und PyTorch erstellen.
- Benutzerdefinierte Implementierung des Predictors.
- Vorhandenes Image, Testen Sie die Inferenz lokal und stellen Sie Modelle mit dem Agent Platform SDK für Python bereit.
- NVIDIA Triton-Inferenzserver für PyTorch-Modelle verwenden.