


Questa pagina fornisce una panoramica della configurazione ad alta affidabilità (HA) per le istanze Cloud SQL. Per configurare una nuova istanza per l'alta affidabilità o per abilitare l'alta affidabilità su un'istanza esistente, consulta Abilitare e disabilitare l'alta affidabilità su un'istanza.
Panoramica della configurazione ad alta disponibilità
Lo scopo di una configurazione ad alta disponibilità è ridurre i tempi di inattività quando una zona o un'istanza non è disponibile. Ciò può accadere durante un'interruzione della zona o in caso di problemi hardware. Con l'alta disponibilità, i dati continuano a essere disponibili per le applicazioni client.
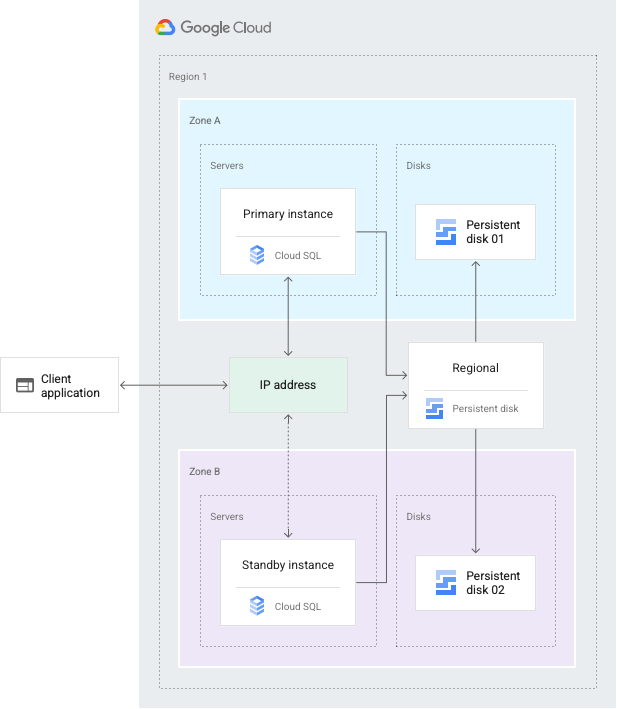
La configurazione ad alta disponibilità fornisce la ridondanza dei dati. Un'istanza Cloud SQL configurata per l'alta disponibilità è detta anche istanza regionale e ha una zona principale e una secondaria all'interno della regione configurata*. In un'istanza regionale, la configurazione include un'istanza principale e un'istanza in standby. Tramite replica sincrona nel disco permanente di ciascuna zona, tutte le scritture effettuate nell'istanza principale vengono replicate nei dischi di entrambe le zone prima che venga confermato il commit di una transazione. In caso di errore di un'istanza o una zona, l'istanza in standby diventa la nuova istanza principale. Gli utenti vengono quindi reindirizzati alla nuova istanza principale. Questo processo è noto come failover.
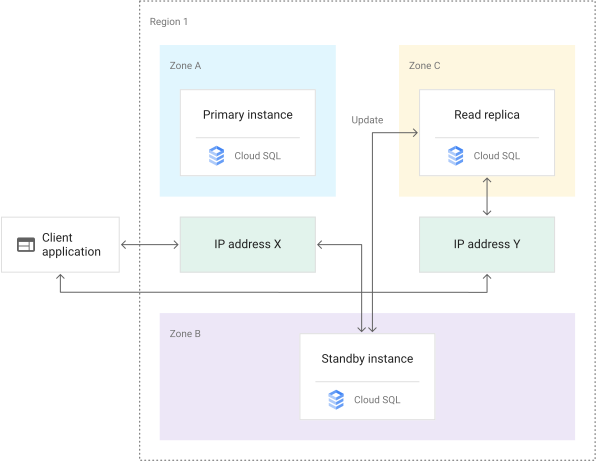
Dopo un failover, l'istanza che ha ricevuto il failover continua a essere l'istanza principale, anche dopo che l'istanza originale torna online. Dopo che la zona o l'istanza che ha subito un'interruzione torna disponibile, l'istanza principale originale viene eliminata e ricreata. Poi diventa la nuova istanza in standby. Se in futuro si verifica un failover, la nuova istanza principale eseguirà il failover sull'istanza originale nella zona originale.
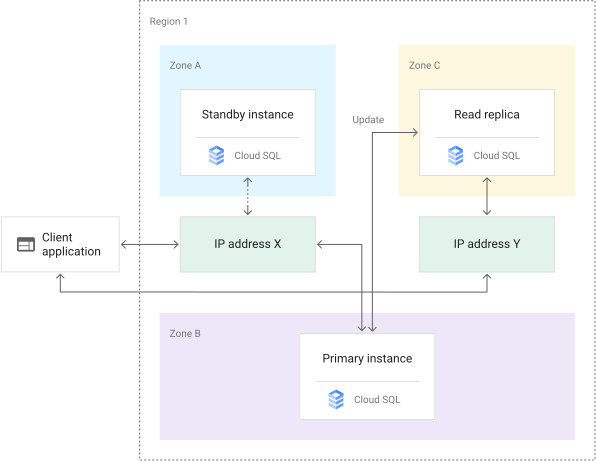
Se devi avere l'istanza principale nella zona che ha subito l'interruzione, puoi eseguire un failback. Un failback esegue gli stessi passaggi del failover, ma nella direzione opposta, per reindirizzare il traffico all'istanza originale. Per eseguire un failback, segui la procedura descritta in Avviare il failover.
Il supporto per i disco permanente regionali per la configurazione ad alta disponibilità di Cloud SQL con almeno una CPU dedicata ha una copertura completa dell'accordo sul livello del servizio (SLA). Un'istanza configurata per l'alta disponibilità costa il doppio di un'istanza autonoma. Questo prezzo include CPU, RAM e spazio di archiviazione. Per ulteriori informazioni, consulta la pagina dei prezzi.
* Per saperne di più sulle considerazioni specifiche per le regioni, consulta Area geografica e regioni.
Repliche di lettura
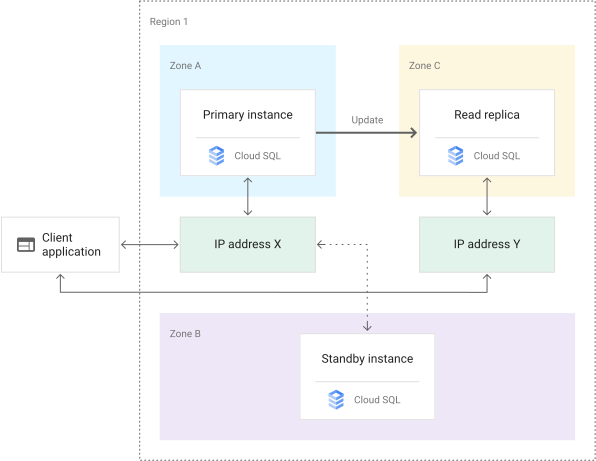
Se la disponibilità è una considerazione importante per le repliche di lettura, puoi abilitare l'alta disponibilità sulle repliche. Quando promuovi una replica di questo tipo in modo che diventi un'istanza principale, è già configurata come istanza ad alta disponibilità.
Durante un'interruzione della zona, il traffico si interrompe per le repliche di lettura in quella zona. Una volta che la zona torna disponibile, tutte le repliche di lettura nella zona riprendono la replica dall'istanza principale. Se le repliche di lettura non si trovano in una zona in cui si verifica un'interruzione, si connettono all'istanza in standby quando questa diventa l'istanza principale.
Come best practice, valuta la possibilità di inserire alcune repliche di lettura in una zona diversa dalle istanze principali e in standby. Ad esempio, se hai un'istanza principale nella zona A e un'istanza in standby nella zona B, inserisci una replica di lettura nella zona C per migliorare l'affidabilità. Questa pratica garantisce che le repliche di lettura continuino a funzionare anche se la zona dell'istanza principale non è disponibile. Dovresti anche aggiungere la logica di business nell'applicazione client per inviare le letture all'istanza principale quando le repliche di lettura non sono disponibili.
Nota: l'istanza in standby non può essere utilizzata per le query di lettura. Questo è diverso dalla configurazione ad alta disponibilità legacy di Cloud SQL per MySQL.
Panoramica del failover
Se un'istanza configurata per l'alta disponibilità non risponde, Cloud SQL passa automaticamente all'erogazione dei dati dall'istanza in standby. Per verificare se si è verificato un failover, controlla la cronologia dei failover del log delle operazioni.
Scopri di più su come creare query in Esplora log. Se hai bisogno di informazioni più dettagliate su un'operazione, ad esempio l'utente che l'ha eseguita, devi abilitare i log di audit.
Fai clic sulle schede per vedere in che modo il failover influisce sull'istanza.
Normale
Failover
Post-failover
Failback
Processo
Si verifica il seguente processo:
L'istanza principale o la zona non funziona.
Ogni secondo, il sistema di heartbeat rileva se l'istanza principale è integra. Se non vengono rilevati più heartbeat, viene avviato il failover.
L'istanza in standby ora gestisce i dati al momento della riconnessione.
Tramite un indirizzo IP statico condiviso con l'istanza principale, l'istanza in standby ora gestisce i dati dalla zona secondaria.
Requisiti
Affinché Cloud SQL consenta un failover, la configurazione deve soddisfare i seguenti requisiti:
- L'istanza principale deve essere in uno stato operativo normale (non arrestata, in manutenzione o in esecuzione di un'operazione di istanza Cloud SQL a lunga esecuzione, ad esempio un'operazione di backup).
- La zona secondaria e l'istanza in standby devono essere entrambe in uno stato integro. Quando l'istanza in standby non risponde, le operazioni di failover vengono bloccate. Dopo che Cloud SQL ripara l'istanza in standby e la zona secondaria è disponibile, Cloud SQL consente il failover.
Backup e ripristino
I backup automatici e il recupero point-in-time devono essere abilitati per le istanze ad alta disponibilità, ad eccezione delle repliche di lettura.
Opzioni di recupero per le istanze autonome
Cloud SQL non recupera automaticamente le istanze autonome da un'interruzione della zona. Per ristabilire un'istanza non configurata per l'alta affidabilità in una zona integra, devi ripristinare manualmente tutte le istanze della zona. Puoi recuperare manualmente un'istanza autonoma da un'interruzione della zona utilizzando una delle seguenti opzioni:
Esegui il recupero point-in-time sull'istanza in una nuova istanza che crei. Per utilizzare questa opzione, devi aver abilitato il recupero point-in-time sull'istanza della zona prima dell'interruzione della zona. I log delle transazioni per l'istanza devono essere archiviati in Cloud Storage. Se i log delle transazioni sono archiviati su disco, puoi spostarli in Cloud Storage. Per utilizzare questa opzione, segui i passaggi descritti in Eseguire il recupero point-in-time su un'istanza non disponibile.
Se l'istanza ha una replica di lettura in una zona diversa, puoi promuoverla per sostituire l'istanza autonoma che sta subendo l'interruzione della zona. Per utilizzare questa opzione, segui i passaggi descritti in Promuovere una replica.
Per entrambe le opzioni, si applicano le seguenti considerazioni:
Alcune transazioni recenti di cui è stato eseguito il commit sull'istanza principale potrebbero non essere visualizzate nell'istanza appena recuperata. L'intervallo di tempo in cui le transazioni potrebbero essere state perse è l'RPO (Recovery Point Objective).
- Per il recupero point-in-time, l'RPO è in genere di cinque minuti o meno.
- Per la promozione della replica di lettura, l'RPO varia in base al carico di lavoro del database. Per ulteriori informazioni su come monitorare e ridurre il ritardo di replica, consulta Ritardo di replica.
Dopo aver eseguito una delle opzioni di ripristino, devi riconfigurare tutti i client delle istanze che subiscono l'interruzione della zona, perché le istanze recuperate avranno indirizzi IP e nomi di connessione diversi.
Applicazioni e istanze
Non esiste alcuna differenza nel lavorare con istanze non ad alta disponibilità e ad alta disponibilità, quindi l'applicazione non deve essere configurata in modo particolare. Quando si verifica un failover, tutte le connessioni esistenti all'istanza principale e alle repliche di lettura vengono chiuse e ci vorranno circa 60 secondi per ristabilire le connessioni all'istanza principale. L'applicazione si riconnette utilizzando la stessa stringa di connessione o lo stesso indirizzo IP, quindi non è necessario aggiornare l'applicazione dopo il failover.
Per vedere esattamente in che modo le applicazioni sono interessate dal failover, avvia manualmente il failover.
Tempo di inttività per manutenzione
Gli eventi di manutenzione influiscono sulle istanze principali configurate con l'alta disponibilità nello stesso modo delle altre istanze. Puoi prevedere che le istanze principali non siano disponibili per un breve periodo di tempo. Per ulteriori informazioni su come la manutenzione influisce sulle istanze ad alta disponibilità, consulta Come funziona la manutenzione. Per ridurre al minimo l'impatto sul servizio, modifica le impostazioni di manutenzione per controllare quando si verifica il tempo di inattività.
Prestazioni
Le prestazioni disco permanente regionali dipendono da molti fattori. Le operazioni di I/O al secondo (IOPS) potrebbero essere ridotte con i disco permanente regionali rispetto ai disco permanente a livello di zona. Esamina le dimensioni del tipo di istanza VM e l'input e l'output del carico di lavoro. Un'altra metrica da tenere presente è che la latenza per i dischi permanenti regionali con unità a stato solido (SSD) è superiore a quella di un disco permanente a livello di zona con SSD. Ciò implica che, se il carico di lavoro non è un carico di lavoro di streaming ed è sensibile alla latenza, non può raggiungere il limite di IOPS, poiché il disco permanente regionale con SSD ha una latenza maggiore rispetto a un disco permanente a livello di zona con SSD. Questo è dovuto alla replica sincrona dei dati su più zone coinvolte in un disco permanente regionale per fornire più copie dei dati nelle zone di una regione.
Opzione di alta affidabilità legacy di MySQL
La procedura legacy per aggiungere l'alta affidabilità alle istanze MySQL utilizza una replica di failover. La funzionalità legacy non è disponibile nella Google Cloud console. Consulta Configurazione legacy: creare una nuova istanza configurata per l'alta affidabilità o Configurazione legacy: configurare un'istanza esistente per l'alta affidabilità.
Passaggi successivi
- Abilitare e disabilitare l'alta affidabilità su un'istanza.
- Avviare il failover.
- Scopri di più sulla gestione delle connessioni al database.
- Scopri di più su regioni e zone in Cloud SQL.