


이 페이지에서는 Spanner 쿼리 성능을 조정하는 기술을 설명합니다. 쿼리 조정을 시작하기 전에 쿼리 조정에 사용되는 기본 개념과 도구를 설명하는 다음 페이지를 검토하세요.
이 페이지의 쿼리 및 실행 계획은 다음 데이터베이스 스키마를 기반으로 합니다.
CREATE TABLE Singers (
  SingerId   INT64 NOT NULL,
  FirstName  STRING(1024),
  LastName   STRING(1024),
  SingerInfo BYTES(MAX),
  BirthDate  DATE
) PRIMARY KEY(SingerId);

CREATE INDEX SingersByFirstLastName ON Singers(FirstName, LastName);

CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByAlbumTitle2 ON Albums(AlbumTitle) STORING (MarketingBudget);

CREATE TABLE Songs (
  SingerId  INT64 NOT NULL,
  AlbumId   INT64 NOT NULL,
  TrackId   INT64 NOT NULL,
  SongName  STRING(MAX),
  Duration  INT64,
  SongGenre STRING(25)
) PRIMARY KEY(SingerId, AlbumId, TrackId),
  INTERLEAVE IN PARENT Albums ON DELETE CASCADE;

CREATE INDEX SongsBySingerAlbumSongNameDesc ON Songs(SingerId, AlbumId, SongName DESC), INTERLEAVE IN Albums;

CREATE INDEX SongsBySongName ON Songs(SongName);

CREATE TABLE Concerts (
  VenueId      INT64 NOT NULL,
  SingerId     INT64 NOT NULL,
  ConcertDate  DATE NOT NULL,
  BeginTime    TIMESTAMP,
  EndTime      TIMESTAMP,
  TicketPrices ARRAY<INT64>
) PRIMARY KEY(VenueId, SingerId, ConcertDate);
다음과 같은 데이터 조작 언어(DML) 문을 사용하여 이러한 테이블에 데이터를 추가할 수 있습니다.
INSERT INTO Singers (SingerId, FirstName, LastName, BirthDate)
VALUES (1, "Marc", "Richards", "1970-09-03"),
       (2, "Catalina", "Smith", "1990-08-17"),
       (3, "Alice", "Trentor", "1991-10-02"),
       (4, "Lea", "Martin", "1991-11-09"),
       (5, "David", "Lomond", "1977-01-29");

INSERT INTO Albums (SingerId, AlbumId, AlbumTitle)
VALUES (1, 1, "Total Junk"),
       (1, 2, "Go, Go, Go"),
       (2, 1, "Green"),
       (2, 2, "Forever Hold Your Peace"),
       (2, 3, "Terrified"),
       (3, 1, "Nothing To Do With Me"),
       (4, 1, "Play");

INSERT INTO Songs (SingerId, AlbumId, TrackId, SongName, Duration, SongGenre)
VALUES (2, 1, 1, "Let's Get Back Together", 182, "COUNTRY"),
       (2, 1, 2, "Starting Again", 156, "ROCK"),
       (2, 1, 3, "I Knew You Were Magic", 294, "BLUES"),
       (2, 1, 4, "42", 185, "CLASSICAL"),
       (2, 1, 5, "Blue", 238, "BLUES"),
       (2, 1, 6, "Nothing Is The Same", 303, "BLUES"),
       (2, 1, 7, "The Second Time", 255, "ROCK"),
       (2, 3, 1, "Fight Story", 194, "ROCK"),
       (3, 1, 1, "Not About The Guitar", 278, "BLUES");
벤치마크 추천
가장 안정적인 성능 통계는 대상 인스턴스와 동일한 리전에 있는 Google Cloud 가상 머신(VM) 인스턴스에서 무작위로 지정된 다양한 쿼리 파라미터 값을 사용하는 부하 테스트를 실행하여 얻을 수 있습니다.
Spanner Studio 또는 QueryMode.PROFILE 모드를 사용하여 쿼리를 벤치마킹하지 마세요. 이러한 도구는 실제 프로덕션 네트워크 및 클라이언트 환경을 복제하지 않기 때문입니다. 하지만 부하 테스트에서 성능 문제가 식별된 후에는 쿼리 계획 (쿼리 통계에서 샘플링되거나 Spanner Studio에서 주문형으로 실행되는지 여부)이 특정 문제를 조사하는 데 유용한 도구입니다.
쿼리 실행 계획 이해
쿼리 계획 시각화 도구에서 쿼리 실행 계획은 연산자 트리로 표시됩니다. 여기서 각 연산자는 하위 연산자에서 행을 읽고 처리한 후 결과를 상위 연산자에 전달합니다.
시각적 계획의 대부분의 연산자에서 보고된 지연 시간은 가산적입니다 (해당 연산자에서 소요된 시간만 반영). 하지만 Distributed union 및 Distributed apply 연산자의 경우 보고된 지연 시간은 누적됩니다. 즉, 분산 연산자 자체에서 소요된 시간과 하위 연산자에서 소요된 시간이 모두 포함됩니다. 이러한 연산자에 대한 자세한 내용은 분산 합집합 및 분산 적용을 참조하세요.
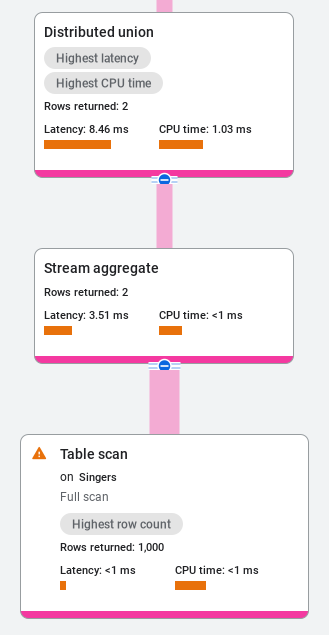
예를 들어 다음 분산 통합 계획에서 Distributed union 카드는 총 지연 시간 8.46ms를 보고하는 반면 하위 Stream aggregate 연산자는 3.51ms를 보고하고 Table scan는 1ms를 보고합니다. Distributed union 지연 시간은 누적되므로 Distributed union 연산자 자체는 8ms가 아닌 약 5ms의 지연 시간만 추가합니다.
다음 예시에서 Distributed union 카드는 13.69ms의 지연 시간을 보고하는 반면 하위 연산자 (1ms 미만의 Stream aggregate, 1.14ms의 Cross apply, 1ms 미만의 Albums에 대한 Table scan, 1ms의 Filter scan, 10.85ms의 Singers에 대한 Table scan)는 약 13ms를 차지합니다. 결과적으로 Distributed union 연산자 자체는 13ms가 아닌 1ms 미만의 지연 시간을 추가합니다.
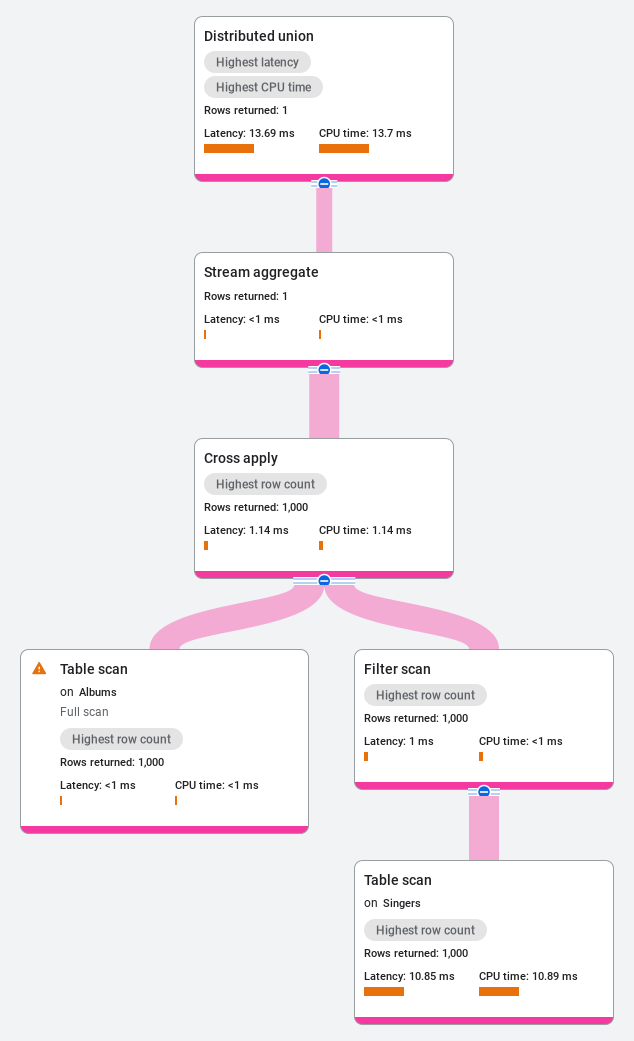
연산자 요약 패널에서 누적 지연 시간 값을 볼 수도 있습니다.
여러 색인 결합
쿼리가 OR 또는 AND 조건을 사용하여 색인이 생성된 여러 열을 필터링하는 경우 Spanner는 여러 보조 색인을 결합하여 전체 기본 테이블을 스캔하지 않을 수 있습니다. 이 섹션의 예시에서는 ReleaseDate 열과 AlbumsByReleaseDate 보조 색인을 추가하여 이전 예시 스키마의 Albums 테이블을 확장합니다.
CREATE TABLE Albums (
  SingerId        INT64 NOT NULL,
  AlbumId         INT64 NOT NULL,
  AlbumTitle      STRING(MAX),
  ReleaseDate     DATE,
  MarketingBudget INT64
) PRIMARY KEY(SingerId, AlbumId),
  INTERLEAVE IN PARENT Singers ON DELETE CASCADE;

CREATE INDEX AlbumsByAlbumTitle ON Albums(AlbumTitle);

CREATE INDEX AlbumsByReleaseDate ON Albums(ReleaseDate);
OR 조건을 사용하여 두 개의 개별 보조 색인 (AlbumsByAlbumTitle 및 AlbumsByReleaseDate)에서 조건자를 필터링하는 다음 쿼리를 살펴보세요.
SELECT a.AlbumId, a.AlbumTitle, a.ReleaseDate
FROM Albums AS a
WHERE a.AlbumTitle = 'Play' OR a.ReleaseDate = '2023-09-07';
쿼리에 두 개의 개별 색인에서 조건자에 대한 OR 조건이 있는 경우 Spanner는 비용 기반 최적화를 사용하여 두 색인을 모두 읽고 결과를 결합할 수 있습니다 (색인 합집합). 쿼리에 INDEX_STRATEGY=FORCE_INDEX_UNION 테이블 힌트를 추가하여 이 최적화를 강제할 수도 있습니다.
SELECT a.AlbumId, a.AlbumTitle, a.ReleaseDate
FROM Albums@{INDEX_STRATEGY=FORCE_INDEX_UNION} AS a
WHERE a.AlbumTitle = 'Play' OR a.ReleaseDate = '2023-09-07';
테이블 힌트에 대한 자세한 내용은 테이블 힌트를 참조하세요.
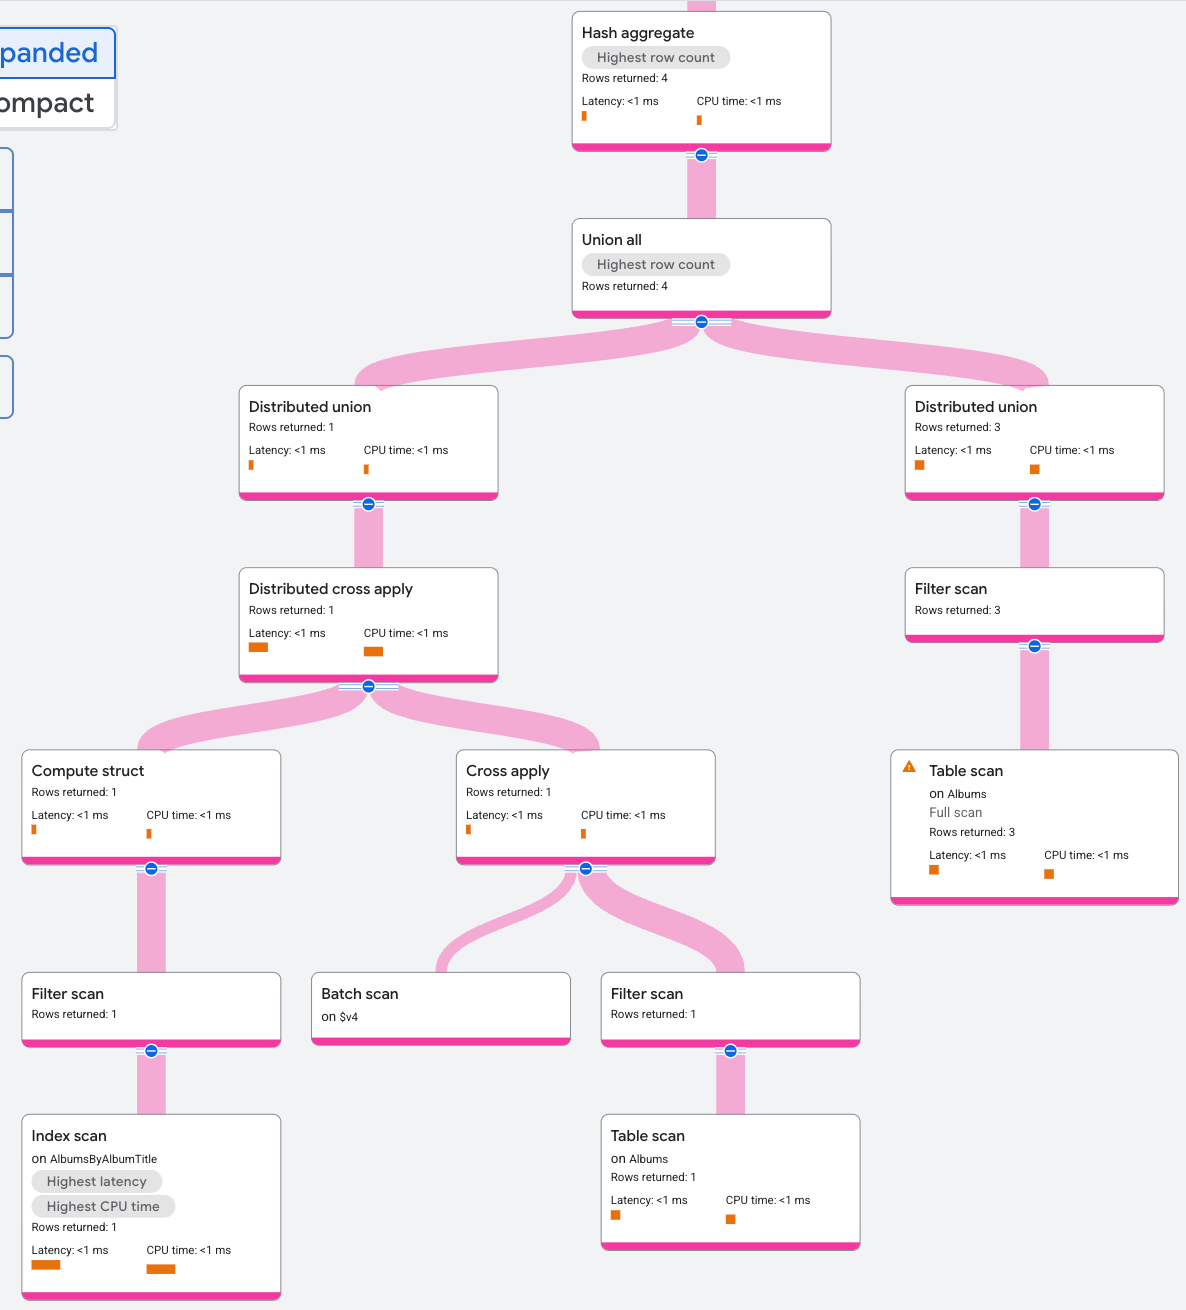
다음 실행 계획 다이어그램은 Spanner가 각 브랜치를 개별적으로 스캔하고 Union all 및 Hash aggregate 연산자를 사용하여 결과를 결합하여 이 OR 조건 (분리)을 평가하는 방법을 보여줍니다.
다음으로 AND 조건을 사용하여 두 색인 생성 열을 필터링하는 쿼리를 고려해 보세요.
SELECT a.AlbumId, a.ReleaseDate, a.AlbumTitle
FROM Albums AS a
WHERE a.AlbumTitle = 'Aardvark' AND a.ReleaseDate = '2023-09-07';
AND 조건을 사용하면 Spanner는 기본적으로 단일 색인을 선택한 다음 필요한 경우 기본 테이블에 다시 조인하여 AND 절의 나머지 조건을 평가합니다. 이 기본 테이블 백 조인이 성능 병목 현상인지 확인하려면 시각화 도구에서 쿼리 실행 계획을 검사합니다. Index scan 연산자가 기본 테이블의 Table scan 연산자와 조인한 후 필터링되는 많은 행을 반환하는 경우 (반환된 최종 행 수에 비해 Table scan 브랜치에서 지연 시간 또는 CPU 시간이 길어짐) 백 조인이 병목 현상입니다.
기본 테이블 백 조인이 쿼리의 병목 현상인 경우 권장되는 해결 방법은 AND 조건의 추가 열을 보조 색인의 STORING 절에 추가하여 Spanner가 기본 테이블을 읽지 않고 색인에서 직접 두 조건을 모두 평가할 수 있도록 하는 것입니다.
CREATE INDEX AlbumsByAlbumTitleStoringReleaseDate
  ON Albums(AlbumTitle)
  STORING (ReleaseDate);
색인을 수정할 수 없는 경우 INTERSECT DISTINCT를 사용하여 두 색인의 교차를 수행하도록 쿼리를 다시 작성한 다음 일치하는 기본 키를 Albums 기본 테이블에 다시 조인하는 방법이 있습니다.
SELECT union_a.AlbumId, a.ReleaseDate, a.AlbumTitle FROM
  (SELECT a1.SingerId, a1.AlbumId
  FROM Albums @{force_index=AlbumsByReleaseDate} AS a1
  WHERE a1.ReleaseDate = '2023-09-07'
  INTERSECT DISTINCT
  SELECT a2.SingerId, a2.AlbumId
  FROM Albums @{force_index=AlbumsByAlbumTitle} AS a2
  WHERE a2.AlbumTitle = 'Aardvark') AS union_a
JOIN Albums AS a
  ON a.SingerId = union_a.SingerId AND a.AlbumId = union_a.AlbumId;
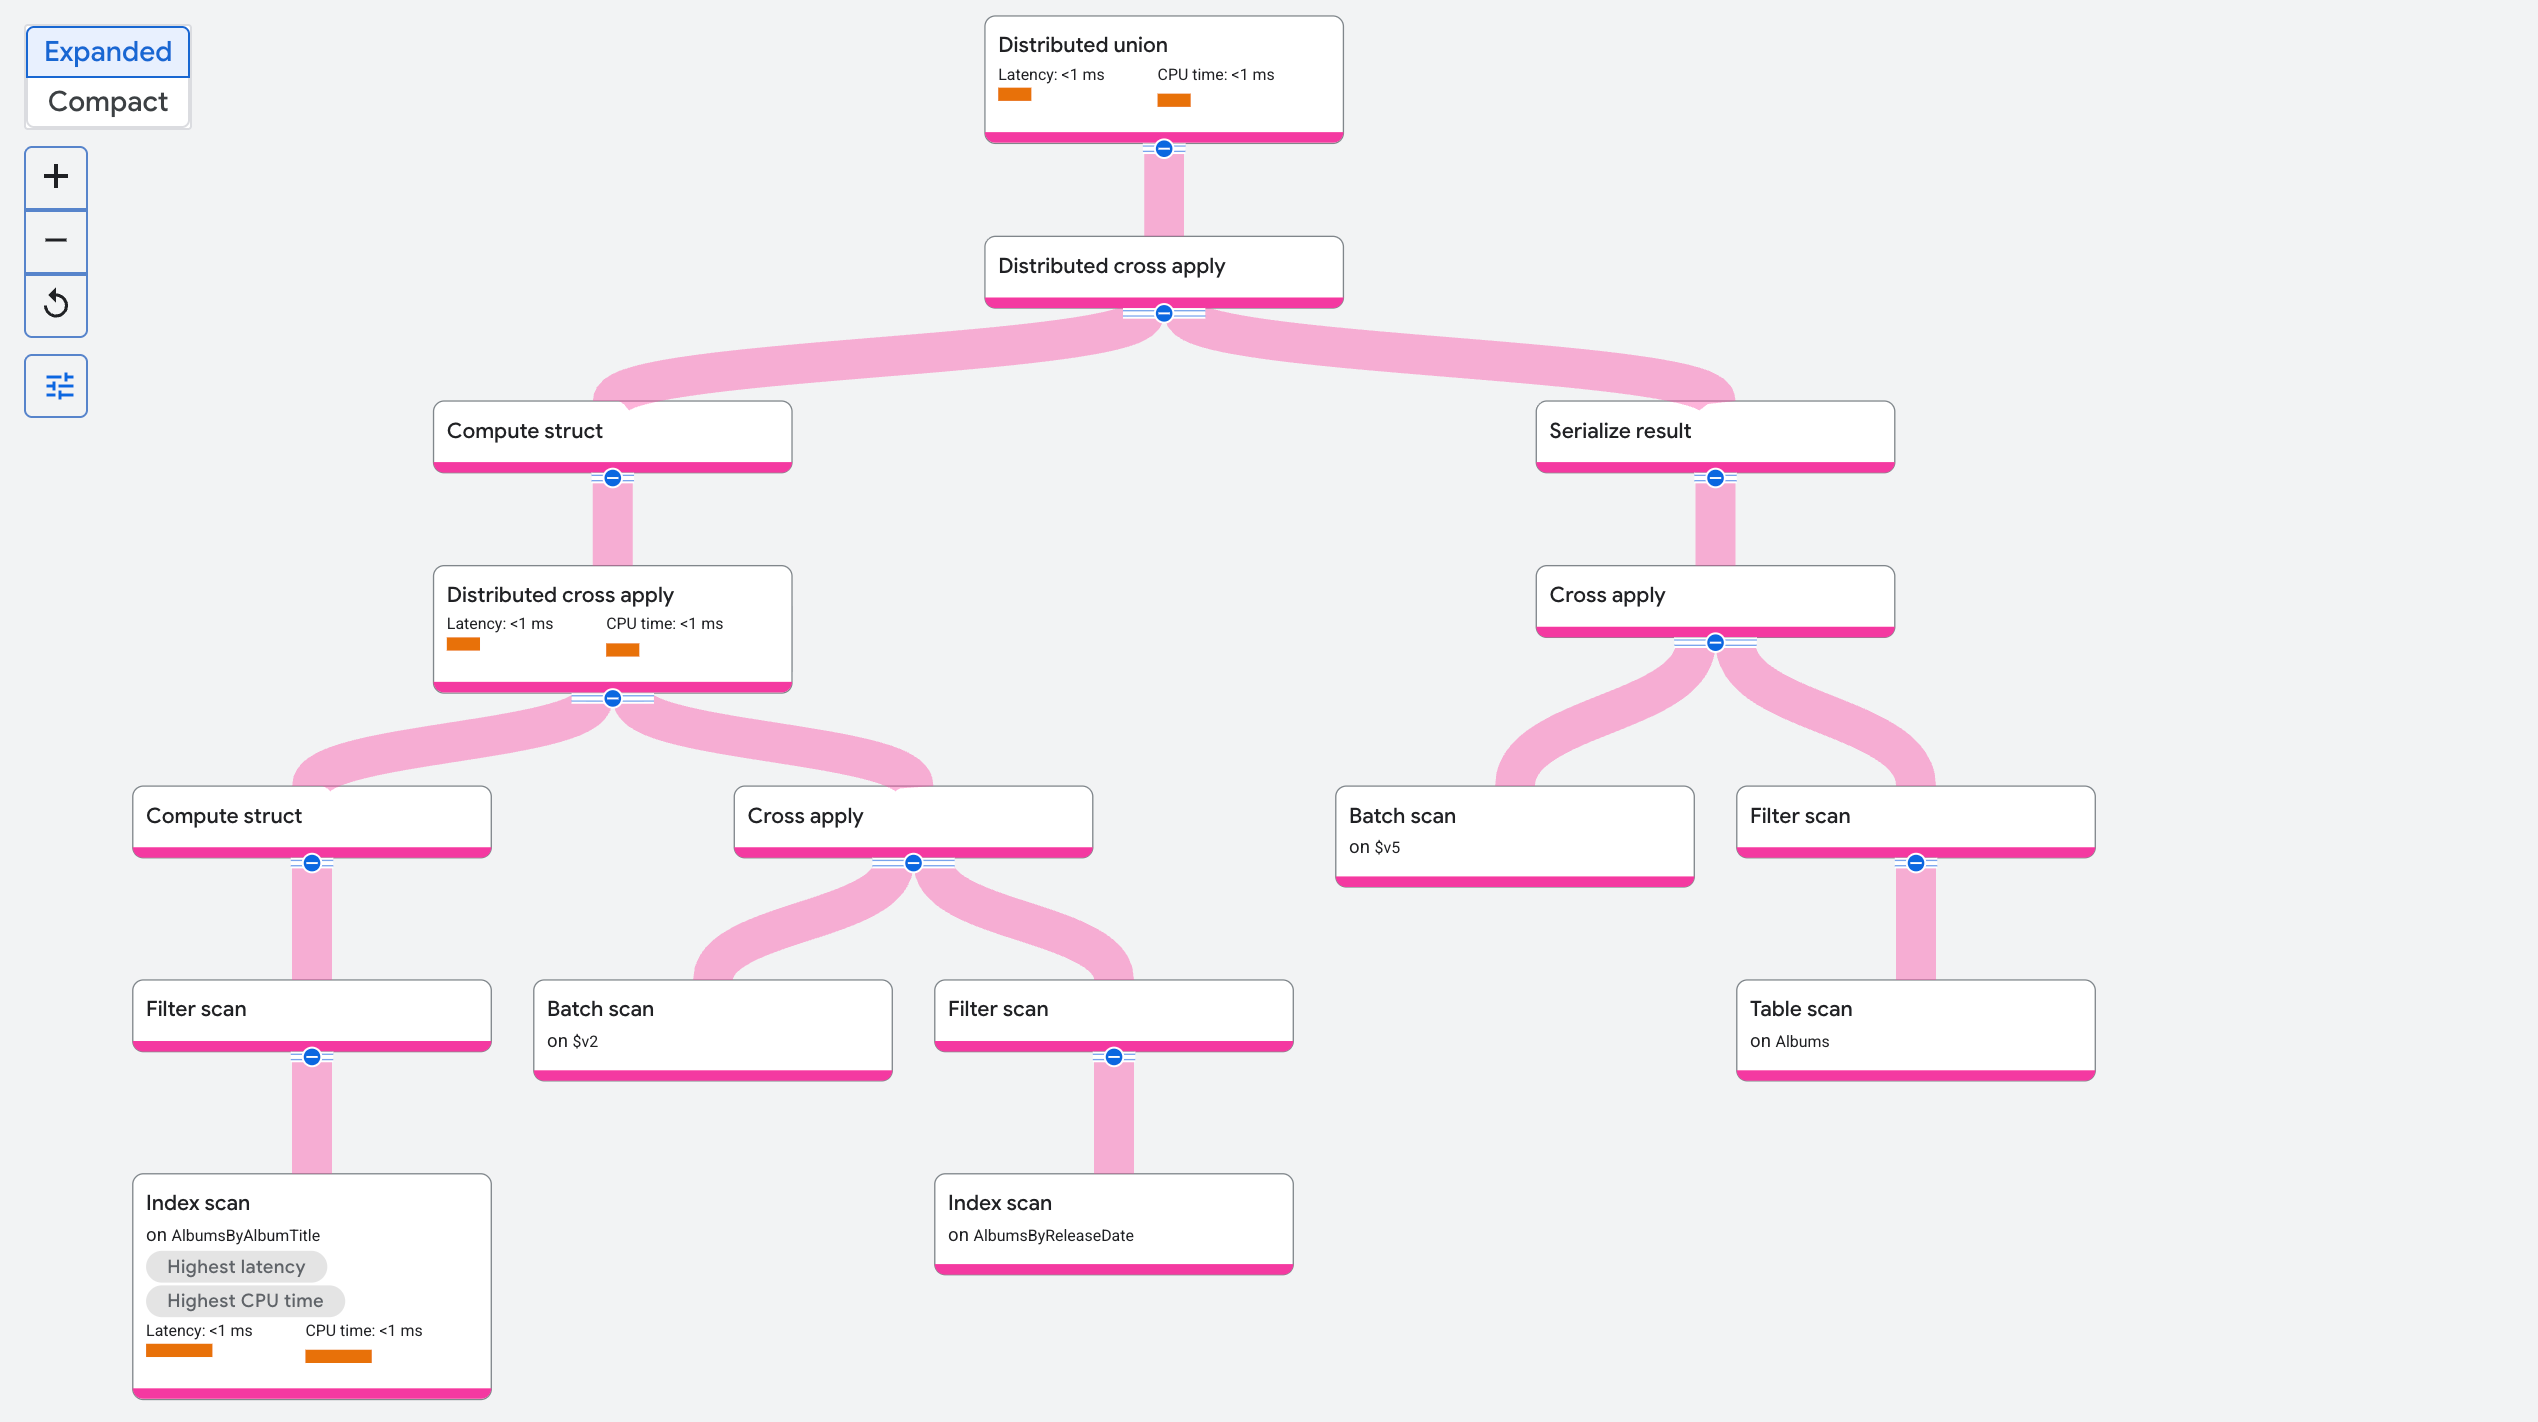
다음 실행 계획 다이어그램은 다시 작성된 쿼리를 보여줍니다. 계획에서 Albums 기본 테이블에서 Table scan를 수행하기 전에 두 개의 Index scan 연산자 (on AlbumsByAlbumTitle 및 on AlbumsByReleaseDate)를 사용하여 교차 키를 찾는 방법을 확인하세요.
여러 열에 걸친 필터링이 워크로드에서 자주 발생하는 패턴인 경우 보조 색인 대신 다중 열 전체 텍스트 검색을 사용하는 것이 좋습니다. 자세한 내용은 다중 열 검색 수행을 참조하세요.
조인 최적화
Spanner가 여러 테이블을 조인하는 쿼리를 실행할 때 쿼리 최적화 도구는 조인 순서 (테이블이 조인되는 순서)와 조인 메서드 (적용 조인, 해시 조인, 병합 조인과 같이 두 입력의 행을 결합하는 데 사용되는 알고리즘)를 모두 선택합니다. 조인이 있는 쿼리가 예상보다 느린 경우 쿼리 힌트를 사용하여 Spanner에 다른 조인 순서 또는 조인 메서드를 사용하도록 지시할 수 있습니다. 이렇게 하면 실행 계획이 변경되지만 반환되는 결과는 변경되지 않습니다. 예를 들면 다음과 같습니다.
GoogleSQL
조인 순서 강제 적용:
SELECT *
FROM Singers AS s JOIN@{FORCE_JOIN_ORDER=TRUE} Albums AS a
ON s.SingerId = a.SingerId
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
참여 방법 변경:
SELECT *
FROM Singers AS s JOIN@{JOIN_METHOD=HASH_JOIN} Albums AS a
ON s.SingerId = a.SingerId;
PostgreSQL
조인 순서 강제 적용:
SELECT *
FROM Singers AS s JOIN/*@ FORCE_JOIN_ORDER=TRUE */ Albums AS a
ON s.SingerId = a.SingerId
WHERE s.LastName LIKE '%x%' AND a.AlbumTitle LIKE '%love%';
참여 방법 변경:
SELECT *
FROM Singers AS s JOIN/*@ JOIN_METHOD=HASH_JOIN */ Albums AS a
ON s.SingerId = a.SingerId;
다음 섹션에서는 쿼리 성능을 개선하는 데 도움이 되는 조인 순서와 조인 방법을 결정하는 데 도움이 되는 배경 정보를 제공합니다.
조인 메서드 및 스캔
Spanner는 여러 조인 메서드를 지원하며, 조인 메서드를 선택하면 Spanner가 기본 테이블 또는 색인을 스캔하는 방식에 직접적인 영향을 미칩니다.
- 조인 적용 (일부 시스템에서는 조회 조인 또는 중첩 루프 조인이라고 함): 왼쪽 ('입력') 측의 각 행에 대해 오른쪽('맵') 측을 한 번 실행합니다. 각 오른쪽 조회는 현재 왼쪽 행의 값을 사용하므로 왼쪽의 조인 열을 오른쪽의 탐색 키로 사용할 수 있습니다. 분산 적용 조인은 로컬 적용 조인과 유사하게 작동하지만 분산 조인의 분할 간에 더 효율적인 통신을 위해 행을 일괄 처리합니다.
- 해시 조인: 한 입력에서 행을 읽어 조인 키에 인메모리 해시 테이블을 빌드한 다음 다른 입력을 스캔하여 해시 테이블에서 일치하는 항목을 프로브합니다.
- 병합 조인: 조인 키에서 정렬된 순서로 두 입력을 읽고 일치하는 행을 한 번에 병합합니다.
예를 들어 Singers 및 Albums를 조인하는 다음 쿼리를 살펴보세요.
SELECT s.*, a.AlbumTitle
FROM Singers AS s
JOIN Albums AS a ON s.SingerId = a.SingerId
WHERE s.SingerId = 2 AND a.AlbumId = 1;
적용 조인을 사용하면 s.SingerId = a.SingerId가 조인의 오른쪽에 있는 탐색 조건으로 작동하므로 쿼리는 Albums 테이블에서 한 행만 읽으면 됩니다.
반면 해시 조인 또는 병합 조인에서는 왼쪽 및 오른쪽 입력이 서로 독립적으로 읽히므로 조인 조건이 한쪽에서 다른 쪽으로 탐색 키를 제공하지 않습니다. 최악의 경우 해시 또는 병합 조인은 각 입력의 전체 테이블 스캔을 수행합니다.
대화형 및 트랜잭션 쿼리에서 대부분의 조인은 색인을 사용하므로 분산 적용은 Spanner에서 가장 일반적인 조인 유형입니다. 하지만 연속된 행 범위를 읽는 것이 동일한 수의 분산된 단일 행 검색을 수행하는 것보다 훨씬 빠르기 때문에 해시 또는 병합 조인이 더 나은 선택인 경우도 있습니다. 절충점은 더 적은 행을 찾는 것이 더 빠른지 (적용 조인 사용) 아니면 더 큰 연속 행 범위를 스캔하는 것이 더 빠른지 (해시 또는 병합 조인 사용)입니다. 이 장단점에 대한 자세한 내용은 순차 읽기 및 분산 탐색을 참조하세요.
수천 개의 행을 읽는 쿼리의 경우 조인 키에서 색인을 사용할 수 있으면 일반적으로 분산 적용 조인을 사용하는 것이 더 안전합니다. 이는 적용 조인 비용이 조인된 행 수에 비례하는 반면 해시 또는 병합 조인의 경우 비용이 총 테이블 크기에 비례할 수 있기 때문입니다. 수백만 개의 행을 처리하는 쿼리와 같은 대규모 쿼리의 경우 해시 또는 병합 조인을 사용하면 성능이 크게 향상될 수 있습니다.
조인 연산자 및 힌트에 대한 자세한 내용은 다음 리소스를 참조하세요.
조인 순서
다른 관계형 데이터베이스 관리 시스템 (RDBMS)과 마찬가지로 중간 결과 크기를 최대한 작게 유지하도록 조인을 정렬합니다. 즉, 데이터를 최대한 빨리 필터링하고 대규모 일치를 최대한 늦게 지연시키는 것입니다.
FORCE_JOIN_ORDER=TRUE 힌트를 제공하면 Spanner는 쿼리 텍스트에 표시된 순서대로 조인을 실행합니다. 선택성이 높은 필터가 있는 조인은 쿼리 초반으로 이동하고 일치 항목이 많은 조인은 쿼리 후반으로 이동합니다.
집계 최적화
다음 기법은 집계 쿼리 중에 스캔되고 정렬되는 행 수를 줄이는 데 도움이 될 수 있습니다.
키 프리픽스당 행 1개 검색
일반적인 집계 패턴은 키 프리픽스당 하나의 행 (예: 버전 번호 또는 타임스탬프가 가장 높은 행)을 검색하는 것입니다. GoogleSQL에서 이를 수행하는 가장 효율적인 방법은 HAVING MAX와 함께 ANY_VALUE를 사용하는 것입니다. 그러면 최대값이 있는 행을 찾고 자체 조인 또는 전체 정렬 없이 단일 집계 패스에서 요청된 열을 반환합니다. 예를 들어 다음 쿼리는 Concerts 테이블을 ConcertDate별로 그룹화하고 각 날짜의 최신 EndTime가 있는 콘서트의 BeginTime를 반환합니다.
SELECT ConcertDate, ANY_VALUE(BeginTime HAVING MAX(EndTime))
FROM Concerts
GROUP BY ConcertDate;
행 존재 여부 확인
테이블에 행이 있는지 또는 특정 조건과 일치하는 행이 있는지 확인하려면 COUNT 대신 LIMIT를 사용합니다. 예를 들면 다음과 같습니다.
SELECT 1 FROM Albums LIMIT 1;
동시 로드 증가
Spanner는 테이블과 색인을 분할이라고 하는 연속적인 기본 키 범위로 나누며, 이는 여러 서버에서 동시에 처리될 수 있습니다. 일반적으로 Spanner는 지연 시간과 효율성의 균형을 맞추기 위해 쿼리 동시 로드를 선택합니다. 예를 들어 쿼리에 LIMIT 절이 있는 경우 한도에서 삭제하는 작업이 낭비되지 않도록 동시 로드를 줄일 수 있습니다. 쿼리로 스캔되는 분할 수에 따라 최대 동시 로드 수준이 제한됩니다.
한도가 있거나 대규모 스캔이 있는 쿼리의 경우 USE_ADDITIONAL_PARALLELISM=TRUE 문 힌트를 설정하여 Spanner가 주로 지연 시간을 최적화하도록 지시할 수 있습니다.
GoogleSQL
@{USE_ADDITIONAL_PARALLELISM=TRUE}
SELECT *
FROM Singers
LIMIT 10;
PostgreSQL
/*@ USE_ADDITIONAL_PARALLELISM=TRUE */
SELECT *
FROM Singers
LIMIT 10;
이 힌트는 지정된 분할에서 CPU를 포화시킬 수 있습니다. 쿼리가 장기 실행되는 경우 다른 우선순위가 높은 쿼리의 지연 시간이 늘어나지 않도록 중간 요청 우선순위로 전송합니다.
최적화 한도
쿼리에 LIMIT 절이 포함되어 있지만 한도 값보다 많은 행을 스캔하는 경우 다음과 같은 가능한 원인을 확인하세요.
색인 누락
쿼리에 색인을 사용하여 충족할 수 없는 필터가 있는 경우 쿼리 계획은 기본 테이블 또는 필요한 정렬 순서를 제공하지 않는 색인을 스캔합니다. 그런 다음 쿼리는 LIMIT 절을 평가하기 전에 일치하는 데이터를 완전히 정렬합니다.
이 문제를 해결하려면 필터 열을 포함하는 보조 색인을 추가하는 것이 좋습니다. 색인이 NULL_FILTERED로 정의된 경우 (색인이 생성된 열이 NULL인 행 제외) 최적화 도구가 색인을 사용할 수 있도록 쿼리 조건자에 IS NOT NULL가 포함되어 있는지 확인합니다. 보조 색인 만들기에 대한 자세한 내용은 보조 색인을 참조하세요.
전체 정렬
필터링된 열에 색인이 있지만 색인이 ORDER BY 절에 필요한 정렬 순서를 제공하지 않는 경우 Spanner는 일치하는 모든 행을 읽고 LIMIT를 적용하기 전에 쿼리 실행 계획의 Sort 연산자에 전달해야 합니다.
전체 정렬을 방지하려면 CREATE INDEX 문에서 다음 순서로 열을 지정합니다.
- 먼저 쿼리에 등식 (
=) 또는IN조건이 있는 모든 열 - 그런 다음 쿼리의
ORDER BY절과 동일한 열을 동일한 순서와 동일한 정렬 방향 (ASC또는DESC)으로 지정합니다.
예를 들어 Users 테이블 (이전 예시 스키마에 표시되지 않음)이 있고 다음 쿼리를 최적화하려고 한다고 가정해 보겠습니다.
SELECT * FROM Users
WHERE Name='Alex'
ORDER BY LastLogin DESC
LIMIT 10;
Spanner가 정렬 없이 색인 순서대로 상위 10개 행을 직접 읽을 수 있도록 (Name, LastLogin DESC)에 색인을 만듭니다.
CREATE INDEX UsersByNameLastLogin ON Users(Name, LastLogin DESC);
키 서픽스별 순서 지정
색인에 ORDER BY 열이 색인 키의 서픽스로 포함된 경우에도 색인의 프리픽스 열 중 하나에 IN, OR 또는 범위 조건자가 있으면 쿼리가 추가 행을 스캔할 수 있습니다.
예를 들어 이전 전체 정렬 예시의 (Name, LastLogin DESC) 색인을 사용하는 다음 쿼리를 살펴보세요. 이 색인은 예시 스키마에 포함되지 않습니다.
SELECT *
FROM Users
WHERE Name IN ('Alex','Amal')
ORDER BY LastLogin DESC
LIMIT 10;
Name는 여러 값과 일치하므로 일치하는 행은 LastLogin DESC에 의해 전역적으로 정렬된 단일 범위에 저장되지 않습니다. UNNEST 및 조인을 사용하여 쿼리를 재구성하면 Spanner가 각 Name 값의 상위 행을 개별적으로 검색한 후 결합할 수 있습니다.
SELECT *
FROM UNNEST(['Alex','Amal']) AS Name
JOIN Users AS u ON u.Name = Name
ORDER BY LastLogin DESC
LIMIT 10;
이 재작성은 각 바인딩 프리픽스 키 ('Alex' 및 'Amal')에서 최소 행 수를 읽은 후 결합된 결과를 작게 정렬하여 최종 LIMIT를 생성함으로써 더 효율적인 스캔을 수행합니다.
이 패턴의 일반적인 특수 사례는 샤드 프리픽스입니다. 여기서 ShardId 열은 분할 간에 쓰기를 분산하기 위해 선행 키 열로 추가됩니다.
예를 들어 다음 쿼리는 32개의 샤드 (0~31)를 스캔합니다.
SELECT *
FROM Users
WHERE ShardId BETWEEN 0 AND 31
ORDER BY LastLogin DESC
LIMIT 10;
이 쿼리를 최적화하려면 샤드 ID (0~31)를 명시적으로 열거하고 GoogleSQL의 GENERATE_ARRAY 또는 PostgreSQL의 generate_series를 사용하여 Users 테이블에 조인합니다.
GoogleSQL
SELECT *
FROM GENERATE_ARRAY(0, 31) AS id
JOIN Users AS u ON u.ShardId = id
ORDER BY LastLogin DESC
LIMIT 10;
PostgreSQL
SELECT *
FROM generate_series(0, 31) AS id
JOIN Users AS u ON u.ShardId = id
ORDER BY LastLogin DESC
LIMIT 10;
이러한 배열 및 계열 생성 함수에 대한 자세한 내용은 GoogleSQL의 경우 GENERATE_ARRAY, PostgreSQL의 경우 generate_series를 참조하세요.
스캔 성능 이해하기
다음 섹션에서는 테이블 또는 색인 스캔 속도가 느려지는 가장 일반적인 원인과 이를 완화하는 방법을 설명합니다.
행 삭제
기본적으로 Spanner는 이전 읽기 및 PITR(point-in-time recovery)을 지원하기 위해 삭제되거나 덮어쓴 행을 1시간 동안 보관하며, 이 보관 기간을 최대 7일까지 늘릴 수 있습니다. 이전 행 버전이 보관 기간을 지나면 백그라운드 스토리지 압축 중에 삭제될 수 있으며, 이 작업은 최대 7일이 더 걸릴 수 있습니다. 이전 행 버전이 압축될 때까지 키 범위를 스캔하는 쿼리는 삭제되거나 덮어쓴 행 버전을 읽고 필터링해야 할 수 있습니다. 데이터 보관에 대한 자세한 내용은 PITR (point-in-time recovery)을 참조하세요.
쿼리 계획 시각화 도구 세부정보 패널의 스캔 연산자 세부정보 뷰에서 스캔된 삭제된 행 측정항목을 검사하여 쿼리가 삭제된 행을 스캔했는지 확인할 수 있습니다.
최근에 삭제된 행이 많아 스캔이 느려지는 문제를 완화하려면 수동 데이터 압축을 트리거하면 됩니다. 자세한 내용은 수동 데이터 압축을 참조하세요.
큰 행
작은 행 (최대 수백 바이트)의 경우 스캔 비용은 주로 스캔한 행 수에 따라 달라집니다. 행 크기가 증가하면 행의 바이트 크기가 더 중요해집니다. 행 지향 스토리지에서는 쿼리로 프로젝션된 열의 크기뿐만 아니라 행의 총 크기가 스캔 성능에 영향을 미칩니다.
큰 테이블에 대한 스캔이 많은 분석 쿼리의 경우 열 기반 엔진을 사용하는 것이 좋습니다. 자세한 내용은 열 기반 엔진 모니터링을 참조하세요.
더 좁은 행 집합에 대한 쿼리의 경우 테이블에 큰 열과 자주 쿼리되는 작은 열이 모두 있으면 다음 옵션을 고려하세요.
- 더 큰 열을 기본이 아닌 지역성 그룹 (지정된 열을 디스크에 테이블의 나머지 부분과 별도로 저장) 또는 별도의 하위 테이블로 분리하여 더 작은 열을 스캔할 때 큰 열 데이터를 읽지 않도록 합니다. 자세한 내용은 지역 그룹 만들기 및 관리를 참조하세요.
- 추가 읽기 시간 최적화를 위해
STORING절을 사용하여 더 작은 열을 포함하여 기본 테이블과 동일한 기본 키를 사용하여 더 작은 열을 보조 색인에 복제합니다.
예를 들어 Documents 테이블 (이전 예시 스키마의 일부가 아님)이 큰 Content JSON 객체와 함께 작은 Metadata 문자열을 저장한다고 가정해 보겠습니다. Metadata만 저장하는 보조 색인을 만들 수 있으므로 Content가 필요하지 않은 쿼리는 기본 테이블 대신 더 작은 색인을 스캔할 수 있습니다.
CREATE TABLE Documents (
  Id INT64,
  Metadata STRING(MAX),
  Content JSON
) PRIMARY KEY (Id);

CREATE INDEX DocumentMetadata ON Documents(Id) STORING (Metadata);
대규모 인터리브 처리 데이터
테이블이 인터리브 처리되면 Spanner는 각 상위 행을 인터리브 처리된 하위 행과 함께 키 순서로 물리적으로 저장합니다. 상위 테이블에 인터리브 처리된 하위 행이 많거나 하위 테이블에 상위 또는 동위 테이블보다 행이 훨씬 적은 경우, 스캔이 다른 테이블의 인터리브 처리된 행을 건너뛰어야 하므로 더 작은 테이블에 대한 범위 스캔이 더 희소하고 효율성이 떨어집니다.
예를 들어 Transaction 및 AuthorizedPerson가 모두 Account에 인터리브 처리된 다음 스키마 (이전 예시 스키마의 일부가 아님)를 살펴보겠습니다.
CREATE TABLE Account (
  AccountId INT64,
  -- Additional columns omitted
) PRIMARY KEY (AccountId);

CREATE TABLE Transaction (
  AccountId INT64,
  TransactionId STRING(MAX),
  -- Additional columns omitted
) PRIMARY KEY (AccountId, TransactionId),
INTERLEAVE IN PARENT Account;

CREATE TABLE AuthorizedPerson (
  AccountId INT64,
  SignerId INT64,
  Name STRING(MAX),
  -- Additional columns omitted
) PRIMARY KEY (AccountId, SignerId),
INTERLEAVE IN PARENT Account;
모든 Account 행에 수천 개의 Transaction 행과 소수의 AuthorizedPerson 행이 있는 경우 Account 또는 AuthorizedPerson의 범위 스캔은 Transaction의 범위 스캔보다 행당 비용이 더 높습니다 (총비용은 여전히 더 낮음). 이는 Transaction 스캔이 한 번에 많은 연속된 Transaction 행을 읽는 반면, Account 또는 AuthorizedPerson 스캔은 동일한 테이블의 인접한 행이 더 적고 인터리브 처리된 Transaction 행을 건너뛰어야 하기 때문입니다.
희소 테이블 (Account 또는 AuthorizedPerson)에서 범위 스캔을 최적화하려면 큰 행에 대한 접근 방식과 유사하게 쿼리에 필요한 열을 복제하는 인터리브 처리되지 않은 보조 색인을 만듭니다.
CREATE INDEX AuthorizedPersonByAccount
  ON AuthorizedPerson(AccountId, SignerId)
  STORING (Name);
일괄 중심 실행 사용
Spanner는 행 중심 메서드 (한 번에 한 행 처리) 또는 일괄 중심 메서드(한 번에 행 블록 처리)를 사용하여 쿼리 스캔 및 쿼리 연산자를 실행할 수 있습니다. 다음 섹션에서는 일괄 지향 스캔 및 일괄 지향 연산자 실행을 검사하고 구성하는 방법을 설명합니다.
일괄 중심 스캔
특정 Spanner 쿼리는 데이터를 스캔할 때 보다 일반적인 행 중심 처리 방법이 아닌 일괄 중심 처리 방법을 사용하는 이점이 있을 수 있습니다. 일괄 처리로 스캔을 처리하는 것이 대량의 데이터 볼륨을 모두 한 번에 처리하는 것보다 효율적이며, 쿼리의 CPU 사용률과 지연 시간을 낮출 수 있습니다.
Spanner 스캔 작업은 항상 행 중심 방법으로 실행을 시작합니다. 이 시간 동안 Spanner는 여러 런타임 측정항목을 수집합니다. 그런 후 Spanner가 이러한 측정항목의 결과에 따라 일련의 휴리스틱을 적용하여 최적의 스캔 방법을 결정합니다. 해당되는 경우 Spanner는 일괄 중심 처리 방법으로 전환하여 스캔 처리량 및 성능을 향상시킵니다.
일반적인 사용 사례
다음 특성의 쿼리는 일반적으로 일괄 중심 처리를 사용하는 것이 좋습니다.
- 가끔 업데이트되는 데이터에 대한 대규모 스캔
- 고정 너비 열의 조건자를 사용하는 스캔
- 대규모 탐색 수로 스캔 (탐색은 색인을 사용하여 레코드를 검색함)
성능 이점이 없는 사용 사례
일괄 중심 처리가 모든 쿼리에 도움이 되지는 않습니다. 행 중심 스캔 처리 시 다음 쿼리 유형의 성능이 더 뛰어납니다.
- 포인트 조회 쿼리: 행 하나만 가져오는 쿼리
- 소규모 스캔 쿼리: 대규모 탐색 수가 있지 않으면 일부 행만 스캔하는 테이블 스캔
LIMIT절이 있는 쿼리: 고정된 수의 행을 반환한 후 스캔을 중지하는 쿼리입니다.- 변동률이 높은 데이터를 읽는 쿼리: 자주 업데이트되는 읽은 데이터의 약 10% 이상에서 수행되는 쿼리
- 큰 값이 포함된 행이 있는 쿼리: 단일 열에 32,000바이트보다 큰 값이 포함된 행에 대한 쿼리입니다 (압축 전).
쿼리에 사용된 스캔 방법 확인
쿼리가 일괄 처리, 행 중심 처리를 사용하는지 또는 두 스캔 방법이 자동으로 전환되는지 확인하려면 다음 단계를 따르세요.
Google Cloud 콘솔에서 Spanner 인스턴스 페이지로 이동합니다.
조사하려는 쿼리가 있는 인스턴스 이름을 클릭합니다.
데이터베이스 테이블에서 조사하려는 쿼리가 있는 데이터베이스를 클릭합니다.
Spanner 탐색 메뉴에서 Spanner Studio를 클릭합니다.
새 SQL 편집기 탭 또는 새 탭을 클릭합니다.
쿼리 편집기에 쿼리를 입력합니다.
실행을 클릭합니다.
Spanner가 쿼리를 실행하고 결과를 표시합니다.
쿼리 편집기 창에서 설명 탭을 클릭합니다.
Spanner가 쿼리 실행 계획 시각화 도구를 표시합니다. 그래프의 각 카드는 반복자를 나타냅니다. 실행 계획에 대한 자세한 내용은 쿼리 실행 계획을 참조하세요.
테이블 스캔 반복자 카드를 클릭하여 정보 패널을 엽니다.
정보 패널에는 스캔 메서드 (메서드)를 포함하여 선택한 스캔에 대한 컨텍스트 정보가 표시됩니다. 자동은 Spanner가 스캔 방법을 결정합니다. 다른 가능한 값으로는 일괄 중심 처리를 위한 일괄과 행 중심 처리를 위한 행이 있습니다(다음 이미지 참조).

쿼리에 사용된 스캔 방법 적용
쿼리 성능을 최적화하기 위해 Spanner는 쿼리에 대해 최적의 스캔 방법을 선택합니다. 이 기본 스캔 방법을 사용하는 것이 좋습니다. 하지만 특정 유형의 스캔 방법을 적용해야 할 수도 있습니다.
일괄 중심 스캔 적용
테이블 수준 및 문 수준에서 일괄 중심 스캔을 적용할 수 있습니다.
테이블 수준에서 일괄 중심 스캔 방법을 적용하려면 쿼리에 테이블 힌트를 사용하세요.
GoogleSQL
SELECT *
FROM (Singers@{SCAN_METHOD=BATCH} AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
PostgreSQL
SELECT *
FROM (Singers/*@ scan_method=batch */ AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
문 수준에서 일괄 중심 스캔 방법을 적용하려면 쿼리에 문 힌트를 사용하세요.
GoogleSQL
@{SCAN_METHOD=BATCH}
SELECT *
FROM Singers;
PostgreSQL
/*@ scan_method=batch */
SELECT *
FROM Singers;
문 수준 힌트를 사용하면 전체 쿼리에 적용됩니다. 테이블 수준에서 힌트를 설정하는 것이 더 좋으며 더 세분화된 제어를 제공합니다.
행 중심 스캔 적용
Spanner에서 설정한 자동 스캔 방법을 사용 중지하지 않는 것이 좋지만 지연 시간을 진단하는 것과 같은 문제 해결을 위해 이를 사용 중지하고 행 중심 스캔 방법을 사용할 수도 있습니다.
자동 스캔 방법 선택을 사용 중지하고 테이블 수준에서 행 처리를 적용하려면 쿼리에 테이블 힌트를 사용하세요.
GoogleSQL
SELECT *
FROM (Singers@{SCAN_METHOD=ROW} AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
PostgreSQL
SELECT *
FROM (Singers/*@ scan_method=row */ AS s
  JOIN Albums AS a ON s.SingerId = a.SingerId);
자동 스캔 방법을 사용 중지하고 문 수준에서 행 처리를 적용하려면 쿼리에 문 힌트를 사용하세요.
GoogleSQL
@{SCAN_METHOD=ROW}
SELECT *
FROM Singers;
PostgreSQL
/*@ scan_method=row */
SELECT *
FROM Singers;
실행 메소드입니다.
일괄 중심 스캔 외에도 문 수준에서 실행 방법을 적용하여 쿼리 실행을 최적화할 수도 있습니다. 이는 일부 연산자에만 작동하며 스캔 연산자에서만 사용하는 스캔 방법과는 무관합니다. 일괄 지향 스캔에 대한 자세한 내용은 이 문서의 일괄 지향 스캔 섹션을 참조하세요.
기본적으로 대부분의 연산자는 한 번에 한 행씩 데이터를 처리하는 행 중심 방법으로 실행됩니다. 벡터화된 연산자는 일괄 중심 방법으로 실행되어 실행 처리량과 성능을 개선합니다. 이러한 연산자는 한 번에 한 블록씩 데이터를 처리합니다. 연산자가 많은 행을 처리해야 하는 경우 일반적으로 일괄 중심 실행 방법이 더 효율적입니다.
실행 방법과 스캔 방법 비교
쿼리 실행 방법은 쿼리 스캔 방법과 관련이 없습니다. 쿼리 힌트에서 이러한 방법 중 하나 또는 둘 다 설정하거나 아예 설정하지 않을 수 있습니다.
쿼리 실행 방법은 쿼리 연산자가 중간 결과를 처리하는 방식과 연산자가 서로 상호작용하는 방식을 나타내고, 스캔 방법은 스캔 연산자가 Spanner 스토리지 레이어와 상호작용하는 방식을 나타냅니다.
쿼리에 사용된 실행 방법 적용
쿼리 성능을 최적화하기 위해 Spanner에서는 다양한 휴리스틱을 기반으로 쿼리에 대해 최적의 실행 방법을 선택합니다. 이 기본 실행 방법을 사용하는 것이 좋습니다. 하지만 특정 유형의 실행 방법을 적용해야 할 수도 있습니다.
문 수준에서 실행 방법을 적용할 수 있습니다. EXECUTION_METHOD 쿼리 힌트는 지시문이 아닌 권장사항입니다. 궁극적으로 각 연산자에 사용할 방법은 쿼리 옵티마이저에서 결정합니다.
문 수준에서 일괄 중심 실행 방법을 적용하려면 쿼리에 문 힌트를 사용하세요.
GoogleSQL
@{EXECUTION_METHOD=BATCH}
SELECT *
FROM Singers;
PostgreSQL
/*@ EXECUTION_METHOD=BATCH */
SELECT *
FROM Singers;
Spanner에서 설정한 자동 실행 방법을 사용 중지하지 않는 것이 좋지만 지연 시간을 진단하는 것과 같은 문제 해결을 위해 이를 사용 중지하고 행 중심 실행 방법을 사용할 수도 있습니다.
자동 실행 방법을 사용 중지하고 문 수준에서 행 중심 실행 방법을 적용하려면 쿼리에 문 힌트를 사용하세요.
GoogleSQL
@{EXECUTION_METHOD=ROW}
SELECT *
FROM Singers;
PostgreSQL
/*@ EXECUTION_METHOD=ROW */
SELECT *
FROM Singers;
사용 설정된 실행 방법 확인
모든 Spanner 연산자가 일괄 중심 실행 방법과 행 중심 실행 방법을 모두 지원하는 것은 아닙니다. 각 연산자에 대해 쿼리 실행 계획 시각화 도구는 반복자 카드에 실행 방법을 표시합니다. 일괄 중심 실행 방법인 경우 일괄이 표시되고, 행 중심 실행 방법인 경우 행이 표시됩니다. 시각화 도구에 대한 자세한 내용은 쿼리 실행 계획을 참조하세요.
쿼리의 연산자가 서로 다른 실행 방법을 사용하여 실행되는 경우 실행 방법 어댑터 DataBlockToRowAdapter 및 RowToDataBlockAdapter가 연산자 사이에 표시되어 실행 방법의 변경사항을 보여줍니다. 이러한 연산자에 대한 자세한 내용은 DataBlockToRowAdapter 및 RowToDataBlockAdapter를 참조하세요.