


Dieser Leitfaden bietet einen Überblick über die Zuverlässigkeitsfunktionen von Pub/Sub.
Vorteile von Pub/Sub
Als Messaging-Paradigma ist Publish-Subscribe so konzipiert, dass die Ersteller von Nachrichten von den Nutzern dieser Nachrichten entkoppelt werden. Anstatt dass Ersteller direkte Anfragen mit den Daten an die Nutzer senden, veröffentlichen sie diese Daten in einem Pub/Sub-Dienst wie Pub/Sub. Der Dienst stellt diese Nachrichten asynchron an interessierte Nutzer zu, die sie abonniert haben.
Der Dienst übernimmt alle komplexen Aufgaben, die mit der Suche nach Nutzern verbunden sind, die an den Daten interessiert sind. Der Dienst verwaltet auch die Rate, mit der die Nutzer die Daten empfangen, basierend auf ihrer Kapazität. Durch die Entkopplung können Datenproduzenten Nachrichten in großem Umfang mit niedriger Latenz schreiben, unabhängig vom Verhalten der Konsumenten.
Pub/Sub bietet eine hochskalierbare, zuverlässige Zustellung von Nachrichten. Der Dienst übernimmt einen Großteil davon automatisch, Sie haben jedoch die Kontrolle über verschiedene Aspekte Ihrer Publisher und Abonnenten, die sich auf die Verfügbarkeit und Leistung auswirken können. Im weiteren Verlauf dieses Leitfadens finden Sie einige Details zu diesen Aspekten.
Isolation
Standardmäßig ist Pub/Sub ein globaler Dienst: Themen und Abos sind nicht an bestimmte Regionen gebunden und Nachrichten werden bei Bedarf innerhalb des Pub/Sub-Dienstes zwischen Regionen übertragen. Wenn Sie den globalen Endpunkt pubsub.googleapis.com verwenden, stellen Publisher und Abonnenten eine Verbindung zur nächstgelegenen Region her, in der Pub/Sub ausgeführt wird. Wenn Sie regionale Endpunkte wie pubsub.us-central1.rep.googleapis.com oder standortbezogene Endpunkte wie us-central1-pubsub.googleapis.com verwenden, stellen Publisher und Abonnenten eine Verbindung zu Pub/Sub in der angegebenen Region her. Wenn Sie Publisher oder Abonnenten außerhalb von Google Cloudausführen, sollten Sie regionale oder standortbezogene Endpunkte verwenden, damit Nachrichten konsistent zwischen den erwarteten Regionen fließen.
Regionale Isolation
So minimieren Sie die Infrastruktur, von der Veröffentlichungs- und Abovorgänge außerhalb einer einzelnen Region abhängen, und sorgen dafür, dass alle Daten in dieser Region isoliert bleiben:
Erstellen Sie ein Thema pro Region.
Der Namespace von Pub/Sub ist global und Sie können Themen und Abos nicht an eine bestimmte Region binden. Die Metadaten für alle Ressourcen werden jedoch in lokalen Datenspeichern innerhalb der Region repliziert. Sobald Sie eine Ressource erstellt haben, ist ihre Konfiguration daher auch im Falle eines Problems in einer anderen Region verfügbar. Beachten Sie, dass Aktualisierungen der Thema- oder Abo-Konfigurationen im Falle eines Ausfalls möglicherweise nicht sofort weitergegeben werden.
Vermeiden Sie die Verwendung globaler Endpunkte.
Verwenden Sie stattdessen regionale Endpunkte, sofern verfügbar, und Standortendpunkte, wenn keine regionalen Endpunkte verfügbar sind. Regionale Endpunkte bieten eine bessere regionale Isolation, sind aber noch nicht in allen Regionen verfügbar.
Verwenden Sie eine Richtlinie für die Nachrichtenspeicherung und setzen Sie
enforceInTransitaufTrue.Mit Während der Übertragung erzwingen verlassen die Daten die Region nie und alle Clients, die eine Verbindung zum Thema in einer bestimmten Region herstellen, legen die Nachrichtenspeicherrichtlinie für diese Region fest.
Wenn Themen so konfiguriert sind, können Sie sicher sein, dass alle Veröffentlichungs- und Abovorgänge Daten ausschließlich innerhalb der Region schreiben und lesen. Bei Ausfällen von Publishern, Abonnenten oder Pub/Sub in einer einzelnen Region wird die Nachrichtenzustellung in dieser Region beendet. Die Nachrichtenzustellung für Themen und Abos in anderen Regionen ist nicht betroffen.
Wenn Sie die administrativen Vorgänge und den Namespace Ihrer Themen und Abos ebenfalls regional isolieren müssen, sollten Sie Managed Service for Apache Kafka verwenden.
Failover
Wenn Sie keine regionale Isolation benötigen, können Sie die Fähigkeit von Pub/Sub nutzen, Nachrichten effizient über mehrere Regionen hinweg zuzustellen, um multiregionale Failover-Funktionen zu erreichen. Im weiteren Verlauf dieses Abschnitts wird erläutert, wie Sie Themen und Abos erstellen und Publisher und Abonnenten platzieren, um verschiedene Arten von Failover und Datenredundanz zu unterstützen.
Standard-Failover-Semantik
Angenommen, es gibt ein einzelnes Thema und ein einzelnes Abo. Die Publisher befinden sich in Regionen der USA und Australiens und die Abonnenten in den Google Cloud -Regionen Europas und Australiens. Wenn alle Abonnenten genügend Kapazität zum Empfangen von Nachrichten haben, sieht der Nachrichtenfluss so aus:
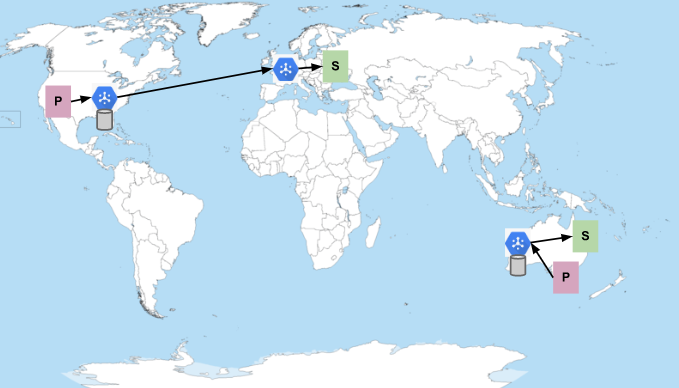
Die P stehen für Publisher, die S für Abonnenten. Das blaue Sechseck stellt den Pub/Sub-Dienst dar. Die Zylinder stellen die Orte dar, an denen Nachrichten gespeichert werden. Nachrichten werden immer in mehreren Zonen in der Region gespeichert, in der sie veröffentlicht werden. Pub/Sub sendet Nachrichten bevorzugt innerhalb derselben Region, in der sie veröffentlicht wurden, wenn Abonnenten verfügbar sind. Andernfalls werden die Nachrichten an die Region im Netzwerk gesendet, die Abonnenten mit Kapazität hat. Wie in der vorherigen Abbildung dargestellt, werden in den USA veröffentlichte Nachrichten an Abonnenten in Europa zugestellt und in Australien veröffentlichte Nachrichten bleiben in Australien.
In den folgenden Abschnitten wird beschrieben, was in verschiedenen Ausfallszenarien passiert.
Abonnenten in Europa sind nicht verfügbar
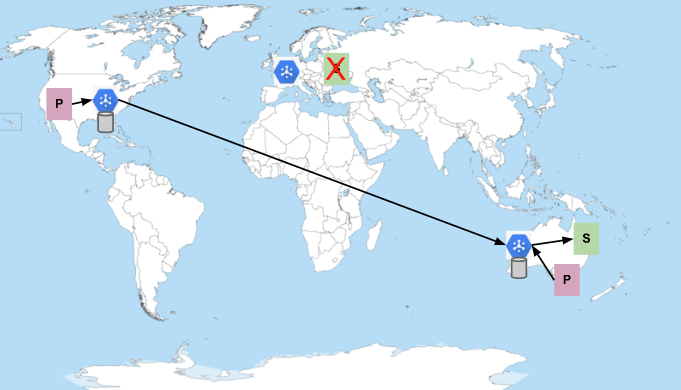
Angenommen, Abonnenten in Europa wurden abgelehnt oder stürzten häufig ab und konnten keine Verbindung zu Pub/Sub aufrechterhalten. In diesem Fall würde der Dienst Nachrichten an Abonnenten in Australien senden:
Abonnenten in Europa und Australien sind nicht verfügbar
Wenn alle Abonnenten nicht verfügbar sind, speichert Pub/Sub die Nachrichten bis zur konfigurierten Nachrichtenaufbewahrungsdauer.
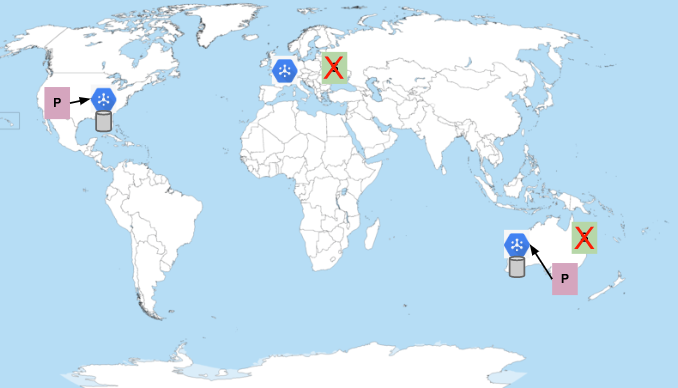
Sobald die Abonnenten wieder verbunden sind, werden die Nachrichten zugestellt, sofern der Ausfall nicht länger als die konfigurierte Nachrichtenaufbewahrungsdauer dauert. Standardmäßig ist die Aufbewahrungsdauer für Abonachrichten auf 7 Tage festgelegt. Sie können auch die Nachrichtenaufbewahrung für ein Thema für bis zu 31 Tage konfigurieren. Wählen Sie keine Aufbewahrungsdauer für Nachrichten, die kürzer ist als der maximale Ausfall, den Sie erwarten oder tolerieren möchten.
Pub/Sub ist in Europa nicht verfügbar
In seltenen Fällen kann es auch vorkommen, dass Pub/Sub selbst nicht verfügbar ist. Die Nichtverfügbarkeit von Pub/Sub äußert sich in längeren Zeiträumen mit unerwarteten Fehlern bei Veröffentlichungs- oder Aboanfragen oder in der Unfähigkeit, veröffentlichte Nachrichten an Abonnenten zuzustellen. Wenn Pub/Sub beispielsweise in der Region in Europa ausfällt, sieht das Szenario ähnlich aus wie bei einem Ausfall von Abonnenten:
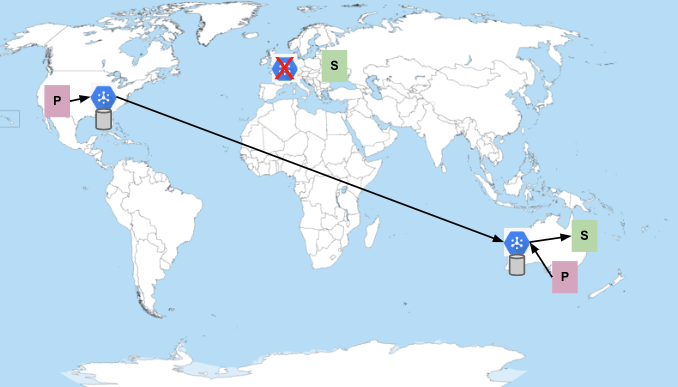
Beachten Sie, dass in diesem Fall die Abonnenten in Europa nicht auf eine andere Region umgestellt werden, auch wenn der globale Endpunkt verwendet wird. Pub/Sub führt absichtlich kein automatisches Failover durch. Stellen Sie sich vor, dass die Abonnenten selbst ein unerwartetes Problem in Pub/Sub verursachen, das zu einer Nichtverfügbarkeit führt. Ein solches Problem wird als schwerwiegender Ausfall behandelt. Der Umfang der Auswirkungen des Ausfalls kann jedoch auf die Region beschränkt werden, mit der die Abonnenten verbunden sind. Wenn der Dienst ein Failover in eine andere Region zulassen würde, könnten die Abonnenten auch dort zu einer Nichtverfügbarkeit führen, was zu einem kaskadierenden Ausfall im gesamten Dienst führen würde.
Publisher in Australien sind nicht verfügbar
Wenn die Publisher in einer Region nicht mehr verfügbar sind, werden die bereits veröffentlichten Nachrichten weiterhin an die nächstgelegenen Abonnenten zugestellt:
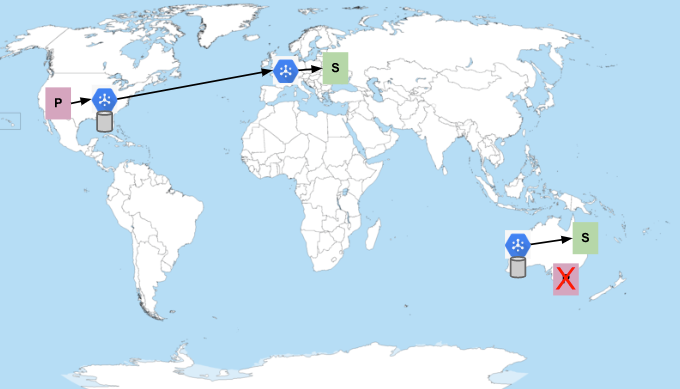
Schließlich werden alle Nachrichten von Abonnenten konsumiert und bestätigt. Beim Senden von Nachrichten versucht Pub/Sub, die Netzwerkentfernung zu minimieren. Daher können die Abonnenten in der Region in Australien keine Nachrichten mehr empfangen, wenn die Abonnenten in Europa genügend Kapazität haben, um alle in den USA veröffentlichten Nachrichten zu verarbeiten.
Pub/Sub ist in den USA nicht verfügbar.
Pub/Sub schreibt Nachrichten synchron in mehrere Zonen innerhalb einer Region. Daher reicht ein zonaler Ausfall nicht aus, um die Zustellung von Nachrichten zu verhindern. Die gesamte Region muss nicht verfügbar sein. Wenn Pub/Sub in einer Region, in der Publisher Nachrichten senden, nicht mehr verfügbar ist, werden Nachrichten in dieser Region möglicherweise erst zugestellt, wenn der Dienst vollständig wiederhergestellt ist:
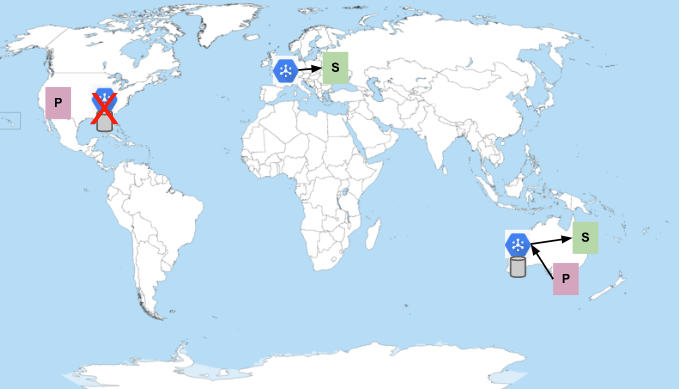
Die Nachricht wird letztendlich zugestellt (vorausgesetzt, die Aufbewahrungsdauer für Nachrichten ist nicht abgelaufen), verzögert um die Dauer des Ausfalls. Beachten Sie, dass die Publisher in den USA ähnlich wie die Abonnenten nicht auf eine andere Region umgestellt werden, wenn der Dienst ausfällt. Dieses Verhalten trägt dazu bei, die Wahrscheinlichkeit von Fehlerkaskaden in verschiedenen Regionen aufgrund eines fehlerhaften Publishers oder Abonnenten zu verringern.
Vom Kunden gesteuertes Failover und Redundanz
Die standardmäßige Failover-Semantik von Pub/Sub garantiert möglicherweise nicht vollständig, dass Nachrichten immer von Publishern an Abonnenten weitergeleitet werden können, wenn es irgendwo dazwischen zu einem Ausfall kommt. Ausfälle können an verschiedenen Stellen auftreten, z. B. bei Ihren Clients, im Dienst, in dem Ihre Publisher oder Abonnenten ausgeführt werden, im Netzwerk oder in seltenen Fällen auch in Pub/Sub selbst. Wenn Ihre Dienste gegen solche Ausfälle resistent sein müssen, müssen Sie eigene Redundanzen implementieren. In der Regel umfassen diese Redundanzen die Verwendung mehrerer Instanzen von Publisher- und Subscriber-Clients, die jeweils einen anderen Standortendpunkt verwenden.
Möglicherweise möchten Sie Ausfallsicherheit für zwei verschiedene Auswirkungen: zonal oder regional. Hier sind die Einrichtungsoptionen für die einzelnen Optionen.
Zonale Ausfallsicherheit
Pub/Sub bietet eine integrierte zonenübergreifende Replikation. Sie müssen keine besonderen Schritte unternehmen, um Ausfälle in einer einzelnen Zone zu beheben, die den Dienst selbst betreffen. Damit Ihre Clients oder Ihr Netzwerk jedoch vor Ausfällen geschützt sind, sollten Sie Publisher und Subscriber mit ausreichender Kapazität in mehreren Zonen innerhalb der Region ausführen. Wenn eine einzelne Zone ausfällt, können die Clients in der anderen Zone den Traffic übernehmen und die Nachrichten verarbeiten. Es empfiehlt sich, Änderungen an diesen Clients nicht gleichzeitig zu veröffentlichen. Wenn ein Fehler auftritt, können die anderen, unberührten Zonen weiterhin Nachrichten verarbeiten.
Regionale Ausfallsicherheit
Richten Sie zusätzliche Redundanzen bei Ihren Publishern und Abonnenten ein, um sich vor regionalen Ausfällen zu schützen. Sie können Publisher und Abonnenten in mehreren Regionen ausführen, um die Möglichkeit von Ausfällen bei diesen Clients oder im Netzwerk zu berücksichtigen.
Wenn Sie sich gegen potenzielle Pub/Sub-Ausfälle in einer Region absichern möchten, müssen Sie einen Failover-Mechanismus für einen solchen Ausfall bereithalten. Die möglichen Ansätze sind ein Kompromiss zwischen der End-to-End-Latenz der Nachrichtenzustellung und Ihren Kosten.
Wenn Sie die Latenz minimieren möchten und die Kosten keine Rolle spielen, ist es am besten, immer gleichzeitig in verschiedenen Regionen zu veröffentlichen und zu abonnieren. Wählen Sie zuerst die Anzahl der Regionen aus, in denen Sie Redundanz wünschen. Als Nächstes können Sie ein Thema und ein Abo für jede dieser Regionen einrichten, obwohl dies nicht unbedingt erforderlich ist.
Jeder Publisher erstellt so viele Publisher-Clients, wie es Regionen gibt (einen für jede Region), und verwendet einen anderen Standortendpunkt, damit Nachrichten an verschiedene Regionen weitergeleitet werden. Wenn Sie separate Themen verwenden, muss jeder Publisher-Client im entsprechenden, regionsspezifischen Thema veröffentlichen. Für jede Nachricht ruft der Publisher „publish“ auf jedem Client auf. Bei redundanten Veröffentlichungen ist es nicht erforderlich, Veröffentlichungen noch einmal zu versuchen, wenn eine einzelne fehlschlägt.
Ebenso erstellt jeder Abonnent so viele Abonnentenclients (einen für jede Region) und verwendet einen Standortendpunkt, um eine Verbindung zu einer anderen Region herzustellen. Wenn Sie für jede Region unterschiedliche Abos verwenden, muss jeder Abonnentenclient das entsprechende Abo verwenden. Die für Publisher und Abonnenten verwendeten Regionen müssen nicht unbedingt identisch sein. Abonnenten empfangen Nachrichten über die drei Abos und verarbeiten sie.
Diese Einrichtung hat mehrere wichtige Funktionen und Anforderungen:
- Ein Ausfall in einer einzelnen Region hat keine Auswirkungen auf die Verarbeitung von Nachrichten, die bereits veröffentlicht wurden, oder auf Nachrichten, die während des Ausfalls veröffentlicht wurden. Da Nachrichten in mehreren Regionen veröffentlicht wurden, sind sie auch dann in anderen Regionen verfügbar, wenn eine Region ausgefallen ist. Während des Ausfalls schlagen Veröffentlichungsaufrufe in der betroffenen Region fehl, sind aber in den anderen Regionen erfolgreich.
- Die Latenz bei der Nachrichtenverarbeitung wird nicht beeinträchtigt, solange eine der Regionen, über die Nachrichten fließen, verfügbar ist.
- Die Nachrichtenverarbeitung muss idempotent sein. Da jede Nachricht mehrmals zugestellt wird, muss die Nachrichtenverarbeitung unempfindlich gegenüber Duplikaten sein. Bei einem regionalen Ausfall können einige dieser Duplikate viel später als die erste Zustellung der Nachricht eintreffen. Diese Duplikate stammten wahrscheinlich aus einer anderen Region, in der es keinen Ausfall gab.
Diese Art von Redundanz bietet die höchste Ausfallsicherheit. Für interne Google-Dienste, die auf Pub/Sub basieren und die höchste Verfügbarkeit erfordern, wird diese Einrichtung bevorzugt. Diese Einrichtung hat jedoch den Nachteil, dass die Kosten für die Nachrichtenzustellung mit der Anzahl der verwendeten Regionen multipliziert werden. Außerdem fallen zusätzliche Kosten für die interregionale Netzwerknutzung für Nachrichten an, die zwischen Regionen übertragen werden müssen.
Ein anderer Ansatz für Redundanz besteht darin, nur dann ein Failover durchzuführen, wenn Anfragen fehlschlagen oder Nachrichten nicht wie erwartet von Publishern an Abonnenten weitergeleitet werden. In diesem Szenario haben Sie eine primäre Region, an die Sie Ihre Publisher und Abonnenten über Standortendpunkte weiterleiten. Wie zuvor müssen diese nicht dieselbe Region sein. Außerdem haben Sie eine Fallback-Region für Publisher und Abonnenten, die verwendet wird, wenn die primäre Region nicht verfügbar ist.
Publisher veröffentlichen nur in der primären Region (über den Standortendpunkt), wenn die Anfragen erfolgreich gesendet wurden. Wenn die Region als ausgefallen erkannt wird, veröffentlichen Publisher stattdessen in der Fallback-Region. Es gibt zwei Möglichkeiten, um festzustellen, dass die Region ausgefallen ist, und ein Failover durchzuführen. Dies kann manuell erfolgen, wobei die Konfiguration bei den Verlagen und Webpublishern dynamisch aktualisiert wird. Die Publisher können die Konfiguration auch selbst aktualisieren, wenn die Fehlerrate bei Veröffentlichungsanfragen ausreichend hoch ist.
Abonnenten müssen immer über den Standortendpunkt eine Verbindung zur primären Region herstellen. Sie können festlegen, dass der Abonnent die Fallback-Region mit einem oder mehreren der folgenden Trigger verwenden kann:
- Abonnieren Sie immer die Fallback-Region. In diesem Fall hält der Abonnent jederzeit eine Verbindung sowohl zur primären Region als auch zur Fallback-Region aufrecht. Sowohl für Publisher als auch für Abonnenten können dieselben Regionen für die primäre und die Fallback-Region verwendet werden. In diesem Fall darf der Abonnent nur dann Nachrichten über die Sicherungsregion empfangen, wenn der Publisher ein Failover durchgeführt hat.
- Abonnenten manuell über eine Konfiguration erkennen und zur Fallback-Region wechseln. Wenn Sie einen Ausfall feststellen, können Sie ein Failover zur Fallback-Region durchführen und dann zur primären Region zurückkehren, wenn der Ausfall behoben ist.
- Failover bei Abonnentenfehlern. Wenn die Abonnentenanfragen Fehler zurückgeben, können Sie dies als Hinweis darauf verwenden, dass Sie ein Failover zur Fallback-Region durchführen müssen. Beachten Sie, dass die Pub/Sub-Clientbibliotheken Streaming-Pull-Anfragen bei vorübergehenden Fehlern intern wiederholen. Daher können Sie möglicherweise nicht erkennen, dass es lange Zeiträume mit unerwarteten Fehlern gibt. Außerdem wird die Fehlerrate für Streaming-Pull-Anfragen voraussichtlich 100 % betragen, auch während des normalen Betriebs.
- Führen Sie ein Failover durch, wenn der Abonnent unerwartet lange keine Nachrichten empfängt. Wenn Nachrichten konsistent veröffentlicht werden, können die Abonnenten immer Nachrichten empfangen. Wenn sie über einen längeren Zeitraum keine Nachrichten erhalten, liegt möglicherweise ein Problem auf der Abonnentenseite in Pub/Sub in der primären Region vor. Dies wird durch ein Failover zur Fallback-Region behoben.
Von allen vier Optionen ist die erste ideal. Eine Abonnentenverbindung kostet nichts, wenn keine Nachrichten darüber gesendet werden. Die einzigen Kosten entstehen durch den Speicherbedarf der zusätzlichen Instanz der Subscriber-Clientbibliothek, der vernachlässigbar sein kann. Außerdem müssen Sie das Kontingent für die Anzahl der offenen StreamingPull-Verbindungen pro Region beachten.
Der Vorteil dieses zweiten Modells besteht darin, dass es keinen Multiplikator für die Pub/Sub-Kosten gibt, da Nachrichten nur einmal veröffentlicht werden. Der Nachteil ist jedoch, dass bei bestimmten Arten von Ausfällen Nachrichten, die vor Beginn des Ausfalls veröffentlicht wurden, möglicherweise erst nach Behebung des Ausfalls verfügbar sind. Nachrichten, die in der nicht verfügbaren Region gespeichert sind, können möglicherweise nicht an Abonnenten zugestellt werden, unabhängig davon, wo sie verbunden sind. Nachrichten, die während des Ausfalls in der Fallback-Region veröffentlicht wurden, können verfügbar sein. Darüber hinaus kann es zu einer Phase der Nichtverfügbarkeit mit erhöhten Fehlerraten für die Publisher oder Abonnenten kommen. Dies hängt von der Methode ab, mit der ein Ausfall erkannt wird, und von der Zeit, die für das Failover auf die Fallback-Region benötigt wird.
Unabhängig davon, für welche Option Sie sich entscheiden, sollten Sie sich darüber im Klaren sein, wie sich dies auf die Funktionen von Pub/Sub auswirken kann. Sowohl die Zustellung in der richtigen Reihenfolge als auch die genau einmalige Zustellung bieten ihre Garantien innerhalb einer Region. Wenn Sie beispielsweise die Failover-Redundanztechnik verwenden, wird die Nachrichtenzustellung nur für Nachrichten garantiert, die in derselben Region veröffentlicht wurden. Der Abonnent könnte Nachrichten, die in der Fallback-Region veröffentlicht wurden, vor Nachrichten erhalten, die in der primären Region veröffentlicht wurden, selbst wenn die Nachrichten zuerst in der primären Region veröffentlicht wurden.
Publisher für die Feinabstimmung
Unabhängig davon, welche der Failover-Optionen Sie wählen, sollten Sie einige zusätzliche Optimierungsschritte in den Publishern selbst vornehmen. Durch die Optimierung des Publisher-Verhaltens wird eine optimale Leistung bei hoher Last sichergestellt. Batching von Nachrichten ist eine Möglichkeit, die Latenz gegen geringere Kosten einzutauschen, ist aber kein Zuverlässigkeitsproblem und wird daher hier nicht behandelt. Konzentrieren Sie sich stattdessen auf einige der anderen Parameter, die für die Zuverlässigkeit nützlich sind, einschließlich der Einstellungen für Wiederholungsversuche und die Flusssteuerung.
Veröffentlichungen können aus verschiedenen Gründen fehlschlagen, z. B. aufgrund vorübergehender Probleme wie Netzwerkausfällen oder Problemen, die ein Eingreifen des Nutzers erfordern, z. B. Berechtigungsänderungen. Die Pub/Sub-Clientbibliothek wiederholt vorübergehende Fehler mit den in den Wiederholungseinstellungen angegebenen Parametern. Diese Einstellungen steuern das Verhalten des exponentiellen Backoffs bei Wiederholungsversuchen von Veröffentlichungs-RPCs, die aus vorübergehenden Gründen fehlschlagen. Die Standardeinstellungen funktionieren in den meisten Szenarien in der Regel gut, aber es gibt Situationen, in denen Sie diese Werte möglicherweise anpassen möchten.
Die beiden Properties, die Sie am wahrscheinlichsten anpassen möchten, sind das anfängliche RPC-Zeitlimit und das Gesamtzeitlimit. Das anfängliche RPC-Zeitlimit gibt an, wie lange der erste Veröffentlichungs-RPC Zeit hat, um abgeschlossen zu werden. Wenn ein RPC fehlschlägt oder eine Zeitüberschreitung auftritt, wird ein anderer mit einer längeren Zeitüberschreitung versucht, bis die Gesamtzahl der Anfragen oder die Gesamtzeitüberschreitung überschritten wird.
Das anfängliche Zeitlimit kann angepasst werden, wenn Ihr Publisher netzwerkbeschränkt oder weit vom nächsten Google Cloud -Rechenzentrum entfernt ist, in dem Pub/Sub ausgeführt wird. Netzwerkeinschränkungen können Einschränkungen des Durchsatzes der Maschine sein, auf der der Publisher ausgeführt wird, oder das Ergebnis anderer Dienste, die auf derselben Maschine ausgeführt werden und netzwerkintensiv sind. Wenn das Zeitlimit zu kurz ist, können die ersten RPCs wiederholt fehlschlagen, sodass mehr Versuche (mit längeren Zeitlimits) erforderlich sind, um die Veröffentlichung erfolgreich abzuschließen. Die wiederholte Notwendigkeit von Wiederholungsversuchen erhöht die Veröffentlichungslatenz. In dieser Situation kann eine Erhöhung des anfänglichen Zeitlimits zu schnelleren Veröffentlichungen führen.
Wenn die Netzwerkverbindung unzuverlässig ist, kann es helfen, das Gesamtzeitlimit sowie das anfängliche Zeitlimit zu erhöhen. Durch ein erhöhtes Gesamtzeitlimit hat der Veröffentlichungs-RPC mehr Zeit, um erfolgreich abgeschlossen zu werden. Wenn Veröffentlichungs-RPCs immer wieder mit Fehlern vom Typ „Frist überschritten“ fehlschlagen, sollten Sie diese Werte anpassen.
Wenn beim Veröffentlichen immer wieder Fehler aufgrund einer überschrittenen Frist auftreten, kann das auch ein Hinweis darauf sein, dass die Flusssteuerung des Publishers angepasst werden muss. Mit diesen Einstellungen können Sie dafür sorgen, dass Ihre Publisher widerstandsfähig gegenüber Spitzen im eingehenden Traffic sind, die dazu führen, dass mehr Nachrichten an Pub/Sub gesendet werden. Ein starker Anstieg der ausgehenden Anfragen kann die CPU, den Arbeitsspeicher oder die Netzwerkkapazität des Publishers überlasten. Wenn der Veröffentlichungsvorgang überlastet ist, können Veröffentlichungsanfragen oder -antworten nicht vor den Zeitüberschreitungen verarbeitet werden. Dies führt zu noch mehr Veröffentlichungsanfragen und letztendlich zum Erreichen des Gesamtzeitlimits. Die Publisher-Flusssteuerung begrenzt die Anzahl der Nachrichten oder Byte, die ohne Antwort auf die Veröffentlichungsanfrage ausstehen können. Durch die Begrenzung der Anzahl der Anfragen bleibt die Ressourcenauslastung auch bei Spitzen auf einem überschaubaren Niveau. Je nachdem, wie Ihr Publisher funktioniert, können Sie nachfolgende Veröffentlichungs-RPCs auf Kapazität warten lassen, indem Sie zulassen, dass die Veröffentlichung weitere Anfragen blockiert. Alternativ können Sie die Aufrufer Ihres Dienstes zurückweisen, indem Sie die Flusssteuerung so konfigurieren, dass ein Fehler zurückgegeben wird, wenn die Kapazität erreicht ist. Sie konfigurieren, wie die Publisher-Clientbibliothek auf das Verhalten bei Überschreitung des Limits reagiert.
Abonnenten für die Feinabstimmung
Möglicherweise ist auch eine Abstimmung der Abonnenten erforderlich, um einen zuverlässigen Betrieb zu gewährleisten. Ähnlich wie bei Publishern können Sie die Einstellungen für die Ablaufsteuerung von Abonnenten anpassen, um sicherzustellen, dass sie nicht überlastet werden. Die Abonnenten-Clientbibliothek verwendet Streaming-Pull. Dabei öffnet der Client einen persistenten Stream zum Server und der Server sendet Nachrichten, sobald sie verfügbar sind. Wenn die Anzahl der veröffentlichten Nachrichten stark ansteigt, erhält der Abonnent möglicherweise mehr Nachrichten, als er verarbeiten kann. Mit der Flusssteuerung wird die Anzahl der unbestätigten Nachrichten, die gleichzeitig an den Client gesendet werden, begrenzt. Dadurch wird die Anzahl der gleichzeitig verarbeiteten Nachrichten reduziert und die Verarbeitung über einen längeren Zeitraum verteilt. Durch die Verteilung der Last können Abonnenten die Ressourcenbeschränkungen einhalten, die sich auf die Nachrichtenverarbeitung auswirken. Dies kann zu einem Kaskadeneffekt führen, der dazu führt, dass keine Nachrichten mehr verarbeitet werden können.
Die Flusssteuerung allein reicht aus, wenn Sie nur Spitzen bei der zu verarbeitenden Datenmenge erwarten, die letztendlich zurückgehen. Wenn der Traffic im Laufe der Zeit aufgrund einer höheren Nutzung zunimmt, schützt die Flusssteuerung die Abonnenten. Dies kann jedoch zu einem Rückstand führen, der sich weiter aufbaut und dazu führt, dass Nachrichten nicht vor Ablauf der Aufbewahrungsdauer zugestellt werden können. In solchen Fällen können Sie das Autoscaling auch so einstellen, dass mehr Abonnenten als Reaktion auf eine wachsende Anzahl nicht bestätigter Nachrichten aktiviert werden. Die Einrichtung hängt von der Computing-Plattform ab, die Sie für Ihre Abonnenten verwenden. Mit dem Autoscaling von Compute Engine können Sie beispielsweise basierend auf Messwerten wie der Anzahl der nicht zugestellten Nachrichten skalieren. Durch die Verwendung von Autoscaling und Flusssteuerung können Sie dafür sorgen, dass Ihre Abonnenten gegen andere kurzfristige Spitzen beim Nachrichtendurchsatz und längerfristiges Wachstum, das mehr Rechenleistung erfordert, geschützt sind. Beachten Sie die Best Practices für die Verwendung von Pub/Sub-Messwerten als Skalierungssignal.
Regionale Version der Backlog-Messwerte anstelle der globalen Versionen verwenden
Wenn Sie Ihren Abo-Backlog überwachen, Benachrichtigungsrichtlinien konfigurieren oder Abonnenten automatisch skalieren, bietet Pub/Sub zwei Versionen jedes Backlog-Messwerts. Verwenden Sie die Versionen mit dem Suffix by_region:
Verwenden Sie nicht die globalen Versionen dieser Messwerte (subscription/num_undelivered_messages und subscription/oldest_unacked_message_age), wenn Sie möchten, dass Ihr Monitoring, Ihre Benachrichtigungen und Ihr Autoscaling gegen Ausfälle in einer einzelnen Region resistent sind. Für die globalen Versionen dieser Messwerte muss der Rückstand in allen Regionen berechnet werden, in denen Nachrichten vorhanden sind. Das bedeutet, dass die Nichtverfügbarkeit in einer einzelnen Region zu einer Datenlücke führt. Im Gegensatz dazu berechnen die by_region-Versionen der Messwerte den Rückstand pro Region und melden ihn. Wenn der Rückstand für eine einzelne Region nicht berechnet werden kann, werden für den Messwert weiterhin Werte für die anderen Regionen gemeldet.
Snapshot und Suchvorgang für sichere Bereitstellungen verwenden
Der Verlust von Nachrichten ist in der Regel ein katastrophales Ereignis. Pub/Sub bietet eine mindestens einmalige Zustellung für alle veröffentlichten Nachrichten. Die korrekte Verarbeitung dieser Nachrichten hängt jedoch vom Verhalten des Abonnenten ab. Wenn Nachrichten erfolgreich bestätigt wurden, werden sie von Pub/Sub nicht noch einmal zugestellt. Daher kann ein Fehler im neuen Abonnentencode, den Sie bereitstellen und der Nachrichten bestätigt, ohne sie korrekt verarbeitet zu haben, zu einem vom Abonnenten verursachten Nachrichtenverlust führen. Pub/Sub bietet die Funktion Snapshot und Seek, mit der Sie dafür sorgen können, dass jede Nachricht korrekt verarbeitet wird, auch wenn Abonnentenfehler auftreten.
Das Muster für jede Abonnentenbereitstellung muss so aussehen:
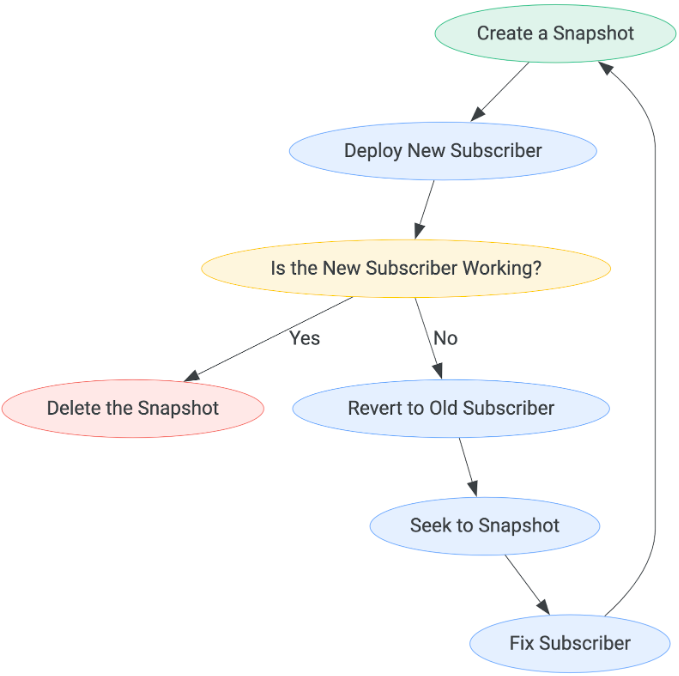
Wie lange Sie warten sollten, bevor Sie feststellen, ob der neue Abonnent funktioniert, kann je nach Anwendungsfall variieren. Die einzige Möglichkeit, den Ablauf der Schritte zu verlassen, besteht darin, dass ein Abonnent als funktionierend gilt. In diesem Fall kann der Snapshot gelöscht werden.
Die Verwendung von Snapshots und Suchvorgängen ist nicht als Ersatz für Best Practices gedacht, bei denen Software zuerst in einer Nicht-Produktionsumgebung ausgeführt und dann schrittweise in der Produktion bereitgestellt wird. Sie bieten eine zusätzliche Schutzebene, um die zuverlässige Verarbeitung von Daten zu gewährleisten. Der Nachteil ist, dass das Suchen nach dem Snapshot dazu führen kann, dass Nachrichten, die Ihr Abonnent erfolgreich verarbeitet hat, doppelt zugestellt werden. Da Pub/Sub jedoch standardmäßig die Semantik „Mindestens einmal“ verwendet, sind Ihre Abonnenten bereits gegen die erneute Zustellung von Nachrichten geschützt.