


Nesta página, explicamos como a arquitetura do Memorystore para Valkey oferece e oferece suporte à alta disponibilidade (HA). Nesta página, também explicamos como melhorar o desempenho e a estabilidade da instância com as configurações de alta disponibilidade que recomendamos.
Alta disponibilidade
O Memorystore for Valkey é baseado em uma arquitetura de alta disponibilidade em que os clientes acessam diretamente os nós gerenciados do Memorystore for Valkey. Para isso, os clientes se conectam a endpoints individuais, conforme descrito em Conectar-se a uma instância do Memorystore for Valkey.
A conexão direta com os fragmentos oferece os seguintes benefícios:
A conexão direta evita saltos intermediários, o que minimiza o tempo de retorno (latência do cliente) entre o cliente e o nó do Memorystore para Valkey.
No modo de cluster ativado, a conexão direta evita qualquer ponto único de falha, porque cada fragmento é projetado para falhar de forma independente. Por exemplo, se o tráfego de vários clientes sobrecarregar um slot (parte do keyspace), a falha do fragmento vai limitar o impacto ao fragmento responsável por exibir o slot.
Configurações recomendadas
Recomendamos que você crie instâncias multizona de alta disponibilidade em vez de instâncias de zona única, porque elas oferecem maior confiabilidade. No entanto, se você optar por provisionar uma instância sem réplicas, recomendamos que escolha uma instância de zona única. Para mais informações, consulte Quando usar uma instância de zona única.
Para ativar a alta disponibilidade na instância, provisione pelo menos uma réplica para cada fragmento. É possível fazer isso ao criar a instância ou escalonar a contagem de réplicas para pelo menos uma réplica por fragmento. As réplicas fornecem failover automático durante a manutenção planejada e falhas inesperadas de fragmentos.
Recomendamos que você configure o cliente de acordo com as orientações em Práticas recomendadas para clientes. O uso das práticas recomendadas permite que o cliente processe os seguintes itens para sua instância de maneira automática e sem inatividade:
- O papel (failovers automáticos)
- O endpoint (substituição de nó)
- Mudanças na atribuição de slots relacionadas ao modo de cluster ativado (escalonar horizontalmente e vertical do consumidor)
Réplicas
Uma instância do Memorystore para Valkey altamente disponível é um recurso regional. O Memorystore for Valkey distribui as VMs primárias e de réplica de fragmentos em várias zonas para proteger contra uma interrupção zonal. O Memorystore for Valkey oferece suporte a instâncias com 0 a 5 réplicas por fragmento.
É possível usar réplicas para aumentar a capacidade de leitura, mas isso pode resultar em dados desatualizados.
- Modo de cluster ativado:use o comando
READONLYpara estabelecer uma conexão que permita ao cliente ler as réplicas. - Modo de cluster desativado:conecte-se ao endpoint de leitura para se conectar a qualquer uma das réplicas disponíveis.
Exemplos de instâncias com o modo de cluster ativado
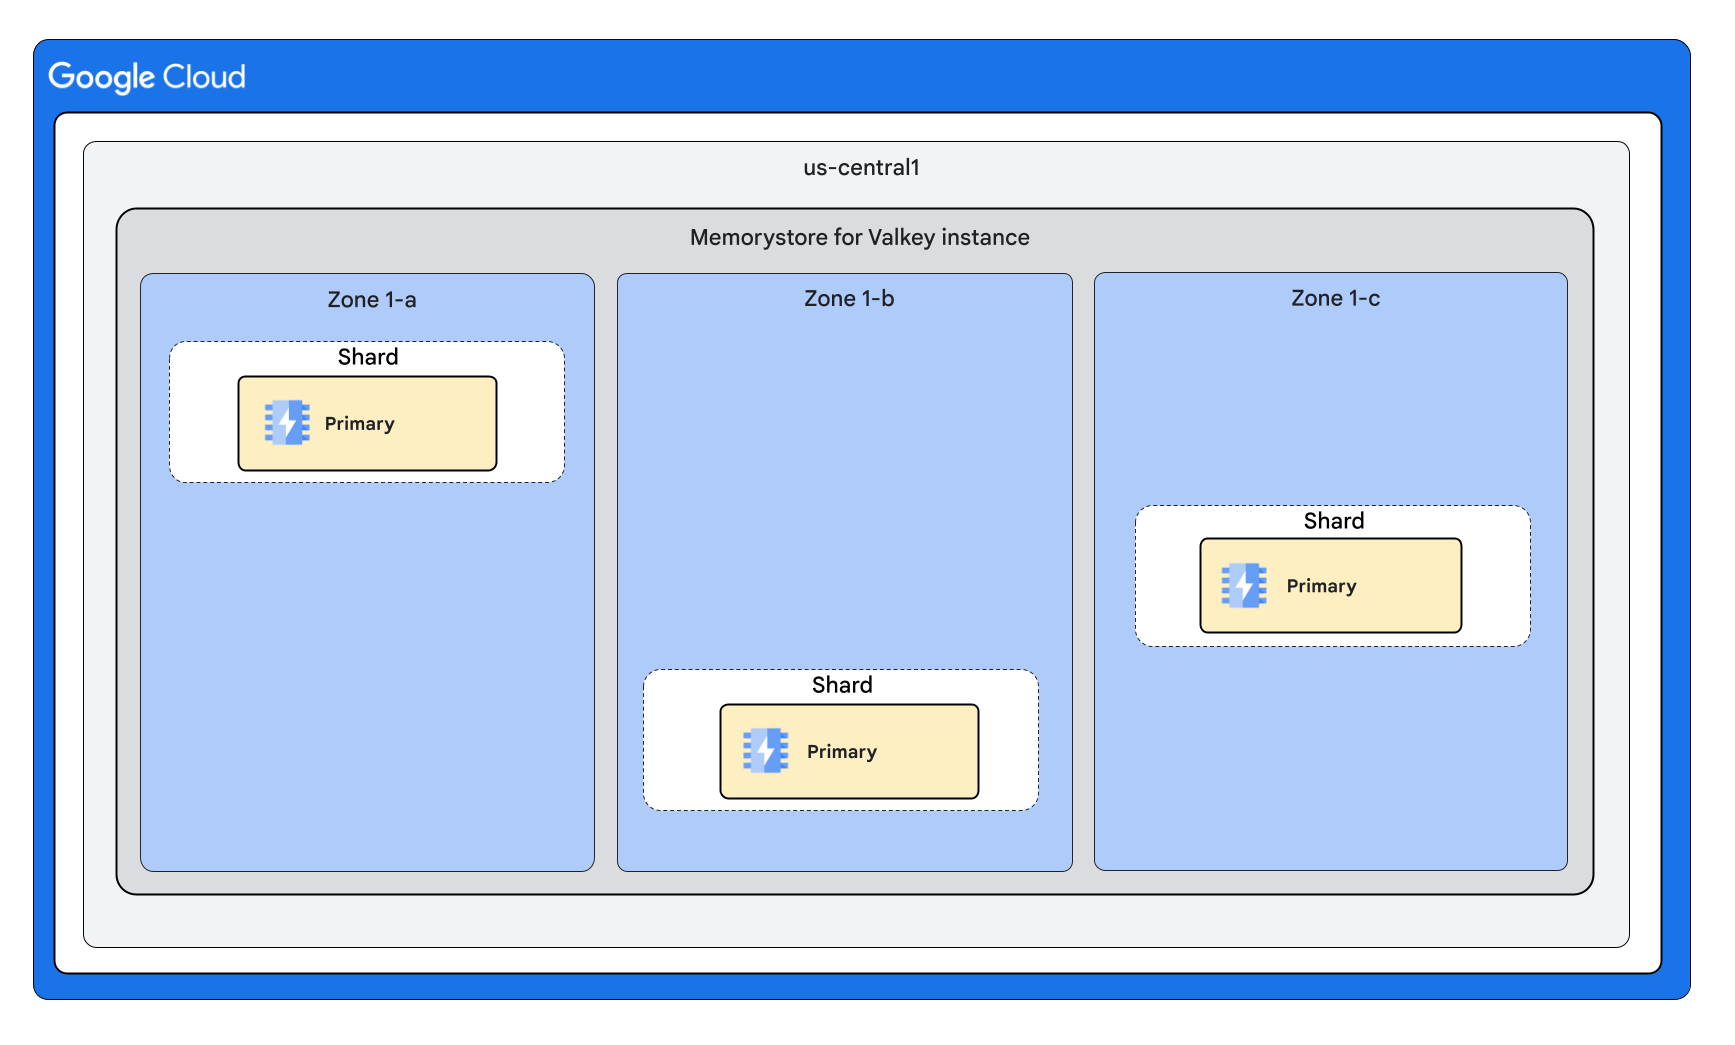
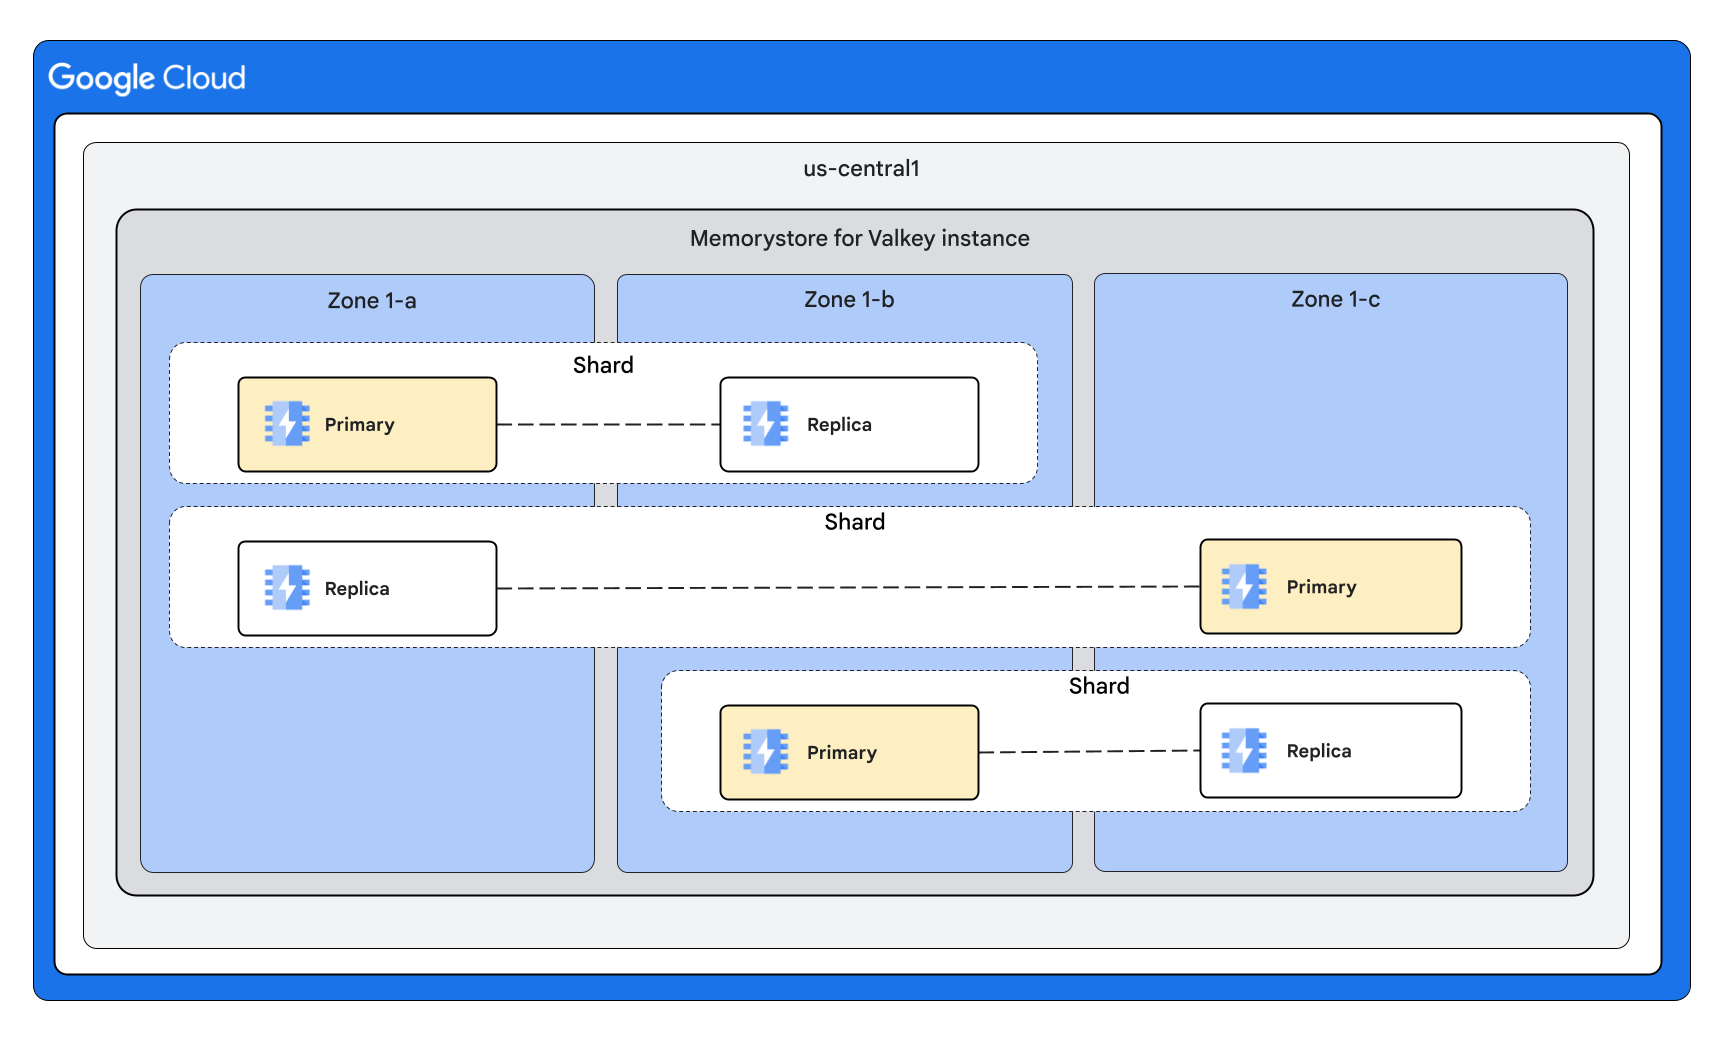
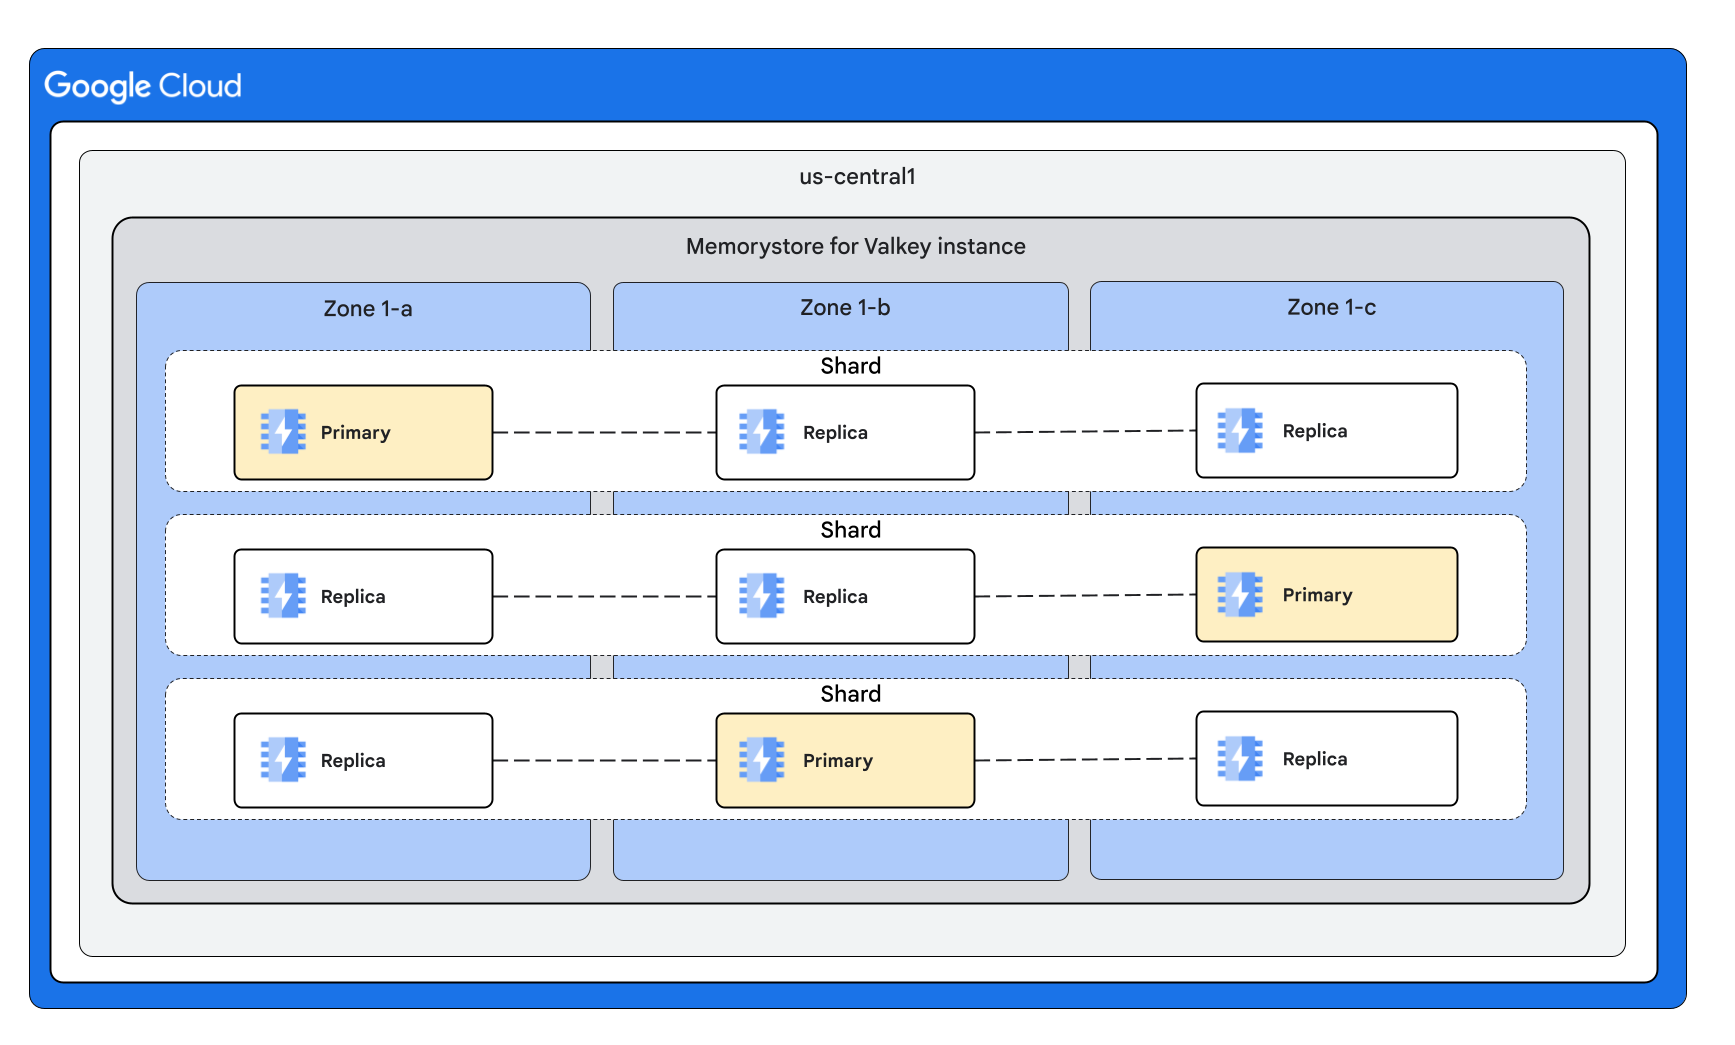
Os diagramas a seguir ilustram exemplos de instâncias com o modo de cluster ativado:
Exemplo de instância com três fragmentos e zero réplicas por fragmento
Exemplo de instância com três fragmentos e uma réplica por fragmento
Exemplo de instância com três fragmentos e várias réplicas por fragmento
Exemplos de instâncias com o modo de cluster desativado
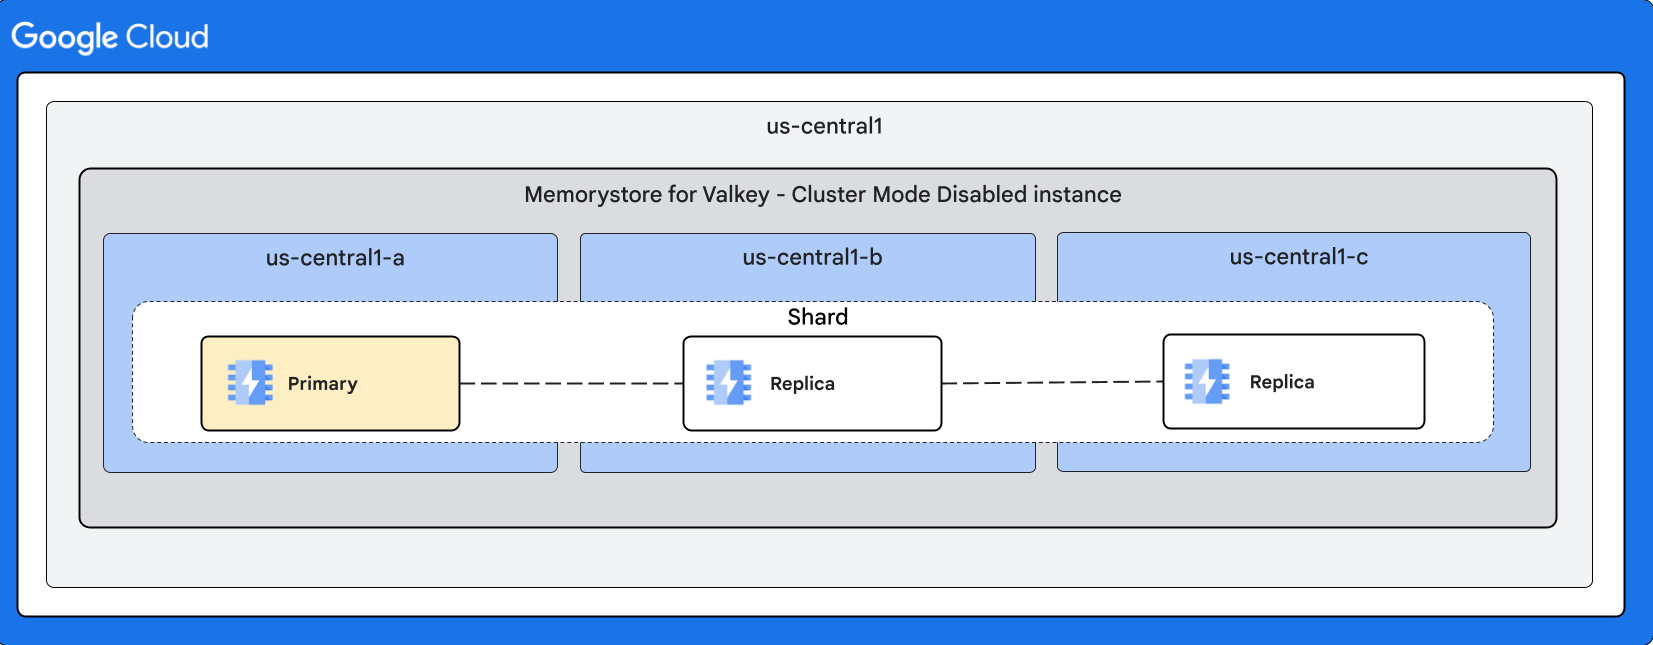
O diagrama a seguir ilustra um exemplo de instâncias com o modo de cluster desativado:
Exemplo de instância com várias réplicas
Como um failover afeta seu aplicativo
Quando o Memorystore for Valkey promove uma réplica para a instância principal, ele encerra as conexões atuais com o endpoint principal da instância. Durante reparos automatizados e eventos de manutenção, a instância fica indisponível por uma média de 30 segundos.
Depois que a instância fica disponível, o Memorystore for Valkey usa a mesma string de conexão ou endereço IP para redirecionar automaticamente o aplicativo para a nova instância principal. Não é necessário atualizar o aplicativo.
Durante um failover, se houver conexões com o endpoint de leitura, o Memorystore for Valkey vai encerrar as conexões com a réplica que ele promove para a instância principal. No entanto, o Memorystore for Valkey não descarta as conexões com as outras réplicas. Depois que o failover é concluído e a nova réplica está disponível, o Memorystore for Valkey redireciona as conexões para a nova réplica.
Failover automático
Os failovers automáticos em um fragmento podem ocorrer devido à manutenção ou a uma falha inesperada do nó principal. Durante um failover, uma réplica é promovida para ser a principal. É possível configurar réplicas explicitamente. O serviço também pode provisionar temporariamente réplicas extras durante a manutenção interna para evitar inatividade.
Os failovers automáticos evitam a perda de dados durante as atualizações de manutenção. Para mais informações sobre o comportamento de failover automático durante a manutenção, consulte Comportamento de failover automático durante a manutenção.
Duração do failover e do reparo de nós
Os failovers automáticos podem levar dezenas de segundos para eventos não planejados, como uma falha no processo do nó principal ou uma falha de hardware. Durante esse período, o sistema detecta a falha e escolhe uma réplica para ser a nova primária.
O reparo de nós pode levar alguns minutos para que o serviço substitua o nó com falha. Isso é válido para todos os nós primários e de réplica. Para instâncias que não são de alta disponibilidade (sem réplicas provisionadas), o reparo de um nó principal com falha também leva alguns minutos.
Comportamento do cliente durante um failover não planejado
As conexões do cliente provavelmente serão redefinidas, dependendo da natureza da falha. Após a recuperação automática, tente novamente as conexões com espera exponencial para evitar sobrecarregar os nós primários e de réplica.
Os clientes que usam réplicas para capacidade de leitura podem ter uma degradação temporária na capacidade até que o nó com falha seja substituído automaticamente.
Gravações perdidas
Durante um failover resultante de uma falha inesperada, as gravações confirmadas podem ser perdidas devido à natureza assíncrona do protocolo de replicação do Valkey.
Os aplicativos cliente podem usar o comando WAIT do Valkey para melhorar a segurança dos dados no mundo real.
Impacto de uma falha temporária de zona única no keyspace
Nesta seção, descrevemos o impacto de uma interrupção de zona única em uma instância do Memorystore for Valkey.
Instâncias de várias zonas
Instâncias de alta disponibilidade:se uma zona tiver uma interrupção, todo o keyspace estará disponível para leituras e gravações, mas como algumas réplicas de leitura estão indisponíveis, a capacidade de leitura será reduzida. Recomendamos provisionar em excesso a capacidade do cluster para que a instância tenha capacidade de leitura suficiente, no caso raro de uma interrupção em uma única zona. Quando a falha temporária terminar, as réplicas na zona afetada serão restauradas e a capacidade de leitura do cluster retornará ao valor configurado. Para mais informações, consulte Padrões para aplicativos escalonáveis e confiáveis.
Instâncias sem alta disponibilidade (sem réplicas): se uma zona tiver uma interrupção, a parte do keyspace provisionada na zona afetada vai passar por uma limpeza de dados e ficará indisponível para gravações ou leituras durante a interrupção. Quando a interrupção terminar, as primárias na zona afetada serão restauradas e a capacidade do cluster retornará ao valor configurado.
Instâncias de zona única
- Instâncias de alta disponibilidade e não alta disponibilidade:se a zona em que a instância está provisionada tiver uma interrupção, o cluster ficará indisponível e os dados serão limpos. Se uma zona diferente tiver uma interrupção, o cluster continuará atendendo às solicitações de leitura e gravação.
Práticas recomendadas
Nesta seção, descrevemos as práticas recomendadas para alta disponibilidade e réplicas.
Adicionar uma réplica
Para adicionar uma réplica, é necessário um snapshot do RDB. Os snapshots do RDB usam uma bifurcação de processo e um mecanismo de cópia em gravação para criar um snapshot dos dados do nó. Dependendo do padrão de gravações nos nós, a memória usada deles aumenta à medida que as páginas afetadas pelas gravações são copiadas. O consumo de memória pode ser até o dobro do tamanho dos dados no nó.
Para garantir que os nós tenham memória suficiente para concluir o snapshot, mantenha ou
defina maxmemory como 80% da
capacidade do nó para que 20% seja reservado para sobrecarga. Essa sobrecarga de memória, além de monitorar snapshots, ajuda a gerenciar sua carga de trabalho para ter snapshots bem-sucedidos. Além disso, ao adicionar réplicas, reduza o tráfego de gravação o máximo
possível. Para mais informações, consulte Monitorar o uso da memória de uma instância.