


Los clientes pueden conectarse a un clúster de Managed Service para Apache Kafka desde cualquier red de nube privada virtual (VPC) en tus proyectos deGoogle Cloud . También puedes activar el acceso desde rangos de IP de confianza a través de la Internet pública.
En esta página, se explica cómo se configuran las redes en Managed Service para Apache Kafka y cómo habilitar las conexiones entre los clientes de Kafka y tu clúster.
Subredes conectadas
Cuando creas un clúster de Managed Service para Apache Kafka, especificas al menos una subred de VPC para conectarte al clúster. Más adelante, puedes actualizar el clúster para agregar o quitar subredes. Puedes conectar varias subredes a un clúster, pero, como máximo, una subred por red de VPC. Las aplicaciones cliente pueden conectarse al clúster desde cualquier subred que comparta la red de VPC de una subred conectada, en cualquier región.
Cuando el servicio aprovisiona un clúster, coloca los agentes del clúster y los extremos de red en una red de VPC independiente dentro de un proyecto administrado por Google. Este proyecto se llama proyecto de usuario, y la red se llama red de usuario. Cada clúster de Managed Service para Apache Kafka tiene su propia red de usuario aislado. No es necesario que administres ni configures la red de usuario.
El recurso Google Cloud que representa el clúster reside en tu propio proyecto deGoogle Cloud . Por ejemplo, cuando ejecutas comandos de Google Cloud CLI, especificas tu proyecto de Google Cloud , no el proyecto de usuario. Del mismo modo, cuando conectas una subred a un clúster, la subred reside en tu proyecto deGoogle Cloud .
En las secciones que siguen, proyecto se refiere a tu propio proyecto de Google Cloud , a menos que se especifique el proyecto de usuario administrado por Google.
Entradas de DNS del clúster
Cuando conectas una subred a un clúster, el servicio crea entradas de DNS en la red de la subred para la dirección de arranque y los agentes del clúster. Los clientes de Kafka usan la dirección de arranque para ubicar los agentes y establecer una conexión. Cuando el servidor de arranque redirecciona un cliente a un agente en particular, usa la URL del agente en lugar de una dirección IP.
Los nombres de DNS de un clúster son los mismos en todas las subredes conectadas del clúster, aunque corresponden a diferentes direcciones IP en cada subred. Debido a que los nombres de DNS son coherentes, todas tus aplicaciones cliente de Kafka usan la misma dirección de arranque.
Las URLs de arranque y de agente son fijas durante el ciclo de vida de un clúster. Para obtener la dirección de arranque de un clúster, consulta Visualiza la dirección de arranque de un clúster. El formato de las URLs puede ser diferente para los distintos clústeres.
Tamaño de la subred
Cuando agregas una subred a un clúster, la subred debe tener suficientes direcciones IP. Cada subred requiere una dirección IP para cada agente de Kafka, además de una dirección IP para la dirección de arranque.
La cantidad inicial de agentes se calcula de la siguiente manera:
number of brokers = max(3, ceiling(vCPUs / 15))
Por ejemplo, un clúster con 60 CPU virtuales tiene cuatro agentes (60/15) y, por lo tanto, necesita al menos cinco direcciones IP utilizables, incluida la dirección de arranque. A medida que escalas verticalmente un clúster, el servicio agrega más agentes. Cuando planifiques el tamaño de la subred, basa tus cálculos en el tamaño máximo al que esperas escalar tu clúster. Google podría cambiar la proporción de agentes por CPU virtuales, por lo que recomendamos asignar 3 veces la cantidad mínima calculada de direcciones IP. Para obtener más información, consulta Planifica el tamaño de tu clúster de Managed Service para Apache Kafka.
Si planeas usar Kafka Connect, también considera los requisitos de subred para el clúster de Connect. Para obtener más información, consulta Subred de trabajador (principal).
Rangos de IP públicas de uso privado
Puedes conectar tu clúster a subredes que usen rangos de direcciones IP públicas de uso privado sin configuración adicional. Las subredes deben usar un rango de IPv4 válido que no sea un rango de subred IPv4 prohibido.
Clústeres de Connect en varios proyectos
Para permitir que los clientes de Kafka de un proyecto de Google Cloud distinto se conecten a tu clúster a través de una IP privada, puedes usar uno de los siguientes métodos:
- Conecta una subred del proyecto del cliente de Kafka al clúster.
- Usa una VPC compartida para conectar los proyectos.
En las siguientes secciones, se describen estas opciones.
Conecta subredes entre proyectos
Para conectar una subred de un proyecto diferente a tu clúster, el agente de servicio de Kafka administrado asociado con tu clúster necesita permiso para acceder a los recursos de red en el proyecto de esa subred. Otorga al agente de servicio el rol de IAM de agente de servicio de Kafka administrado en el proyecto que contiene la subred. Este rol permite que el clúster cree los recursos de red y las entradas de DNS necesarios.
Por ejemplo, si creas un clúster en project-1 y quieres conectar una subred
en project-2, otorga al agente de servicio de Kafka administrado para project-1 el
rol de agente de servicio de Kafka administrado en project-2. Luego, conecta una subred de
project-2 al clúster, como se describe en
Conecta subredes al clúster.
Para otorgar los roles necesarios, sigue estos pasos:
Console
En la consola de Google Cloud , ve a la página IAM del proyecto que contiene la subred.
Haz clic en Otorgar acceso.
En el campo Principales nuevas, ingresa lo siguiente:
service-CLUSTER_PROJECT_NUMBER@gcp-sa-managedkafka.iam.gserviceaccount.comReemplaza
CLUSTER_PROJECT_NUMBERpor el número de proyecto del proyecto que contiene el clúster de Managed Service para Apache Kafka.Haz clic en Agregar roles.
En el campo Buscar roles, ingresa
Managed Kafka Service Agent.En los resultados de la búsqueda, selecciona Agente de servicio de Kafka administrado.
Haz clic en Aplicar.
Haz clic en Guardar.
gcloud
Para otorgar el rol de IAM, usa el comando
gcloud projects add-iam-policy-binding:
gcloud projects add-iam-policy-binding CLIENT_PROJECT_ID \
  --member=serviceAccount:service-CLUSTER_PROJECT_NUMBER@gcp-sa-managedkafka.iam.gserviceaccount.com \
  --role=roles/managedkafka.serviceAgent
Reemplaza lo siguiente:
- CLIENT_PROJECT_ID: el nombre del proyecto que contiene la subred que se conectará
- CLUSTER_PROJECT_NUMBER: Es el número de proyecto del proyecto que contiene el clúster de Managed Service para Apache Kafka.
Usa la VPC compartida para conectar proyectos
La VPC compartida permite que una organización conecte recursos de varios proyectos a una red de VPC común. Para usar la VPC compartida con Managed Service para Apache Kafka, sigue estos pasos:
Crea un clúster de Managed Service para Apache Kafka.
Otorga al agente de servicio de Kafka administrado el rol de agente de servicio de Kafka administrado en el proyecto host de la VPC compartida, como se describe en la sección anterior.
Conecta el clúster a una subred en la red de VPC compartida.
Los clientes del proyecto host de la VPC compartida o de los proyectos de servicio pueden conectarse al clúster.
Para obtener información sobre cuándo usar la VPC compartida, consulta Prácticas recomendadas y arquitecturas de referencia para el diseño de VPC.
Conecta clientes a través de la Internet pública
Si tienes aplicaciones cliente fuera de tu red de VPC, puedes habilitar el acceso público a tu clúster. Un clúster público aún requiere una subred conectada. Sin embargo, no es necesario que envíes tráfico a través de ella.
Cuando habilitas la función de clúster público, el servicio aprovisiona direcciones IPv4 externas para los extremos de agente y de arranque del clúster. El servicio también hace que las entradas de DNS del clúster se resuelvan de forma pública en estas direcciones IP públicas. Los clientes externos pueden usar la dirección de arranque del clúster para ubicar los agentes y establecer una conexión.
En esta implementación, se usa el DNS de horizonte dividido. Los clientes de las redes de VPC que contienen una subred conectada siguen resolviendo los extremos privados, mientras que los clientes de otras redes resuelven los extremos públicos. Habilitar la función de clúster público no crea ningún recurso adicional en tu proyecto.
Managed Service para Apache Kafka usa Cloud Next Generation Firewall para restringir el acceso a clústeres públicos. Cuando habilitas la función de clúster público, debes especificar uno o más rangos de IP de origen permitidos. Para obtener más información, consulta Clústeres públicos.
Puedes actualizar un clúster para agregar o quitar rangos de IP de origen permitidos. Si quitas los rangos de IP de origen permitidos, el cambio solo se aplicará a las conexiones nuevas.
El servicio toma varias precauciones para garantizar la seguridad de tus clústeres públicos. Todas las conexiones se encriptan en tránsito con TLS y todas requieren autenticación. Debes autenticarte con una identidad de IAM con SASL o un certificado de cliente con mTLS. No se permite el acceso anónimo. Para obtener más información, consulta Tipos de autenticación para agentes de Kafka.
Los administradores de seguridad pueden prohibir los clústeres públicos habilitando la
restricción de la política de la organización administrada
Restringir los clústeres públicos de Kafka administrados (constraints/managedkafka.managed.restrictPublicClusters). Para obtener más información sobre las restricciones administradas,
consulta Restricciones administradas.
Configura firewalls de salida desde redes externas
En algunas situaciones, es posible que debas determinar las direcciones IPv4 externas de tus extremos de agente y de arranque. Para ver estas direcciones, consulta Detalles del clúster público.
El servicio también mantiene uno o más registros DNS de descubrimiento. Estos son registros DNS A
que contienen todas las direcciones IPv4 externas asociadas con tu
clúster. Puedes usar estos registros en firewalls basados en FQDN, como
Cloud NGFW, que actualizan
las reglas automáticamente cuando cambia la lista de extremos. Para obtener más información, consulta
Asigna objetos FQDN a direcciones IP.
Ten en cuenta lo siguiente cuando uses las direcciones IP públicas asociadas con tu clúster:
La lista de direcciones IPv4 públicas puede cambiar o crecer. Por este motivo, automatiza la forma en que consumes esta información o define un proceso para tener en cuenta los nuevos registros DNS de descubrimiento cuando escales verticalmente tu clúster. Los cambios pueden ocurrir en los siguientes casos:
Escalas verticalmente tu clúster. El escalamiento vertical puede agregar una o más direcciones IPv4 externas a medida que se agregan agentes nuevos. Para obtener más información, consulta Escala el clúster.
Desactivas y, luego, activas la función de clúster público. Esta acción asigna un nuevo conjunto de direcciones IPv4 externas al clúster.
Cada registro DNS de descubrimiento contiene un máximo de 30 direcciones IP, un valor que está dentro de los límites comunes que aplican los firewalls de FQDN. Los clústeres con 29 agentes o menos tienen un registro DNS de descubrimiento que incluye el registro de la dirección de arranque. El servicio agrega un registro DNS de descubrimiento por cada 30 agentes adicionales.
Los registros DNS de descubrimiento solo están destinados a configurar firewalls de salida basados en FQDN. No configures tus clientes de Kafka para que se conecten a los registros DNS de descubrimiento; en su lugar, configúralos para que se conecten a la dirección de arranque.
Si usas esta información para configurar firewalls de salida, permite la conectividad a los puertos TCP
9092(SASL) y9192(mTLS).
Arquitectura de red de un clúster
En esta sección, se describen los detalles de la arquitectura de red que se usa en Managed Service para Apache Kafka.
Un clúster de Kafka abarca una red de usuario y una o más redes de consumidor.
En la red de usuario, el clúster tiene una sola dirección IP y una URL de arranque. Esta dirección de arranque corresponde a un balanceador de cargas conectado a todos los agentes del clúster. Cada agente de forma individual también puede actuar como un servidor de arranque, pero te recomendamos que uses la dirección de arranque para obtener confiabilidad.
Dentro de cada red de consumidor, el servicio crea un extremo de Private Service Connect para la dirección de arranque y un extremo para cada agente.
La URL de la dirección de arranque es la misma en todas las redes de VPC a las que está conectado un clúster. La dirección IP es local para la red del consumidor.
Los clientes se conectan a los agentes de Kafka con nombres de DNS. Estos nombres se registran automáticamente en cada red de VPC a la que se conecta un clúster de Kafka. La dirección de arranque y su número de puerto están disponibles como una propiedad del clúster.
Los clientes usan la dirección de arranque para recuperar las URLs de los agentes. Estas URLs se resuelven en direcciones IP locales para cada red de VPC. Puedes encontrar las direcciones IP y las URLs reales del agente en Cloud DNS.
En el siguiente diagrama, se muestra una arquitectura de ejemplo de una red de clústeres de Managed Service para Apache Kafka.
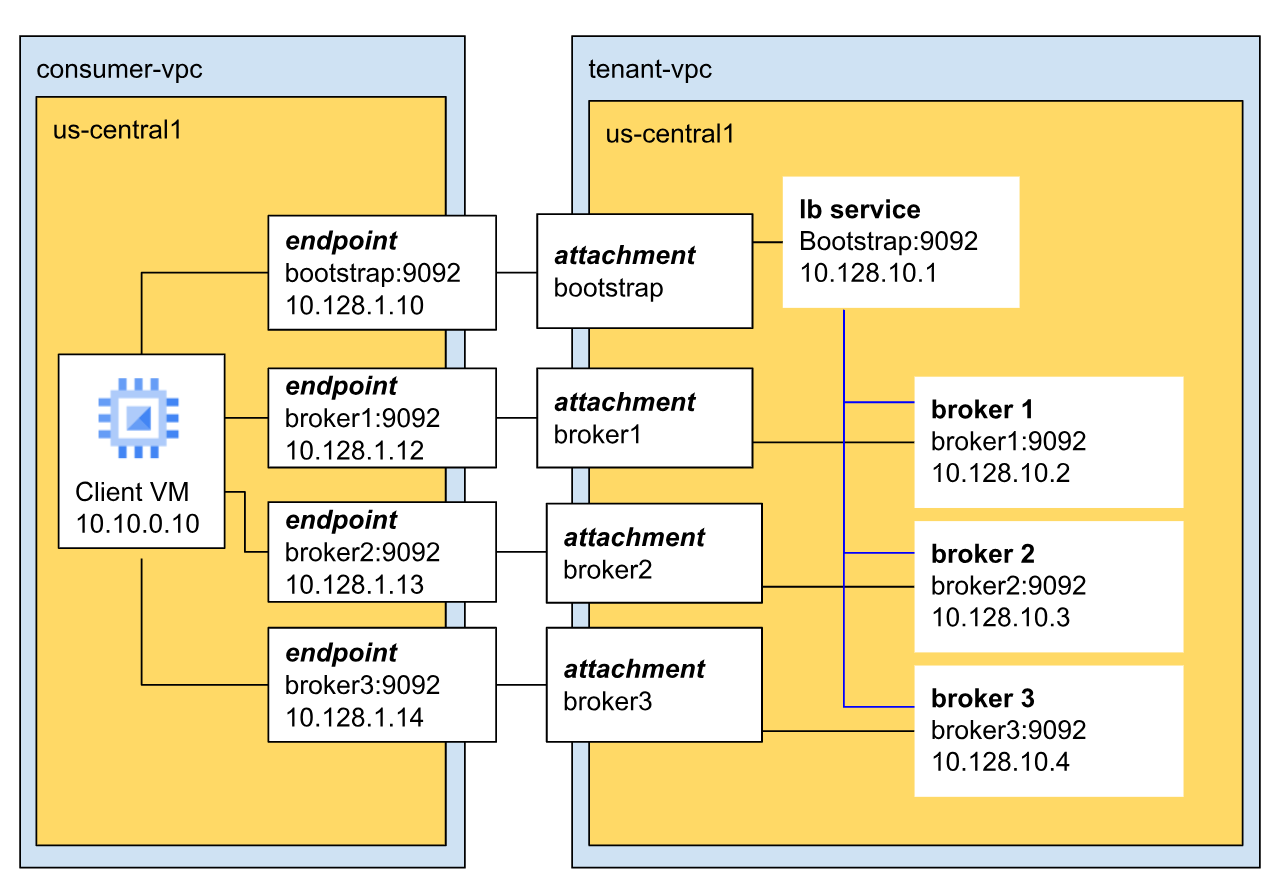 *
En este ejemplo, el clúster tiene tres agentes y se encuentra en la VPC del
usuario.
Los agentes se comunican con los clientes a través del puerto predeterminado de Kafka (9092) y tienen direcciones IP únicas. En este ejemplo, los tres agentes tienen las direcciones IP 10.128.10.2, 10.128.10.3 y 10.128.10.4, respectivamente.
Los tres agentes se conectan al balanceador de cargas de arranque. Esto garantiza una alta disponibilidad y tolerancia a errores regionales, ya que la dirección de arranque no se limita a un solo agente o zona.
Limitaciones
Se aplican las siguientes limitaciones a las conexiones de VPC y los clústeres públicos:
Región de la subred. Las subredes conectadas deben estar en la misma región que tu clúster.
Recuento de subredes. Puedes conectar un mínimo de una y un máximo de diez subredes a un clúster.
Subredes por red. Puedes conectar como máximo una subred por red de VPC a un clúster.
Tamaño de la subred. Cada subred conectada requiere al menos una dirección IP para cada agente, además de una dirección IP para la dirección de arranque. Se requiere un mínimo de cuatro direcciones IP utilizables. Para obtener más información, consulta Tamaño de las subredes.
Subredes conectadas para clústeres públicos. Para activar el acceso público, tu clúster debe tener al menos una subred conectada, aunque no es necesario que envíes tráfico a través de ella.
Rangos de IP de origen permitidos. Cada rango de IP de origen permitido para un clúster público debe especificarse en la notación CIDR de IPv4. Cada tamaño de subred CIDR debe estar entre
/16y/32. Los rangos CIDR no deben superponerse. No se admiten las direcciones IPv6. Puedes especificar un máximo de 500 rangos de IP de origen permitidos.Resolución de DNS del registro de descubrimiento. Los registros DNS de descubrimiento solo están diseñados para configurar firewalls de salida basados en FQDN. No configures tus clientes de Kafka para que se conecten a estos registros de descubrimiento. En su lugar, configúralos para que se conecten a la dirección de arranque.
Solucionar problemas
Para obtener información sobre cómo solucionar problemas de herramientas de redes, consulta Errores de herramientas de redes.
Próximos pasos
Para obtener más información sobre cómo crear un clúster, consulta Crea un clúster de Managed Service para Apache Kafka.
Para obtener más información sobre cómo actualizar un clúster, consulta Actualiza un clúster de Managed Service para Apache Kafka.
Para obtener más información sobre cómo ver las subredes y los agentes activos de un clúster, consulta Visualiza un clúster.
Para obtener más información sobre cómo publicar y consumir mensajes, consulta Publica y consume mensajes.