


클라이언트는 Google Cloud 프로젝트의 모든 가상 프라이빗 클라우드 (VPC) 네트워크에서 Google Cloud Managed Service for Apache Kafka 클러스터에 연결할 수 있습니다. 공개 인터넷을 통해 신뢰할 수 있는 IP 범위에서 액세스를 사용 설정할 수도 있습니다.
이 페이지에서는 Managed Service for Apache Kafka에서 네트워킹이 구성되는 방식, Kafka 클라이언트와 클러스터 간 연결을 설정하는 방법, 여러 프로젝트에서 클라이언트와 클러스터를 비공개로 연결하는 방법을 설명합니다.
VPC 네트워크는 Google Cloud내에서 구현되는 물리적 네트워크의 가상 버전입니다. VM 인스턴스, 컨테이너 워크로드, 기타 리소스에 안전한 비공개 네트워크 연결을 제공합니다. 자세한 내용은 VPC 네트워크 개요를 참고하세요.
개요
클러스터를 만들면 서비스에서 클러스터 브로커와 네트워크 엔드 포인트를 Google 관리 프로젝트 내의 VPC 네트워크에 배치합니다. 이 프로젝트를 테넌트 프로젝트라고 하고 네트워크를 테넌트 네트워크라고 합니다. 반면 리소스, 클라이언트 애플리케이션, 클라이언트 VPC 네트워크는 소비자 프로젝트라고 하는 자체 프로젝트에 있습니다. 각 Managed Service for Apache Kafka 클러스터에는 자체 격리된 테넌트 네트워크가 있습니다.
VPC 네트워크는 서브네트워크 (서브넷)라는 파티션으로 나뉩니다. 각 서브넷은 클라우드 네트워크의 특정 리전에서 IP 주소 범위를 정의합니다. 클라이언트 애플리케이션이 클러스터와 통신하도록 하려면 VPC 네트워크 내의 서브넷을 테넌트 네트워크에 연결하거나, 원하는 경우 공개 인터넷을 통해 연결하도록 공개 클러스터 액세스를 사용 설정합니다.
다음 다이어그램은 두 개의 Google Cloud 프로젝트 project-1와
project-2를 보여줍니다. Managed Service for Apache Kafka 클러스터는 project-1에 있습니다.
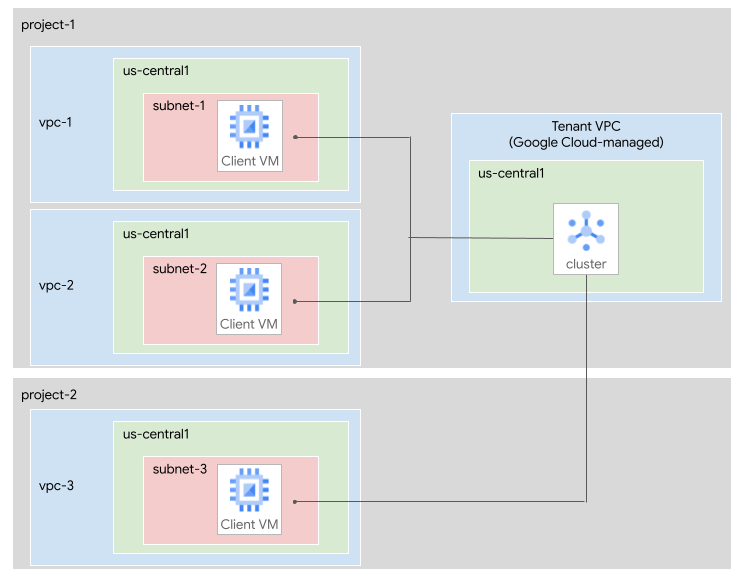
다음 서브넷이 클러스터에 연결되어 있습니다.
project-1의 VPC 네트워크vpc-1에 있는subnet-1project-1의 VPC 네트워크vpc-2에 있는subnet-2project-2의 VPC 네트워크vpc-3에 있는subnet-3
서브넷을 클러스터에 연결
Managed Service for Apache Kafka 클러스터를 처음 만들 때는 하나 이상의 서브넷을 지정해야 합니다. 나중에 클러스터를 업데이트하여 서브넷을 추가하거나 삭제할 수 있습니다.
연결된 서브넷은 클러스터와 동일한 소비자 프로젝트에 속하거나 다른 소비자 프로젝트에 속할 수 있습니다. 연결된 VPC 네트워크 내의 모든 리전에 있는 클라이언트 애플리케이션은 클러스터에 연결할 수 있습니다. 서브넷 위치 및 수에 관한 자세한 내용은 제한사항을 참고하세요.
연결된 서브네트워크를 보는 방법에 대한 자세한 내용은 클러스터 보기를 참고하세요.
클러스터 DNS 항목
서브넷을 클러스터에 연결하면 서비스에서 클러스터의 부트스트랩 주소와 브로커에 대해 해당 서브넷 네트워크 내에 DNS 항목을 만듭니다. Kafka 클라이언트는 부트스트랩 주소를 사용하여 브로커를 찾고 연결을 설정합니다. 부트스트랩 서버가 클라이언트를 특정 브로커로 리디렉션할 때 IP 주소 대신 브로커 URL을 사용합니다.
부트스트랩 및 브로커 URL은 클러스터의 수명 동안 고정되지만 URL 형식은 클러스터마다 다를 수 있습니다. 클러스터의 부트스트랩 주소를 가져오려면 클러스터의 부트스트랩 주소 보기를 참고하세요.
DNS 이름은 연결된 모든 서브넷에서 동일하지만 각 서브넷의 IP 주소는 서로 다릅니다. DNS 이름이 일관되므로 모든 Kafka 클라이언트 애플리케이션에서 동일한 부트스트랩 주소를 사용할 수 있습니다.
Managed Service for Apache Kafka에 연결하는 클라이언트 애플리케이션의 예는 다음 튜토리얼을 참고하세요.
서브넷 크기 조정
클러스터에 서브넷을 추가할 때는 서브넷에 사용 가능한 IP 주소가 충분해야 합니다. 각 서브넷에는 Kafka 브로커당 하나의 IP 주소와 부트스트랩 주소용 하나의 IP 주소가 필요합니다. Managed Service for Apache Kafka의 최소 클러스터 크기는 브로커 3개이므로 각 서브넷에는 부트스트랩 주소를 포함하여 사용 가능한 IP 주소가 4개 이상 필요합니다.
클러스터에 vCPU가 45개를 초과하면 클러스터에 vCPU 15개당 브로커가 하나씩 있습니다. 이 경우 각 서브넷의 최소 IP 주소 수를 다음과 같이 계산합니다.
- vCPU 수를 15로 나눕니다.
- 가장 가까운 정수로 올림합니다.
- 부트스트랩 주소를 고려하여 1을 추가합니다.
예를 들어 vCPU가 60개인 클러스터에는 사용 가능한 IP 주소가 최소 (60/15 + 1) = 5개 필요합니다.
Google은 브로커와 vCPU의 비율을 변경할 수 있습니다. 변경사항을 수용하려면 이전 단계에서 계산된 IP 주소 수의 3배를 할당하는 것이 좋습니다.
서브넷 크기를 계획할 때는 클러스터를 확장할 것으로 예상되는 최대 크기를 기준으로 계산하세요.
Kafka Connect를 사용하려는 경우 Connect 클러스터의 서브넷 요구사항도 고려하세요. 자세한 내용은 작업자 서브넷을 참고하세요.
비공개로 사용되는 공개 IP 범위
RFC 1918 이외의 주소 공간을 사용하는 서브넷에 클러스터를 연결할 수 있습니다. 이러한 IP 주소 범위를 비공개로 사용되는 공개 IP (PUPI) 범위라고 합니다.
PUPI 서브넷에 연결하기 위한 추가 구성은 필요하지 않습니다. PUPI 서브넷은 금지된 IPv4 서브넷 범위가 아닌 유효한 IPv4 범위를 사용해야 합니다.
프로젝트 간에 비공개로 클라이언트와 클러스터 연결
서로 다른 Google Cloud 프로젝트의 Kafka 클라이언트를 클러스터에 비공개로 연결하려면 다음 방법 중 하나를 사용하면 됩니다.
다음 섹션에서는 이러한 옵션을 설명합니다.
프로젝트 간 클러스터 연결
다른 프로젝트의 서브넷을 클러스터에 연결할 수 있습니다. 프로젝트 간 액세스를 사용 설정하려면 클러스터와 연결된 Google 관리 서비스 계정에 권한을 부여해야 합니다. Kafka 클라이언트가 클러스터에 액세스할 프로젝트마다 서비스 계정에 해당 프로젝트의 Managed Kafka Service Agent IAM 역할이 있어야 합니다. 이 역할을 통해 클러스터가Google Cloud 리소스에 액세스하여 네트워크 리소스와 DNS 항목을 만들 수 있습니다.
예를 들어 project-1에 클러스터가 포함되어 있고 project-2의 클라이언트가 클러스터에 액세스하도록 하려면 project-1의 관리형 Kafka 서비스 계정에 project-2에 대한 관리형 Kafka 서비스 에이전트 역할을 부여합니다. 그런 다음 서브넷을 클러스터에 연결에 설명된 대로 project-2의 서브넷을 클러스터에 연결합니다.
필요한 역할을 부여하려면 다음 단계를 따르세요.
콘솔
Kafka 클라이언트가 Google Cloud Managed Service for Apache Kafka 클러스터에 액세스할 프로젝트를 결정합니다.
각 프로젝트의 Google Cloud 콘솔에서 해당 프로젝트의 IAM 페이지로 이동합니다.
액세스 권한 부여를 클릭합니다.
새 주 구성원 필드에 다음을 입력합니다.
service-CLUSTER_PROJECT_NUMBER@gcp-sa-managedkafka.iam.gserviceaccount.comCLUSTER_PROJECT_NUMBER를 Managed Service for Apache Kafka 클러스터가 포함된 프로젝트의 프로젝트 번호로 바꿉니다.
역할 추가를 클릭합니다.
역할 검색 필드에
Managed Kafka Service Agent을 입력합니다. 서비스 에이전트 이름이 검색 결과에 표시됩니다.검색 결과에서 관리형 Kafka 서비스 에이전트를 선택합니다.
적용을 클릭합니다.
저장을 클릭합니다.
gcloud
Kafka 클라이언트가 Google Cloud Managed Service for Apache Kafka 클러스터에 액세스할 프로젝트를 결정합니다.
각 프로젝트에 대해
gcloud projects add-iam-policy-binding명령어를 실행합니다.gcloud projects add-iam-policy-binding CLIENT_PROJECT_ID \ --member=serviceAccount:service-CLUSTER_PROJECT_NUMBER@gcp-sa-managedkafka.iam.gserviceaccount.com \ --role=roles/managedkafka.serviceAgent다음을 바꿉니다.
- CLIENT_PROJECT_ID: 연결할 VPC 네트워크가 포함된 프로젝트의 이름
- CLUSTER_PROJECT_NUMBER: Apache Kafka용 관리형 서비스 클러스터가 포함된 프로젝트의 프로젝트 번호
공유 VPC를 사용하여 프로젝트 연결
공유 VPC를 사용하면 조직에서 여러 프로젝트의 리소스를 공통 VPC 네트워크에 연결할 수 있습니다. Managed Service for Apache Kafka와 함께 공유 VPC를 사용하려면 다음 단계를 실행하세요.
Managed Service for Apache Kafka 클러스터를 만듭니다.
이전 섹션에 설명된 대로 공유 VPC 호스트 프로젝트에서 관리형 Kafka 서비스 계정에 필요한 역할을 부여합니다.
Managed Service for Apache Kafka 클러스터를 공유 VPC 네트워크의 서브넷에 연결합니다.
공유 VPC 호스트 프로젝트 또는 서비스 프로젝트의 클라이언트는 클러스터에 연결할 수 있습니다.
네트워크 아키텍처에서 공유 VPC를 사용해야 하는 경우에 관한 자세한 내용은 VPC 설계에 관한 권장사항 및 참조 아키텍처를 참고하세요.
클라이언트를 공개 클러스터에 연결
VPC 네트워크 외부에 클라이언트 애플리케이션이 있는 경우 클러스터에 대한 공개 액세스를 사용 설정할 수 있습니다. 공개 클러스터에도 연결된 서브넷이 필요합니다. 하지만 이 경로를 통해 트래픽을 전송할 필요는 없습니다.
공개 클러스터 기능을 사용 설정하면 서비스에서 클러스터의 브로커 및 부트스트랩 엔드포인트에 외부 IPv4 주소를 프로비저닝합니다. 또한 서비스는 클러스터 DNS 항목을 이러한 공개 IP 주소로 공개적으로 확인할 수 있도록 합니다. 즉, 외부 클라이언트는 동일한 부트스트랩 주소를 사용하여 브로커를 찾고 연결을 설정할 수 있습니다. 이 구현에서는 분할된 범위의 DNS를 사용합니다. 연결된 서브넷이 포함된 VPC 네트워크의 클라이언트는 계속해서 비공개 엔드포인트를 확인하는 반면 다른 네트워크의 클라이언트는 공개 엔드포인트를 확인합니다. 공개 클러스터 기능을 사용 설정해도 소비자 프로젝트에 추가 리소스가 생성되지 않습니다.
공개 클러스터 기능을 사용 설정할 때는 허용된 소스 IP 범위를 하나 이상 제공해야 합니다. 허용되는 범위 크기 및 제한에 대한 자세한 내용은 공개 클러스터 또는 제한사항을 참고하세요.
클러스터를 업데이트하여 허용된 소스 IP 범위를 추가하거나 삭제할 수 있습니다. Managed Service for Apache Kafka는 Cloud Next Generation Firewall을 사용하여 공개 클러스터에 대한 액세스를 제한합니다. 허용된 소스 IP 범위를 삭제하는 것은 새 연결에만 적용됩니다 (기존 트래픽에 미치는 영향 참고).
이 서비스는 공개 클러스터의 보안을 보장하기 위해 여러 예방 조치를 취합니다. 모든 연결은 TLS를 사용하여 전송 중에 암호화되며 모든 연결에는 인증이 필요합니다. SASL을 사용하는 IAM ID 또는 mTLS를 사용하는 클라이언트 인증서를 사용하여 인증해야 합니다. 익명 액세스는 허용되지 않습니다. 자세한 내용은 Kafka 브로커의 인증 유형을 참고하세요.
보안 관리자는 관리형 Kafka 공개 클러스터 제한 (constraints/managedkafka.managed.restrictPublicClusters) 관리 조직 정책 제약 조건을 사용 설정하여 공개 클러스터를 금지할 수 있습니다. 관리형 제약 조건에 대한 자세한 내용은 관리형 제약 조건을 참고하세요.
외부 네트워크에서 이그레스 방화벽 구성
일부 시나리오에서는 브로커 및 부트스트랩 엔드포인트의 외부 IPv4 주소를 확인해야 할 수 있습니다. 이러한 값을 가져오는 방법은 공개 클러스터 세부정보를 참고하세요.
서비스는 다음과 같은 방식으로 이 정보를 제공합니다.
클러스터와 연결된 외부 IPv4 주소는 Managed Service for Apache Kafka API,
gcloud, Terraform에서 확인할 수 있습니다.서비스는 하나 이상의 검색 DNS 레코드를 유지합니다. 클러스터와 연결된 모든 외부 IPv4 주소를 포함하는 DNS
A레코드입니다. 엔드포인트 목록이 변경될 때 규칙을 자동으로 업데이트하는 Cloud NGFW와 같은 FQDN 기반 방화벽에서 이러한 레코드를 사용할 수 있습니다. 검색 엔드포인트 목록은 API,gcloud, Terraform에서 확인할 수 있습니다.
클러스터와 연결된 공개 IP 주소를 사용할 때는 다음 사항을 고려하세요.
클러스터와 연결된 공개 IPv4 주소 목록은 변경되거나 늘어날 수 있습니다. 따라서 이 정보를 사용하는 방법을 자동화하거나 클러스터를 확장할 때 새로 검색된 DNS 레코드를 고려하는 프로세스를 정의하세요. 다음과 같은 경우 변경이 발생할 수 있습니다.
클러스터를 확장합니다. 새 브로커가 추가되면 확장으로 하나 이상의 외부 IPv4 주소가 추가될 수 있습니다. vCPU 수가 브로커 수에 미치는 영향을 알아보려면 서브넷 크기 조정을 참고하세요.
공개 클러스터 기능을 사용 중지했다가 다시 사용 설정합니다. 이 작업은 클러스터에 새 외부 IPv4 주소 집합을 할당합니다.
각 검색 DNS 레코드에는 최대 30개의 IP 주소가 포함됩니다. 이는 FQDN 방화벽에서 적용하는 일반적인 한도 내에 있습니다. 브로커가 29개 이하인 클러스터에는 부트스트랩 레코드를 포함하여 30개의 외부 IPv4 주소가 포함된 검색 DNS 레코드가 하나 있습니다. 서비스는 30개의 브로커가 추가될 때마다 검색 DNS 레코드를 하나씩 추가합니다. vCPU 수가 브로커 수에 미치는 영향을 알아보려면 서브넷 크기 조정을 참고하세요.
디스커버리 DNS 레코드에 연결하도록 Kafka 클라이언트를 구성하지 마세요. 대신 부트스트랩 주소에 연결하도록 클라이언트를 구성하세요. 자세한 내용은 제한사항을 참고하세요.
이 정보를 사용하여 이그레스 방화벽을 구성하는 경우 TCP 포트
9092(SASL) 및9192(mTLS)에 대한 연결을 허용하세요.
클러스터의 네트워크 아키텍처
이 섹션에서는 Managed Service for Apache Kafka에서 사용되는 네트워킹 아키텍처의 세부정보를 설명합니다.
Kafka 클러스터는 테넌트 네트워크와 하나 이상의 소비자 네트워크에 걸쳐 있습니다.
테넌트 네트워크에서 클러스터에는 단일 부트스트랩 IP 주소와 URL이 있습니다. 이 부트스트랩 주소는 클러스터의 모든 브로커에 연결된 부하 분산기에 해당합니다. 각 브로커는 개별적으로 부트스트랩 서버로 작동할 수도 있지만 안정성을 위해 부트스트랩 주소를 사용하는 것이 좋습니다.
각 소비자 네트워크 내에서 서비스는 부트스트랩 주소의 Private Service Connect 엔드포인트와 각 브로커의 엔드포인트 하나를 만듭니다.
부트스트랩 주소의 URL은 클러스터가 연결된 VPC 네트워크에서 동일합니다. IP 주소는 소비자 네트워크에 로컬입니다.
클라이언트는 DNS 이름을 사용하여 Kafka 브로커에 연결합니다. 이러한 이름은 Kafka 클러스터가 연결된 모든 VPC 네트워크에 자동으로 등록됩니다. 부트스트랩 주소와 포트 번호는 클러스터의 속성으로 사용할 수 있습니다.
클라이언트는 부트스트랩 주소를 사용하여 브로커 URL을 가져옵니다. 이러한 URL은 각 VPC 네트워크의 로컬 IP 주소로 확인됩니다. 실제 브로커 IP 주소와 URL은 Cloud DNS에서 확인할 수 있습니다.
다음 다이어그램은 Managed Service for Apache Kafka 클러스터 네트워크의 샘플 아키텍처를 보여줍니다.
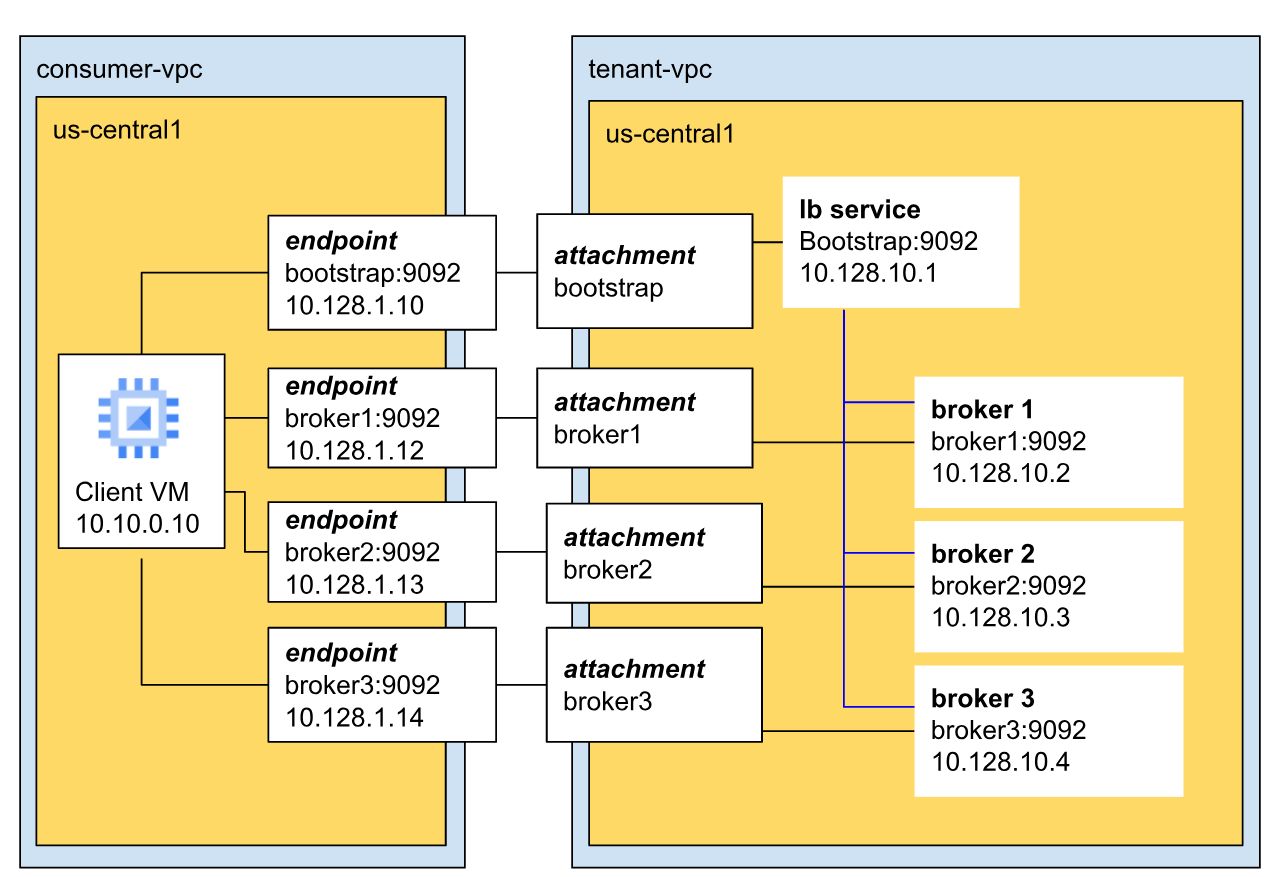 *
이 예시에서 클러스터에는 브로커가 3개 있으며 클러스터는 테넌트 VPC에 있습니다.
브로커는 기본 Kafka 포트 (9092)를 통해 클라이언트와 통신하며 고유한 IP 주소가 있습니다. 이 예에서 세 브로커의 IP 주소는 각각 10.128.10.2, 10.128.10.3, 10.128.10.4입니다.
세 브로커 모두 부트스트랩 부하 분산기에 연결됩니다. 부트스트랩 주소가 단일 브로커나 영역에 국한되지 않으므로 고가용성과 리전 내결함성이 보장됩니다.
제한사항
VPC 연결 및 공개 클러스터에는 다음 제한사항이 적용됩니다.
서브넷 리전 연결된 서브넷은 클러스터와 동일한 리전에 있어야 합니다.
서브넷 수입니다. 클러스터에 최소 1개에서 최대 10개의 서브넷을 연결할 수 있습니다.
네트워크당 서브넷. VPC 네트워크당 최대 하나의 서브넷을 클러스터에 연결할 수 있습니다.
서브넷 크기. 연결된 각 서브넷에는 브로커마다 IP 주소가 하나 이상 필요하며 부트스트랩 주소용 IP 주소가 하나 더 필요합니다. 사용 가능한 IP 주소가 4개 이상 필요합니다. 자세한 내용은 서브넷 크기 조정을 참고하세요.
공개 클러스터의 연결된 서브넷 공개 액세스를 사용 설정하려면 클러스터에 연결된 서브넷이 하나 이상 있어야 합니다. 서브넷을 통해 트래픽을 전송하지 않아도 됩니다.
허용된 소스 IP 범위 공개 클러스터에 허용된 각 소스 IP 범위는 IPv4 CIDR 표기법으로 지정해야 합니다. 각 CIDR 서브넷 크기는
/16~/32사이여야 합니다. CIDR 범위가 겹쳐서는 안 됩니다. IPv6 주소는 지원되지 않습니다. 허용된 소스 IP 범위를 최대 500개까지 지정할 수 있습니다.탐색 레코드 DNS 변환 탐색 DNS 레코드는 FQDN 기반 이그레스 방화벽을 구성하는 데만 사용됩니다. 이러한 탐색 레코드에 연결하도록 Kafka 클라이언트를 구성하지 마세요. 대신 부트스트랩 주소에 연결하도록 클라이언트를 구성하세요.
문제 해결
네트워킹 문제를 해결하는 방법은 네트워킹 오류를 참고하세요.
다음 단계
클러스터를 만드는 방법에 대한 자세한 내용은 Managed Service for Apache Kafka 클러스터 만들기를 참고하세요.
클러스터를 업데이트하는 방법에 대한 자세한 내용은 Managed Service for Apache Kafka 클러스터 업데이트를 참고하세요.
클러스터의 서브네트워크와 활성 브로커를 보는 방법에 대한 자세한 내용은 클러스터 보기를 참고하세요.
메시지를 게시하고 사용하는 방법에 관한 자세한 내용은 메시지 게시 및 사용을 참고하세요.