


Clients können von jedem VPC-Netzwerk (Virtual Private Cloud) in Ihren Google Cloud Projekten aus eine Verbindung zu einem Google Cloud Managed Service for Apache Kafka-Cluster herstellen. Sie können auch den Zugriff über vertrauenswürdige IP-Bereiche über das öffentliche Internet aktivieren.
Auf dieser Seite wird erläutert, wie das Netzwerk in Managed Service for Apache Kafka konfiguriert wird, wie Sie Verbindungen zwischen Kafka-Clients und Ihrem Cluster aktivieren und wie Sie Clients und Cluster in verschiedenen Projekten privat verbinden.
Ein VPC-Netzwerk ist eine virtuelle Version eines physischen Netzwerks, das innerhalb von Google Cloudimplementiert wird. Es bietet eine sichere, private Netzwerkverbindung für Ihre VM-Instanzen, Container-Arbeitslasten und andere Ressourcen. Weitere Informationen finden Sie in der Übersicht zu VPC-Netzwerken.
Übersicht
Wenn Sie einen Cluster erstellen, platziert der Dienst die Clusterbroker und Netzwerkendpunkte in einem VPC-Netzwerk in einem von Google verwalteten Projekt. Dieses Projekt wird als Mandantenprojekt und das Netzwerk als Mandantennetzwerk bezeichnet. Ihre Ressourcen, Clientanwendungen und Client-VPC-Netzwerke befinden sich dagegen in Ihrem eigenen Projekt, dem Nutzerprojekt. Jeder Managed Service for Apache Kafka-Cluster hat sein eigenes isoliertes Mandantennetzwerk.
VPC-Netzwerke sind in Partitionen unterteilt, die als Subnetzwerke (Subnetze) bezeichnet werden. Von jedem Subnetz wird ein Bereich von IP-Adressen in einer bestimmten Region Ihres Cloud-Netzwerks definiert. Damit Clientanwendungen mit dem Cluster kommunizieren können, verbinden Sie Subnetze in Ihren VPC-Netzwerken mit dem Mandantennetzwerk oder aktivieren optional den öffentlichen Clusterzugriff, um eine Verbindung über das öffentliche Internet herzustellen.
Das folgende Diagramm zeigt zwei Google Cloud Projekte, project-1 und project-2. Ein Managed Service for Apache Kafka-Cluster befindet sich in project-1.

Die folgenden Subnetze sind mit dem Cluster verbunden:
subnet-1im VPC-Netzwerkvpc-1inproject-1.subnet-2im VPC-Netzwerkvpc-2inproject-1.subnet-3im VPC-Netzwerkvpc-3inproject-2.
Subnetze mit einem Cluster verbinden
Wenn Sie einen Managed Service for Apache Kafka-Cluster erstellen, müssen Sie mindestens ein Subnetz angeben. Später können Sie den Cluster aktualisieren, um Subnetze hinzuzufügen oder zu entfernen.
Verbundene Subnetze können demselben oder einem anderen Nutzerprojekt wie der Cluster angehören. Clientanwendungen in einer beliebigen Region innerhalb verbundener VPC-Netzwerke können eine Verbindung zum Cluster herstellen. Weitere Informationen zu Subnetzstandorten und ‑anzahlen finden Sie unter Einschränkungen.
Weitere Informationen zum Ansehen verbundener Subnetzwerke finden Sie unter Cluster ansehen.
Cluster-DNS-Einträge
Wenn Sie ein Subnetz mit einem Cluster verbinden, erstellt der Dienst DNS-Einträge innerhalb dieses Subnetzwerks für die Bootstrap-Adresse und die Broker des Clusters. Kafka-Clients verwenden die Bootstrap-Adresse, um die Broker zu finden und eine Verbindung herzustellen. Wenn der Bootstrap-Server einen Client zu einem bestimmten Broker umleitet, verwendet er die Broker-URL anstelle einer IP-Adresse.
Die Bootstrap- und Broker-URLs sind für die Lebensdauer eines Clusters festgelegt, das Format der URLs kann jedoch für verschiedene Cluster unterschiedlich sein. Informationen zum Abrufen der Bootstrap-Adresse eines Clusters finden Sie unter Bootstrap-Adresse eines Clusters ansehen.
Die DNS-Namen sind in allen verbundenen Subnetzen gleich, obwohl sie in jedem Subnetz unterschiedlichen IP-Adressen entsprechen. Da die DNS-Namen konsistent sind, können alle Ihre Kafka-Clientanwendungen dieselbe Bootstrap-Adresse verwenden.
Beispiele für Clientanwendungen, die eine Verbindung zu Managed Service for Apache Kafka herstellen, finden Sie in den folgenden Anleitungen:
Subnetzgröße
Wenn Sie einem Cluster ein Subnetz hinzufügen, muss das Subnetz genügend IP-Adressen haben. Für jedes Subnetz ist eine IP-Adresse für jeden Kafka-Broker sowie eine IP-Adresse für die Bootstrap-Adresse erforderlich. Die Mindestclustergröße für Managed Service for Apache Kafka umfasst drei Broker. Daher benötigt jedes Subnetz mindestens vier nutzbare IP-Adressen, einschließlich der Bootstrap-Adresse.
Wenn Ihr Cluster mehr als 45 vCPUs hat, gibt es einen Broker für jeweils 15 vCPUs. In diesem Fall berechnen Sie die Mindestanzahl der IP-Adressen für jedes Subnetz so:
- Teilen Sie die Anzahl der vCPUs durch 15.
- Runden Sie auf die nächste ganze Zahl auf.
- Addieren Sie 1, um die Bootstrap-Adresse zu berücksichtigen.
Ein Cluster mit 60 vCPUs benötigt beispielsweise mindestens (60/15 + 1) = 5 nutzbare IP-Adressen.
Google kann das Verhältnis von Brokern zu vCPUs ändern. Um Änderungen zu berücksichtigen, empfehlen wir, die dreifache Anzahl der im vorherigen Schritt berechneten IP-Adressen zuzuweisen.
Wenn Sie die Subnetzgröße planen, sollten Sie Ihre Berechnungen auf der maximalen Größe basieren, auf die Sie Ihren Cluster voraussichtlich skalieren werden.
Wenn Sie Kafka Connect verwenden möchten, sollten Sie auch die Subnetzanforderungen für den Connect-Cluster berücksichtigen. Weitere Informationen finden Sie unter Worker-Subnetz.
Privat genutzte öffentliche IP-Bereiche
Sie können Ihren Cluster mit Subnetzen verbinden, die den Adressraum außerhalb von RFC 1918 verwenden. Solche IP-Adressbereiche werden als privat verwendete öffentliche IP-Bereiche (Privately Used Public IP, PUPI) bezeichnet.
Für die Verbindung mit PUPI-Subnetzen ist keine zusätzliche Konfiguration erforderlich. Die PUPI-Subnetze müssen einen gültigen IPv4-Bereich verwenden, der kein unzulässiger IPv4-Subnetzbereich ist.
Clients und Cluster projektübergreifend privat verbinden
Wenn Sie Kafka-Clients in verschiedenen Google CloudProjekten privat mit Ihrem Cluster verbinden möchten, können Sie eine der folgenden Methoden verwenden:
- Cluster mit VPC-Netzwerken in mehreren Projekten verbinden
- Gemeinsam genutzte VPC zum Verbinden von Projekten verwenden
In den folgenden Abschnitten werden diese Optionen beschrieben.
Cluster projektübergreifend verbinden
Sie können Subnetze aus anderen Projekten mit Ihrem Cluster verbinden. Wenn Sie den projektübergreifenden Zugriff aktivieren möchten, müssen Sie dem von Google verwalteten Dienstkonto, das dem Cluster zugeordnet ist, Berechtigungen erteilen. Für jedes Projekt, in dem Kafka-Clients auf den Cluster zugreifen sollen, muss das Dienstkonto die IAM-Rolle Managed Kafka Service Agent für dieses Projekt haben. Mit dieser Rolle kann der Cluster aufGoogle Cloud -Ressourcen zugreifen, um Netzwerkressourcen und DNS-Einträge zu erstellen.
Wenn project-1 beispielsweise den Cluster enthält und Sie möchten, dass Clients in project-2 auf den Cluster zugreifen können, gewähren Sie dem Managed Kafka-Dienstkonto für project-1 die Rolle „Managed Kafka Service Agent“ für project-2. Stellen Sie dann eine Verbindung von einem Subnetz aus project-2 zum Cluster her, wie unter Subnetze mit dem Cluster verbinden beschrieben.
Führen Sie die folgenden Schritte aus, um die erforderlichen Rollen zuzuweisen:
Console
Legen Sie die Google Cloud Projekte fest, in denen Ihre Kafka-Clients auf den Managed Service for Apache Kafka-Cluster zugreifen sollen.
Rufen Sie für jedes Projekt in der Google Cloud Console die Seite IAM für das jeweilige Projekt auf:
Klicken Sie auf Zugriffsrechte erteilen.
Geben Sie im Feld Neue Hauptkonten Folgendes ein:
service-CLUSTER_PROJECT_NUMBER@gcp-sa-managedkafka.iam.gserviceaccount.comErsetzen Sie CLUSTER_PROJECT_NUMBER durch die Projektnummer des Projekts, das den Managed Service for Apache Kafka-Cluster enthält.
Klicken Sie auf Rollen hinzufügen.
Geben Sie im Feld Nach Rollen suchen
Managed Kafka Service Agentein. Der Name des Dienst-Agents wird in den Suchergebnissen angezeigt.Wählen Sie in den Suchergebnissen Managed Kafka Service Agent aus.
Klicken Sie auf Übernehmen.
Klicken Sie auf Speichern.
gcloud
Legen Sie die Google Cloud Projekte fest, in denen Ihre Kafka-Clients auf den Managed Service for Apache Kafka-Cluster zugreifen sollen.
Führen Sie für jedes Projekt den Befehl
gcloud projects add-iam-policy-bindingaus:gcloud projects add-iam-policy-binding CLIENT_PROJECT_ID \ --member=serviceAccount:service-CLUSTER_PROJECT_NUMBER@gcp-sa-managedkafka.iam.gserviceaccount.com \ --role=roles/managedkafka.serviceAgentErsetzen Sie Folgendes:
- CLIENT_PROJECT_ID: der Name des Projekts, das das VPC-Netzwerk enthält, mit dem eine Verbindung hergestellt werden soll
- CLUSTER_PROJECT_NUMBER: die Projektnummer des Projekts, das den Managed Service for Apache Kafka-Cluster enthält
Projekte mit einer gemeinsam genutzten VPC verbinden
Mit einer gemeinsam genutzten VPC kann eine Organisation Ressourcen aus mehreren Projekten mit einem gemeinsamen VPC-Netzwerk verbinden. So verwenden Sie freigegebene VPC mit Managed Service for Apache Kafka:
Erstellen Sie einen Managed Service for Apache Kafka-Cluster.
Weisen Sie dem Managed Kafka-Dienstkonto die erforderlichen Rollen im freigegebene VPC-Hostprojekt zu, wie im vorherigen Abschnitt beschrieben.
Verbinden Sie den Managed Service for Apache Kafka-Cluster mit einem Subnetz im freigegebene VPC-Netzwerk.
Clients im Hostprojekt der freigegebene VPC oder in den Dienstprojekten können eine Verbindung zum Cluster herstellen.
Informationen dazu, wann Sie freigegebene VPC in Ihren Netzwerkarchitekturen verwenden sollten, finden Sie unter Best Practices und Referenzarchitekturen für das VPC-Design.
Clients mit einem öffentlichen Cluster verbinden
Wenn Sie Clientanwendungen außerhalb Ihres VPC-Netzwerk haben, können Sie den öffentlichen Zugriff auf Ihren Cluster aktivieren. Für einen öffentlichen Cluster ist weiterhin ein verbundenes Subnetz erforderlich. Sie müssen jedoch keinen Traffic darüber senden.
Wenn Sie die Funktion für öffentliche Cluster aktivieren, stellt der Dienst externe IPv4-Adressen für die Broker- und Bootstrap-Endpunkte des Clusters bereit. Der Dienst sorgt auch dafür, dass die Cluster-DNS-Einträge öffentlich in diese öffentlichen IP-Adressen aufgelöst werden können. Das bedeutet, dass externe Clients dieselbe Bootstrap-Adresse verwenden können, um die Broker zu finden und eine Verbindung herzustellen. Bei dieser Implementierung wird Split-Horizon-DNS verwendet. Clients in VPC-Netzwerken, die ein verbundenes Subnetz enthalten, lösen weiterhin die privaten Endpunkte auf, während Clients in anderen Netzwerken die öffentlichen Endpunkte auflösen. Wenn Sie das Feature für öffentliche Cluster aktivieren, werden in Ihrem privaten Projekt keine zusätzlichen Ressourcen erstellt.
Wenn Sie die Funktion für öffentliche Cluster aktivieren, müssen Sie einen oder mehrere zulässige Quell-IP-Bereiche angeben. Weitere Informationen zu zulässigen Bereichsgrößen und Limits finden Sie unter Öffentliche Cluster oder Einschränkungen.
Sie können zulässige Quell-IP-Bereiche hinzufügen oder entfernen, indem Sie Ihren Cluster aktualisieren. Managed Service for Apache Kafka verwendet die Cloud Next Generation Firewall, um den Zugriff auf öffentliche Cluster einzuschränken. Das Entfernen zulässiger Quell-IP-Bereiche gilt nur für neue Verbindungen (siehe Auswirkungen auf vorhandenen Traffic).
Der Dienst ergreift verschiedene Maßnahmen, um die Sicherheit Ihrer öffentlichen Cluster zu gewährleisten. Alle Verbindungen werden bei der Übertragung mit TLS verschlüsselt und erfordern eine Authentifizierung. Sie müssen sich mit einer IAM-Identität mit SASL oder einem Clientzertifikat mit mTLS authentifizieren. Anonymer Zugriff ist nicht zulässig. Weitere Informationen finden Sie unter Authentifizierungstypen für Kafka-Broker.
Sicherheitsadministratoren können öffentliche Cluster verbieten, indem sie die verwaltete Organisationsrichtlinien-Einschränkung Restrict Managed Kafka Public Clusters (constraints/managedkafka.managed.restrictPublicClusters) aktivieren. Weitere Informationen zu verwalteten Einschränkungen finden Sie unter Verwaltete Einschränkungen.
Firewalls für ausgehenden Traffic aus externen Netzwerken konfigurieren
In einigen Fällen müssen Sie möglicherweise die externen IPv4-Adressen Ihrer Broker- und Bootstrap-Endpunkte ermitteln. Eine Anleitung zum Abrufen dieser Werte finden Sie unter Details zu öffentlichen Clustern.
Der Dienst stellt diese Informationen auf folgende Weise zur Verfügung:
Die externen IPv4-Adressen, die Ihrem Cluster zugeordnet sind, sind in der Managed Service for Apache Kafka API,
gcloudund Terraform verfügbar.Der Dienst verwaltet einen oder mehrere DNS-Einträge für die Ermittlung. Dies sind DNS-
A-Einträge, die alle externen IPv4-Adressen enthalten, die mit Ihrem Cluster verknüpft sind. Sie können diese Einträge in FQDN-basierten Firewalls wie Cloud NGFW verwenden, in denen Regeln automatisch aktualisiert werden, wenn sich die Liste der Endpunkte ändert. Die Liste der Discovery-Endpunkte ist in der API,gcloudund Terraform verfügbar.
Beachten Sie Folgendes, wenn Sie die öffentlichen IP-Adressen verwenden, die Ihrem Cluster zugeordnet sind:
Die Liste der öffentlichen IPv4-Adressen, die mit Ihrem Cluster verknüpft sind, kann sich ändern oder erweitern. Automatisieren Sie daher die Verarbeitung dieser Informationen oder definieren Sie einen Prozess, um neue DNS-Einträge für die Ermittlung beim Hochskalieren Ihres Clusters zu berücksichtigen. Änderungen können in folgenden Fällen auftreten:
Sie skalieren Ihren Cluster. Beim Hochskalieren können eine oder mehrere externe IPv4-Adressen hinzugefügt werden, wenn neue Broker hinzugefügt werden. Informationen dazu, wie sich die Anzahl der vCPUs auf die Anzahl der Broker auswirkt, finden Sie unter Subnetzgröße.
Sie deaktivieren und aktivieren dann die Funktion für öffentliche Cluster. Bei dieser Aktion wird dem Cluster eine neue Gruppe externer IPv4-Adressen zugewiesen.
Jeder Discovery-DNS-Eintrag enthält maximal 30 IP-Adressen. Dies bleibt innerhalb der üblichen Grenzwerte, die von FQDN-Firewalls erzwungen werden. Cluster mit 29 oder weniger Brokern haben einen Discovery-DNS-Eintrag, der 30 externe IPv4-Adressen enthält (einschließlich des Bootstrap-Eintrags). Der Dienst fügt für jeweils 30 zusätzliche Broker einen DNS-Eintrag für die Erkennung hinzu. Informationen dazu, wie sich die Anzahl der vCPUs auf die Anzahl der Broker auswirkt, finden Sie unter Subnetzgröße.
Konfigurieren Sie Ihre Kafka-Clients nicht so, dass sie eine Verbindung zu Discovery-DNS-Einträgen herstellen. Konfigurieren Sie sie stattdessen so, dass sie eine Verbindung zur Bootstrap-Adresse herstellen. Weitere Informationen finden Sie unter Einschränkungen.
Wenn Sie diese Informationen zum Konfigurieren von Firewalls für ausgehenden Traffic verwenden, lassen Sie Verbindungen zu den TCP-Ports
9092(SASL) und9192(mTLS) zu.
Netzwerkarchitektur eines Clusters
In diesem Abschnitt werden die Details der Netzwerkarchitektur beschrieben, die in Managed Service for Apache Kafka verwendet wird.
Ein Kafka-Cluster erstreckt sich über ein Mandantennetzwerk und ein oder mehrere Verbrauchernetzwerke.
Im Mandantennetzwerk hat der Cluster eine einzelne Bootstrap-IP-Adresse und ‑URL. Diese Bootstrap-Adresse entspricht einem Load-Balancer, der mit allen Brokern im Cluster verbunden ist. Jeder Broker kann auch als Bootstrap-Server fungieren. Wir empfehlen jedoch, die Bootstrap-Adresse zu verwenden, um die Zuverlässigkeit zu erhöhen.
In jedem Nutzernetzwerk erstellt der Dienst einen Private Service Connect-Endpunkt für die Bootstrap-Adresse und einen Endpunkt für jeden Broker.
Die URL für die Bootstrap-Adresse ist in allen VPC-Netzwerken, mit denen ein Cluster verbunden ist, dieselbe. Die IP-Adresse ist lokal für das Consumer-Netzwerk.
Clients stellen über DNS-Namen eine Verbindung zu Kafka-Brokern her. Diese Namen werden automatisch in jedem VPC-Netzwerk registriert, mit dem ein Kafka-Cluster verbunden ist. Die Bootstrap-Adresse und die zugehörige Portnummer sind als Eigenschaft des Clusters verfügbar.
Clients verwenden die Bootstrap-Adresse, um Broker-URLs abzurufen. Diese URLs werden in IP-Adressen aufgelöst, die für jedes VPC-Netzwerk lokal sind. Die tatsächlichen Broker-IP-Adressen und ‑URLs finden Sie in Cloud DNS.
Das folgende Diagramm zeigt ein Beispiel für die Architektur eines Managed Service for Apache Kafka-Clusternetzwerks.
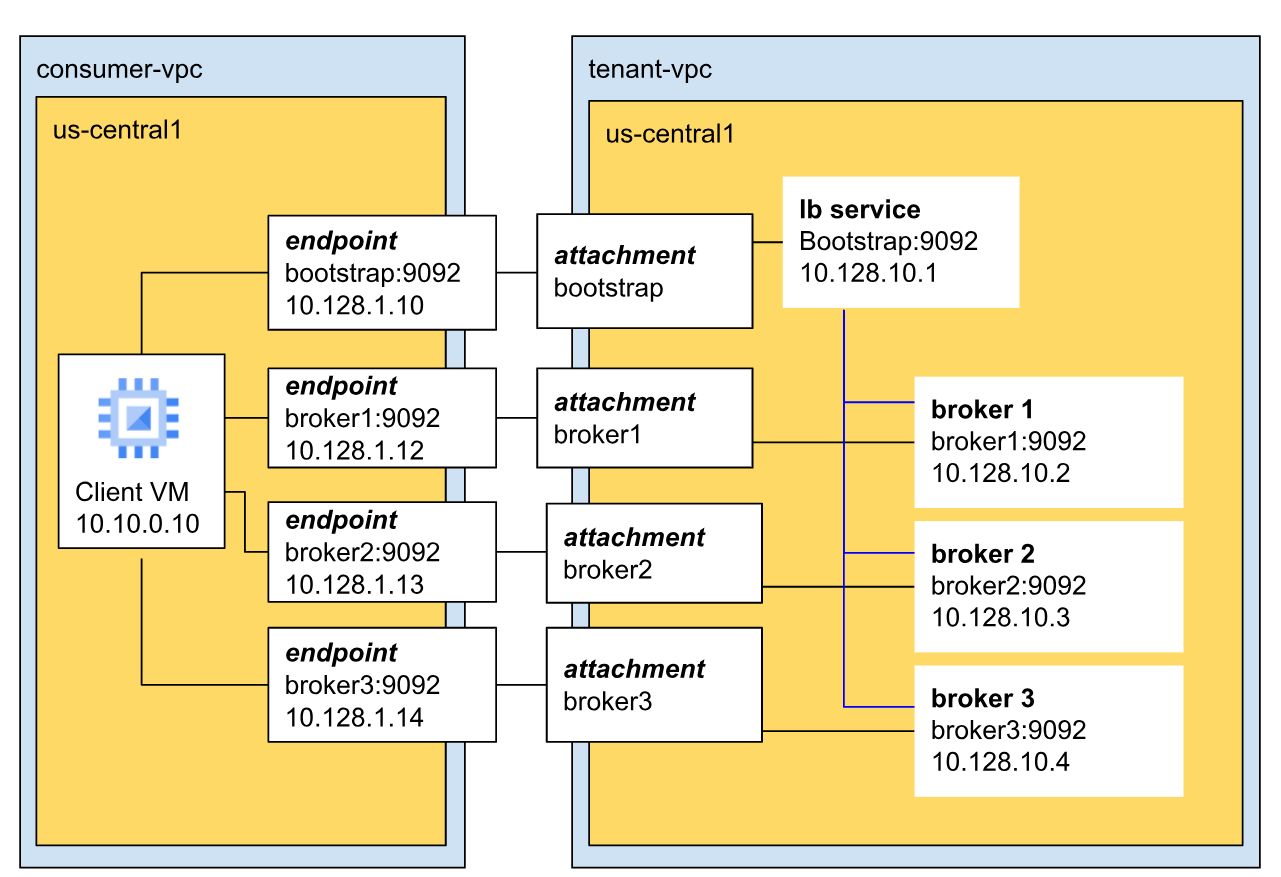 *
In diesem Beispiel hat der Cluster drei Broker und befindet sich in der VPC des Mandanten.
Broker kommunizieren über den standardmäßigen Kafka-Port (9092) mit Clients und haben eindeutige IP-Adressen. In diesem Beispiel haben die drei Broker die IP-Adressen 10.128.10.2, 10.128.10.3 und 10.128.10.4.
Alle drei Broker stellen eine Verbindung zum Bootstrap-Load-Balancer her. Dies sorgt für hohe Verfügbarkeit und regionale Fehlertoleranz, da die Bootstrap-Adresse nicht auf einen einzelnen Broker oder eine einzelne Zone beschränkt ist.
Beschränkungen
Für VPC-Verbindungen und öffentliche Cluster gelten die folgenden Einschränkungen:
Subnetzregion: Verbundene Subnetze müssen sich in derselben Region wie Ihr Cluster befinden.
Anzahl der Subnetze: Sie können mindestens ein und maximal zehn Subnetze mit einem Cluster verbinden.
Subnetze pro Netzwerk Sie können maximal ein Subnetz pro VPC-Netzwerk mit einem Cluster verbinden.
Subnetzgröße: Für jedes verbundene Subnetz ist mindestens eine IP-Adresse für jeden Broker sowie eine IP-Adresse für die Bootstrap-Adresse erforderlich. Es sind mindestens vier nutzbare IP-Adressen erforderlich. Weitere Informationen finden Sie unter Subnetzgröße.
Verbundene Subnetze für öffentliche Cluster Damit Sie den öffentlichen Zugriff aktivieren können, muss Ihr Cluster mindestens ein verbundenes Subnetz haben. Sie müssen jedoch keinen Traffic darüber senden.
Zulässige Quell-IP-Bereiche: Jeder zulässige Quell-IP-Bereich für einen öffentlichen Cluster muss in IPv4-CIDR-Notation angegeben werden. Die Größe jedes CIDR-Subnetzes muss zwischen
/16und/32liegen. CIDR-Bereiche dürfen sich nicht überschneiden. IPv6-Adressen werden nicht unterstützt. Sie können maximal 500 zulässige Quell-IP-Bereiche angeben.DNS-Auflösung von Erkennungseinträgen: Discovery-DNS-Einträge sind nur für die Konfiguration von FQDN-basierten Egress-Firewalls vorgesehen. Konfigurieren Sie Ihre Kafka-Clients nicht so, dass sie eine Verbindung zu diesen Discovery-Einträgen herstellen. Konfigurieren Sie sie stattdessen so, dass sie eine Verbindung zur Bootstrap-Adresse herstellen.
Fehlerbehebung
Informationen zur Fehlerbehebung bei Netzwerkproblemen finden Sie unter Netzwerkfehler.
Nächste Schritte
Weitere Informationen zum Erstellen eines Clusters finden Sie unter Managed Service for Apache Kafka-Cluster erstellen.
Weitere Informationen zum Aktualisieren eines Clusters finden Sie unter Managed Service for Apache Kafka-Cluster aktualisieren.
Weitere Informationen zum Ansehen der Subnetzwerke und aktiven Broker eines Clusters finden Sie unter Cluster ansehen.
Weitere Informationen zum Veröffentlichen und Verarbeiten von Nachrichten finden Sie unter Nachrichten veröffentlichen und verarbeiten.