


Les clients peuvent se connecter à un cluster Google Cloud Managed Service pour Apache Kafka depuis n'importe quel réseau de cloud privé virtuel (VPC) de vos projets Google Cloud . Vous pouvez également activer l'accès depuis des plages d'adresses IP de confiance sur l'Internet public.
Cette page explique comment la mise en réseau est configurée dans Managed Service pour Apache Kafka, comment activer les connexions entre les clients Kafka et votre cluster, et comment connecter de manière privée les clients et les clusters dans différents projets.
Un réseau VPC est une version virtuelle d'un réseau physique, implémentée dans Google Cloud. Il fournit une connectivité réseau privée et sécurisée pour vos instances de VM, vos charges de travail de conteneurs et d'autres ressources. Pour en savoir plus, consultez la présentation des réseaux VPC.
Présentation
Lorsque vous créez un cluster, le service place les brokers et les points de terminaison réseau du cluster dans un réseau VPC au sein d'un projet géré par Google. Ce projet est appelé projet locataire, et le réseau est appelé réseau locataire. En revanche, vos ressources, vos applications clientes et vos réseaux VPC clients résident dans votre propre projet, appelé projet consommateur. Chaque cluster Managed Service pour Apache Kafka possède son propre réseau de locataire isolé.
Les réseaux VPC sont divisés en partitions appelées sous-réseaux. Chaque sous-réseau définit une plage d'adresses IP dans une région spécifique de votre réseau cloud. Pour permettre aux applications clientes de communiquer avec le cluster, vous devez connecter les sous-réseaux de vos réseaux VPC au réseau du locataire. Vous pouvez également activer l'accès public au cluster pour vous connecter via l'Internet public.
Le schéma suivant montre deux projets Google Cloud , project-1 et project-2. Un cluster Managed Service pour Apache Kafka se trouve dans project-1.
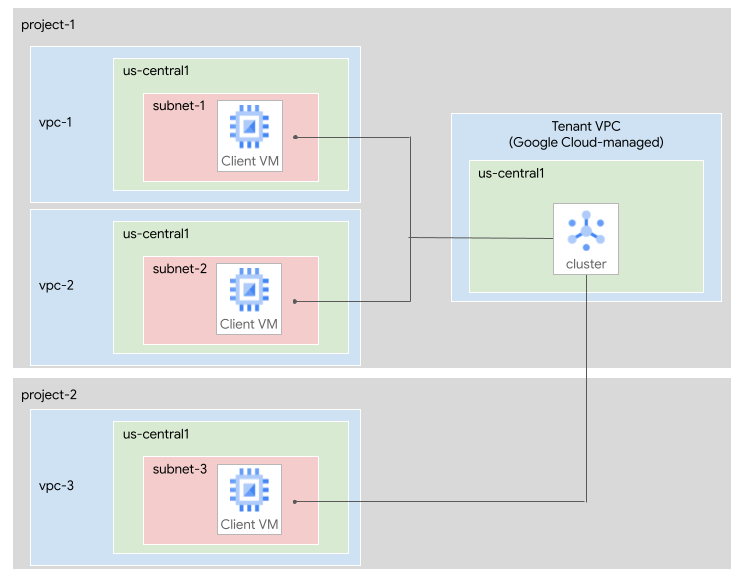
Les sous-réseaux suivants sont connectés au cluster :
subnet-1, dans le réseau VPCvpc-1deproject-1.subnet-2, dans le réseau VPCvpc-2deproject-1.subnet-3, dans le réseau VPCvpc-3deproject-2.
Connecter des sous-réseaux à un cluster
Lorsque vous créez un cluster Managed Service pour Apache Kafka, vous devez spécifier au moins un sous-réseau. Vous pourrez ensuite mettre à jour le cluster pour ajouter ou supprimer des sous-réseaux.
Les sous-réseaux connectés peuvent appartenir au même projet client que le cluster ou à un autre projet client. Les applications clientes de n'importe quelle région des réseaux VPC connectés peuvent se connecter au cluster. Pour en savoir plus sur les emplacements et le nombre de sous-réseaux, consultez Limites.
Pour savoir comment afficher les sous-réseaux connectés, consultez Afficher un cluster.
Entrées DNS du cluster
Lorsque vous connectez un sous-réseau à un cluster, le service crée des entrées DNS dans le réseau de ce sous-réseau pour l'adresse d'amorçage et les courtiers du cluster. Les clients Kafka utilisent l'adresse d'amorçage pour localiser les courtiers et établir une connexion. Lorsque le serveur d'amorçage redirige un client vers un courtier spécifique, il utilise l'URL du courtier plutôt qu'une adresse IP.
Les URL d'amorçage et d'agent sont fixes pendant toute la durée de vie d'un cluster, mais leur format peut varier selon les clusters. Pour obtenir l'adresse d'amorçage d'un cluster, consultez Afficher l'adresse d'amorçage d'un cluster.
Les noms DNS sont identiques dans tous les sous-réseaux connectés, bien qu'ils correspondent à des adresses IP différentes dans chaque sous-réseau. Comme les noms DNS sont cohérents, toutes vos applications clientes Kafka peuvent utiliser la même adresse d'amorçage.
Pour obtenir des exemples d'applications clientes qui se connectent à Managed Service pour Apache Kafka, consultez les tutoriels suivants :
Dimensionnement des sous-réseaux
Lorsque vous ajoutez un sous-réseau à un cluster, il doit disposer de suffisamment d'adresses IP disponibles. Chaque sous-réseau nécessite une adresse IP pour chaque courtier Kafka, ainsi qu'une adresse IP pour l'adresse d'amorçage. La taille minimale d'un cluster Managed Service pour Apache Kafka est de trois courtiers. Chaque sous-réseau a donc besoin d'au moins quatre adresses IP utilisables, y compris l'adresse d'amorçage.
Si votre cluster comporte plus de 45 vCPU, il dispose d'un courtier pour 15 vCPU. Dans ce cas, calculez le nombre minimal d'adresses IP pour chaque sous-réseau comme suit :
- Divisez le nombre de vCPU par 15.
- Arrondissez à l'entier supérieur le plus proche.
- Ajoutez 1 pour tenir compte de l'adresse d'amorçage.
Par exemple, un cluster avec 60 vCPU a besoin d'au moins (60/15 + 1) = 5 adresses IP utilisables.
Google peut modifier le ratio entre les courtiers et les processeurs virtuels. Pour tenir compte de toute modification, nous vous recommandons d'allouer trois fois le nombre d'adresses IP calculé à l'étape précédente.
Lorsque vous planifiez la taille du sous-réseau, basez vos calculs sur la taille maximale à laquelle vous prévoyez de faire évoluer votre cluster.
Si vous prévoyez d'utiliser Kafka Connect, tenez également compte des exigences concernant le sous-réseau pour le cluster Connect. Pour en savoir plus, consultez Sous-réseau de nœuds de calcul.
Plages d'adresses IP publiques utilisées en mode privé
Vous pouvez connecter votre cluster à des sous-réseaux qui utilisent l'espace d'adressage non-RFC 1918. Ces plages d'adresses IP sont appelées plages d'adresses IP publiques utilisées en mode privé (PUPI).
Aucune configuration supplémentaire n'est requise pour se connecter aux sous-réseaux PUPI. Les sous-réseaux PUPI doivent utiliser une plage IPv4 valide qui n'est pas une plage de sous-réseaux IPv4 interdite.
Connecter des clients et des clusters de manière privée entre les projets
Si vous souhaitez connecter des clients Kafka de différents projets Google Cloudà votre cluster de manière privée, vous pouvez utiliser l'une des méthodes suivantes :
- Connectez le cluster aux réseaux VPC de plusieurs projets.
- Utilisez un VPC partagé pour connecter des projets.
Les sections suivantes décrivent ces options.
Connecter un cluster entre les projets
Vous pouvez connecter des sous-réseaux d'autres projets à votre cluster. Pour activer l'accès entre projets, vous devez accorder des autorisations au compte de service géré par Google associé au cluster. Pour chaque projet dans lequel vous souhaitez que les clients Kafka accèdent au cluster, le compte de service doit disposer du rôle IAM Agent de service Managed Kafka dans ce projet. Ce rôle permet au cluster d'accéder aux ressourcesGoogle Cloud afin de créer des ressources réseau et des entrées DNS.
Par exemple, si project-1 contient le cluster et que vous souhaitez que les clients de project-2 accèdent au cluster, accordez au compte de service Managed Kafka pour project-1 le rôle d'agent de service Managed Kafka sur project-2. Connectez ensuite un sous-réseau de project-2 au cluster, comme décrit dans Connecter des sous-réseaux au cluster.
Pour attribuer les rôles nécessaires, procédez comme suit :
Console
Déterminez les Google Cloud projets dans lesquels vous souhaitez que vos clients Kafka accèdent au cluster Managed Service pour Apache Kafka.
Pour chaque projet, dans la console Google Cloud , accédez à la page IAM de ce projet :
Cliquez sur Accorder l'accès.
Dans le champ Nouveaux comptes principaux, saisissez ce qui suit :
service-CLUSTER_PROJECT_NUMBER@gcp-sa-managedkafka.iam.gserviceaccount.comRemplacez CLUSTER_PROJECT_NUMBER par le numéro de projet du projet contenant le cluster Managed Service for Apache Kafka.
Cliquez sur Ajouter des rôles.
Dans le champ Rechercher des rôles, saisissez
Managed Kafka Service Agent. Le nom de l'agent de service s'affiche dans les résultats de recherche.Dans les résultats de recherche, sélectionnez Agent du service Kafka géré.
Cliquez sur Appliquer.
Cliquez sur Enregistrer.
gcloud
Déterminez les Google Cloud projets dans lesquels vous souhaitez que vos clients Kafka accèdent au cluster Managed Service pour Apache Kafka.
Pour chaque projet, exécutez la commande
gcloud projects add-iam-policy-binding:gcloud projects add-iam-policy-binding CLIENT_PROJECT_ID \ --member=serviceAccount:service-CLUSTER_PROJECT_NUMBER@gcp-sa-managedkafka.iam.gserviceaccount.com \ --role=roles/managedkafka.serviceAgentRemplacez les éléments suivants :
- CLIENT_PROJECT_ID : nom du projet contenant le réseau VPC à connecter
- CLUSTER_PROJECT_NUMBER : numéro de projet du projet contenant le cluster Managed Service pour Apache Kafka
Utiliser un VPC partagé pour connecter des projets
Le VPC partagé permet à une organisation de connecter des ressources provenant de différents projets à un réseau VPC commun. Pour utiliser le VPC partagé avec Managed Service pour Apache Kafka, procédez comme suit :
Créez un cluster Managed Service pour Apache Kafka.
Attribuez les rôles requis au compte de service Managed Kafka dans le projet hôte de VPC partagé, comme décrit dans la section précédente.
Connectez le cluster Managed Service pour Apache Kafka à un sous-réseau du réseau VPC partagé.
Les clients du projet hôte de VPC partagé ou des projets de service peuvent se connecter au cluster.
Pour savoir quand utiliser le VPC partagé dans vos architectures réseau, consultez Bonnes pratiques et architectures de référence pour la conception de VPC.
Connecter des clients à un cluster public
Si vous disposez d'applications clientes en dehors de votre réseau VPC, vous pouvez activer l'accès public à votre cluster. Un cluster public nécessite toujours un sous-réseau connecté. Toutefois, vous n'avez pas besoin d'y envoyer du trafic.
Lorsque vous activez la fonctionnalité de cluster public, le service provisionne des adresses IPv4 externes pour les points de terminaison du courtier et du bootstrap du cluster. Le service permet également de résoudre publiquement les entrées DNS du cluster en ces adresses IP publiques. Cela signifie que les clients externes peuvent utiliser la même adresse d'amorçage pour localiser les courtiers et établir une connexion. Cette implémentation utilise le DNS fractionné. Les clients des réseaux VPC contenant un sous-réseau connecté continuent de résoudre les points de terminaison privés, tandis que les clients des autres réseaux résolvent les points de terminaison publics. L'activation de la fonctionnalité de cluster public ne crée pas de ressources supplémentaires dans votre projet consommateur.
Lorsque vous activez la fonctionnalité de cluster public, vous devez fournir une ou plusieurs plages d'adresses IP sources autorisées. Pour en savoir plus sur les tailles et les limites de plages autorisées, consultez Clusters publics ou Limites.
Vous pouvez ajouter ou supprimer des plages d'adresses IP sources autorisées en mettant à jour votre cluster. Managed Service pour Apache Kafka utilise Cloud Next Generation Firewall pour restreindre l'accès aux clusters publics. La suppression des plages d'adresses IP sources autorisées ne s'applique qu'aux nouvelles connexions (voir Effets sur le trafic existant).
Le service prend plusieurs précautions pour assurer la sécurité de vos clusters publics. Toutes les connexions sont chiffrées en transit à l'aide du protocole TLS et nécessitent une authentification. Vous devez vous authentifier à l'aide d'une identité IAM avec SASL ou d'un certificat client avec mTLS. L'accès anonyme n'est pas autorisé. Pour en savoir plus, consultez Types d'authentification pour les courtiers Kafka.
Les administrateurs de la sécurité peuvent interdire les clusters publics en activant la contrainte de règle d'administration gérée Restreindre les clusters Kafka publics gérés (constraints/managedkafka.managed.restrictPublicClusters). Pour en savoir plus sur les contraintes gérées, consultez Contraintes gérées.
Configurer des pare-feu de sortie à partir de réseaux externes
Dans certains cas, vous devrez peut-être déterminer les adresses IPv4 externes de vos points de terminaison de broker et d'amorçage. Pour savoir comment récupérer ces valeurs, consultez Détails du cluster public.
Le service met ces informations à disposition des utilisateurs de différentes manières :
Les adresses IPv4 externes associées à votre cluster sont disponibles dans l'API Managed Service pour Apache Kafka,
gcloudet Terraform.Le service gère un ou plusieurs enregistrements DNS de découverte. Il s'agit d'enregistrements DNS
Aqui contiennent toutes les adresses IPv4 externes associées à votre cluster. Vous pouvez utiliser ces enregistrements dans les pare-feu basés sur le nom de domaine complet (FQDN), tels que Cloud NGFW, qui mettent automatiquement à jour les règles lorsque la liste des points de terminaison change. La liste des points de terminaison Discovery est disponible dans l'API,gcloudet Terraform.
Tenez compte des points suivants lorsque vous utilisez les adresses IP publiques associées à votre cluster :
La liste des adresses IPv4 publiques associées à votre cluster peut changer ou s'allonger. Pour cette raison, automatisez la façon dont vous consommez ces informations ou définissez un processus pour tenir compte des nouveaux enregistrements DNS de découverte lorsque vous augmentez la taille de votre cluster. Des modifications peuvent se produire dans les cas suivants :
Vous effectuez le scaling de votre cluster. L'augmentation de la capacité peut ajouter une ou plusieurs adresses IPv4 externes à mesure que de nouveaux courtiers sont ajoutés. Pour comprendre comment le nombre de processeurs virtuels influe sur le nombre de brokers, consultez Dimensionnement des sous-réseaux.
Vous désactivez, puis réactivez la fonctionnalité de cluster public. Cette action attribue un nouvel ensemble d'adresses IPv4 externes au cluster.
Chaque enregistrement DNS de découverte contient au maximum 30 adresses IP. Cela reste dans les limites courantes imposées par les pare-feu FQDN. Les clusters comportant 29 brokers ou moins disposent d'un enregistrement DNS de découverte contenant 30 adresses IPv4 externes (y compris l'enregistrement d'amorçage). Le service ajoute un enregistrement DNS de découverte pour chaque groupe de 30 brokers supplémentaires. Pour comprendre comment le nombre de vCPU influence le nombre de courtiers, consultez Dimensionnement des sous-réseaux.
Ne configurez pas vos clients Kafka pour qu'ils se connectent aux enregistrements DNS de découverte. Configurez-les plutôt pour qu'ils se connectent à l'adresse d'amorçage. Pour en savoir plus, consultez la section Limites.
Si vous utilisez ces informations pour configurer des pare-feu de sortie, autorisez la connectivité aux ports TCP
9092(SASL) et9192(mTLS).
Architecture réseau d'un cluster
Cette section décrit en détail l'architecture réseau utilisée dans Managed Service pour Apache Kafka.
Un cluster Kafka s'étend sur un réseau de locataire et un ou plusieurs réseaux de consommateurs.
Dans le réseau du locataire, le cluster dispose d'une seule adresse IP et URL d'amorçage. Cette adresse d'amorçage correspond à un équilibreur de charge connecté à tous les courtiers du cluster. Chaque courtier peut également servir de serveur d'amorçage, mais nous vous recommandons d'utiliser l'adresse d'amorçage pour plus de fiabilité.
Dans chaque réseau consommateur, le service crée un point de terminaison Private Service Connect pour l'adresse d'amorçage et un point de terminaison pour chaque courtier.
L'URL de l'adresse d'amorçage est la même pour tous les réseaux VPC auxquels un cluster est connecté. L'adresse IP est locale au réseau consommateur.
Les clients se connectent aux brokers Kafka à l'aide de noms DNS. Ces noms sont enregistrés automatiquement dans chaque réseau VPC auquel un cluster Kafka est connecté. L'adresse d'amorçage et son numéro de port sont disponibles en tant que propriété du cluster.
Les clients utilisent l'adresse d'amorçage pour récupérer les URL des courtiers. Ces URL sont résolues en adresses IP locales pour chaque réseau VPC. Vous trouverez les adresses IP et les URL réelles du courtier dans Cloud DNS.
Le schéma suivant présente un exemple d'architecture d'un réseau de cluster Managed Service pour Apache Kafka.
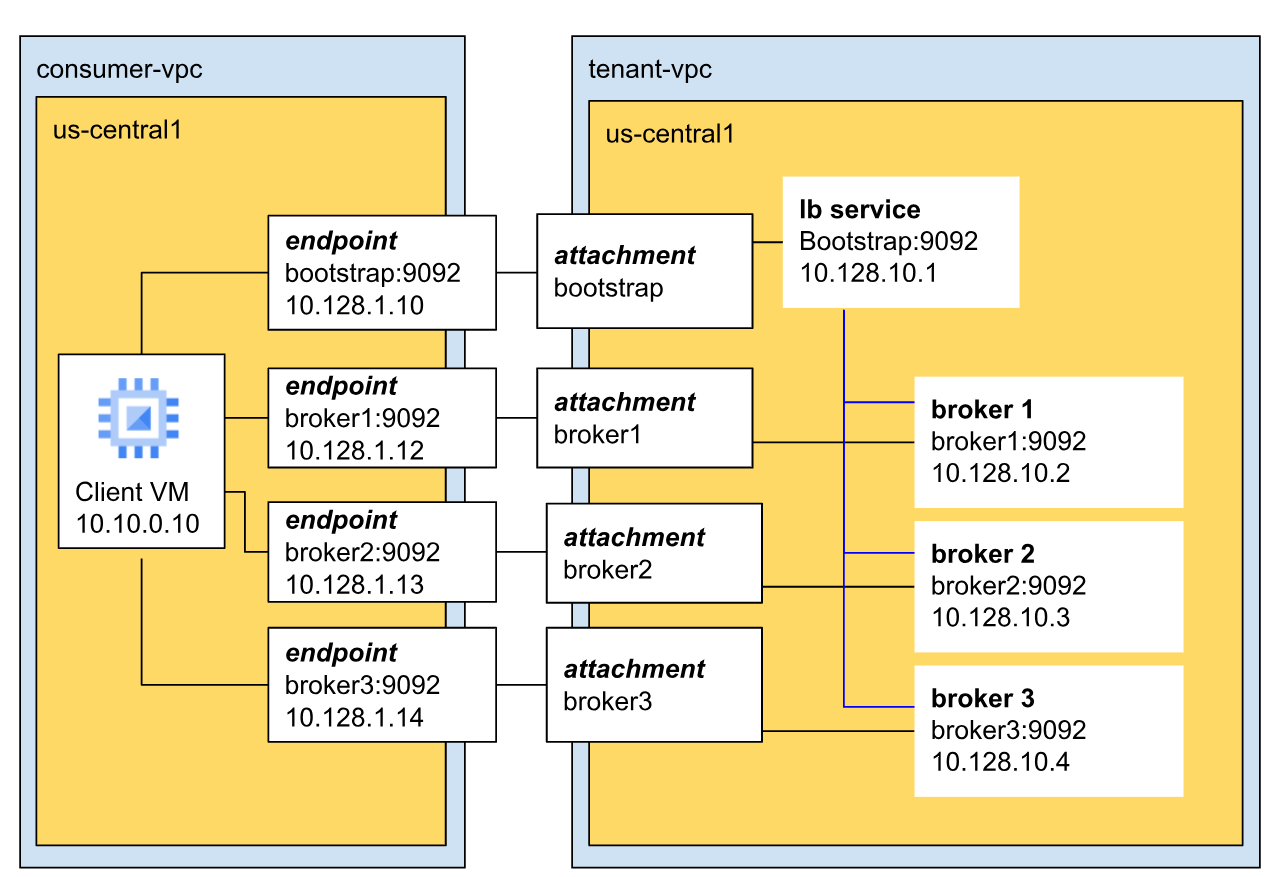 *
Dans cet exemple, le cluster comporte trois courtiers et se trouve dans le VPC du locataire.
Les courtiers communiquent avec les clients via le port Kafka par défaut (9092) et disposent d'adresses IP uniques. Dans cet exemple, les trois courtiers ont respectivement les adresses IP 10.128.10.2, 10.128.10.3 et 10.128.10.4.
Les trois courtiers se connectent à l'équilibreur de charge d'amorçage. Cela garantit une haute disponibilité et une tolérance aux pannes régionales, car l'adresse d'amorçage n'est pas limitée à un seul courtier ni à une seule zone.
Limites
Les limitations suivantes s'appliquent aux connexions VPC et aux clusters publics :
Région du sous-réseau. Les sous-réseaux connectés doivent se trouver dans la même région que votre cluster.
Nombre de sous-réseaux. Vous pouvez connecter au minimum une et au maximum dix sous-réseaux à un cluster.
Sous-réseaux par réseau. Vous ne pouvez connecter qu'un seul sous-réseau par réseau VPC à un cluster.
Taille du sous-réseau : Chaque sous-réseau connecté nécessite au moins une adresse IP pour chaque courtier, plus une adresse IP pour l'adresse d'amorçage. Vous devez disposer d'au moins quatre adresses IP utilisables. Pour en savoir plus, consultez Dimensionnement des sous-réseaux.
Sous-réseaux connectés pour les clusters publics. Pour activer l'accès public, votre cluster doit toujours comporter au moins un sous-réseau connecté, même si vous n'avez pas besoin d'y envoyer du trafic.
Plages d'adresses IP sources autorisées. Chaque plage d'adresses IP sources autorisée pour un cluster public doit être spécifiée au format CIDR IPv4. La taille de chaque sous-réseau CIDR doit être comprise entre
/16et/32. Les plages CIDR ne doivent pas se chevaucher. Les adresses IPv6 ne sont pas acceptées. Vous pouvez spécifier jusqu'à 500 plages d'adresses IP sources autorisées.Résolution DNS de l'enregistrement de découverte. Les enregistrements DNS de découverte ne sont conçus que pour configurer les pare-feu de sortie basés sur le nom de domaine complet. Ne configurez pas vos clients Kafka pour qu'ils se connectent à ces enregistrements de découverte. Configurez-les plutôt pour qu'ils se connectent à l'adresse d'amorçage.
Résoudre les problèmes
Pour en savoir plus sur la résolution des problèmes de mise en réseau, consultez Erreurs de mise en réseau.
Étape suivante
Pour en savoir plus sur la création d'un cluster, consultez Créer un cluster Managed Service pour Apache Kafka.
Pour savoir comment mettre à jour un cluster, consultez Mettre à jour un cluster Managed Service pour Apache Kafka.
Pour savoir comment afficher les sous-réseaux et les brokers actifs d'un cluster, consultez Afficher un cluster.
Pour en savoir plus sur la publication et l'utilisation de messages, consultez Publier et utiliser des messages.