


Los clientes pueden conectarse a un clúster de Google Cloud Managed Service para Apache Kafka desde cualquier red de nube privada virtual (VPC) en tus Google Cloud proyectos. También puedes activar el acceso desde rangos de IP de confianza a través de Internet pública.
En esta página, se explica cómo se configura la red en Managed Service para Apache Kafka, cómo activar las conexiones entre los clientes de Kafka y tu clúster, y cómo conectar de forma privada clientes y clústeres en diferentes proyectos.
Una red de VPC es una versión virtual de una red física, implementada dentro de Google Cloud. Proporciona conectividad de red privada y segura para tus instancias de VM, cargas de trabajo de contenedores y otros recursos. Para obtener más información, consulta la descripción general de las redes de VPC.
Descripción general
Cuando creas un clúster, el servicio coloca los agentes del clúster y los extremos de red en una red de VPC dentro de un proyecto administrado por Google. Este proyecto se llama proyecto de usuario, y la red se llama red de usuario. En cambio, tus recursos, aplicaciones cliente y redes de VPC cliente residen en tu propio proyecto, que se denomina proyecto del consumidor. Cada clúster de Managed Service para Apache Kafka tiene su propia red de arrendatario aislada.
Las redes de VPC se dividen en particiones llamadas subredes. Cada subred define un rango de direcciones IP en una región específica de tu red de nube. Para permitir que las aplicaciones cliente se comuniquen con el clúster, conecta las subredes dentro de tus redes de VPC a la red del arrendatario o, de manera opcional, activa el acceso público al clúster para conectarte a través de Internet pública.
En el siguiente diagrama, se muestran dos proyectos Google Cloud , project-1 yproject-2. Un clúster de Managed Service para Apache Kafka se encuentra en project-1.
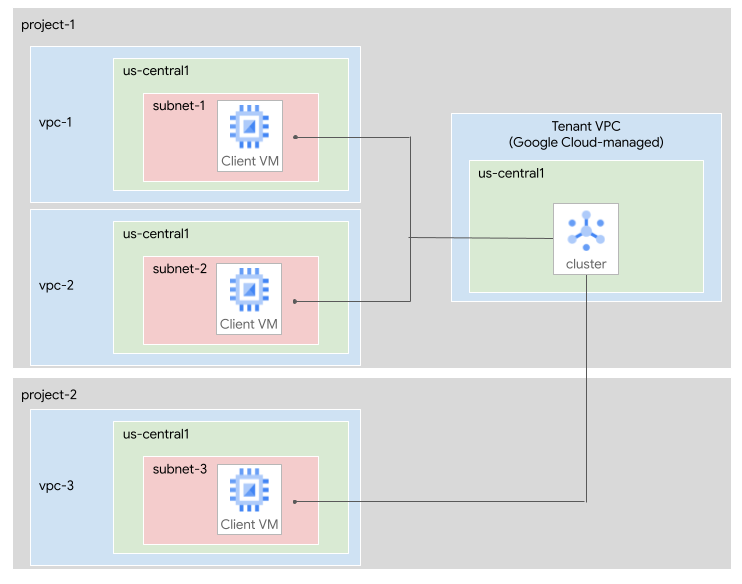
Las siguientes subredes están conectadas al clúster:
subnet-1, en la red de VPCvpc-1enproject-1.subnet-2, en la red de VPCvpc-2enproject-1subnet-3, en la red de VPCvpc-3enproject-2
Conecta subredes a un clúster
Cuando creas un clúster de Managed Service para Apache Kafka por primera vez, debes especificar al menos una subred. Más adelante, puedes actualizar el clúster para agregar o quitar subredes.
Las subredes conectadas pueden pertenecer al mismo proyecto de consumidor que el clúster o a otro proyecto de consumidor. Las aplicaciones cliente en cualquier región dentro de las redes de VPC conectadas pueden conectarse al clúster. Para obtener más información sobre las ubicaciones y los recuentos de subredes, consulta Limitaciones.
Para obtener más información sobre cómo ver las subredes conectadas, consulta Cómo ver un clúster.
Entradas de DNS del clúster
Cuando conectas una subred a un clúster, el servicio crea entradas de DNS dentro de esa red de subred para la dirección de arranque y los intermediarios del clúster. Los clientes de Kafka usan la dirección de inicio para ubicar los agentes y establecer una conexión. Cuando el servidor de arranque redirecciona un cliente a un agente en particular, usa la URL del agente en lugar de una dirección IP.
Las URLs de arranque y de agente son fijas durante la vida útil de un clúster, pero el formato de las URLs puede ser diferente para los distintos clústeres. Para obtener la dirección de arranque de un clúster, consulta Cómo ver la dirección de arranque de un clúster.
Los nombres de DNS son los mismos en todas las subredes conectadas, aunque corresponden a diferentes direcciones IP en cada subred. Debido a que los nombres de DNS son coherentes, todas tus aplicaciones cliente de Kafka pueden usar la misma dirección de inicio.
Para ver ejemplos de aplicaciones cliente que se conectan a Managed Service para Apache Kafka, consulta los siguientes instructivos:
Tamaño de la subred
Cuando agregas una subred a un clúster, esta debe tener suficientes direcciones IP disponibles. Cada subred requiere una dirección IP para cada agente de Kafka, además de una dirección IP para la dirección de arranque. El tamaño mínimo del clúster para Managed Service para Apache Kafka es de tres brokers, por lo que cada subred necesita al menos cuatro direcciones IP utilizables, incluida la dirección de bootstrap.
Si tu clúster tiene más de 45 CPU virtuales, tendrá un agente para cada 15 CPU virtuales. En ese caso, calcula la cantidad mínima de direcciones IP para cada subred de la siguiente manera:
- Divide la cantidad de CPU virtuales por 15.
- Redondea hacia arriba al número entero más cercano.
- Agrega 1 para tener en cuenta la dirección de arranque.
Por ejemplo, un clúster con 60 CPU virtuales necesita al menos (60/15 + 1) = 5 direcciones IP utilizables.
Es posible que Google cambie la proporción de intermediarios en relación con las CPU virtuales. Para tener en cuenta cualquier cambio, te recomendamos que asignes tres veces la cantidad de direcciones IP que calculaste en el paso anterior.
Cuando planifiques el tamaño de la subred, basa tus cálculos en el tamaño máximo al que esperas escalar tu clúster.
Si planeas usar Kafka Connect, también debes tener en cuenta los requisitos de subred para el clúster de Connect. Para obtener más información, consulta subred del trabajador.
Rangos de IP públicas que se usan de forma privada
Puedes conectar tu clúster a subredes que usen el espacio de direcciones que no es RFC 1918. Estos rangos de direcciones IP se denominan rangos de IP pública de uso privado (PUPI).
No necesitas configuración adicional para conectarte a las subredes de PUPI. Las subredes de PUPI deben usar un rango IPv4 válido que no sea un rango de subred IPv4 prohibido.
Conecta clientes y clústeres de forma privada en todos los proyectos
Si deseas conectar de forma privada clientes de Kafka en diferentes proyectos de Google Clouda tu clúster, puedes usar uno de los siguientes métodos:
- Conecta el clúster a redes de VPC en varios proyectos.
- Usa la VPC compartida para conectar proyectos.
En las siguientes secciones, se describen estas opciones.
Conecta un clúster en varios proyectos
Puedes conectar subredes de otros proyectos a tu clúster. Para activar el acceso entre proyectos, debes otorgar permisos a la cuenta de servicio administrada por Google que está asociada al clúster. En cada proyecto en el que desees que los clientes de Kafka accedan al clúster, la cuenta de servicio debe tener el rol de IAM de agente de servicio de Managed Kafka en ese proyecto. Este rol permite que el clúster acceda a los recursos deGoogle Cloud , de modo que pueda crear recursos de red y entradas de DNS.
Por ejemplo, si project-1 contiene el clúster y deseas que los clientes de project-2 accedan al clúster, otorga a la cuenta de servicio de Kafka administrada para project-1 el rol de agente de servicio de Kafka administrado en project-2. Luego, conecta una subred de project-2 al clúster, como se describe en Conecta subredes al clúster.
Para otorgar los roles necesarios, sigue estos pasos:
Console
Determina los Google Cloud proyectos en los que deseas que tus clientes de Kafka accedan al clúster de Managed Service para Apache Kafka.
Para cada proyecto, en la consola de Google Cloud , ve a la página IAM de ese proyecto:
Haz clic en Otorgar acceso.
En el campo Principales nuevas, ingresa lo siguiente:
service-CLUSTER_PROJECT_NUMBER@gcp-sa-managedkafka.iam.gserviceaccount.comReemplaza CLUSTER_PROJECT_NUMBER por el número del proyecto que contiene el clúster de Managed Service para Apache Kafka.
Haz clic en Agregar roles.
En el campo Buscar roles, ingresa
Managed Kafka Service Agent. El nombre del agente de servicio aparece en los resultados de la búsqueda.En los resultados de la búsqueda, selecciona Agente de servicio de Kafka administrado.
Haz clic en Aplicar.
Haz clic en Guardar.
gcloud
Determina los Google Cloud proyectos en los que deseas que tus clientes de Kafka accedan al clúster de Managed Service para Apache Kafka.
Para cada proyecto, ejecuta el comando
gcloud projects add-iam-policy-binding:gcloud projects add-iam-policy-binding CLIENT_PROJECT_ID \ --member=serviceAccount:service-CLUSTER_PROJECT_NUMBER@gcp-sa-managedkafka.iam.gserviceaccount.com \ --role=roles/managedkafka.serviceAgentReemplaza lo siguiente:
- CLIENT_PROJECT_ID: Es el nombre del proyecto que contiene la red de VPC a la que se conectará.
- CLUSTER_PROJECT_NUMBER: El número de proyecto del proyecto que contiene el clúster de Managed Service para Apache Kafka
Usa la VPC compartida para conectar proyectos
La VPC compartida permite que una organización conecte recursos de varios proyectos a una red de VPC común. Para usar la VPC compartida con Managed Service para Apache Kafka, sigue estos pasos:
Crea un clúster de Managed Service para Apache Kafka.
Otorga a la cuenta de servicio de Kafka administrado los roles necesarios en el proyecto host de la VPC compartida, como se describe en la sección anterior.
Conecta el clúster de Managed Service para Apache Kafka a una subred de la red de VPC compartida.
Los clientes del proyecto host de la VPC compartida o de los proyectos de servicio pueden conectarse al clúster.
Para obtener información sobre cuándo usar la VPC compartida en tus arquitecturas de red, consulta Prácticas recomendadas y arquitecturas de referencia para el diseño de VPC.
Conecta clientes a un clúster público
Si tienes aplicaciones cliente fuera de tu red de VPC, puedes activar el acceso público a tu clúster. Un clúster público aún requiere una subred conectada. Sin embargo, no es necesario que envíes tráfico a través de ella.
Cuando activas la función de clúster público, el servicio aprovisiona direcciones IPv4 externas para los extremos de bootstrap y del agente del clúster. El servicio también hace que las entradas de DNS del clúster se puedan resolver públicamente en estas direcciones IP públicas. Esto significa que los clientes externos pueden usar la misma dirección de arranque para ubicar los intermediarios y establecer una conexión. Esta implementación usa el DNS de horizonte dividido. Los clientes en redes de VPC que contienen una subred conectada siguen resolviendo los extremos privados, mientras que los clientes en otras redes resuelven los extremos públicos. Activar la función de clúster público no crea recursos adicionales en tu proyecto de consumidor.
Cuando activas la función de clúster público, debes proporcionar uno o más rangos de IP de origen permitidos. Para obtener más información sobre los límites y los tamaños de rangos permitidos, consulta Clústeres públicos o Limitaciones.
Puedes agregar o quitar rangos de IP de origen permitidos actualizando tu clúster. Managed Service para Apache Kafka usa Cloud Next Generation Firewall para restringir el acceso a los clústeres públicos. La eliminación de los rangos de IP de origen permitidos solo se aplica a las conexiones nuevas (consulta los efectos en el tráfico existente).
El servicio toma varias precauciones para garantizar la seguridad de tus clústeres públicos. Todas las conexiones se encriptan en tránsito con TLS y todas requieren autenticación. Debes autenticarte con una identidad de IAM con SASL o un certificado de cliente con mTLS. No se permite el acceso anónimo. Para obtener más información, consulta Tipos de autenticación para los agentes de Kafka.
Los administradores de seguridad pueden prohibir los clústeres públicos habilitando la restricción de la política de la organización administrada Restringir clústeres públicos de Kafka administrado (constraints/managedkafka.managed.restrictPublicClusters). Para obtener más información sobre las restricciones administradas, consulta Restricciones administradas.
Configura firewalls de salida desde redes externas
En algunos casos, es posible que debas determinar las direcciones IPv4 externas de los extremos de bootstrap y del agente. Para obtener instrucciones sobre cómo recuperar estos valores, consulta Detalles del clúster público.
El servicio pone esta información a disposición de las siguientes maneras:
Las direcciones IPv4 externas asociadas con tu clúster están disponibles en la API de Managed Service para Apache Kafka,
gcloudy Terraform.El servicio mantiene uno o más registros DNS de descubrimiento. Estos son registros
Ade DNS que contienen todas las direcciones IPv4 externas asociadas con tu clúster. Puedes usar estos registros en firewalls basados en FQDN, como Cloud NGFW, que actualizan automáticamente las reglas cuando cambia la lista de extremos. La lista de extremos de descubrimiento está disponible en la API,gcloudy Terraform.
Ten en cuenta lo siguiente cuando uses las direcciones IP públicas asociadas a tu clúster:
La lista de direcciones IPv4 públicas asociadas a tu clúster puede cambiar o crecer. Por este motivo, automatiza la forma en que consumes esta información o define un proceso para tener en cuenta los nuevos registros DNS de descubrimiento cuando aumentes la escala de tu clúster. Los cambios pueden ocurrir en los siguientes casos:
Escalas tu clúster. El aumento de la escala puede agregar una o más direcciones IPv4 externas a medida que se agregan nuevos intermediarios. Para comprender cómo la cantidad de CPU virtuales influye en la cantidad de intermediarios, consulta Tamaño de la subred.
Desactivas y, luego, vuelves a activar la función de clúster público. Esta acción asigna un nuevo conjunto de direcciones IPv4 externas al clúster.
Cada registro DNS de detección contiene un máximo de 30 direcciones IP. Esto se mantiene dentro de los límites comunes que aplican los firewalls de FQDN. Los clústeres con 29 o menos agentes tienen un registro DNS de descubrimiento que contiene 30 direcciones IPv4 externas (incluido el registro de bootstrap). El servicio agrega un registro DNS de descubrimiento por cada 30 agentes adicionales. Para comprender cómo la cantidad de CPU virtuales influye en la cantidad de intermediarios, consulta Tamaño de la subred.
No configures tus clientes de Kafka para que se conecten a los registros DNS de descubrimiento. En cambio, configúralos para que se conecten a la dirección de arranque. Para obtener más información, consulta Limitaciones.
Si usas esta información para configurar firewalls de salida, permite la conectividad a los puertos TCP
9092(SASL) y9192(mTLS).
Arquitectura de red de un clúster
En esta sección, se describen los detalles de la arquitectura de redes que se usa en Managed Service para Apache Kafka.
Un clúster de Kafka abarca una red de arrendatario y una o más redes de consumidores.
En la red del arrendatario, el clúster tiene una sola dirección IP y URL de arranque. Esta dirección de arranque corresponde a un balanceador de cargas conectado a todos los intermediarios del clúster. Cada agente también puede actuar de forma individual como servidor de arranque, pero te recomendamos que uses la dirección de arranque para mayor confiabilidad.
Dentro de cada red del consumidor, el servicio crea un extremo de Private Service Connect para la dirección de arranque y un extremo para cada agente.
La URL de la dirección de arranque es la misma en todas las redes de VPC a las que se conecta un clúster. La dirección IP es local para la red del consumidor.
Los clientes se conectan a los agentes de Kafka con nombres de DNS. Estos nombres se registran automáticamente en cada red de VPC a la que se conecta un clúster de Kafka. La dirección de arranque y su número de puerto están disponibles como una propiedad del clúster.
Los clientes usan la dirección de arranque para recuperar las URLs de los intermediarios. Estas URLs se resuelven en direcciones IP locales para cada red de VPC. Puedes encontrar las direcciones IP y URLs reales del agente en Cloud DNS.
En el siguiente diagrama, se muestra una arquitectura de muestra de una red de clúster de Managed Service para Apache Kafka.
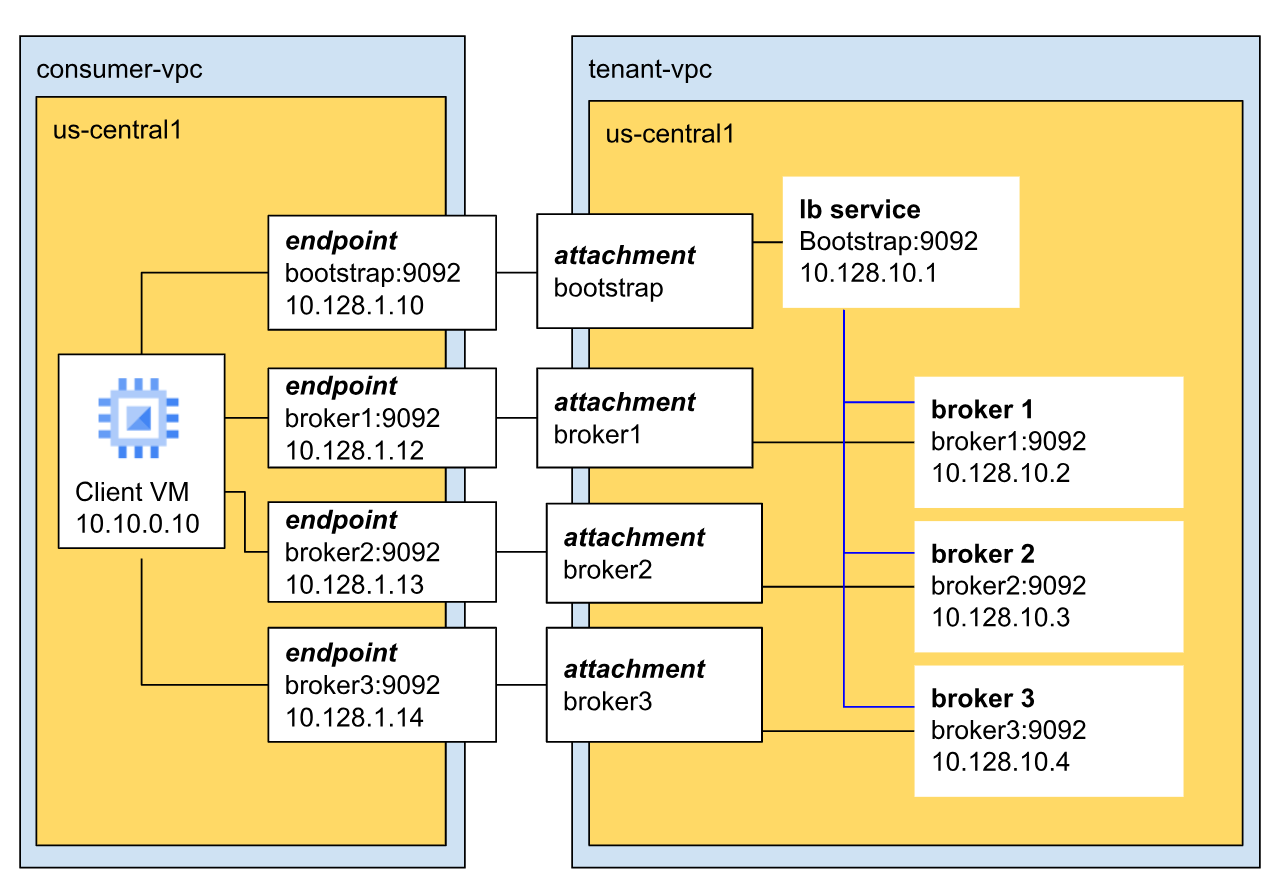 : En este ejemplo, el clúster tiene tres intermediarios y se encuentra en la VPC del arrendatario.
Los agentes se comunican con los clientes a través del puerto predeterminado de Kafka (9092) y tienen direcciones IP únicas. En este ejemplo, los tres agentes tienen las direcciones IP 10.128.10.2, 10.128.10.3 y 10.128.10.4, respectivamente.
Los tres intermediarios se conectan al balanceador de cargas de arranque. Esto garantiza una alta disponibilidad y tolerancia a errores regionales, ya que la dirección de inicio no se limita a un solo agente o zona.
Limitaciones
Se aplican las siguientes limitaciones a las conexiones de VPC y los clústeres públicos:
Región de la subred. Las subredes conectadas deben estar en la misma región que tu clúster.
Recuento de subredes. Puedes conectar un mínimo de una y un máximo de diez subredes a un clúster.
Subredes por red. Puedes conectar como máximo una subred por red de VPC a un clúster.
Tamaño de la subred. Cada subred conectada requiere al menos una dirección IP para cada agente y una dirección IP para la dirección de arranque. Se requiere un mínimo de cuatro direcciones IP utilizables. Para obtener más información, consulta Tamaño de la subred.
Subredes conectadas para clústeres públicos. Para activar el acceso público, tu clúster debe tener al menos una subred conectada, aunque no es necesario que envíes tráfico a través de ella.
Rangos de IP de origen permitidos. Cada rango de IP de origen permitido para un clúster público debe especificarse en la notación CIDR con IPv4. Cada tamaño de subred CIDR debe estar entre
/16y/32. Los rangos de CIDR no deben superponerse. No se admiten direcciones IPv6. Puedes especificar un máximo de 500 rangos de IP de origen permitidos.Resolución de DNS del registro de descubrimiento. Los registros DNS de descubrimiento solo se diseñaron para configurar firewalls de salida basados en FQDN. No configures tus clientes de Kafka para que se conecten a estos registros de descubrimiento. En cambio, configúralos para que se conecten a la dirección de arranque.
Solucionar problemas
Para obtener información sobre cómo solucionar problemas de redes, consulta Errores de redes.
Próximos pasos
Si deseas obtener más información para crear un clúster, consulta Crea un clúster de Managed Service para Apache Kafka.
Para obtener más información sobre cómo actualizar un clúster, consulta Actualiza un clúster de Managed Service para Apache Kafka.
Para obtener más información sobre cómo ver las subredes y los intermediarios activos de un clúster, consulta Cómo ver un clúster.
Para obtener más información sobre cómo publicar y consumir mensajes, consulta Publica y consume mensajes.