


このドキュメントでは、Apache Kafka ワークロードを Managed Service for Apache Kafka に移行する方法について説明します。
このドキュメントで説明するアプローチでは、MirrorMaker 2.0 で Kafka Connect を使用します。Kafka Connect は Kafka を外部システムに接続するためのフレームワークであり、MirrorMaker 2.0 は Kafka クラスタ間でデータをリアルタイムに複製するためのツールです。
アーキテクチャ
次の図は、Managed Service for Apache Kafka にデータを移行するアーキテクチャを示しています。
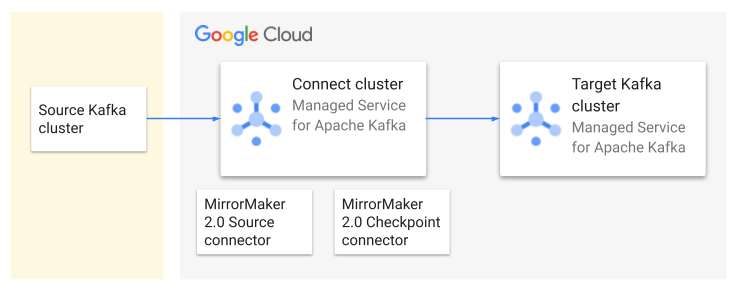
このアーキテクチャは、次のコンポーネントで構成されています。
移行元 Kafka クラスタ: 既存の Kafka クラスタ。オンプレミスまたは別のクラウド環境に配置できます。移行するトピックが含まれています。
ターゲット Kafka クラスタ: Kafka データを移動する Managed Service for Apache Kafka クラスタ。
Connect クラスタ: ターゲット Kafka クラスタに関連付けられている Kafka Connect の分散型デプロイ。
MirrorMaker 2.0 ソースコネクタ: ソースクラスタからターゲット クラスタにトピックを複製します。対応するトピックとパーティションが存在しない場合は、ターゲット クラスタに自動的に作成されます。また、移行元トピックの ACL と一致するように、移行先クラスタのトピック ACL を構成します。
MirrorMaker 2.0 チェックポイント コネクタ。コンシューマー オフセットを複製して、コンシューマーがセカンダリ Kafka クラスタに切り替えて、中断した同じポイントから読み取ることができるようにします。
大まかなワークフロー
このセクションでは、移行プロセスの概要について説明します。
移行を計画する
クラスタのサイズ、トピック、スループット、コンシューマー グループなど、既存の Kafka 設定を文書化します。
アクティブなワークロードを新しいクラスタに切り替える方法など、移行戦略を計画します。
必要なクラスタサイズを見積もります。この計算により、Managed Service for Apache Kafka クラスタの初期サイズが求められます。これにより、ワークロードを実行するのに十分なリソースを確保できます。必要に応じて、後でクラスタをスケールアップできます。
データの移行
Managed Service for Apache Kafka クラスタ、Connect クラスタ、データを複製する MirrorMaker 2.0 コネクタなど、 Google Cloud リソースを作成します。
トピックとコンシューマー グループが複製されていることを確認したら、コンシューマーとプロデューサーを Managed Service for Apache Kafka クラスタに移行します。
新しいクラスタに切り替える
Managed Service for Apache Kafka クラスタを使用して、データの完全性とアプリケーション機能を検証します。
最終的なカットオーバーを実行し、Managed Service for Apache Kafka クラスタにトラフィックをリダイレクトします。
古い Kafka クラスタを廃止します。
監視
Managed Service for Apache Kafka クラスタのパフォーマンスを継続的にモニタリングします。詳細については、Managed Service for Apache Kafka クラスタをモニタリングするをご覧ください。
変更を反映するようにドキュメントを確認して更新します。
Kafka の設定を文書化する
移行を開始する前に、現在の Kafka の設定を文書化します。次の情報を収集します。
Apache Kafka クラスタのバージョンを確認します。MirrorMaker 2.0 では、クラスタのバージョンが 2.4.0 以降である必要があります。
移行する必要があるトピックを特定します。各トピックのレプリケーション係数とパーティション数も文書化します。
クラスタレベルとトピックレベルの両方でメッセージ スループットを測定します。
各トピックに関連付けられているプロデューサーとコンシューマーを特定します。コンシューマーの場合は、すべてのコンシューマー グループを特定します。
コンシューマー構成(特にセキュリティ プロトコルや他の Google Cloud サービスとの統合)を文書化します。
この情報を使用して、Managed Service for Apache Kafka クラスタに必要なサイズを計算し、MirrorMaker 2.0 コネクタの構成設定を選択できます。
移行中の中断を回避するには、移行元の Kafka クラスタに関連するすべてのアプリケーションの依存関係をマッピングします。
移行戦略を計画する
このセクションでは、Kafka データの移行に関する運用上の考慮事項について説明します。移行プロセス中のダウンタイムを最小限に抑えるには、次の戦略を検討してください。
並列デプロイ: 新しいクラスタに切り替える前に、古いクラスタと新しいクラスタの両方でアプリケーションの並列インスタンスを実行します。この移行期間中は、同じメッセージが 2 回処理されることによる意図しない結果を防ぐため、メッセージごとに 1 回だけ実行する必要があるアプリ内のアクションを一時的に無効にします。新しいインスタンスが完全に追いついたら、すべてのトラフィックを新しいクラスタにリダイレクトし、すべての機能を再度有効にします。
段階的なロールアウト: 重要度の低いアプリケーションから始めて、管理しやすい小さなフェーズで移行します。このアプローチにより、潜在的な問題を特定し、中断の影響を最小限に抑えることができます。
Blue/Green デプロイ: 既存の環境(青)とともに、本番環境(緑)の完全なレプリカを作成します。トラフィックを Blue から Green に徐々に移行します。最終カットオーバーの前に、新しい本番環境をテストして検証します。このアプローチではダウンタイムを最小限に抑えることができますが、移行中に多くのリソースが必要になります。
ドライラン。本番環境を移行する前に、開発環境でテスト移行を実施します。プロセスを検証し、潜在的な問題を特定します。
移行を計画する際のその他の考慮事項は次のとおりです。
メッセージ処理の要件: アプリケーションで重複または欠落したメッセージが許容される範囲を把握し、それに応じてコンシューマーを構成します。
コミュニケーションと調整: 明確なコミュニケーション チャネルを確立し、切り替えのタイミングを調整します。
Rollback で終了しません。必要に応じて元のクラスタに戻すためのロールバック プランを作成します。
クラスタのサイズを見積もる
Managed Service for Apache Kafka クラスタに必要なメモリと vCPU の数を見積もるには、まずワークロードの合計書き込みスループットと読み取りスループットを計算します。次の JMX 指標を使用して、これらの値を測定できます。
kafka.server:type=BrokerTopicMetrics,name=BytesInPerSec: すべてのトピックのクライアントからの受信バイトレート。すべてのトピックの集計レートを取得するには、topic={...}パラメータを省略します。kafka.server:type=BrokerTopicMetrics,name=BytesOutPerSec: すべてのトピックのクライアントへの送信バイトレート。全体的なレートを取得するには、topic={...}パラメータを省略します。
これらの指標はブローカー レベルで報告されます。クラスタのスループットを計算するには、すべてのブローカーのデータを集計します。
これらの JMX 指標を一定期間モニタリングすることで、次の指標を計算するためのデータポイントを収集できます。
平均データ入力(MBps): データが Kafka クラスタに取り込まれる平均速度。
ピーク データ(MBps): Kafka クラスタにデータが取り込まれる最大レート。
平均データ出力(MBps): Kafka クラスタからデータが消費される平均レート。
ピーク データ出力(MBps): Kafka クラスタからデータが消費される最大レート。
これらの計算値を使用して、次のように書き込み相当率を推定します。
Write-equivalent rate (Avg/Peak) = (total write bandwidth) + (total read bandwidth / 4)
書き込み相当レートは、読み取り帯域幅の方が書き込み帯域幅よりも処理効率が高いことを考慮しています。書き込み相当率を使用して、Managed Service for Apache Kafka クラスタの適切なサイズを選択します。詳細については、Kafka クラスタのサイズを計画するをご覧ください。
オンプレミスの Apache Kafka を Google Cloudに接続する
ソースの Apache Kafka クラスタがオンプレミスにある場合は、オンプレミス ネットワークと Managed Service for Apache Kafka クラスタが存在する Virtual Private Cloud(VPC)の間に安全な接続を確立する必要があります。 Google Cloudから次のいずれかのオプションを使用します。
Cloud VPN: 帯域幅のニーズが低い場合や、移行の初期テストに適した費用対効果の高いソリューション。公共のインターネット上に暗号化されたトンネルを構築します。Cloud VPN の詳細については、Cloud VPN の概要をご覧ください。
Cloud Interconnect: オンプレミス ネットワークと Google Cloudの間に専用の高帯域幅接続を提供します。これは、高スループットと低レイテンシを必要とするエンタープライズ グレードのデプロイに最適です。Dedicated Interconnect(物理的な直接接続)または Partner Interconnect(サポートされているサービス提供者を介した接続)のいずれかを選択できます。詳細については、Cloud Interconnect の概要をご覧ください。
Managed Service for Apache Kafka クラスタを作成するときは、VPC ネットワークで少なくとも 1 つのサブネットを選択する必要があります。このサブネットは、クラスタが VPC ネットワーク内の他のリソースとの通信に使用する IP アドレスを提供します。
オンプレミス ネットワークまたは他の VPC ネットワークから Managed Service for Apache Kafka クラスタに安全に接続するには、Cloud VPN または Cloud Interconnect 経由で Private Service Connect を使用します。Private Service Connect エンドポイントを明示的に設定する必要はありません。クラスタの作成時にサブネットを選択すると、Managed Service for Apache Kafka サービスは必要な Private Service Connect エンドポイントを自動的に作成します。これにより、複雑なファイアウォール ルールやパブリック IP アドレスを管理することなく、VPC ネットワーク内の内部 IP アドレスを使用してクラスタにアクセスできるため、ネットワーク構成が簡素化されます。
詳細については、Managed Service for Apache Kafka のネットワーキングをご覧ください。
Google Cloud リソースを作成する
次のリソースを作成します。
Managed Service for Apache Kafka クラスタ。詳細については、Managed Service for Apache Kafka クラスタを作成して表示するをご覧ください。
プライマリ Kafka クラスタが前の手順で作成したクラスタである Connect クラスタ。詳細については、Connect クラスタを作成するをご覧ください。
Connect クラスタは、Managed Service for Apache Kafka クラスタと同じリージョンに配置します。
データを複製する MirrorMaker 2.0 ソースコネクタ。詳細については、MirrorMaker 2.0 ソース コネクタを作成するをご覧ください。
コンシューマー チェックポイントを複製する MirrorMaker 2.0 チェックポイント コネクタ。詳細については、MirrorMaker 2.0 チェックポイント コネクタを作成するをご覧ください。
MirrorMaker 2.0 の設定
次の設定は、チェックポイントが作成および複製される頻度を決定します。これは、クラスタ間のコンシューマー オフセット変換の精度に影響する可能性があります。
コンシューマ:
auto.commit.interval.ms: コンシューマーがオフセットを commit する頻度。
MirrorMaker 2.0 ソース コネクタ:
offset.lag.max: ソース コネクタがオフセット同期を書き込む頻度。
MirrorMaker 2.0 チェックポイント コネクタ:
sync.group.offsets.enabled:trueの場合、Checkpoint コネクタは内部トピックからコンシューマーが使用する__consumer_offsetsトピックにチェックポイントをコピーします。コンシューマーがシームレスにフェイルオーバーできるようにするには、このプロパティをtrueに設定します。emit.checkpoints.interval.seconds: Checkpoint コネクタがチェックポイントを書き込む頻度。sync.group.offsets.interval.seconds: Checkpoint コネクタがチェックポイントを__consumer_offsetsにコピーする頻度。
詳細については、MirrorMaker 2.0 チェックポイント コネクタの仕組みをご覧ください。
データ レプリケーションをモニタリングする
MirrorMaker 2.0 プロセスをモニタリングして、正しく実行され、データが想定どおりに複製されていることを確認します。詳細については、Connect クラスタをモニタリングするをご覧ください。
アプリケーションの移行後、次の指標をモニタリングして、移行が成功したことを確認します。
下り(ダウンストリーム)スループット レート: 下り(ダウンストリーム)スループット レートに大きな変化がないことを確認します。
CPU とメモリの使用率: Managed Service for Apache Kafka クラスタの CPU とメモリの使用率をモニタリングします。詳細については、信頼性を確保するために Kafka クラスタをモニタリングするをご覧ください。
エラーログ: Cloud Logging で、Managed Service for Apache Kafka クラスタまたはアプリケーションに関連するエラーログを定期的に確認します。
次のステップ
- Kafka Connect の概要
- MirrorMaker 2.0 を使用して Kafka トピックを複製する
- Managed Service for Apache Kafka クラスタをモニタリングする