


שימוש
explore: explore_name {
  aggregate_table: table_name {

    query:  {
      dimensions: [dimension1, dimension2, ... ]
      measures: [measure1, measure2, ... ]
      sorts: [field1: asc, field2: desc, ... ]
      filters: [field1: "value1", field2: "value2", ... ]
      timezone: timezone
    }

    materialization:  {
      ...
    }
  }

  ...

}
|
היררכיה
aggregate_table |
ערך ברירת המחדל
ללא
אמצעי תשלום מקובלים
שם לטבלה המסכמת, תת-הפרמטר query להגדרת הטבלה ותת-הפרמטר materialization להגדרת אסטרטגיית השמירה של הטבלה
כללים מיוחדים
|
הגדרה
הפרמטר aggregate_table משמש ליצירת טבלאות מסכמות שיצמצמו את מספר השאילתות שנדרשות לטבלאות הגדולות במסד הנתונים.
Looker משתמש בלוגיקה של מודעות לצבירת נתונים כדי למצוא את הטבלה המסכמת הקטנה והיעילה ביותר שזמינה במסד הנתונים שלכם להרצת שאילתה, תוך שמירה על הדיוק. (עיין בדף התיעוד בנושא מודעוּת לצבירת נתונים לקבלת סקירה כללית ואסטרטגיות ליצירת טבלאות מסכמות).
אם יש לכם טבלאות גדולות מאוד במסד הנתונים, אתם יכולים ליצור טבלאות מסכמות קטנות יותר של נתונים, שמקובצות לפי שילובים שונים של מאפיינים. הטבלאות המסכמות פועלות כטבלאות סיכום או סיכום ביניים ש-Looker יכול להשתמש בהן לשאילתות כשאפשר, במקום הטבלה הגדולה המקורית.
אחרי שיוצרים את הטבלאות המסכמות, אפשר להריץ שאילתות בכלי הניתוחים כדי לראות באילו טבלאות מסכמות Looker משתמש. מידע נוסף זמין בקטע Determining which aggregate table is used for a query בדף התיעוד Aggregate awareness.
בקטע פתרון בעיות בדף התיעוד מודעוּת לצבירת נתונים מפורטות סיבות נפוצות לכך שלא נעשה שימוש בטבלאות מסכמות.
הגדרת טבלה מסכמת ב-LookML
לכל פרמטר aggregate_table צריך להיות שם ייחודי בתוך explore נתון.
הפרמטר aggregate_table כולל את תתי-הפרמטרים query ו-materialization.
query
הפרמטר query מגדיר את השאילתה לטבלה המסכמת, כולל המאפיינים והמדדים שבהם צריך להשתמש. הפרמטר query כולל את תתי-הפרמטרים הבאים:
| שם הפרמטר | תיאור | דוגמה |
|---|---|---|
dimensions |
רשימה מופרדת בפסיקים של המאפיינים מהניתוח שרוצים לכלול בטבלה המסכמת. השדה dimensions הוא בפורמט הבא: dimensions: [dimension1, dimension2, ...]
כל מאפיין ברשימה הזו צריך להיות מוגדר כ-dimension בקובץ התצוגה של ה-Explore של השאילתה. אם רוצים לכלול שדה שמוגדר כשדה filter בשאילתה של Explore, אפשר להוסיף אותו לרשימה filters בשאילתה של הטבלה המסכמת.
|
dimensions: [orders.created_month, orders.country] |
measures |
רשימה מופרדת בפסיקים של המדדים מ-Explore שרוצים לכלול בטבלה המסכמת. השדה measures הוא בפורמט הבא: measures: [measure1, measure2, ...]
למידע על סוגי המדדים שנתמכים במודעות מצטברת, עיינו בקטע גורמים של סוגי מדדים בדף התיעוד בנושא מוּדעוּת מצטברת.
|
measures: [orders.count] |
filters |
אפשר להוסיף מסנן ל-query. המסננים מתווספים לסעיף WHERE של ה-SQL שיוצר את הטבלה המסכמת.
השדה filters הוא בפורמט הבא: filters: [field1: "value1", field2: "value2", ...]
כדי להבין איך מסננים יכולים למנוע שימוש בטבלה המסכמת, קראו את הקטע גורמי סינון בדף התיעוד בנושא מודעות לצבירת נתונים. |
filters: [orders.country: "United States", orders.state: "California"]
|
sorts |
אופציונלי, מציין את שדות המיון ואת כיוון המיון (בסדר עולה או בסדר יורד) של query.
השדה sorts הוא בפורמט הבא: sorts: [field1: asc|desc, field2: asc|desc, ...]
|
[orders.country: asc, orders.state: desc] |
timezone |
הגדרת אזור הזמן של query. אם לא מציינים אזור זמן, הטבלה המסכמת לא תבצע המרה של אזור הזמן, ובמקום זאת תשתמש באזור הזמן של מסד הנתונים.
כדי לקבל מידע על הגדרת אזור הזמן כך שהטבלה המסכמת תשמש כמקור לשאילתה, עיינו בקטע גורמים של אזור זמן בדף התיעוד מוּדעוּת לצבירת נתונים.
סביבת הפיתוח המשולבת (IDE) מציעה באופן אוטומטי את ערך אזור הזמן כשמקלידים את הפרמטר timezone ב-IDE. ב-IDE מוצגת גם רשימה של ערכי אזורי הזמן הנתמכים בחלונית העזרה המהירה. |
timezone: America/Los_Angeles |
materialization
הפרמטר materialization מציין את אסטרטגיית השמירה של הטבלה המסכמת, וגם אפשרויות אחרות להפצה, לחלוקה למחיצות, לאינדקסים ולאשכולות שעשויות להיתמך על ידי ניב ה-SQL שלכם.
כדי שהטבלה המסכמת תהיה נגישה למודעות למאגר נתונים, היא צריכה להיות שמורה במסד הנתונים. הפרמטר materialization של הטבלה המסכמת חייב לכלול את אחד מתת-הפרמטרים הבאים כדי לציין את אסטרטגיית השמירה:
datagroup_triggersql_trigger_valuepersist_for(לא מומלץ)
בנוסף, יכול להיות שהטבלה המסכמת תתמוך בתת-הפרמטרים הבאים של materialization, בהתאם לניב ה-SQL שלכם:
כדי ליצור טבלה מסכמת מצטברת, משתמשים בתת-הפרמטרים הבאים של materialization:
datagroup_trigger
משתמשים בפרמטר datagroup_trigger כדי להפעיל את היצירה מחדש של הטבלה המסכמת על סמך קבוצת נתונים קיימת שמוגדרת בקובץ המודל:
explore: event {
  aggregate_table: monthly_orders {
    materialization: {
      datagroup_trigger: order_datagroup
    }
    query: {
      ...
    }
  }
  ...
}
sql_trigger_value
משתמשים בפרמטר sql_trigger_value כדי להפעיל את היצירה מחדש של הטבלה המסכמת על סמך הצהרת SQL שאתם מספקים. אם התוצאה של הצהרת ה-SQL שונה מהערך הקודם, הטבלה נוצרת מחדש. ההצהרה הזו של sql_trigger_value תפעיל יצירה מחדש כשהתאריך ישתנה:
explore: event {
  aggregate_table: monthly_orders {
    materialization: {
      sql_trigger_value: SELECT CURDATE() ;;
    }
    query: {
      ...
    }
  }
  ...
}
persist_for
הפרמטר persist_for נתמך גם בטבלאות מסכמות. עם זאת, יכול להיות ששיטת הבידינג persist_for לא תניב את הביצועים הטובים ביותר מבחינת המודעות המצטברת. הסיבה לכך היא שכאשר משתמש מריץ שאילתה שמסתמכת על טבלת persist_for, Looker בודק את גיל הטבלה בהשוואה להגדרה של persist_for. אם הטבלה ישנה יותר מההגדרה persist_for, הטבלה נוצרת מחדש לפני הרצת השאילתה. אם הגיל קטן מההגדרה persist_for, המערכת משתמשת בטבלה הקיימת. לכן, אלא אם משתמש מריץ שאילתה בתוך פרק הזמן של persist_for, צריך לבנות מחדש את הטבלה המסכמת לפני שאפשר יהיה להשתמש בה למודעות מצטברת.
explore: event {
  aggregate_table: monthly_orders {
    materialization: {
      persist_for: "90 minutes"
    }
    query: {
      ...
    }
  }
  ...
}
אם אתם לא מבינים את המגבלות ואין לכם תרחיש שימוש ספציפי להטמעה של persist_for, עדיף להשתמש ב-datagroup_trigger או ב-sql_trigger_value כאסטרטגיית שמירה של טבלאות מסכמות.
cluster_keys
הפרמטר cluster_keys מאפשר להוסיף עמודה מקובצת לטבלאות מחולקות למחיצות ב-BigQuery או ב-Snowflake. באשכולות, הנתונים ממוינים במחיצה שמבוססת על הערכים בעמודות המקובצות, והעמודות המקובצות מאורגנות בבלוקים של אחסון בגודל אופטימלי.
מידע נוסף זמין בדף התיעוד של הפרמטר cluster_keys.
distribution
הפרמטר distribution מאפשר לציין את העמודה מטבלה מסכמת שעליה רוצים להחיל מפתח הפצה. distribution פועל רק עם מסדי הנתונים Redshift ו-Aster. בניבים אחרים של SQL (כמו MySQL ו-Postgres), צריך להשתמש במקום זאת ב-indexes.
מידע נוסף זמין בדף התיעוד של הפרמטר distribution.
distribution_style
הפרמטר distribution_style מאפשר לציין איך השאילתה של טבלה מסכמת מופצת בין הצמתים במסד נתונים של Redshift:
distribution_style: allמציין שכל השורות מועתקות במלואן לכל צומת.distribution_style: evenמציין חלוקה שווה, כך שהשורות מחולקות לצמתים שונים בשיטת רובין סבב.
מידע נוסף זמין בדף התיעוד של הפרמטר distribution_style.
indexes
הפרמטר indexes מאפשר להחיל אינדקסים על העמודות של טבלה מסכמת.
מידע נוסף זמין בדף התיעוד של הפרמטר indexes.
partition_keys
הפרמטר partition_keys מגדיר מערך של עמודות שלפיהן הטבלה המסכמת תחולק למחיצות. partition_keys תומך בדיאלקטים של מסדי נתונים שמאפשרים לחלק עמודות למחיצות. כשמריצים שאילתה שמסוננת לפי עמודה מחולקת למחיצות, מסד הנתונים סורק רק את המחיצות שכוללות את הנתונים המסוננים, במקום לסרוק את כל הטבלה. הפונקציה partition_keys נתמכת רק בדיאלקטים של Presto ו-BigQuery.
מידע נוסף זמין בדף התיעוד של הפרמטר partition_keys.
publish_as_db_view
הפרמטר publish_as_db_view מאפשר לסמן טבלה מסכמת כדי לשלוח אליה שאילתות מחוץ ל-Looker. בטבלאות צבירת נתונים שבהן publish_as_db_view מוגדר ל-yes, Looker יוצר תצוגת מסד נתונים יציבה במסד הנתונים של טבלת צבירת הנתונים. תצוגת מסד הנתונים היציבה נוצרת במסד הנתונים עצמו, כך שאפשר להריץ עליה שאילתות מחוץ ל-Looker.
מידע נוסף זמין בדף התיעוד של הפרמטר publish_as_db_view.
sortkeys
הפרמטר sortkeys מאפשר לציין עמודה אחת או יותר של טבלה מסכמת שעליה רוצים להחיל מפתח מיון רגיל.
מידע נוסף זמין בדף התיעוד של הפרמטר sortkeys.
increment_key
אתם יכולים ליצור טבלאות PDT מצטברות בפרויקט אם הניב תומך בהן. טבלת PDT מצטברת היא טבלה נגזרת מתמידה (PDT) ש-Looker יוצר על ידי הוספת נתונים חדשים לטבלה, במקום ליצור מחדש את הטבלה כולה. מידע נוסף זמין בדף התיעוד טבלאות PDT מצטברות.
טבלאות מסכמות הן סוג של PDT, ואפשר לבנות אותן באופן מצטבר על ידי הוספת הפרמטר increment_key. הפרמטר increment_key מציין את מרווח הזמן שבו צריך לשלוח שאילתה לגבי נתונים עדכניים ולהוסיף אותם לטבלה המסכמת.
מידע נוסף זמין בדף התיעוד של הפרמטר increment_key.
increment_offset
הפרמטר increment_offset מגדיר את מספר התקופות הקודמות (ברמת הפירוט של מפתח ההגדלה) שייבנו מחדש כשמצרפים נתונים לטבלה המסכמת. הפרמטר increment_offset הוא אופציונלי לטבלאות מצטברות ולטבלאות PDT מצטברות.
מידע נוסף זמין בדף התיעוד של הפרמטר increment_offset.
איך מקבלים LookML של טבלה מסכמת מ-Explore
כדי לקצר את התהליך, מפתחים ב-Looker יכולים להשתמש בשאילתת Explore כדי ליצור טבלה מסכמת, ואז להעתיק את ה-LookML לפרויקט LookML:
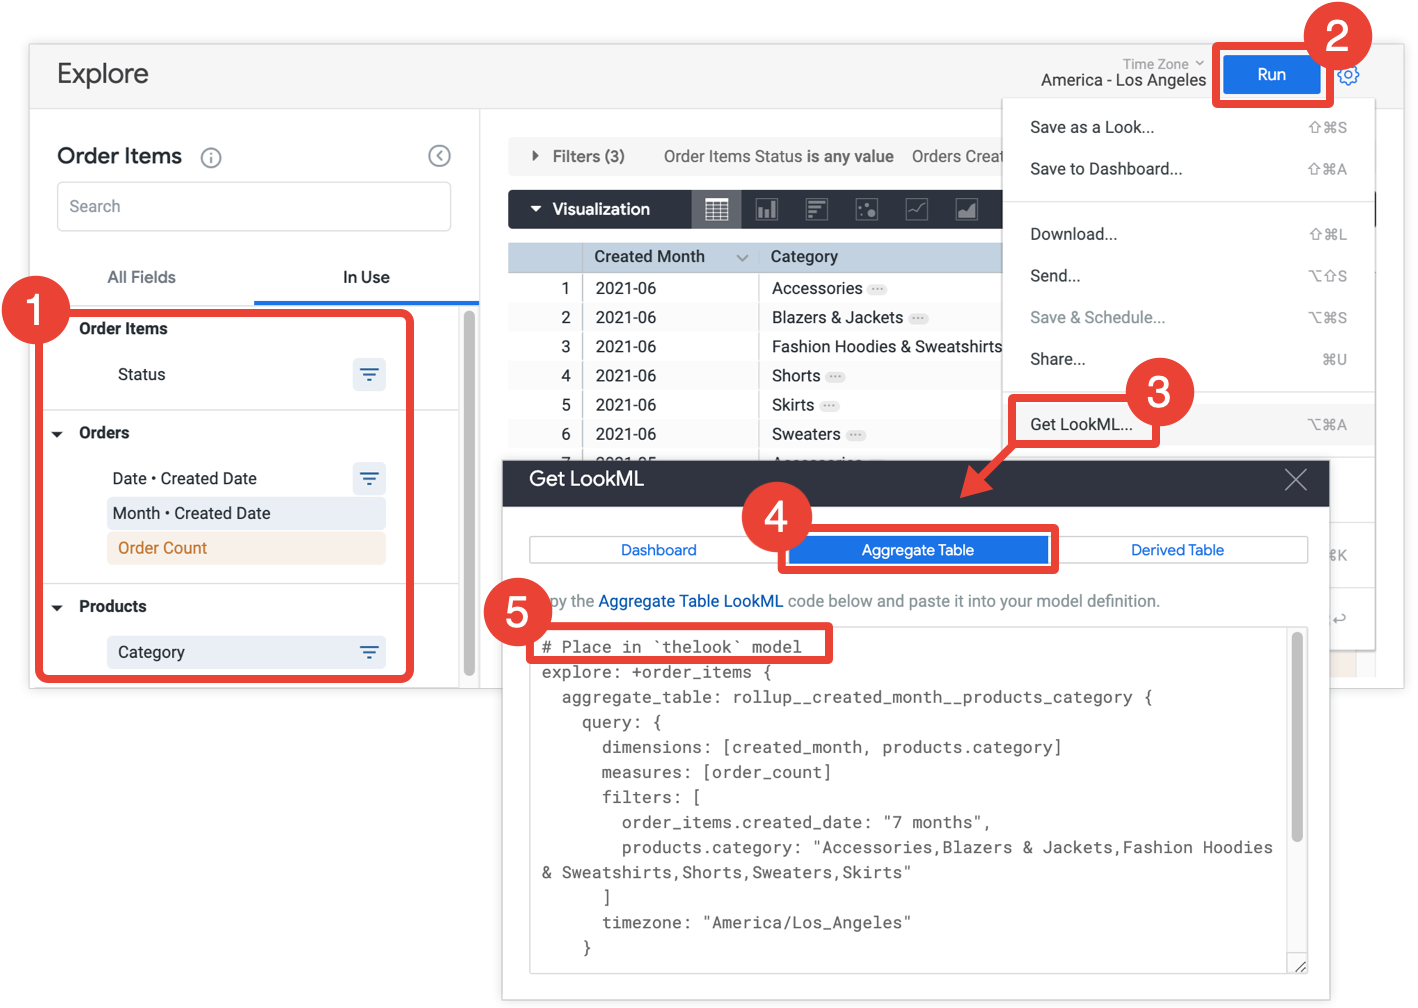
- ב-Explore, בוחרים את כל השדות והמסננים שרוצים לכלול בטבלה המסכמת.
- לוחצים על Run כדי לקבל את התוצאות.
- בתפריט גלגל השיניים של Explore, בוחרים באפשרות Get LookML. האפשרות הזו זמינה רק למפתחים ב-Looker.
- לוחצים על הכרטיסייה טבלה מסכמת.
- Looker מספק את ה-LookML לעידון של Explore שיוסיף את הטבלה המסכמת ל-Explore. מעתיקים את ה-LookML ומדביקים אותו בקובץ המודל המשויך, שמצוין בהערה שלפני ה-Explore refinement. אם ה-Explore מוגדר בקובץ Explore נפרד ולא בקובץ מודל, אפשר להוסיף את ה-refinement לקובץ של ה-Explore במקום לקובץ המודל. אפשר להשתמש בכל אחד מהמיקומים.
אם אתם צריכים לשנות את ה-LookML של הטבלה המסכמת, אתם יכולים לעשות את זה באמצעות הפרמטרים שמתוארים בקטע הגדרת טבלה מסכמת ב-LookML בדף הזה. אתם יכולים לשנות את השם של הטבלה המסכמת בלי לשנות את הרלוונטיות שלה לשאילתה המקורית בכלי הניתוחים. עם זאת, כל שינוי אחר בטבלה המסכמת עשוי להשפיע על היכולת של Looker להשתמש בטבלה המסכמת לשאילתת ה-Explore. בקטע עיצוב טבלאות מסכמות בדף התיעוד מוּדעוּת לצבירה מופיעים טיפים לאופטימיזציה של טבלאות מסכמות, כדי לוודא שהן משמשות למוּדעוּת לצבירה.
איך מקבלים LookML של טבלה מסכמת ממרכז בקרה
אפשרות נוספת למפתחי Looker היא לקבל את ה-LookML של הטבלה המסכמת לכל המשבצות במרכז בקרה, ואז להעתיק את ה-LookML לפרויקט LookML.
יצירת טבלאות מסכמות יכולה לשפר באופן משמעותי את הביצועים של לוח הבקרה, במיוחד עבור משבצות ששולחות שאילתות למערכי נתונים עצומים.
אם יש לכם הרשאת develop, אתם יכולים לקבל את LookML כדי ליצור טבלאות צבירה למרכז בקרה. פותחים את מרכז הבקרה, בוחרים באפשרות Get LookML (קבלת LookML) מתפריט שלוש הנקודות של מרכז הבקרה, ובוחרים בכרטיסייה Aggregate Tables (טבלאות צבירה):
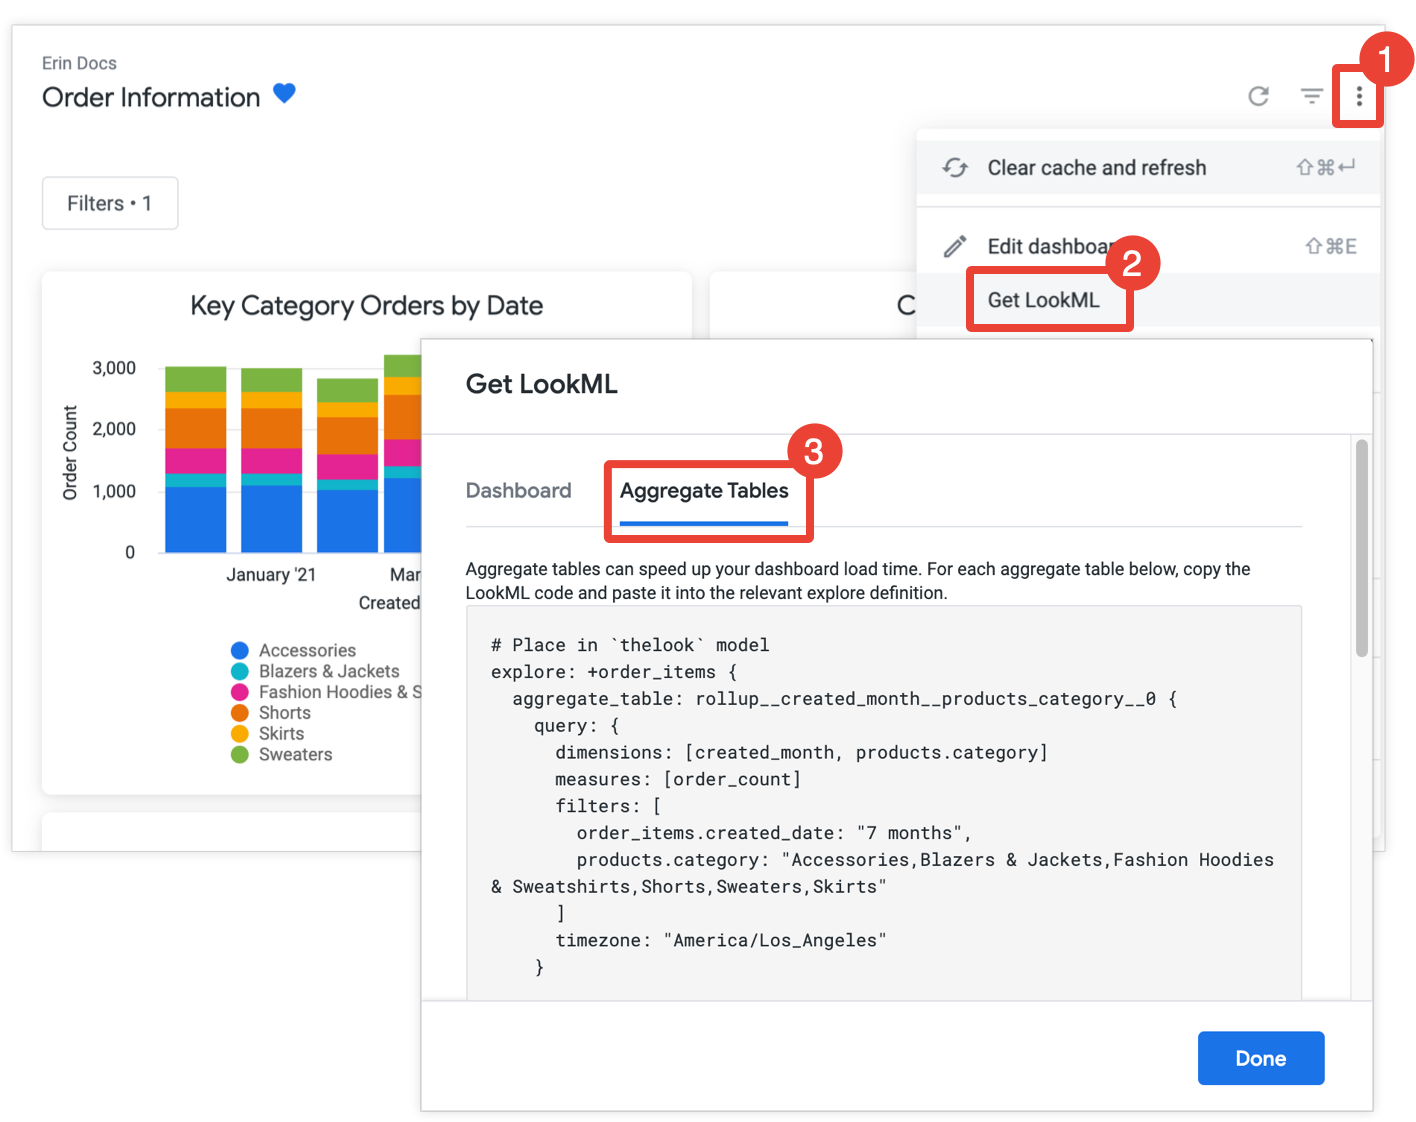
לכל משבצת שעדיין לא עברה אופטימיזציה באמצעות מודעות מצטברת, Looker מספק את LookML עבור עידון של Explore שיוסיף את הטבלה המסכמת ל-Explore. אם מרכז הבקרה כולל כמה משבצות מאותו Explore, Looker מכניס את כל הטבלאות המסכמות ל-Explore refinement אחד. כדי לצמצם את מספר הטבלאות המסכמות שנוצרות, Looker בודק אם אפשר להשתמש בטבלה מסכמת שנוצרה ביותר ממשבצת אחת. אם כן, הוא מסיר את כל הטבלאות המסכמות המיותרות שאפשר להשתמש בהן בפחות משבצות.
מעתיקים ומדביקים כל שיפור של Explore בקובץ המודל המשויך, שמצוין בהערה שלפני השיפור של Explore. אם ה-Explore מוגדר בקובץ Explore נפרד ולא בקובץ מודל, אפשר להוסיף את השיפור לקובץ ה-Explore במקום לקובץ המודל. אפשר להשתמש בכל אחד מהמיקומים.
אם מסנן של מרכז בקרה מוחל על משבצת, Looker יוסיף את המאפיין של המסנן לטבלה המסכמת של המשבצת, כדי שיהיה אפשר להשתמש בטבלה המסכמת במשבצת. הסיבה לכך היא שאפשר להשתמש בטבלאות מסכמות בשאילתה רק אם המסננים של השאילתה מפנים לשדות שזמינים כמאפיינים בטבלה המסכמת. מידע נוסף זמין בדף התיעוד בנושא מודעות מצטברת.
אם אתם צריכים לשנות את ה-LookML של הטבלה המסכמת, אתם יכולים לעשות את זה באמצעות הפרמטרים שמתוארים בקטע הגדרת טבלה מסכמת ב-LookML בדף הזה. אתם יכולים לשנות את השם של הטבלה המסכמת בלי לשנות את הרלוונטיות שלה למשבצת המקורית בלוח הבקרה, אבל כל שינוי אחר בטבלה המסכמת עלול להשפיע על היכולת של Looker להשתמש בטבלה המסכמת בלוח הבקרה. בקטע עיצוב טבלאות מסכמות בדף התיעוד מוּדעוּת לצבירה מופיעים טיפים לאופטימיזציה של טבלאות מסכמות, כדי לוודא שהן משמשות למוּדעוּת לצבירה.
דוגמה
בדוגמה הבאה נוצרת טבלה מסכמת של monthly_orders ל-Explore של event. הטבלה המסכמת יוצרת ספירה חודשית של הזמנות. Looker ישתמש בטבלה המסכמת לשאילתות של ספירת הזמנות שיכולות להשתמש ברמת הפירוט החודשית, כמו שאילתות לספירת הזמנות שנתית, רבעונית וחודשית.
הטבלה המסכמת מוגדרת עם שמירת נתונים באמצעות קבוצת הנתונים orders_datagroup. בנוסף, הטבלה המסכמת מוגדרת עם publish_as_db_view: yes, כלומר Looker תיצור תצוגה יציבה של מסד הנתונים במסד הנתונים של הטבלה המסכמת.
ההגדרה של הטבלה המסכמת נראית כך:
explore: event {
  aggregate_table: monthly_orders {
    materialization: {
      datagroup_trigger: orders_datagroup
      publish_as_db_view: yes
    }
    query: {
      dimensions: [orders.created_month]
      measures: [orders.count]
      filters: [orders.created_date: "1 year", orders.status: "fulfilled"]
      timezone: America/Los_Angeles
    }
  }
}
מה כדאי לקחת בחשבון?
בקטע עיצוב טבלאות מסכמות בדף התיעוד מוּדעוּת לצבירת נתונים מפורטים טיפים ליצירת טבלאות מסכמות באופן אסטרטגי:
- גורמים שקשורים למסגרת הזמן
- גורמים שקשורים לאזור הזמן
- גורמי סינון
- גורמים בשטח
- גורמים שקשורים לסוג המדידה
תמיכה בניבים למודעות לצבירה
האפשרות להשתמש במודעות לצבירת נתונים תלויה בניב של מסד הנתונים שבו משתמש החיבור שלכם ל-Looker. בגרסה האחרונה של Looker, הניבים הבאים תומכים במודעות לצבירת נתונים:
| ניב | יש תמיכה? |
|---|---|
| Actian Avalanche | |
| Amazon Athena | |
| Amazon Aurora MySQL | |
| Amazon Redshift | |
| Amazon Redshift 2.1+ | |
| Amazon Redshift Serverless 2.1+ | |
| Apache Druid | |
| Apache Druid 0.13.x - 0.17.x | |
| Apache Druid 0.18+ | |
| Apache Hive 2.3+ | |
| Apache Hive 3.1.2+ | |
| Apache Spark 3+ | |
| ClickHouse | |
| ClickHouse 26+ | |
| Cloudera Impala 3.1+ | |
| Cloudera Impala 3.1+ with Native Driver | |
| Cloudera Impala with Native Driver | |
| DataVirtuality | |
| Databricks | |
| Denodo 7 | |
| Denodo 8 & 9 | |
| Dremio | |
| Dremio 11+ | |
| Dremio 26+ with Arrow Flight SQL | |
| Exasol | |
| Google BigQuery Legacy SQL | |
| Google BigQuery Standard SQL | |
| Google Cloud AlloyDB for PostgreSQL | |
| Google Cloud PostgreSQL | |
| Google Cloud SQL | |
| Google Spanner | |
| Greenplum | |
| HyperSQL | |
| IBM Netezza | |
| MariaDB | |
| Microsoft Azure PostgreSQL | |
| Microsoft Azure SQL Database | |
| Microsoft Azure Synapse Analytics | |
| Microsoft SQL Server 2008+ | |
| Microsoft SQL Server 2012+ | |
| Microsoft SQL Server 2016 | |
| Microsoft SQL Server 2017+ | |
| MongoBI | |
| MongoSQL | |
| MySQL | |
| MySQL 8.0.12+ | |
| Oracle | |
| Oracle ADWC | |
| PostgreSQL 9.5+ | |
| PostgreSQL pre-9.5 | |
| PrestoDB | |
| PrestoSQL | |
| SAP HANA | |
| SAP HANA 2+ | |
| SingleStore | |
| SingleStore 7+ | |
| Snowflake | |
| Teradata | |
| Trino | |
| Vector | |
| Vertica |