


Descripción general
Looker utiliza la lógica de reconocimiento de agregaciones para encontrar la tabla más pequeña y eficiente disponible en tu base de datos para ejecutar una consulta y, al mismo tiempo, mantener la exactitud.
Para tablas muy grandes en tu base de datos, los desarrolladores de Looker pueden crear tablas de datos agregados más pequeñas, agrupadas según varias combinaciones de atributos. Las tablas de datos agregados actúan como resúmenes o tablas de resumen que Looker puede usar para las consultas siempre que sea posible, en lugar de la tabla grande original. Cuando se implementa de forma estratégica, este reconocimiento puede acelerar una consulta típica en órdenes de magnitud.
Por ejemplo, podrías tener una tabla de datos a escala de petabytes con una fila para cada pedido que se haya realizado en tu sitio web. A partir de esta base de datos, puedes crear una tabla de datos agregados con tus totales de ventas diarias. Si tu sitio web recibe 1,000 pedidos por día, tu tabla de datos agregados diaria representaría cada día con 999 filas menos que la tabla original. Puedes crear otra tabla de datos agregados con los totales de ventas mensuales que será aún más eficiente. Ahora, si un usuario ejecuta una consulta para las ventas diarias o semanales, Looker usará la tabla de totales de ventas diarias. Si un usuario ejecuta una consulta sobre las ventas anuales y no tienes una tabla de datos agregados anual, Looker usará la siguiente mejor opción, que es la tabla de datos agregados de ventas mensuales en este ejemplo.
Looker responde las preguntas de los usuarios con las tablas de datos agregados más pequeñas siempre que sea posible. Por ejemplo:
- Para una consulta sobre las ventas mensuales totales, Looker usa la tabla de datos agregados basada en las ventas mensuales (
sales_monthly_aggregate_table). - Para una consulta sobre el total de cada venta en un día, no hay una tabla de datos agregados con esa granularidad, por lo que Looker obtiene los resultados de la consulta de la tabla de la base de datos original (
orders_database). (Sin embargo, si tus usuarios ejecutan este tipo de consulta con frecuencia, podrías crear una tabla de datos agregados para ella). - Para una consulta sobre las ventas semanales, no hay una tabla de datos agregados semanal, por lo que Looker usa la siguiente mejor opción, que es la tabla de datos agregados basada en las ventas diarias (
sales_daily_aggregate_table).
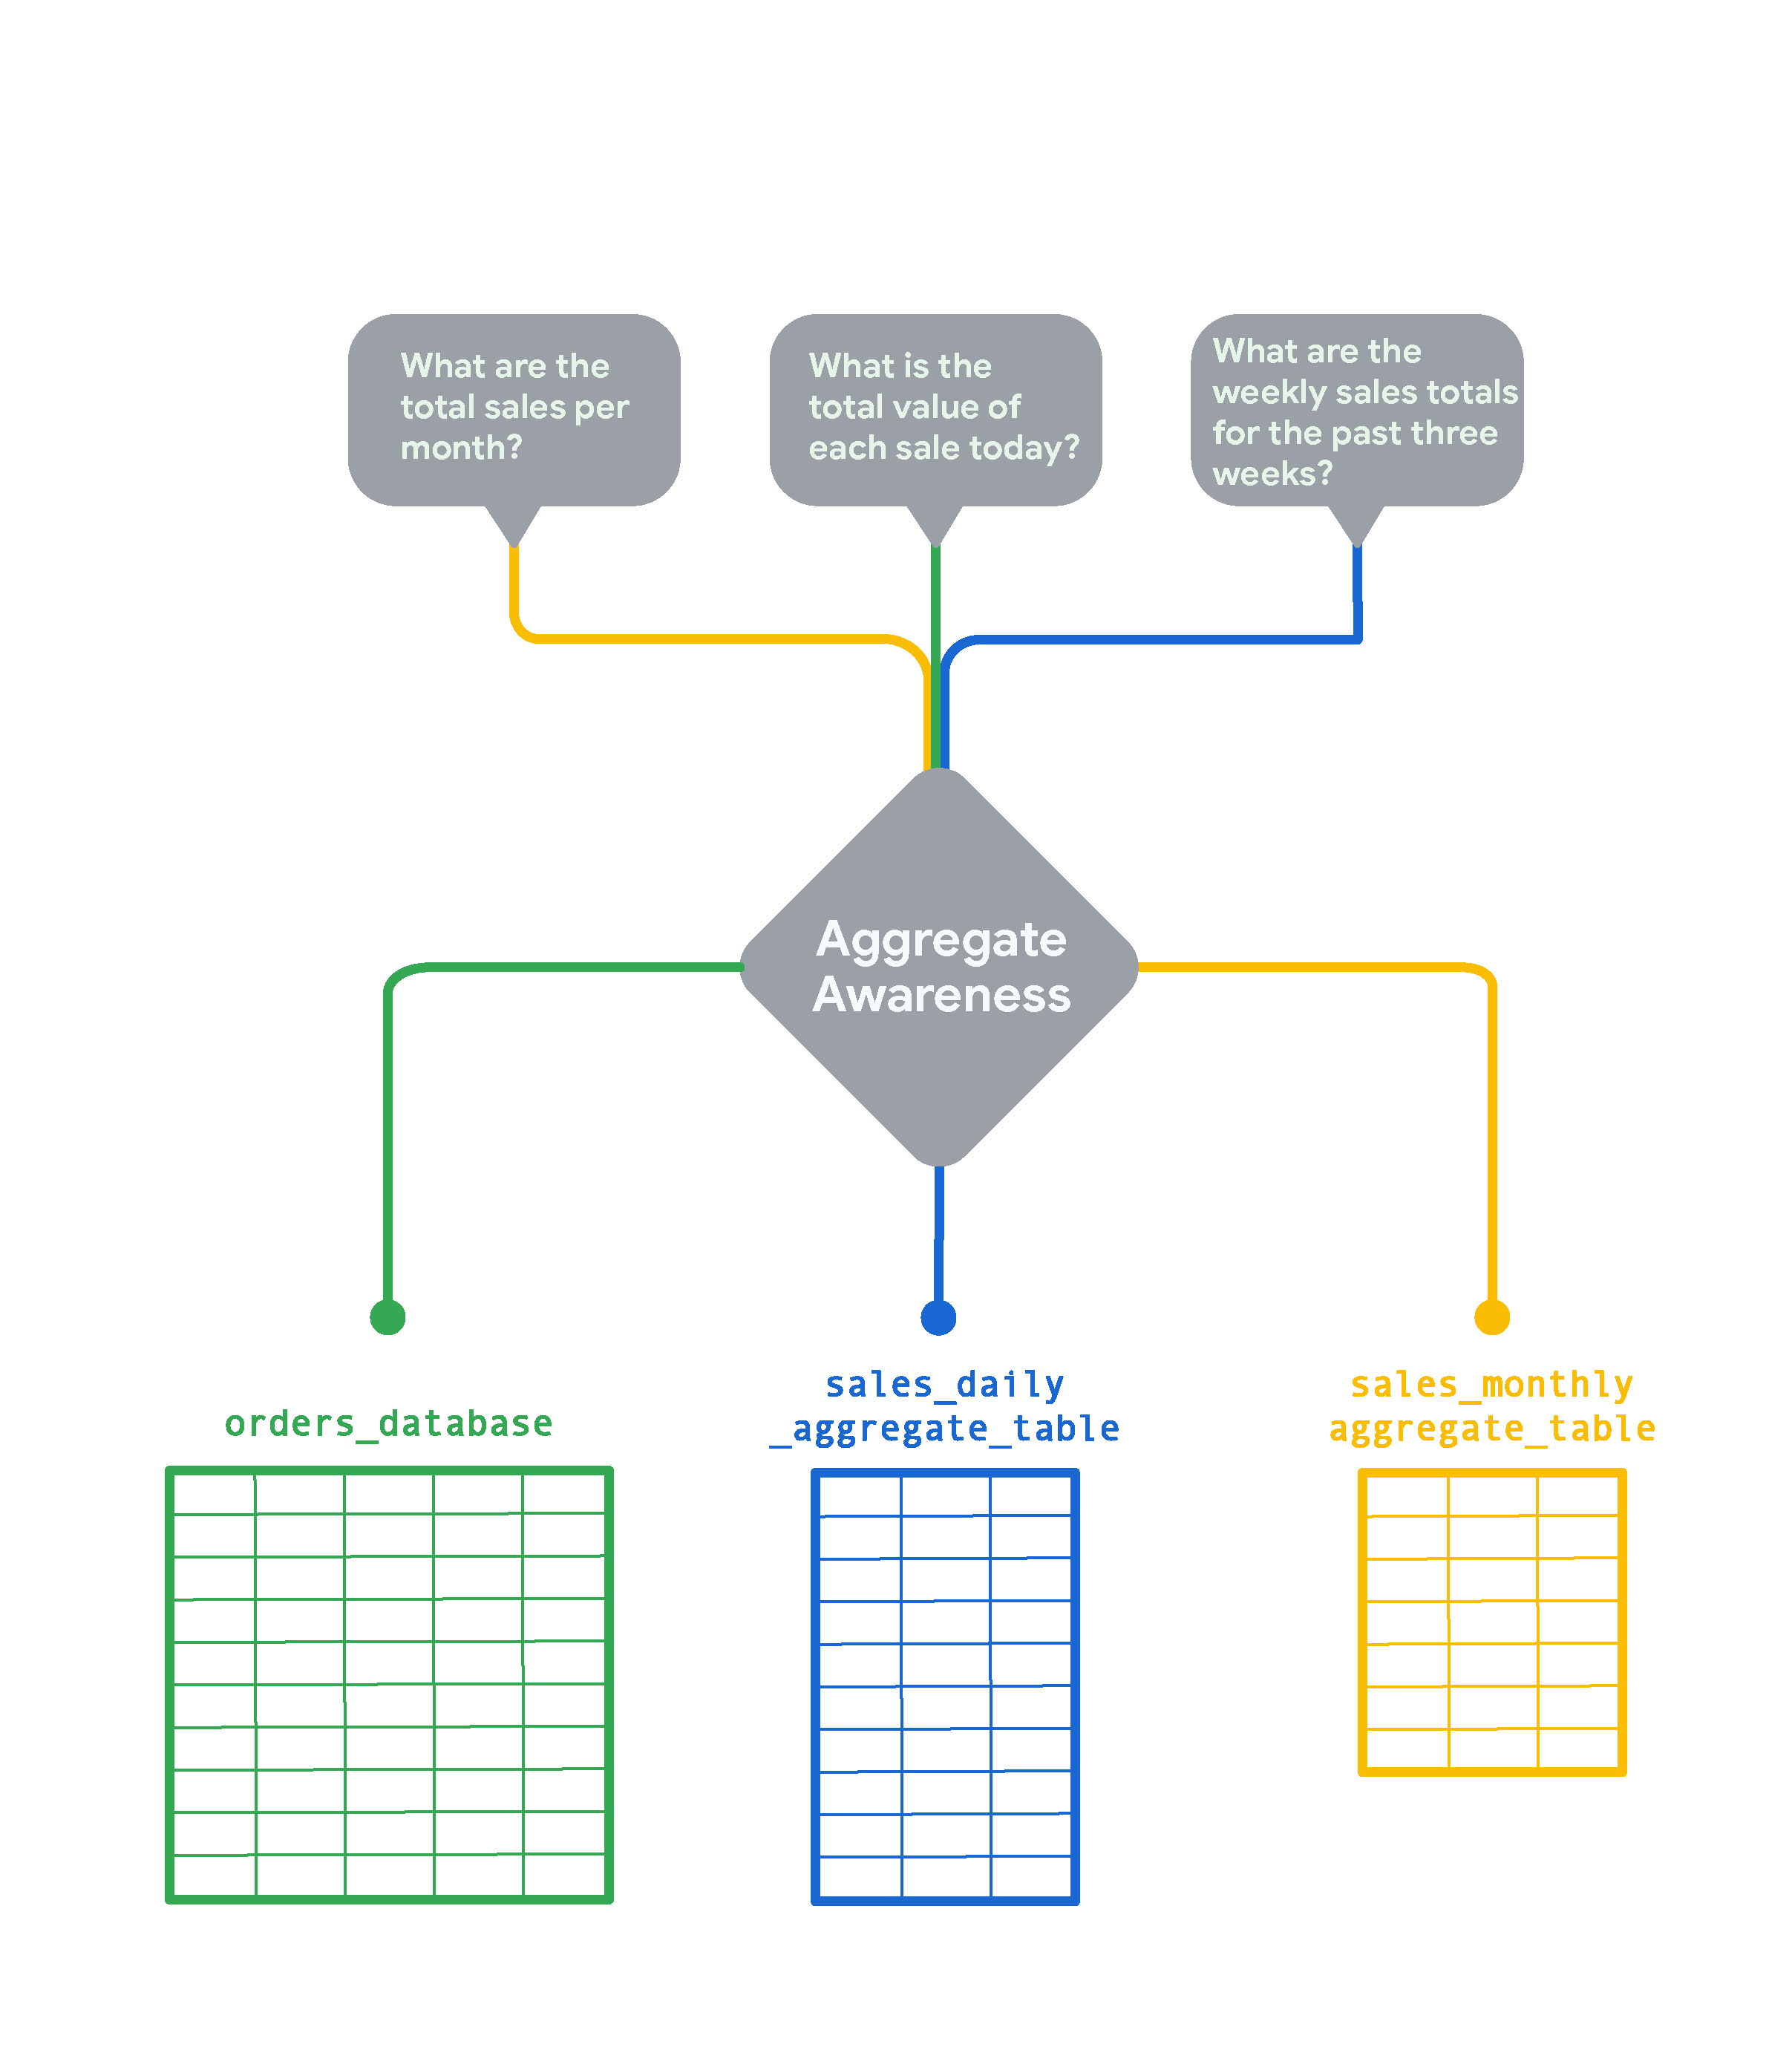
Con la lógica de reconocimiento de agregaciones, Looker consultará la tabla de datos agregados más pequeña posible para responder las preguntas de los usuarios. La tabla original se usaría solo para las consultas que requieran un nivel de detalle más preciso que el que pueden proporcionar las tablas de datos agregados.
No es necesario unir las tablas de datos agregados ni agregarlas a una exploración independiente. En su lugar, Looker ajusta de forma dinámica la cláusula FROM de la consulta de exploración para acceder a la mejor tabla de datos agregados para la consulta. Esto significa que se mantienen tus desgloses y se pueden consolidar las exploraciones. Con el reconocimiento de agregación, una exploración puede aprovechar automáticamente las tablas de datos agregados, pero, de ser necesario, también puede profundizar en los datos detallados.
También puedes aprovechar las tablas de datos agregados para mejorar drásticamente el rendimiento de los paneles, en especial para las tarjetas que consultan conjuntos de datos enormes. Para obtener más detalles, consulta la sección Obtén el LookML de la tabla de datos agregados de un panel en la página de documentación del parámetro aggregate_table.
Agrega tablas de datos agregados a tu proyecto
Los desarrolladores de Looker pueden crear tablas de datos agregados estratégicas que minimicen la cantidad de consultas necesarias en las tablas grandes de una base de datos. Las tablas de datos agregados deben conservarse en tu base de datos para que puedan ser accesibles para el reconocimiento de agregaciones. Por lo tanto, las tablas de datos agregados son un tipo de tabla derivada persistente (PDT).
Una tabla de datos agregados se define con el parámetro aggregate_table en un parámetro explore de tu proyecto de LookML.
Este es un ejemplo de un explore con una tabla de datos agregados en LookML:
explore: orders {
  label: "Sales Totals"
  join: order_items {
    sql_on: ${orders.id} = ${order_items.id} ;;
  }
  aggregate_table: sales_monthly {
    materialization: {
      datagroup_trigger: orders_datagroup
    }
    query: {
      dimensions: [created_month]
      measures: [order_items.total_sales]
    }
  }
  # other explore parameters
}
Para crear una tabla de datos agregados, puedes escribir el LookML desde cero o puedes obtener el LookML de la tabla de datos agregados desde una exploración o desde un panel. Consulta la página de documentación del parámetro aggregate_table para conocer los detalles del parámetro aggregate_table y sus subparámetros.
Diseña tablas de datos agregados
Para que una consulta de exploración use una tabla de datos agregados, esta debe poder proporcionar datos precisos para la consulta. Looker puede usar una tabla de datos agregados para una consulta de exploración si se cumplen todas las condiciones que se indican a continuación:
- Los campos de la consulta de Exploración son un subconjunto de los campos de la tabla de datos agregados (consulta la sección Factores de campo en esta página). O bien, en el caso de los períodos, los períodos de la consulta de Explorar se pueden derivar de los períodos de la tabla de datos agregados (consulta la sección Factores de período de esta página).
- La consulta de la exploración contiene tipos de medición compatibles con el reconocimiento de agregación (consulta la sección Factores de tipo de medición de esta página) o la consulta de la exploración tiene una tabla de datos agregados que es una coincidencia exacta (consulta la sección Crea tablas de datos agregados que coincidan exactamente con las consultas de la exploración de esta página).
- La zona horaria de la consulta de Exploración coincide con la que usa la tabla de datos agregados (consulta la sección Factores de zona horaria de esta página).
- Los filtros de la consulta de exploración hacen referencia a campos que están disponibles como dimensiones en la tabla de datos agregados, o bien cada uno de los filtros de la consulta de exploración coincide con un filtro de la tabla de datos agregados (consulta la sección Factores de filtro en esta página).
Una forma de garantizar que una tabla de datos agregados pueda proporcionar datos precisos para una consulta de exploración es crear una tabla de datos agregados que coincida exactamente con una consulta de exploración. Consulta la sección Crea tablas de datos agregados que coincidan exactamente con las consultas de Explorar en esta página para obtener más detalles.
Factores de campo
Para que se use en una consulta de exploración, una tabla de datos agregados debe tener todas las dimensiones y mediciones necesarias para esa consulta, incluidos los campos que se usan para los filtros en la consulta de exploración. Si una consulta de exploración contiene una dimensión o una medición que no está en una tabla de datos agregados, Looker no podrá usar esa tabla y, en su lugar, usará la tabla base.
Por ejemplo, si una consulta agrupa por las dimensiones A y B, agrega por la medición C y filtra por la dimensión D, la tabla de datos agregados debe tener, como mínimo, las dimensiones A, B y D, y la medición C.
La tabla de datos agregados también puede tener otros campos, pero debe tener al menos los campos de consulta de Explorar para que se pueda optimizar. La única excepción son las dimensiones de período, ya que los períodos de nivel de detalle más amplio se pueden derivar de los de nivel de detalle más específico.
Debido a estas consideraciones de campo, una tabla de datos agregados es específica de la exploración en la que se define. Una tabla de datos agregados definida en una exploración no se usará para consultas en otra exploración.
Factores de período
La lógica de reconocimiento de agregados de Looker puede derivar un período de otro. Se puede usar una tabla de datos agregados para una consulta, siempre y cuando el período de la tabla tenga una nivel de detalle más preciso (o igual) que la consulta de Explorar. Por ejemplo, una tabla de datos agregados basada en datos diarios se puede usar para una consulta de exploración que requiere otros períodos, como consultas de datos diarios, mensuales y anuales, o incluso datos de día del mes, día del año y semana del año. Sin embargo, no se puede usar una tabla de datos agregados anual para una consulta de Explorar que solicite datos por hora, ya que los datos de la tabla de datos agregados no tienen un nivel de detalle lo suficientemente preciso para la consulta de Explorar.
Lo mismo se aplica a los subconjuntos de períodos. Por ejemplo, si tienes una tabla de datos agregados que se filtra por los últimos tres meses y un usuario consulta los datos con un filtro para los últimos dos meses, Looker podrá usar la tabla de datos agregados para esa consulta.
Además, se aplica la misma lógica para las consultas con filtros de período: se puede usar una tabla de datos agregados para una consulta con un filtro de período, siempre que el período de la tabla de datos agregados tenga un nivel de detalle más preciso (o igual) que el filtro de período que se usa en la consulta de Explorar. Por ejemplo, una tabla de datos agregados que tiene una dimensión de período diario se puede usar para una consulta de exploración que filtra por día, semana o mes.
Factores del tipo de medición
Para que una consulta de exploración use una tabla de datos agregados, las mediciones de la tabla deben poder proporcionar datos precisos para la consulta.
Por este motivo, solo se admiten ciertos tipos de mediciones, como se describe en las siguientes secciones:
- Medidas con tipos de medidas admitidos
- Medidas definidas por expresiones de SQL
- Medidas que no se definen con
${TABLE} - Medidas que se aproximan a recuentos distintos
Si una consulta de exploración usa cualquier otro tipo de medición, Looker usará la tabla original, no la tabla de datos agregados, para devolver los resultados. La única excepción es si la consulta de exploración es una coincidencia exacta de una consulta de tabla de datos agregados, como se describe en la sección Crea tablas de datos agregados que coincidan exactamente con las consultas de exploración.
De lo contrario, Looker usará la tabla original, no la tabla de datos agregados, para devolver los resultados.
Mediciones con tipos de medición compatibles
El reconocimiento de datos agregados se puede usar para las consultas de Explorar que usan mediciones con estos tipos de mediciones:
Para usar una tabla de datos agregados en una consulta de exploración, Looker debe poder operar con las mediciones de la tabla de datos agregados para proporcionar datos precisos en la consulta de exploración. Por ejemplo, una medición con type: sum se puede usar para el reconocimiento de datos agregados, ya que puedes sumar varios totales: se puede agregar una tabla de datos agregados de totales semanales para obtener un total mensual preciso. Del mismo modo, se puede usar una medición con type: max porque se puede usar una tabla de datos agregados de máximos diarios para encontrar el máximo semanal exacto.
En el caso de las mediciones con type: average, se admite el reconocimiento de datos agregados porque Looker usa datos de suma y recuento para derivar con precisión los valores promedio de las tablas de datos agregados.
Medidas definidas con expresiones de SQL
El reconocimiento de agregación también se puede usar con mediciones que se definen con expresiones en el parámetro sql. Cuando se definen con expresiones de SQL, también se admiten los siguientes tipos de mediciones:
El reconocimiento de agregación es compatible con las mediciones que se definen como combinaciones de otras mediciones, como en este ejemplo:
measure: total_revenue_in_dollars {
  type: number
  sql: ${total_revenue_in_dollars} - ${inventory_item.total_cost_in_dollars} ;;
}
El reconocimiento de agregación también se admite para las mediciones en las que los cálculos se definen en el parámetro sql, como esta medición:
measure: wholesale_value {
  type: number
    sql: (${order_items.total_sale_price} * 0.60) ;;
}
Además, el reconocimiento de agregación es compatible con las mediciones en las que se definen las operaciones MIN, MAX y COUNT en el parámetro sql, como esta medición:
measure: most_recent_order_date {
  type: date
  sql: MAX(${users.created_at_raw})
}
Mediciones que hacen referencia a campos de LookML
Cuando se usan expresiones sql en mediciones, el reconocimiento de agregación admite los siguientes tipos de referencias de campo:
- Referencias con el formato
${view_name.field_name}, que indica campos en otras vistas - Referencias que usan el formato
${field_name}, que indica campos en la misma vista
El reconocimiento de agregación no se admite para las mediciones que se definen con el formato ${TABLE}.column_name, que indica una columna en una tabla. (Consulta la página de documentación Incorpora SQL y haz referencia a objetos de LookML para obtener una descripción general del uso de referencias en LookML).
Por ejemplo, una medición definida con este parámetro sql no se admitiría en una tabla de datos agregados, ya que usa el formato ${TABLE}.column_name:
measure: wholesale_value {
  type: number
  sql: (${TABLE}.total_sale_price * 0.60) ;;
}
Si quieres incluir esta medición en una tabla de datos agregados, puedes crear una dimensión definida con el formato ${TABLE}.column_name y, luego, crear una medición que haga referencia a la dimensión, de la siguiente manera:
 dimension: total_sale_price {
    sql: (${TABLE}.total_sale_price) ;;
  }

  measure: wholesale_value {
    type: number
    sql: (${total_sale_price} * 0.60) ;;
}
Ahora puedes usar la medición wholesale_value en tu tabla de datos agregados.
Mediciones que aproximan recuentos distintos
En general, los recuentos distintos no se admiten con el reconocimiento de agregación, ya que no puedes obtener datos precisos si intentas agregar recuentos distintos. Por ejemplo, si cuentas los usuarios distintos de un sitio web, es posible que haya un usuario que haya visitado el sitio web dos veces, con tres semanas de diferencia. Si intentaras aplicar una tabla de datos agregados semanal para obtener un recuento mensual de usuarios únicos en tu sitio web, ese usuario se contaría dos veces en tu consulta de recuento mensual de usuarios únicos, y los datos serían incorrectos.
Una solución alternativa para esto es crear una tabla de datos agregados que coincida exactamente con una consulta de exploración, como se describe en la sección Crea tablas de datos agregados que coincidan exactamente con las consultas de exploración de esta página. Cuando la consulta de exploración y la consulta de la tabla de datos agregados son iguales, las mediciones de recuento de valores distintos proporcionan datos precisos, por lo que se pueden usar para el reconocimiento de datos agregados.
Otra opción es usar aproximaciones para los recuentos distintos. En el caso de los dialectos que admiten esbozos de HyperLogLog, Looker puede aprovechar el algoritmo de HyperLogLog para aproximar los recuentos distintos de las tablas de datos agregados.
Se sabe que el algoritmo HyperLogLog tiene un error de alrededor del 2%. El parámetro allow_approximate_optimization: yes requiere que tus desarrolladores de Looker confirmen que es correcto usar datos aproximados para la medición, de modo que esta se pueda calcular de forma aproximada a partir de tablas de datos agregados.
Consulta la página de documentación del parámetro allow_approximate_optimization para obtener más información y la lista de dialectos que admiten el recuento de valores distintos con HyperLogLog.
Factores de zona horaria
En muchos casos, los administradores de bases de datos usan la zona horaria UTC para las bases de datos. Sin embargo, es posible que muchos usuarios no se encuentren en la zona horaria UTC. Looker tiene varias opciones para convertir las zonas horarias, de modo que los usuarios obtengan los resultados de las consultas en su propia zona horaria:
- Zona horaria de la consulta, un parámetro de configuración que se aplica a todas las consultas de la conexión de la base de datos. Si todos tus usuarios se encuentran en la misma zona horaria, puedes establecer una sola zona horaria de consulta para que todas las consultas se conviertan de la zona horaria de la base de datos a la zona horaria de la consulta.
- Zonas horarias específicas del usuario, en las que se pueden asignar y seleccionar zonas horarias de forma individual. En este caso, las consultas se convierten de la zona horaria de la base de datos a la zona horaria del usuario individual.
Consulta la página de documentación Usa la configuración de zona horaria para obtener más información sobre estas opciones.
Es importante comprender estos conceptos para entender el reconocimiento de agregaciones, ya que, para que una tabla de datos agregados se use en una consulta con dimensiones o filtros de fecha, la zona horaria de la tabla de datos agregados debe coincidir con el parámetro de configuración de zona horaria que se usó para la consulta original.
Las tablas de datos agregados usan la zona horaria de la base de datos si no se especifica ningún valor de timezone. La conexión de la base de datos también usará la zona horaria de la base de datos si se cumple alguna de las siguientes condiciones:
- Tu base de datos no admite zonas horarias.
- La zona horaria de la consulta de la conexión de tu base de datos está configurada en la misma zona horaria que la zona horaria de la base de datos.
- Tu conexión de base de datos no tiene una zona horaria de consulta especificada ni zonas horarias elegidas por los usuarios. Si este es el caso, la conexión de la base de datos usará la zona horaria de la base de datos.
Si se cumple alguna de estas condiciones, puedes omitir el parámetro timezone para tus tablas de datos agregados.
De lo contrario, la zona horaria de la tabla de datos agregados se debe definir para que coincida con las consultas posibles, de modo que sea más probable que se use la tabla de datos agregados:
- Si tu conexión de base de datos usa una sola zona horaria de consulta, debes hacer coincidir el valor
timezonede tu tabla de datos agregados con el valor de la zona horaria de consulta. - Si tu conexión de base de datos usa zonas horarias específicas del usuario, debes crear tablas de datos agregados idénticas, cada una con un valor de
timezonediferente para que coincida con las posibles zonas horarias de tus usuarios.
Factores de filtro
Ten cuidado cuando incluyas filtros en tu tabla de datos agregados. Los filtros de una tabla de datos agregados pueden limitar los resultados hasta el punto en que la tabla no se pueda usar. Por ejemplo, supongamos que creas una tabla de datos agregados para los recuentos de pedidos diarios y que la tabla de datos agregados filtra solo los pedidos de lentes de sol que provienen de Australia. Si un usuario ejecuta una consulta de exploración para obtener los recuentos diarios de pedidos de lentes de sol en todo el mundo, Looker no puede usar la tabla de datos agregados para esa consulta de exploración, ya que la tabla de datos agregados solo tiene los datos de Australia. La tabla de datos agregados filtra los datos de forma demasiado limitada para que los use la consulta de exploración.
Además, ten en cuenta los filtros que tus desarrolladores de Looker podrían haber integrado en tu exploración, como los siguientes:
access_filters: Aplica restricciones de datos específicas del usuario.always_filter: Exige a los usuarios que incluyan un determinado conjunto de filtros para una consulta de exploración. Los usuarios pueden cambiar el valor predeterminado del filtro para su consulta, pero no pueden quitarlo por completo.conditionally_filter: Define un conjunto de filtros predeterminados que los usuarios pueden anular si aplican al menos un filtro de una segunda lista que también se define en la exploración.
Estos tipos de filtros se basan en campos específicos. Si tu exploración tiene estos filtros, debes incluir sus campos en el parámetro dimensions de aggregate_table.
Por ejemplo, aquí hay una exploración con un filtro de acceso que se basa en el campo orders.region:
explore: orders {
  access_filter: {
    field: orders.region
    user_attribute: region
  }
}
Para crear una tabla de datos agregados que se usaría en esta exploración, la tabla debe incluir el campo en el que se basa el filtro de acceso. En el siguiente ejemplo, el filtro de acceso se basa en el campo orders.region, y este mismo campo se incluye como una dimensión en la tabla de datos agregados:
explore: orders {
  access_filter: {
    field: orders.region  # <-- orders.region field
    user_attribute: region
  }
  aggregate_table: sales_monthly {
    materialization: {
      datagroup_trigger: orders_datagroup
    }
    query: {
      dimensions: [orders.created_day, orders.region] # <-- orders.region field
      measures: [orders.total_sales]
      timezone: America/Los_Angeles
    }
  }
}
Debido a que la consulta de la tabla de datos agregados incluye la dimensión orders.region, Looker puede filtrar de forma dinámica los datos de la tabla de datos agregados para que coincidan con el filtro de la consulta de la exploración. Por lo tanto, Looker aún puede usar la tabla de datos agregados para las consultas de la exploración, aunque esta tenga un filtro de acceso.
Esto también se aplica a las consultas de exploración que usan una tabla derivada nativa configurada con bind_filters. El parámetro bind_filters pasa los filtros especificados de una consulta de exploración a la subconsulta de la tabla derivada nativa. En el caso del reconocimiento de datos agregados, si tu consulta de exploración requiere una tabla derivada nativa que use bind_filters, la consulta de exploración solo puede usar una tabla de datos agregados si todos los campos que se usan en el parámetro bind_filters de la tabla derivada nativa tienen exactamente los mismos valores de filtro en la consulta de exploración que en la tabla de datos agregados.
Crear tablas de datos agregados que coincidan exactamente con las consultas de Explorar
Una forma de asegurarse de que se pueda usar una tabla de datos agregados para una consulta de exploración es crear una tabla de datos agregados que coincida exactamente con la consulta de exploración. Si la consulta de exploración y la tabla de datos agregados usan las mismas mediciones, dimensiones, filtros, zonas horarias y otros parámetros, por definición, los resultados de la tabla de datos agregados se aplicarán a la consulta de exploración. Si una tabla de datos agregados coincide exactamente con una consulta de exploración, Looker puede usar tablas de datos agregados que incluyan cualquier tipo de medición.
Puedes crear una tabla de datos agregados a partir de una exploración con la opción Obtener LookML del menú de ajustes de una exploración. También puedes crear coincidencias exactas para todas las tarjetas de un panel con la opción Obtener LookML del menú de ajustes de un panel.
Determina qué tabla de datos agregados se usa para una consulta
Los usuarios con permisos see_sql pueden usar los comentarios en la pestaña SQL de una exploración para ver qué tabla de datos agregados se usará para una consulta. Los comentarios de la pestaña SQL también se muestran en el Modo de desarrollo, por lo que los desarrolladores pueden probar las tablas de datos agregados nuevas para ver cómo las usa Looker antes de que envíes las tablas nuevas a producción.
Por ejemplo, según la tabla de datos agregados mensual de ejemplo que se mostró anteriormente, puedes ir a la exploración y ejecutar una consulta para obtener los totales de ventas anuales. Luego, puedes hacer clic en la pestaña SQL para ver los detalles de la consulta que creó Looker. Si estás en el Modo de desarrollo, Looker muestra comentarios para indicar la tabla de datos agregados que usó para la consulta.
En los siguientes comentarios de la pestaña SQL, podemos ver que Looker usa la tabla de datos agregados sales_monthly para esta consulta, además de información sobre por qué no se usaron otras tablas de datos agregados para la consulta:
-- use existing orders::sales_monthly in sandbox_scratch.LR$LB4151619827209021_orders$sales_monthly
-- Did not use orders::sales_weekly; it does not include the following fields in the query: orders.created_month
-- Did not use orders::sales_daily; orders::sales_monthly was a better fit for optimization.
-- Did not use orders::sales_last_3_days; contained filters not in the query: orders.created_date
Consulta la sección Solución de problemas de esta página para ver los posibles comentarios que puedes encontrar en la pestaña SQL y sugerencias para resolverlos.
Estimaciones de ahorro de procesamiento para el reconocimiento de agregaciones
Si tu conexión de base de datos admite estimaciones de costos y si se puede usar una tabla de datos agregados para una consulta, la ventana Explorar mostrará los ahorros de procesamiento que se obtienen al usar la tabla de datos agregados en lugar de consultar la base de datos directamente. Los ahorros de reconocimiento de agregados se muestran junto al botón Ejecutar en una exploración antes de que se ejecute la consulta.
Antes de ejecutar la consulta, si quieres ver qué tabla de datos agregados se usará para la consulta, puedes hacer clic en la pestaña SQL, como se describe en la sección Determina qué tabla de datos agregados se usa para una consulta de esta página de documentación.
Después de que se ejecute la consulta, la ventana Explorar mostrará qué tabla de datos agregados se usó para responder la consulta junto al botón Ejecutar.
Los ahorros de reconocimiento de agregados se muestran para las conexiones de base de datos que están habilitadas para las estimaciones de costos. Consulta la página de documentación Explora datos en Looker para obtener más información.
Looker une los datos nuevos a tus tablas de datos agregados
En el caso de las tablas de datos agregados con filtros de tiempo, Looker puede unir datos actualizados en tu tabla de datos agregados. Es posible que tengas una tabla de datos agregados que incluya datos de los últimos tres días, pero que se haya creado ayer. La tabla de datos agregados no tendría la información de hoy, por lo que no se esperaría que la uses para una consulta de Explorar sobre la información diaria más reciente.
Sin embargo, Looker aún puede usar los datos de esa tabla de datos agregados para la consulta, ya que ejecutará una consulta sobre los datos más recientes y, luego, unirá esos resultados con los de la tabla de datos agregados.
Looker puede unir datos actualizados con los datos de tu tabla de datos agregados en las siguientes circunstancias:
- La tabla de datos agregados tiene un filtro de tiempo.
- La tabla de datos agregados incluye una dimensión basada en el mismo campo de tiempo que el filtro de tiempo.
Por ejemplo, la siguiente tabla de datos agregados tiene una dimensión basada en el campo orders.created_date y un filtro de tiempo ("3 days") basado en el mismo campo:
aggregate_table: sales_last_3_days {
  query:  {
    dimensions: [orders.created_date]
    measures: [order_items.total_sales]
    filters: [orders.created_date: "3 days"]  # <-- time filter
    timezone: America/Los_Angeles
  }
  ...
}
Si esta tabla de datos agregados se creó ayer, Looker recuperará los datos más recientes que aún no se incluyen en la tabla de datos agregados y, luego, unirá los resultados nuevos con los resultados de la tabla de datos agregados. Esto significa que tus usuarios obtendrán los datos más recientes y, al mismo tiempo, se optimizará el rendimiento con el conocimiento de agregación.
Si estás en el Modo de desarrollo, puedes hacer clic en la pestaña SQL de una exploración para ver la tabla de datos agregados que Looker usó para la consulta y la sentencia UNION que Looker usó para incorporar datos más recientes que no se incluyeron en la tabla de datos agregados.
Las tablas de datos agregados deben conservarse
Para que se pueda acceder a ella para el reconocimiento de agregaciones, tu tabla de datos agregados debe conservarse en tu base de datos. La estrategia de persistencia se especifica en el parámetro materialization de la tabla de datos agregados. Debido a que las tablas de datos agregados son un tipo de tabla derivada persistente (PDT), tienen los mismos requisitos que las PDT. Consulta la página de documentación Tablas derivadas en Looker para obtener más detalles.
Puedes crear PDT incrementales en tu proyecto si tu dialecto las admite. Looker compila PDT incrementales agregando datos recientes a la tabla, en lugar de volver a compilarla por completo. Dado que las tablas de datos agregados son un tipo de PDT, también puedes crear tablas de datos agregados incrementales. Consulta la página de documentación sobre PDT incrementales para obtener más información sobre las PDT incrementales. Consulta la página de documentación del parámetro increment_key para ver un ejemplo de una tabla de datos agregados incremental.
Un usuario con el permiso develop puede anular la configuración de persistencia y volver a compilar todas las tablas de datos agregados para una consulta con el objetivo de obtener los datos más actualizados. Para volver a compilar las tablas de una consulta, selecciona la opción Volver a compilar tablas derivadas y ejecutar en el menú de ajustes de Explorar acciones.
Debes esperar a que se cargue la consulta de Explorar para que esta opción esté disponible.
La opción Rebuild Derived Tables & Run vuelve a compilar todas las tablas derivadas a las que se hace referencia en la consulta, así como las tablas derivadas de las que dependen las tablas de la consulta. Esto incluye las tablas de datos agregados, que son un tipo de tabla derivada persistente.
Para el usuario que inicia la opción Recompilar tablas derivadas y ejecutar, la consulta esperará a que se vuelvan a compilar las tablas antes de cargar los resultados. Las consultas de otros usuarios seguirán usando las tablas existentes. Una vez que se vuelvan a compilar las tablas persistentes, todos los usuarios usarán las tablas recompiladas.
Consulta la página de documentación Tablas derivadas en Looker para obtener más detalles sobre la opción Volver a compilar tablas derivadas y ejecutar.
Soluciona problemas
Como se describe en la sección Determina qué tabla de datos agregados se usa para una consulta, si estás en el Modo de desarrollo, puedes ejecutar consultas en la exploración y hacer clic en la pestaña SQL para ver los comentarios sobre la tabla de datos agregados que se usa para la consulta, si los hay.
La pestaña SQL también incluye comentarios sobre por qué no se usaron tablas de datos agregados para una consulta, si ese es el caso. En el caso de las tablas de datos agregados que no se usan, el comentario comenzará de la siguiente manera:
Did not use [explore name]::[aggregate table name];
Por ejemplo, aquí hay un comentario sobre por qué la tabla de datos agregados sales_daily definida en la exploración order_items no se usó para una consulta:
-- Did not use order_items::sales_daily; query contained the following filters
that were neither included as fields nor exactly matched by filters in the aggregate table:
order_items.created_year.
En este caso, los filtros de la consulta impidieron que se usara la tabla de datos agregados.
En la siguiente tabla, se muestran algunos otros motivos posibles por los que no se puede usar una tabla de datos agregados, junto con los pasos que puedes seguir para aumentar su usabilidad.
| Motivo por el que no se usa la tabla de datos agregados | Explicación y posibles pasos |
|---|---|
| No existe ese campo en la exploración. | Hay un error de tipo de validación de LookML. Lo más probable es que esto se deba a que la tabla de datos agregados no se definió correctamente o a que hubo un error de ortografía en el LookML de tu tabla de datos agregados. Un posible culpable es un nombre de campo incorrecto o algo similar.Para resolver este problema, verifica que las dimensiones y las mediciones de la tabla de datos agregados coincidan con los nombres de los campos de la exploración. Consulta la página de documentación del parámetro aggregate_table para obtener más información sobre cómo definir una tabla de datos agregados. |
| La tabla de datos agregados no incluye los siguientes campos en la consulta. | Para que se use en una consulta de exploración, una tabla de datos agregados debe tener todas las dimensiones y mediciones necesarias para esa consulta, incluidos los campos que se usan para los filtros en la consulta de exploración. Si una consulta de exploración contiene una dimensión o una medición que no está en una tabla de datos agregados, Looker no podrá usar esa tabla y, en su lugar, usará la tabla base. Consulta la sección Factores de campo de esta página para obtener más detalles. La única excepción son las dimensiones de período, ya que los períodos con un nivel de detalle más amplio se pueden derivar de aquellos con un nivel de detalle más específico. Para resolver este problema, verifica que los campos de la consulta de Exploración estén incluidos en la definición de la tabla de datos agregados. |
| La consulta contenía los siguientes filtros que no se incluyeron como campos ni coincidieron exactamente con los filtros de la tabla de datos agregados. | Los filtros de la consulta de la exploración impiden que Looker use la tabla de datos agregados. Para resolver este problema, puedes realizar una de las siguientes acciones:
|
| La consulta contiene las siguientes mediciones que no se pueden resumir. | La consulta contiene uno o más tipos de mediciones que no son compatibles con el reconocimiento de agregación, como recuento distinto, mediana o percentil.Para resolver este problema, verifica el tipo de cada medición en la consulta y asegúrate de que sea uno de los tipos de mediciones admitidos. Además, si tu exploración tiene uniones, verifica que tus mediciones no se conviertan en mediciones distintas (agregaciones simétricas) a través de uniones expandidas. Consulta la sección Agregaciones simétricas para exploraciones con uniones en esta página para obtener una explicación. |
| Otra tabla de datos agregados era más adecuada para la optimización. | Había varias tablas de datos agregados viables para la consulta, y Looker encontró una tabla de datos agregados más óptima para usar en su lugar. No es necesario realizar ninguna acción en este caso. |
Looker no realizó ninguna agrupación (debido a un parámetro primary_key o cancel_grouping_fields) y, por lo tanto, la consulta no se puede resumir. |
La consulta hace referencia a una dimensión que impide que tenga una cláusula GROUP BY y, por lo tanto, Looker no puede usar ninguna tabla de datos agregados para la consulta.
Para resolver este problema, verifica que el parámetro primary_key de la vista y el parámetro cancel_grouping_fields de la exploración estén configurados correctamente. |
| La tabla de datos agregados contenía filtros que no estaban en la consulta. | La tabla de datos agregados tiene un filtro que no es de tiempo y que no está en la consulta.Para resolver este problema, puedes quitar el filtro de la tabla de datos agregados. Consulta la sección Factores de filtro de esta página para obtener más detalles. |
Un campo se define como un campo de solo filtro en la consulta de exploración, pero se incluye en el parámetro dimensions de la tabla de datos agregados. |
El parámetro dimensions de la tabla de datos agregados enumera un campo que se define solo como un campo filter en la consulta de la exploración.Para resolver este problema, quita el campo de la lista dimensions de la tabla de datos agregados. Si este campo es necesario para la tabla de datos agregados, agrégalo a la lista filters en la consulta de la tabla de datos agregados. |
| El optimizador no puede determinar por qué no se usó la tabla de datos agregados. | Este comentario se reserva para situaciones limítrofes. Si ves esto en una consulta de exploración que se usa con frecuencia, puedes crear una tabla de datos agregados que coincida exactamente con la consulta de exploración. Puedes obtener el LookML de la tabla de datos agregados desde una exploración, como se describe en la página del parámetro aggregate_table. |
Aspectos para tener en cuenta
Agregaciones simétricas para exploraciones con uniones
Un aspecto importante que se debe tener en cuenta es que, en una exploración que une varias tablas de bases de datos, Looker puede renderizar mediciones de tipo SUM, COUNT y AVERAGE como SUM DISTINCT, COUNT DISTINCT y AVERAGE DISTINCT, respectivamente. Looker hace esto para evitar errores de cálculo de distribución. Por ejemplo, una medición count se renderiza como un tipo de medición count_distinct. Esto se hace para evitar errores de cálculo de distribución de uniones y forma parte de la funcionalidad de agregaciones simétricas de Looker. Consulta la página de prácticas recomendadas sobre agregaciones simétricas para obtener una explicación de esta función de Looker.
La funcionalidad de agregaciones simétricas evita los errores de cálculo, pero también puede impedir que se usen tus tablas de datos agregados en ciertos casos, por lo que es importante comprenderla.
En el caso de los tipos de medición compatibles con el reconocimiento de agregación, esto se aplica a sum, count y average. Looker renderizará estos tipos de mediciones como DISTINCT si se cumple lo siguiente:
- La medición proviene de la vista "uno" de una unión varios a uno o uno a varios.
- La medición proviene de cualquier vista de una unión de varios a varios.
Consulta la página de documentación del parámetro relationship para obtener una explicación de estos tipos de uniones.
Si descubres que tu tabla de datos agregados no se usa por este motivo, puedes crear una tabla de datos agregados que coincida exactamente con una consulta de exploración para usar estos tipos de mediciones en una exploración con uniones. Consulta la sección Crea tablas de datos agregados que coincidan exactamente con las consultas de Explorar en esta página para obtener más información.
Además, si tienes un dialecto de SQL que admite esquemas de HyperLogLog, puedes agregar el parámetro allow_approximate_optimization: yes a la medición. Cuando se define una medición de recuento con allow_approximate_optimization: yes, Looker puede usarla para el reconocimiento de agregados, incluso si se renderiza como un recuento distinto.
Consulta la página de documentación del parámetro allow_approximate_optimization para obtener detalles y una lista de qué dialectos de SQL admiten los resúmenes de HyperLogLog.
Compatibilidad de dialectos con el reconocimiento de agregaciones
La capacidad de usar el reconocimiento de agregación depende del dialecto de la base de datos que use tu conexión de Looker. En la versión más reciente de Looker, los siguientes dialectos admiten el reconocimiento de agregación:
| Dialecto | ¿Es compatible? |
|---|---|
| Actian Avalanche | |
| Amazon Athena | |
| Amazon Aurora MySQL | |
| Amazon Redshift | |
| Amazon Redshift 2.1+ | |
| Amazon Redshift Serverless 2.1+ | |
| Apache Druid | |
| Apache Druid 0.13.x - 0.17.x | |
| Apache Druid 0.18+ | |
| Apache Hive 2.3+ | |
| Apache Hive 3.1.2+ | |
| Apache Spark 3+ | |
| ClickHouse | |
| ClickHouse 26+ | |
| Cloudera Impala 3.1+ | |
| Cloudera Impala 3.1+ with Native Driver | |
| Cloudera Impala with Native Driver | |
| DataVirtuality | |
| Databricks | |
| Denodo 7 | |
| Denodo 8 & 9 | |
| Dremio | |
| Dremio 11+ | |
| Dremio 26+ with Arrow Flight SQL | |
| Exasol | |
| Google BigQuery Legacy SQL | |
| Google BigQuery Standard SQL | |
| Google Cloud AlloyDB for PostgreSQL | |
| Google Cloud PostgreSQL | |
| Google Cloud SQL | |
| Google Spanner | |
| Greenplum | |
| HyperSQL | |
| IBM Netezza | |
| MariaDB | |
| Microsoft Azure PostgreSQL | |
| Microsoft Azure SQL Database | |
| Microsoft Azure Synapse Analytics | |
| Microsoft SQL Server 2008+ | |
| Microsoft SQL Server 2012+ | |
| Microsoft SQL Server 2016 | |
| Microsoft SQL Server 2017+ | |
| MongoBI | |
| MongoSQL | |
| MySQL | |
| MySQL 8.0.12+ | |
| Oracle | |
| Oracle ADWC | |
| PostgreSQL 9.5+ | |
| PostgreSQL pre-9.5 | |
| PrestoDB | |
| PrestoSQL | |
| SAP HANA | |
| SAP HANA 2+ | |
| SingleStore | |
| SingleStore 7+ | |
| Snowflake | |
| Teradata | |
| Trino | |
| Vector | |
| Vertica |
Compatibilidad con dialectos para compilar tablas de datos agregados de forma incremental
Para que Looker admita tablas de datos agregados incrementales en tu proyecto de Looker, el dialecto de tu base de datos también debe admitirlas. En la siguiente tabla, se muestran los dialectos que admiten la compilación incremental de PDT en la versión más reciente de Looker:
| Dialecto | ¿Es compatible? |
|---|---|
| Actian Avalanche | |
| Amazon Athena | |
| Amazon Aurora MySQL | |
| Amazon Redshift | |
| Amazon Redshift 2.1+ | |
| Amazon Redshift Serverless 2.1+ | |
| Apache Druid | |
| Apache Druid 0.13.x - 0.17.x | |
| Apache Druid 0.18+ | |
| Apache Hive 2.3+ | |
| Apache Hive 3.1.2+ | |
| Apache Spark 3+ | |
| ClickHouse | |
| ClickHouse 26+ | |
| Cloudera Impala 3.1+ | |
| Cloudera Impala 3.1+ with Native Driver | |
| Cloudera Impala with Native Driver | |
| DataVirtuality | |
| Databricks | |
| Denodo 7 | |
| Denodo 8 & 9 | |
| Dremio | |
| Dremio 11+ | |
| Dremio 26+ with Arrow Flight SQL | |
| Exasol | |
| Google BigQuery Legacy SQL | |
| Google BigQuery Standard SQL | |
| Google Cloud AlloyDB for PostgreSQL | |
| Google Cloud PostgreSQL | |
| Google Cloud SQL | |
| Google Spanner | |
| Greenplum | |
| HyperSQL | |
| IBM Netezza | |
| MariaDB | |
| Microsoft Azure PostgreSQL | |
| Microsoft Azure SQL Database | |
| Microsoft Azure Synapse Analytics | |
| Microsoft SQL Server 2008+ | |
| Microsoft SQL Server 2012+ | |
| Microsoft SQL Server 2016 | |
| Microsoft SQL Server 2017+ | |
| MongoBI | |
| MongoSQL | |
| MySQL | |
| MySQL 8.0.12+ | |
| Oracle | |
| Oracle ADWC | |
| PostgreSQL 9.5+ | |
| PostgreSQL pre-9.5 | |
| PrestoDB | |
| PrestoSQL | |
| SAP HANA | |
| SAP HANA 2+ | |
| SingleStore | |
| SingleStore 7+ | |
| Snowflake | |
| Teradata | |
| Trino | |
| Vector | |
| Vertica |