


A venda de credenciais para o catálogo do ambiente de execução do Lakehouse permite delegar o acesso do Cloud Storage a mecanismos de consulta e aplicar políticas detalhadas do Identity and Access Management (IAM) nos níveis de catálogo, namespace e tabela usando o console do Google Cloud ou a Google Cloud CLI. A venda de credenciais também é necessária para ativar o gerenciamento automático de tabelas para tarefas de manutenção em segundo plano, como compactação, expiração de snapshots e coleta de lixo.
Como funciona o fornecimento de credenciais
Quando você usa a venda de credenciais, a sequência de operações muda um pouco para aplicar políticas antes que o armazenamento seja acessado. O diagrama a seguir ilustra como os mecanismos de consulta recebem tokens de armazenamento com escopo reduzido do catálogo para ler e gravar dados diretamente no Cloud Storage de forma segura:
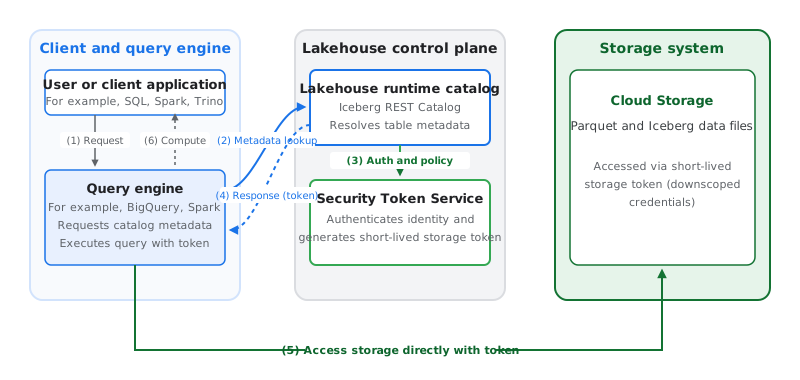
A sequência de operações mostrada no diagrama anterior é a seguinte:
- Solicitação: um usuário envia uma instrução SQL, como uma consulta, uma operação DML ou DDL, para um mecanismo compatível, como o Apache Spark ou o BigQuery.
- Pesquisa de metadados: o mecanismo envia uma solicitação ao catálogo do ambiente de execução do Lakehouse para resolver a tabela.
- Autenticação e política: o catálogo autentica o usuário e verifica as permissões do IAM dele nos recursos do Lakehouse.
- Resposta: como a venda de credenciais está ativada, o catálogo retorna os metadados e um token de armazenamento de curta duração (credenciais de armazenamento com escopo reduzido) para o mecanismo. O token tem como escopo os caminhos associados à tabela e tem como escopo reduzido as permissões mínimas necessárias (por exemplo, acesso somente leitura para consultas que não precisam gravar arquivos).
- Acesso: o mecanismo usa esse token para ler ou gravar os arquivos autorizados específicos diretamente do Cloud Storage.
- Computação: o mecanismo processa os dados ou executa a operação e retorna os resultados.
Quando o gerenciamento automático de tabelas (gcp.biglake.table-management.enabled) está ativado, as tarefas de manutenção em segundo plano, como compactação, expiração de snapshot e coleta de lixo, usam a conta de serviço provisionada automaticamente do catálogo para autenticar diretamente no Cloud Storage e atualizar os arquivos de dados subjacentes.
Mecanismos compatíveis
Para usar a distribuição de credenciais com mecanismos de consulta, configure o endpoint do catálogo REST do Apache Iceberg no catálogo do ambiente de execução do Lakehouse para oferecer suporte à distribuição de credenciais. A venda de credenciais não é compatível com endpoints de catálogo do Apache Hive.
- Mecanismos de código aberto: os mecanismos compatíveis, como Spark
e Trino, usam tokens de armazenamento de curta duração fornecidos pelo catálogo. O aplicativo cliente
precisa especificar o suporte à venda de credenciais no
cabeçalho
X-Iceberg-Access-Delegation. - BigQuery: o BigQuery usa credenciais vendidas para acesso ao Cloud Storage em vez de credenciais de usuário final.
Permissões necessárias da conta de serviço
Quando a venda de credenciais estiver ativada, verifique se as seguintes contas de serviço têm os papéis necessários:
- Conta de serviço do catálogo do ambiente de execução do Lakehouse provisionada automaticamente: é necessário conceder o papel de Usuário de objetos do Storage (
roles/storage.objectUser) a essa conta em todos os buckets do Cloud Storage associados. Sem esse acesso, as credenciais vendidas não podem ler ou gravar no armazenamento. Se você usar o console do Google Cloud , clicar em Definir permissões do bucket vai verificar esse papel. Para a CLI gcloud, o Terraform ou a API, é necessário conceder esse papel manualmente. - Contas de serviço do mecanismo de consulta: as contas de serviço que executam jobs do mecanismo de consulta (como o Serviço Gerenciado para Apache Spark, o Serviço Gerenciado para Apache Spark ou o Dataflow) exigem o papel de Editor do BigLake (
roles/biglake.editor) para receber credenciais vendidas com escopo de gravação.
A seguir
- Saiba como criar um catálogo no modo de fornecimento de credenciais.
- Saiba como ativar a venda de credenciais para um catálogo atual usando o console doGoogle Cloud .
- Saiba como configurar o aplicativo cliente para venda de credenciais.