


Lakehouse ランタイム カタログの認証情報の提供により、Cloud Storage へのアクセスをクエリエンジンに委任し、 Google Cloud コンソールまたは Google Cloud CLI を使用して、カタログ、名前空間、テーブルレベルできめ細かい Identity and Access Management(IAM)ポリシーを適用できます。認証情報の提供は、圧縮、スナップショットの有効期限、ガベージ コレクションなどのバックグラウンド メンテナンス タスクの自動テーブル管理を有効にするためにも必要です。
認証情報ベンディングの仕組み
認証情報の自動販売を使用すると、ストレージにアクセスする前にポリシーを適用するように、オペレーションのシーケンスが若干変更されます。次の図は、クエリエンジンがカタログからスコープを縮小したストレージ トークンを取得し、Cloud Storage でデータを直接読み書きする方法を示しています。
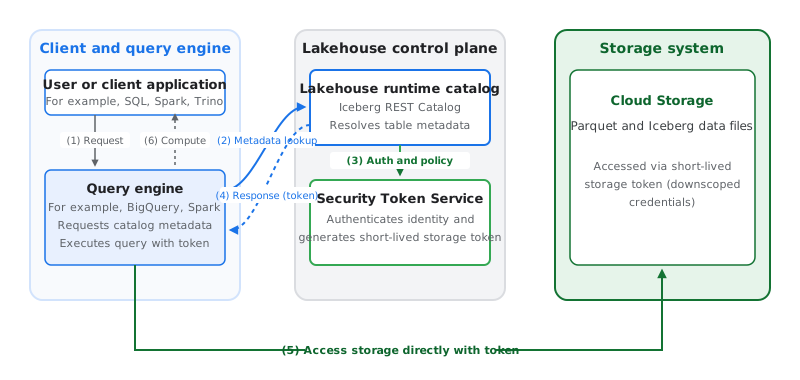
上の図に示されているオペレーションのシーケンスは次のとおりです。
- リクエスト: ユーザーが、クエリ、DML、DDL オペレーションなどの SQL ステートメントを、Apache Spark や BigQuery などのサポートされているエンジンに送信します。
- メタデータ検索: エンジンは、テーブルを解決するために Lakehouse ランタイム カタログにリクエストを送信します。
- 認証とポリシー: カタログはユーザーを認証し、レイクハウス リソースに対する IAM 権限を確認します。
- レスポンス: 認証情報の自動販売が有効になっているため、カタログはメタデータと有効期間の短いストレージ トークン(スコープを縮小したストレージ認証情報)をエンジンに返します。トークンのスコープは、テーブルに関連付けられたパスに設定され、必要最小限の権限にダウンスコープされます(たとえば、ファイルの書き込みを必要としないクエリの読み取り専用アクセス)。
- アクセス: エンジンは、このトークンを使用して、特定の承認済みファイルを Cloud Storage から直接読み取りまたは書き込みます。
- コンピューティング: エンジンがデータを処理するか、オペレーションを実行して、結果を返します。
自動テーブル管理(gcp.biglake.table-management.enabled)が有効になっている場合、コンパクション、スナップショットの有効期限、ガベージ コレクションなどのバックグラウンド メンテナンス タスクは、カタログの自動プロビジョニングされたサービス アカウントを使用して Cloud Storage に対して直接認証し、基盤となるデータファイルを更新します。
サポートされているエンジン
クエリエンジンで認証情報の自動販売を使用するには、認証情報の自動販売をサポートするように Lakehouse ランタイム カタログで Apache Iceberg REST カタログ エンドポイントを構成する必要があります。Apache Hive カタログ エンドポイントでは、認証情報の自動販売はサポートされていません。
- オープンソース エンジン: Spark や Trino などのサポートされているエンジンは、カタログから提供される有効期間の短いストレージ トークンを使用します。クライアント アプリケーションは、
X-Iceberg-Access-Delegationヘッダーで認証情報の提供のサポートを指定する必要があります。 - BigQuery: BigQuery は、エンドユーザーの認証情報の代わりに、Cloud Storage アクセスにベンダー認証情報を使用します。
サービス アカウントに必要な権限
認証情報の提供が有効になっている場合は、次のサービス アカウントに必要なロールが付与されていることを確認します。
- 自動プロビジョニングされた Lakehouse ランタイム カタログ サービス アカウント: 関連付けられているすべての Cloud Storage バケットで、このアカウントに Storage オブジェクト ユーザーのロール(
roles/storage.objectUser)を付与する必要があります。このアクセス権がないと、提供された認証情報でストレージの読み取りや書き込みを行うことができません。 Google Cloud コンソールを使用している場合は、[バケットの権限を設定] をクリックすると、このロールが確認されます。gcloud CLI、Terraform、または API の場合は、このロールを手動で付与する必要があります。 - クエリエンジン サービス アカウント: クエリエンジン ジョブ(Managed Service for Apache Spark、Managed Service for Apache Spark、Dataflow など)を実行するサービス アカウントには、書き込みスコープを持つベンダー認証情報を取得するために、BigLake 編集者ロール(
roles/biglake.editor)が必要です。
次のステップ
- 認証情報自動販売モードでカタログを作成する方法を学習する。
- Google Cloud コンソールを使用して既存のカタログの認証情報の提供を有効にする方法を確認する。
- 認証情報の自動販売用にクライアント アプリケーションを構成する方法を確認する。