


Il catalogo runtime Lakehouse è un metastore serverless e unificato che semplifica la gestione dei metastore Hive autogestiti. Questo singolo livello di metadati completamente gestito elimina la necessità di archivi di metadati separati per i carichi di lavoro open source. Ti consente di condividere facilmente i dati tra Apache Spark, Apache Hive e BigQuery.
Ottimizzata per la compatibilità con ExternalCatalog di Apache Spark, questa integrazione supporta un sottoinsieme dell'interfaccia Hive Metastore. Per verificare se i tuoi carichi di lavoro
dipendono da funzionalità non supportate come transazioni, compattazioni o Kerberos,
consulta il confronto delle funzionalità e le limitazioni.
In che modo Hive si integra con il catalogo runtime Lakehouse
L'endpoint del metastore Hive gestisce le tabelle standard di Apache Hive e Spark (utilizzando le origini dati Hive SerDes o Spark) anziché le tabelle Apache Iceberg. Per semplificare la connessione dei job Spark a questo endpoint, le immagini di Managed Service for Apache Spark sono preconfigurate con le librerie client e le dipendenze necessarie.
La seguente sequenza descrive in che modo Spark si connette al metastore:
- Apache Spark si connette ai cataloghi di metadati esterni utilizzando l'interfaccia
IMetastoreClientstandard di Apache Hive. - Il catalogo runtime Lakehouse implementa un
IMetastoreClientpersonalizzato per fornire un servizio di metastore completamente gestito per i metadati di Spark e Hive. - I runtime preconfigurati di Managed Service for Apache Spark utilizzano automaticamente questo client personalizzato per indirizzare le operazioni sui metadati direttamente al metastore.
Dopo la configurazione, puoi eseguire query sulle tabelle create da Spark direttamente in BigQuery. Questa integrazione supporta vari formati di archiviazione, come Parquet, ORC e Avro, insieme a mappature di tipi di dati specifici tra Spark e BigQuery.
In che modo il catalogo Hive si integra con Google Cloud i servizi
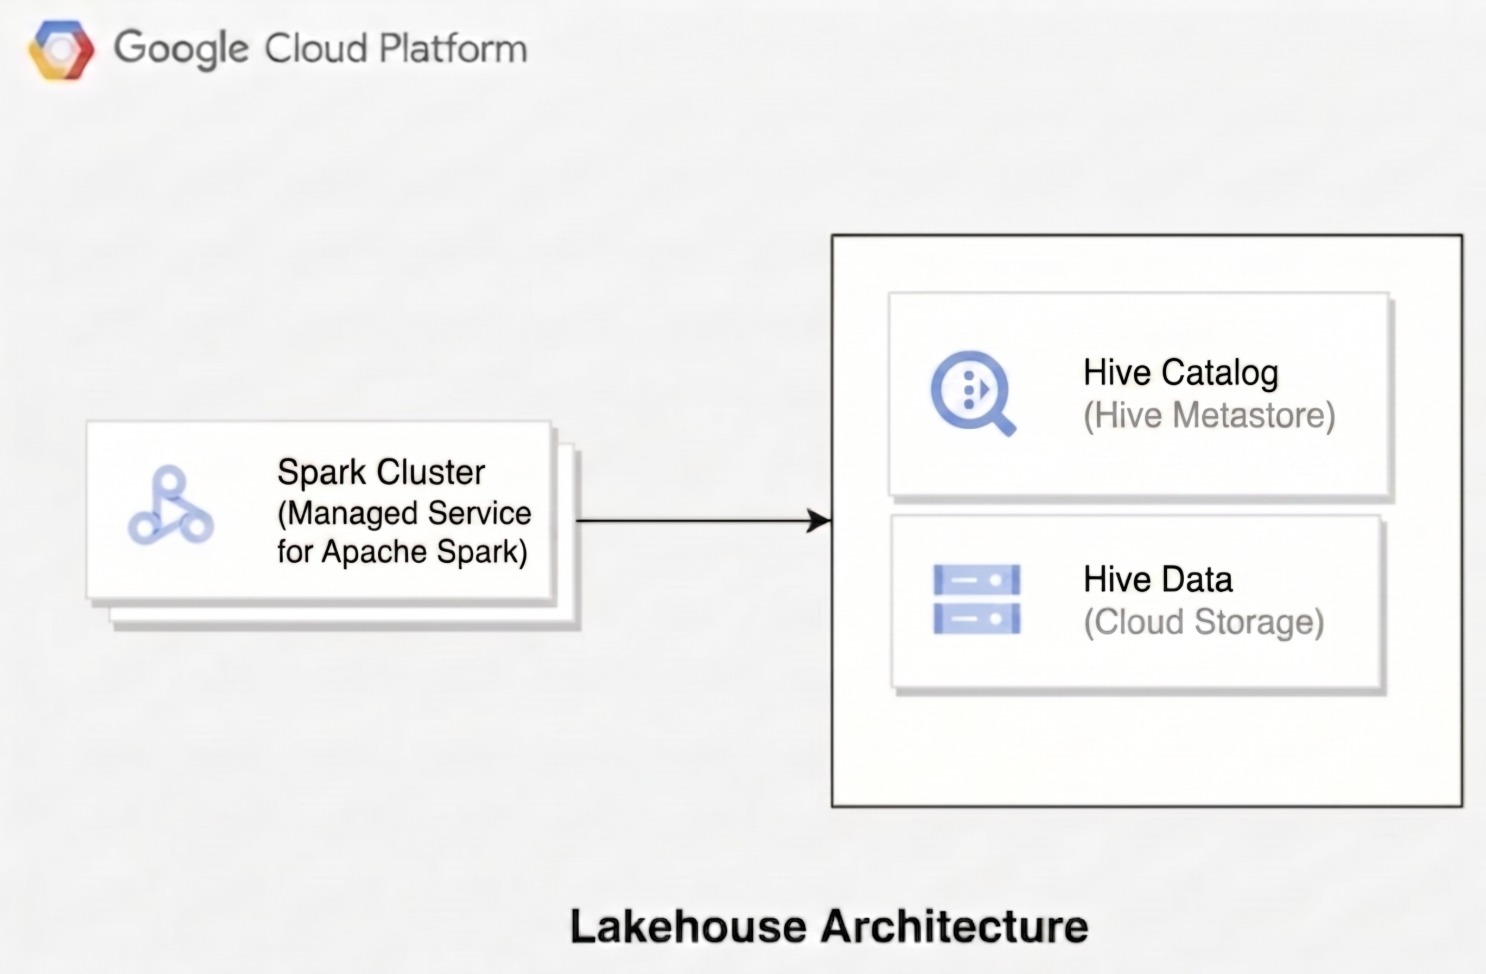
Per capire in che modo Lakehouse senza confini gestisce i tuoi dati, scopri come l'architettura del catalogo Hive si integra con i Google Cloud servizi. Anziché gestire i metastore autogestiti, i carichi di lavoro open source si connettono al catalogo runtime Lakehouse per gestire le definizioni di database e tabelle Hive, mentre i file di dati sottostanti vengono archiviati direttamente nelle directory del warehouse di Cloud Storage.
Il seguente diagramma illustra in che modo i motori di calcolo come Managed Service for Apache Spark utilizzano il catalogo runtime Lakehouse per gestire i metadati delle tabelle durante la lettura e la scrittura dei file di dati sottostanti direttamente in Hive.
Confronto delle funzionalità con Hive Metastore
La seguente tabella mette a confronto le entità e le operazioni in Hive Metastore e Lakehouse:
| Entità o operazione | Hive Metastore | Catalogo runtime Lakehouse |
|---|---|---|
| Catalogo | ✅ | ✅ |
| Database (crea, elimina, aggiorna) | ✅ | ✅ |
| Tabella (crea, elimina, aggiorna) | ✅ | ✅ |
| Partizione (aggiungi, elimina, aggiorna) | ✅ | ✅ |
| Privilegi delle tabelle | ✅ | ✅ (tramite Identity and Access Management (IAM)) |
| Privilegi delle partizioni | ✅ | ✅ (tramite IAM) |
| Funzioni definite dall'utente | ✅ | Non supportata |
| Colonne di bucket / skewing | ✅ | Non supportata |
| Statistiche delle colonne di tabelle e partizioni | ✅ | Non supportata |
| Limitazioni principali | ✅ | Non supportata |
| Token di delega (Kerberos) | ✅ | Non supportata |
| Privilegi delle colonne | ✅ | Non supportata |
| Ruoli | ✅ | Non supportata |
| Piani di risorse di Workload Manager | ✅ | Non supportata |
| Transazioni e compattazioni | ✅ | Non supportata |