


借助跨云数据访问功能,您可以直接从 Google Cloud 查询存储在其他云服务商中的数据,而无需迁移文件或构建复杂的 ETL 流水线。查询可以通过公共互联网路由,也可以使用跨云互连进行专用网络传输。
作为无边界湖仓一体的一部分,此功能通过 BigQuery、独立 Apache Spark 环境或 Managed Service for Apache Spark 统一分布式数据集的分析和 AI 工作负载。
除了运行分析查询之外,您还可以构建基于分布式表(包括跨云来源)的对话式分析智能体,以便通过单次对话分析跨云数据。您还可以使用 Knowledge Catalog 跨远程平台进行数据分析和数据洞见。
使用场景
Lakehouse 支持多种关键应用场景,可用于访问多个云服务提供商的数据:
- 减少数据移动,让您可以直接查询存储在其他云环境中的数据,从而简化数据访问和处理。
- 统一分析可让您对所有数据执行高级分析,无论数据位于何处,都能获得一致的功能和硬件优化。
- 无边界 AI 和机器学习可让您直接将 AI 模型、自主代理和机器学习应用于远程数据,而无需迁移数据。
架构
下图展示了 Lakehouse 跨云数据访问架构:
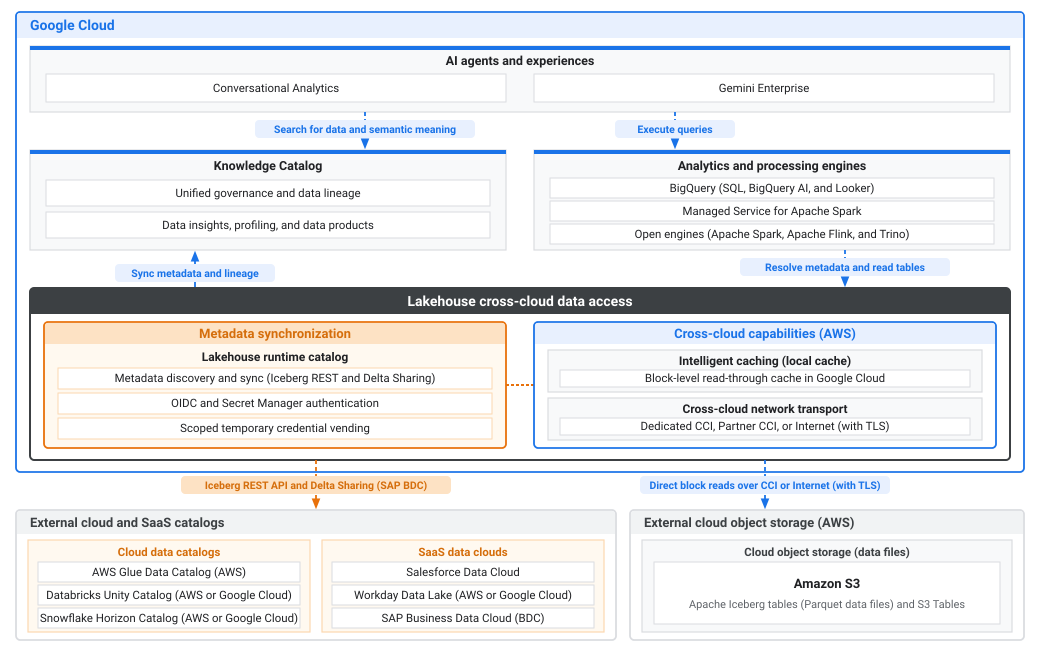
上图展示了 Google Cloud 与外部云和 SaaS 环境之间的架构:
- Google Cloud:提供 AI、治理、分析和跨远程数据集的跨云数据访问:
- AI 智能体和体验:在对话式分析和 Gemini Enterprise 中构建自主智能体,这些智能体可在 Knowledge Catalog 中搜索数据和语义,并通过分析和处理引擎执行查询。
- Knowledge Catalog:通过同步 Lakehouse 中的元数据和沿袭,提供统一治理和数据沿袭,以及数据洞见、数据分析和数据产品。
- 分析和处理引擎:运行 BigQuery SQL、BigQuery AI 和 Looker 工作负载,或通过 Lakehouse 解析元数据和读取表,使用 Managed Service for Apache Spark 和开放引擎(Apache Spark、Apache Flink 和 Trino)处理远程数据。
- Lakehouse 跨云数据访问:就地查询远程数据,无需文件迁移或 ETL 流水线:
- 元数据同步:使用 Lakehouse 运行时目录通过 Apache Iceberg REST 和 Delta Sharing 发现并同步表元数据,通过 OpenID Connect (OIDC) 或 Secret Manager 进行身份验证,并提供限定范围的临时凭证。
- 跨云功能 (AWS):使用块级直读缓存(智能缓存 [本地缓存])在 Google Cloud 中缓存读取的数据块,并使用跨云网络传输通过专用跨云互连 (CCI)、合作伙伴互连或互联网(使用 TLS)路由流量。
- 外部云和 SaaS 数据源:托管远程目录、SaaS Data Cloud 和对象存储区:
- 外部云和 SaaS 目录:通过 Iceberg REST API 和 Delta Sharing(适用于 SAP BDC),同步云数据目录(AWS 上的 AWS Glue Data Catalog,以及 AWS 或 Google Cloud上的 Databricks Unity Catalog 和 Snowflake Horizon Catalog)和 SaaS 数据云(Salesforce Data Cloud、AWS 或Google Cloud上的 Workday Data Lake,以及 SAP Business Data Cloud [BDC])中的元数据。
- 外部云对象存储 (AWS):在 Amazon S3 中存储 Apache Iceberg 表(Parquet 数据文件)和 Amazon S3 表,以便通过 CCI 或互联网(使用 TLS)直接读取块。
访问跨云数据的运作方式
Lakehouse 使用以下流程查询远程数据:
- 元数据发现: Google Cloud的 Lakehouse 会连接到远程 Apache Iceberg REST 目录,例如 Databricks Unity 或 AWS Glue。Lakehouse 会发现数据,而无需复制任何文件。根据远程目录提供商的不同,Lakehouse 会通过 Secret Manager 或 OIDC 令牌联合(以 Google 作为身份提供商)进行安全身份验证。
- 安全传输:与公共互联网相比,选择通过专用互连(例如专用 CCI 或合作伙伴互连)路由流量可显著降低数据传输费用,并使延迟时间高度可预测。
- 优化执行:当查询从远程云端读取数据时,Lakehouse 会将这些数据段临时缓存在 Google Cloud 内的专用存储空间中。后续查询会使用本地缓存,从而避免产生大部分跨云出站流量费用。
支持的目录
Lakehouse 支持查询来自以下远程目录提供商的数据:
- Databricks Unity Catalog:托管在 Amazon Web Services (AWS) 或 Google Cloud上。
- AWS Glue:托管在 AWS 上。
- Snowflake Horizon 目录:托管在 AWS 或 Google Cloud上。
- Workday 数据湖:托管在 AWS 或 Google Cloud上。
- SAP Business Data Cloud (BDC):托管在 AWS、Microsoft Azure 或 Google Cloud 上,使用 SAP BDC 连接器。
核心概念
本部分介绍了使用跨云数据访问功能所必需的关键组件。
元数据层
元数据层会连接到远程 Apache Iceberg REST 目录端点,以根据刷新间隔同步 Iceberg 资源(命名空间、表)元数据。Lakehouse 使用存储在 Secret Manager 或 OIDC 令牌联合中的 OAuth 凭证进行安全身份验证。
传输层
传输层允许 BigQuery 和开源引擎使用元数据层中的同步元数据来查询数据。对于某些类型的远程目录,Lakehouse 支持通过公共互联网或专用私有互连查询数据。
选择符合您的架构和安全要求的传输方法:
客户自有 (CCI)
您可以将 BigQuery 配置为使用专用 Cross-Cloud Interconnect 或合作伙伴 Cross-Cloud Interconnect,通过专用跨云互连查询存储在 AWS Amazon S3 存储桶中的数据。
使用专用互连具有以下优势:
- 增强了安全性:数据通过 Google Cloud 与 AWS 之间的专用网络连接传输,避免了公共互联网。
- 降低费用:与互联网出站流量相比,AWS 的出站流量费用可能更低,尤其是在与专用互连容量结合使用时。
- 性能稳定:与公共互联网相比,网络延迟时间和带宽更可预测。
架构概览
如需启用私密查询,您需要通过专用互连配置从 BigQuery 到 AWS Amazon S3 存储桶的路径。 Google Cloud虚拟私有云 (VPC) 中的一个关键组件是内部负载均衡器 (ILB)。ILB 将来自 BigQuery 的请求分发到 AWS VPC 中 Amazon S3 的专用端点,这些端点是使用 AWS PrivateLink 预配的。
使用具有多个弹性网络接口 (ENI) 作为后端的 ILB 对于负载均衡、可伸缩性和高可用性至关重要。无论您使用的是专用 CCI 还是合作伙伴互连,此限制都适用。
不公开查询工作流遵循以下流程:
- BigQuery 使用配置了 Service Directory 服务的连接。
- Service Directory 会将服务名称解析为 Google Cloud ILB 的内部 IP 地址。
- ILB 接收来自 BigQuery 的请求,并将其分发到配置的后端。
- ILB 后端是混合连接网络端点组 (NEG),每个后端都指向 AWS VPC 中 ENI 的专用 IP 地址。
- 流量从 ILB 流经 NEG,通过专用互连流向 AWS ENI。
- AWS ENI 是 Amazon S3 VPC 接口端点 (AWS PrivateLink) 的一部分,可提供对 Amazon S3 服务的私密访问。
公共互联网(无 CCI)
如果您未配置专用互连,则默认情况下,对远程目录的查询会通过公共互联网传输。
通过公共互联网查询数据时,请考虑以下影响:
- 标准加密:数据访问请求和数据传输在通过公共互联网传输时,会使用标准 TLS 协议进行加密。
- 出站流量费用:数据传输会产生远程云服务商(例如 AWS)的标准互联网出站流量费用,这些费用通常高于专用互连出站流量费率。
- 延迟时间可变:网络性能、带宽和延迟时间取决于公共互联网路由和拥塞情况,因此与专用互连相比,查询执行时间的可预测性较低。
- 设置简单:无需在 Google Cloud 或远程云服务商中配置额外的网络基础架构、VPC 对等互连或 Service Directory。
架构概览
通过公共互联网查询数据时,Lakehouse 会直接连接到远程目录和对象存储区端点,而无需专用 Google Cloud 或远程云网络基础设施。
公共互联网查询工作流遵循以下流程:
- BigQuery 会针对 Lakehouse 目录中定义的远程表发起查询。
- Lakehouse 使用存储在 Secret Manager 或 OIDC 令牌联合中的凭据,安全地向远程 Apache Iceberg 目录进行身份验证。
- Lakehouse 通过公共互联网检索表元数据和清单文件,以识别相关的底层数据文件(例如,在 AWS Amazon S3 中)。
- 针对底层对象的数据访问请求会使用标准 TLS 加密通过公共互联网直接从Google Cloud 发送。
- 远程存储服务使用 Lakehouse 提供的临时、限定范围的凭据验证请求,并通过公共互联网将请求的数据块返回给 Google Cloud。
智能缓存
当您查询远程云数据时,Lakehouse 会自动在 Google Cloud本地缓存检索到的数据块。系统会自动为所有跨云查询启用缓存,以帮助最大限度地减少远程云服务提供商的出站流量费用。后续针对缓存数据的查询会直接从本地 Google Cloud 存储空间读取,而不会跨云重新提取数据。
出站流量费用节省
在初始查询执行时,Lakehouse 会从远程云服务商提取所需的数据块,并填充本地缓存。后续针对同一数据块的查询会直接从本地Google Cloud 缓存中读取,而无需跨云重新提取数据。
对于在同一数据集上具有重复查询句式的工作负载,缓存通过从本地存储空间传送数据请求来减少跨云出站流量费用。实际节省的出站流量费用取决于查询访问模式、数据修改率和目标 Google Cloud区域中的缓存保留等因素。
在作业统计信息中验证缓存使用情况和出站流量费用节省情况
如需验证查询的缓存命中率和出站流量费用节省情况,请在 BigQuery 控制台或 API (JobStatistics2) 中检查查询统计信息。由于查询可以引用多个提供商的数据,因此作业统计信息会提供一个重复的 object_storage_stats (objectStorageStats) 字段,其中包含执行期间访问的每个云提供商的条目。
每个 object_storage_stats 条目都会报告以下指标:
cloud_provider(cloudProvider):托管对象存储区的云服务商(例如AWS或AZURE)。cache_bytes_read(cacheBytesRead):从本地 Google Cloud 缓存读取的总字节数,避免了远程对象存储区读取。object_storage_bytes_read(objectStorageBytesRead):直接从远程云提供方对象存储区读取的总字节数。
数据驻留和管辖权注意事项
在 Google Cloud 区域中创建远程目录或连接会将静态缓存数据存储在目标区域本地。
如果您的远程云数据位于不同的地理区域或管辖区(例如,欧盟境内的 AWS Amazon S3 与 us-east4 中的 BigQuery 计算配对),则跨云查询会将远程数据的静态缓存副本存储在目标Google Cloud 区域中。创建连接或目录的用户或管理员必须确保跨管辖区缓存符合其组织的数据驻留、主权和合规性要求。
加密和 CMEK 支持
Lakehouse 缓存不支持客户管理的加密密钥 (CMEK)。 所有缓存的数据块都会使用默认的Google-owned and Google-managed encryption keys进行静态加密。
如果您的组织强制执行限制非 CMEK 服务组织政策限制条件 (constraints/gcp.restrictNonCmekServices),Lakehouse 会自动为访问受限表的查询停用缓存。查询仍会成功执行,但不会缓存数据块,也不会受益于与缓存相关的出站流量节省。
后续步骤
- 为 AWS Glue、Databricks Unity Catalog、Snowflake Horizon Catalog、Workday Data Lake 或 SAP Business Data Cloud 设置跨云连接。