


クロスクラウド データアクセス機能を使用すると、ファイルを移行したり、Cross-Cloud Interconnect で複雑な ETL パイプラインを構築したりすることなく、他の クラウド プロバイダに保存されているデータを直接 Google Cloud クエリできます。
ボーダーレス レイクハウス の一部として、この機能を使用すると、 BigQuery、スタンドアロンの Apache Spark 環境、または Managed Service for Apache Spark を使用して、分散データセット全体で 統合分析を実行し、AI を適用できます。
分析クエリに加えて、リモートデータを AI ドリブンな分析情報とガバナンスに使用できます。
- 会話分析: クロスクラウド テーブルなど、正確なデータソースに基づいて特殊なエージェントを構築し、1 回の会話でクラウド全体のデータを分析します。
- Knowledge Catalog: Knowledge Catalog の機能を使用して、リモート データソースのデータ プロファイリングと分析を行います。
ユースケース
Lakehouse は、複数のクラウド プロバイダのデータにアクセスするためのいくつかの主要なユースケースをサポートしています。
- データ移動の削減 により、他のクラウド環境に保存されているデータを直接クエリできるため、データアクセスと処理が簡素化されます。
- 統合分析 により、データの保存場所に関係なく、すべてのデータに対して一貫した機能とハードウェアの最適化を使用して高度な分析を実行できます。
- ボーダーレス AI と ML により、AI モデル、自律型エージェント、機械学習をリモートデータに直接適用できます。データを移行する必要はありません。
アーキテクチャ
次の図は、Lakehouse のクロスクラウド データアクセス アーキテクチャを示しています。
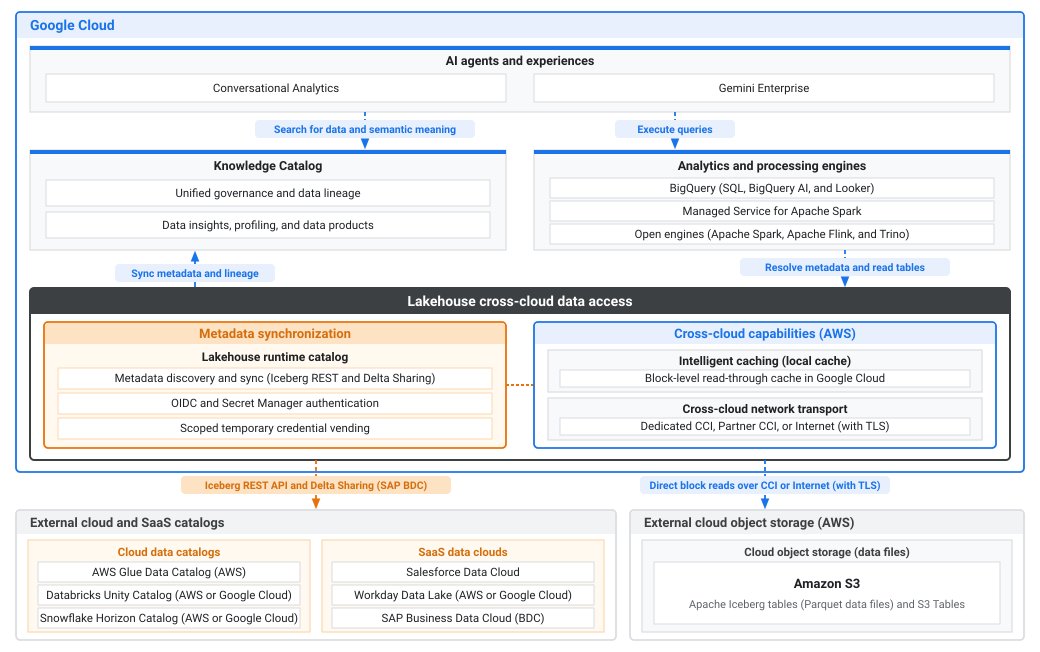
上の図は、 Google Cloud と 外部クラウド環境および SaaS 環境のアーキテクチャを示しています。
- Google Cloud: リモート データセット全体で AI、ガバナンス、分析、クロスクラウド データアクセスを提供します。
- AI エージェントとエクスペリエンス: 会話分析と Gemini Enterprise で自律型エージェントを構築します。このエージェントは、Knowledge Catalog でデータとセマンティックな意味を検索し、分析エンジンと処理エンジンを介してクエリを実行します。
- Knowledge Catalog: Lakehouse からメタデータとリネージを同期することで、 統合ガバナンスとデータリネージ、 データ インサイト、プロファイリング、 データプロダクトを提供します。
- 分析エンジンと処理エンジン: BigQuery SQL、 BigQuery AI、Looker ワークロードを実行します。または、 Lakehouse を介してメタデータを解決し、テーブルを読み取ることで、Managed Service for Apache Spark とオープン エンジン (Apache Spark、Apache Flink、Trino)を使用して リモートデータを処理します。
- Lakehouse クロスクラウド データアクセス: ファイルの移行や ETL パイプラインを行わずに、リモート
データをインプレースでクエリします:
- メタデータの同期: Lakehouse ランタイム カタログを使用して、Apache Iceberg REST と Delta Sharing を介してテーブル メタデータを検出して同期します。 OpenID Connect(OIDC)または Secret Manager を介して認証し、スコープ付きの一時的な認証情報を販売します。
- クロスクラウド機能(AWS): ブロックレベルのリードスルー キャッシュ(インテリジェント キャッシュ(ローカル キャッシュ))を使用して、読み取られたデータ ブロックを Google Cloud にキャッシュし、クロスクラウド ネットワーク転送 を使用して、 Dedicated Cross-Cloud Interconnect(CCI)、 Partner Interconnect、またはインターネット(TLS を使用)を介してトラフィックをルーティングします。
- 外部クラウドと SaaS のデータソース : リモート カタログ、SaaS
データクラウド、オブジェクト ストレージをホストします。
- 外部クラウドと SaaS のカタログ: Iceberg REST API と Delta Sharing(SAP BDC の場合)を介して、クラウド データカタログ (AWS の AWS Glue Data Catalog、および AWS または Google Cloudの Databricks Unity Catalog と Snowflake Horizon Catalog)とSaaS データクラウド (Salesforce Data Cloud、AWS または Google Cloudの Workday Data Lake、SAP Business Data Cloud(BDC))からメタデータを同期します。
- 外部クラウド オブジェクト ストレージ(AWS): Apache Iceberg テーブル(Parquet データファイル)と Amazon S3 テーブルを Amazon S3 に保存し、CCI またはインターネット(TLS を使用)を介してブロック読み取りを直接行います。
クロスクラウド データへのアクセス方法
Lakehouse は、次のプロセスを使用してリモートデータをクエリします。
- メタデータの検出: Google Cloud's Lakehouse は、Databricks Unity や AWS Glue などのリモート Apache Iceberg REST カタログに接続します。Lakehouse は、ファイルをコピーせずにデータを検出します。リモート カタログ プロバイダに応じて、Lakehouse は Secret Manager または OIDC トークン フェデレーションを介して、Google を ID プロバイダとして安全に認証します。
- 安全な転送: プライベート Interconnect(Dedicated CCI や Partner Interconnect など)を介してトラフィックをルーティングすると、公共のインターネットと比較してデータ転送の費用が大幅に削減され、レイテンシを予測しやすくなります。
- 最適化された実行: クエリがリモートクラウドからデータを読み取ると、 Lakehouse はこれらのデータセグメントを一時的にローカル キャッシュします Google Cloud の特殊なストレージに。後続のクエリではローカル キャッシュが使用されるため、クロスクラウドの下り(外向き)料金の大部分を回避できます。
サポートされているカタログ
Lakehouse は、次のリモート カタログ プロバイダからのデータのクエリをサポートしています。
- Databricks Unity Catalog: Amazon Web Services(AWS)または でホストされます Google Cloud.
- AWS Glue: AWS でホストされます。
- Snowflake Horizon カタログ: AWS または でホストされます Google Cloud。
- Workday データレイク: AWS または でホストされます Google Cloud.
- SAP Business Data Cloud(BDC): SAP BDC コネクタを使用して、AWS、Microsoft Azure、または Google Cloud でホストされます。
基本コンセプト
このセクションでは、クロスクラウド データアクセス機能を使用するために不可欠な主要コンポーネントについて説明します。
メタデータ レイヤ
メタデータ レイヤは、リモート Apache Iceberg REST カタログ エンドポイントに接続し、更新間隔に基づいて Iceberg リソース(名前空間、テーブル)のメタデータを同期します。Lakehouse は、Secret Manager または OIDC トークン フェデレーションに保存されている OAuth 認証情報を使用して安全に認証します。
トランスポート層
トランスポート層を使用すると、BigQuery とオープンソース エンジンは、メタデータ レイヤから同期されたメタデータを使用してデータをクエリできます。 特定のタイプのリモート カタログの場合、Lakehouse は公共のインターネットまたは専用のプライベート Interconnect を介したデータのクエリをサポートしています。
アーキテクチャとセキュリティの要件に合った転送方法を選択します。
お客様所有(CCI)
BigQuery を構成して、プライベート Cross-Cloud Interconnect を介して AWS Amazon S3 バケットに保存されているデータを、Dedicated Cross-Cloud Interconnect または Partner Cross-Cloud Interconnect を使用してクエリできます。
プライベート Interconnect を使用すると、次のメリットがあります。
- セキュリティの強化: データは Google Cloud と AWS 間のプライベート ネットワーク接続を介して転送され、公共の インターネットは使用されません。
- コストの削減: インターネットの下り(外向き)と比較して、AWS からの下り(外向き)料金が低くなる可能性があります。特に、プライベート Interconnect の容量と組み合わせた場合は、その可能性が高くなります。
- 一貫したパフォーマンス: 公共のインターネットと比較して、ネットワークのレイテンシと帯域幅を予測しやすくなります。
アーキテクチャの概要
プライベート クエリを有効にするには、プライベート Interconnect を介して BigQuery から AWS Amazon S3 バケットへのパスを構成します。Virtual Private Cloud(VPC)(VPC)の主要コンポーネントは、 Google Cloud 内部ロードバランサ(ILB)です。ILB は、BigQuery から AWS VPC 内の Amazon S3 のプライベート エンドポイントにリクエストを分散します。これらのエンドポイントは、AWS PrivateLink を使用してプロビジョニングされます。
複数の Elastic Network Interface(ENI)をバックエンドとして使用する ILB は、ロード バランシング、スケーラビリティ、高可用性に不可欠です。これは、Dedicated CCI を使用する場合でも、Partner Interconnect を使用する場合でも適用されます。
プライベート クエリのワークフローは次のプロセスに従います。
- BigQuery は、Service Directory サービスで構成された接続を使用します。
- Service Directory は、サービス名を ILB の Google Cloud 内部 IP アドレスに解決します。
- ILB は BigQuery からリクエストを受信し、構成されたバックエンドに分散します。
- ILB バックエンドはハイブリッド接続ネットワーク エンドポイント グループ(NEG)です。各 NEG は、AWS VPC 内の ENI のプライベート IP アドレスを指します。
- トラフィックは ILB から NEG を経由して、プライベート Interconnect を介して AWS ENI に流れます。
- AWS ENI は、Amazon S3 VPC インターフェース エンドポイント(AWS PrivateLink)の一部であり、Amazon S3 サービスへのプライベート アクセスを提供します。
公共のインターネット(CCI なし)
プライベート Interconnect を構成しない場合、リモート カタログへのクエリはデフォルトで公共のインターネットを介して転送されます。
公共のインターネットを介してデータをクエリする場合は、次の影響を考慮してください。
- 標準暗号化: データアクセス リクエストとデータ転送は、公共のインターネットを介して標準の TLS プロトコルを使用して転送中に暗号化されます。
- 下り(外向き)の費用: データ転送には、リモート クラウド プロバイダ(AWS など)から標準のインターネット下り(外向き)料金が発生します。通常、この料金はプライベート Interconnect の下り(外向き)料金よりも高くなります。
- レイテンシの変動: ネットワーク パフォーマンス、帯域幅、レイテンシは、公共のインターネットのルーティングと輻輳に依存するため、専用のプライベート Interconnect と比較して、クエリの実行時間を予測しにくくなります。
- 設定の簡素化: Google Cloud または リモート クラウド プロバイダで、追加のネットワーク インフラストラクチャ、 VPC ピアリング、Service Directory の構成は必要ありません。
アーキテクチャの概要
公共のインターネットを介してデータをクエリする場合、Lakehouse はプライベート Google Cloud またはリモート クラウド ネットワーキング インフラストラクチャを必要とせずに、リモート カタログとオブジェクト ストレージ エンドポイントに 直接接続します。
公共のインターネット クエリのワークフローは次のプロセスに従います。
- BigQuery は、Lakehouse カタログで定義されたリモートテーブルに対してクエリを開始します。
- Lakehouse は、Secret Manager または OIDC トークン フェデレーションに保存されている認証情報を使用して、リモート Apache Iceberg カタログで安全に認証します。
- Lakehouse は、公共のインターネットを介してテーブル メタデータとマニフェスト ファイルを取得し、関連する基盤となるデータファイル(AWS Amazon S3 など)を特定します。
- 基盤となるオブジェクトのデータアクセス リクエストは、標準の TLS 暗号化を使用して、公共のインターネットを介して Google Cloud から直接送信されます。
- リモート ストレージ サービスは、Lakehouse によって販売された一時的なスコープ付き 認証情報を使用してリクエストを検証し、リクエストされた データブロックを公共のインターネットを介して に返します Google Cloud.
インテリジェント キャッシュ
リモートクラウドデータをクエリすると、Lakehouse は取得したデータブロックを自動的に のローカルにキャッシュします Google Cloud。リモート クラウド プロバイダからの下り(外向き)料金を最小限に抑えるため、すべてのクロスクラウド クエリでキャッシュが自動的に有効になります。キャッシュされたデータを対象とする後続のクエリは、ローカル Google Cloud ストレージから直接 読み取ります。クラウド間でデータを再取得するのではなく、クラウド から直接読み取ります。
下り(外向き)の費用削減
最初のクエリ実行時に、Lakehouse は必要なデータブロックをリモート クラウド プロバイダから取得し、ローカル キャッシュにデータを入力します。 同じデータブロックを対象とする後続のクエリは、クラウド間でデータを再取得するのではなく、ローカル Google Cloud キャッシュから直接読み取ります。
同じデータセットに対してクエリ パターンが繰り返されるワークロードの場合、キャッシュを使用すると、ローカル ストレージからデータ リクエストを処理することで、クロスクラウドの下り(外向き)料金を削減できます。 実際の下り(外向き)の費用削減額は、クエリ アクセス パターン、 データ変更率、ターゲット Google Cloud リージョンでのキャッシュ保持などの要因によって異なります。
ジョブ統計情報でキャッシュの使用状況と下り(外向き)の費用削減額を確認する
クエリのキャッシュ ヒット率と下り(外向き)の費用削減額を確認するには、BigQuery コンソールまたは API(JobStatistics2)でクエリ統計情報を確認します。クエリは複数のプロバイダのデータを参照できるため、ジョブ統計情報には、実行中にアクセスしたクラウド プロバイダごとにエントリを含む object_storage_stats(objectStorageStats)フィールドが繰り返し表示されます。
各 object_storage_stats エントリには、次の指標が報告されます。
cloud_provider(cloudProvider): オブジェクト ストレージをホストするクラウド プロバイダ(AWSやAZUREなど)。cache_bytes_read(cacheBytesRead): ローカル Google Cloud キャッシュから読み取られた合計バイト数。リモート オブジェクト ストレージの読み取りは回避されます。object_storage_bytes_read(objectStorageBytesRead): リモート クラウド プロバイダのオブジェクト ストレージから直接読み取られた合計バイト数。
データ所在地と管轄区域に関する考慮事項
リージョンに Google Cloud リモート カタログまたは接続を作成すると、キャッシュされた保存データがそのターゲット リージョン内にローカルに保存されます。
リモートクラウドデータが異なる地理的リージョンまたは
管轄区域(欧州
連合の AWS Amazon S3 と us-east4 の BigQuery コンピューティングなど)に存在する場合、クロスクラウド
クエリは、リモートデータのキャッシュされた保存データのコピーをターゲット
Google Cloud リージョンに保存します。接続またはカタログを作成するユーザーまたは管理者は、管轄区域をまたぐキャッシュが、組織のデータ所在地、主権、コンプライアンスの要件を満たしていることを確認する必要があります。
暗号化と CMEK のサポート
Lakehouse キャッシュでは、顧客管理の暗号鍵(CMEK)はサポートされていません。 キャッシュされたデータブロックはすべて、デフォルトの Google-owned and Google-managed encryption keysを使用して保存データの暗号化が行われます。
組織で非 CMEK サービスの制限 組織のポリシー制約(constraints/gcp.restrictNonCmekServices)が適用されている場合、Lakehouse は制限付きテーブルにアクセスするクエリのキャッシュを自動的に無効にします。クエリは正常に実行されますが、データブロックはキャッシュされず、キャッシュ関連の下り(外向き)の削減のメリットはありません。
次のステップ
- AWS Glue、 Databricks Unity Catalog、 Snowflake Horizon Catalog、 Workday Data Lake、または SAP Business Data Cloudのクロスクラウド接続を設定する。