


La funzionalità di accesso ai dati cross-cloud ti consente di eseguire query sui dati archiviati in altri provider di servizi cloud direttamente da Google Cloud senza eseguire la migrazione dei file o creare pipeline ETL complesse con Cross-Cloud Interconnect.
Nell'ambito di Lakehouse senza confini, questa funzionalità ti consente di eseguire analisi unificate e applicare l'AI ai set di dati distribuiti utilizzando BigQuery, ambienti Apache Spark autonomi o Managed Service for Apache Spark.
Oltre alle query analitiche, puoi utilizzare i dati remoti per insight e governance basati sull'AI:
- Analisi conversazionale: crea agenti specializzati basati sulle tue origini dati esatte, incluse le tabelle cross-cloud, per analizzare i dati su più cloud da una singola conversazione.
- Knowledge Catalog: Utilizza le funzionalità di Knowledge Catalog per la profilazione dei dati e gli insight con origini dati remote.
Casi d'uso
Lakehouse supporta diversi casi d'uso chiave per l'accesso ai dati su più provider di servizi cloud:
- La riduzione dello spostamento dei dati ti consente di eseguire query sui dati archiviati in altri ambienti cloud direttamente, semplificando l'accesso e l'elaborazione dei dati.
- L'analisi unificata ti consente di eseguire analisi avanzate con funzionalità coerenti e ottimizzazione hardware su tutti i tuoi dati, indipendentemente da dove si trovino.
- L'AI e il machine learning senza confini ti consentono di applicare modelli di AI, agenti autonomi e machine learning direttamente ai tuoi dati remoti senza eseguirne la migrazione.
Architettura
Il seguente diagramma illustra l'architettura di accesso ai dati cross-cloud di Lakehouse:
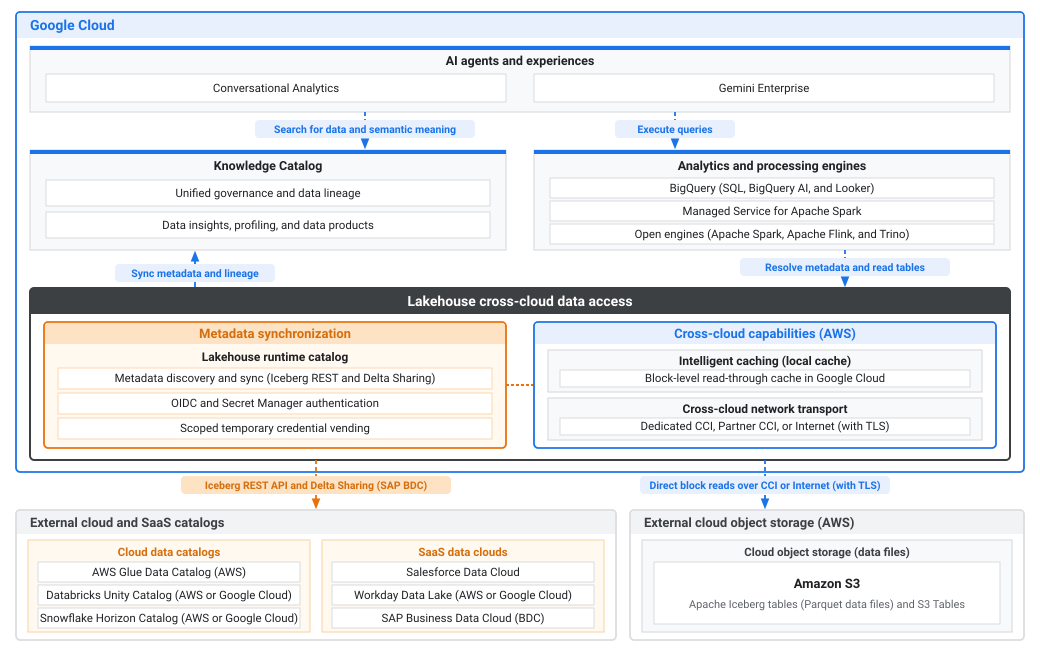
Il diagramma precedente illustra l'architettura negli Google Cloud ambienti cloud e SaaS esterni:
- Google Cloud: fornisce AI, governance, analisi e accesso ai dati cross-cloud su set di dati remoti:
- Agenti ed esperienze di AI: crea agenti autonomi in Analisi conversazionale e Gemini Enterprise che cercano dati e significato semantico in Knowledge Catalog ed eseguono query tramite motori di analisi ed elaborazione.
- Knowledge Catalog: fornisce governance unificata e derivazione dei dati, insieme a insight sui dati, profilazione, e prodotti di dati, sincronizzando i metadati e la derivazione da Lakehouse.
- Motori di analisi ed elaborazione: esegue carichi di lavoro BigQuery SQL, BigQuery AI e Looker oppure elabora i dati remoti con Managed Service for Apache Spark e motori open source (Apache Spark, Apache Flink e Trino) risolvendo i metadati e leggendo le tabelle tramite Lakehouse.
- Accesso ai dati cross-cloud di Lakehouse: esegue query sui dati remoti
senza migrazione di file o pipeline ETL:
- Sincronizzazione dei metadati: rileva e sincronizza i metadati delle tabelle su Apache Iceberg REST e Delta Sharing utilizzando il catalogo di runtime di Lakehouse, esegue l'autenticazione tramite OpenID Connect (OIDC) o Secret Manager e vende credenziali temporanee con ambito.
- Funzionalità cross-cloud (AWS): memorizza nella cache i dati letti blocchi in Google Cloud utilizzando una cache read-through a livello di blocchi (Memorizzazione nella cache intelligente (cache locale)) e instrada il traffico su Dedicated Cross-Cloud Interconnect (CCI), Partner Interconnect o internet (con TLS) utilizzando Trasporto di rete cross-cloud.
- Origini dati cloud e SaaS esterne: ospita i cataloghi remoti, i cloud di dati SaaS
e l'archiviazione di oggetti:
- Cataloghi cloud e SaaS esterni: sincronizza i metadati da Cataloghi di dati cloud (AWS Glue Data Catalog su AWS e Databricks Unity Catalog e Snowflake Horizon Catalog su AWS o Google Cloud) e Cloud di dati SaaS (Salesforce Data Cloud, Workday Data Lake su AWS o Google Cloud, e SAP Business Data Cloud (BDC)) tramite l'API REST Iceberg e Delta Sharing (per SAP BDC).
- Archiviazione di oggetti cloud esterni (AWS): archivia le tabelle Apache Iceberg (file di dati Parquet) e le tabelle Amazon S3 in Amazon S3 per le letture dirette dei blocchi tramite CCI o internet (con TLS).
Come funziona l'accesso ai dati cross-cloud
Lakehouse esegue query sui dati remoti utilizzando la seguente procedura:
- Rilevamento dei metadati: Google Cloud's Lakehouse si connette ai cataloghi REST Apache Iceberg remoti, come Databricks Unity o AWS Glue. Lakehouse rileva i dati senza copiare alcun file. A seconda del provider del catalogo remoto, Lakehouse esegue l'autenticazione in modo sicuro tramite Secret Manager o la federazione di token OIDC con Google come provider di identità.
- Trasporto sicuro: la scelta di instradare il traffico tramite un interconnect privato (ad esempio, Dedicated CCI o Partner Interconnect) riduce significativamente i costi di trasferimento dei dati rispetto a internet pubblico e rende la latenza altamente prevedibile.
- Esecuzione ottimizzata: quando le query leggono i dati dai cloud remoti, Lakehouse memorizza temporaneamente nella cache questi segmenti di dati localmente in Google Cloud uno spazio di archiviazione specializzato. Le query successive utilizzano la cache locale, il che evita una parte significativa degli addebiti per i dati in uscita cross-cloud.
Cataloghi supportati
Lakehouse supporta l'esecuzione di query sui dati dei seguenti provider di cataloghi remoti:
- Databricks Unity Catalog: ospitato su Amazon Web Services (AWS) o Google Cloud.
- AWS Glue: ospitato su AWS.
- Catalogo Snowflake Horizon: ospitato su AWS o Google Cloud.
- Workday Data Lake: ospitato su AWS o Google Cloud.
- SAP Business Data Cloud (BDC): ospitato su AWS, Microsoft Azure o Google Cloud utilizzando il connettore SAP BDC.
Concetti principali
Questa sezione descrive i componenti chiave essenziali per l'utilizzo della funzionalità di accesso ai dati cross-cloud.
Livello dei metadati
Il livello dei metadati si connette agli endpoint del catalogo REST Apache Iceberg remoto per sincronizzare i metadati delle risorse Iceberg (spazio dei nomi, tabella) in base a un intervallo di aggiornamento. Lakehouse esegue l'autenticazione in modo sicuro con le credenziali OAuth archiviate in Secret Manager o nella federazione di token OIDC.
Livello di trasporto
Il livello di trasporto consente a BigQuery e ai motori open source di eseguire query sui dati utilizzando i metadati sincronizzati dal livello dei metadati. Per alcuni tipi di cataloghi remoti, Lakehouse supporta l'esecuzione di query sui dati tramite internet pubblico o un interconnect privato dedicato.
Seleziona il metodo di trasporto che soddisfa i requisiti di architettura e sicurezza:
Di proprietà del cliente (CCI)
Puoi configurare BigQuery per eseguire query sui dati archiviati nei bucket AWS Amazon S3 tramite un interconnect cross-cloud privato utilizzando Dedicated Cross-Cloud Interconnect o Partner Cross-Cloud Interconnect.
L'utilizzo di un interconnect privato offre i seguenti vantaggi:
- Maggiore sicurezza: i dati viaggiano attraverso una connessione di rete privata tra Google Cloud e AWS, evitando internet pubblico.
- Costi ridotti: addebiti per i dati in uscita potenzialmente inferiori da AWS rispetto al traffico in uscita verso internet, soprattutto se combinati con la capacità dell'interconnect privato.
- Prestazioni coerenti: latenza e larghezza di banda della rete più prevedibili rispetto a internet pubblico.
Panoramica dell'architettura
Per abilitare le query private, configura un percorso da BigQuery al bucket AWS Amazon S3 tramite l'interconnect privato. Un componente chiave in the Google Cloud Virtual Private Cloud (VPC) (VPC) è un bilanciatore del carico interno (ILB). L'ILB distribuisce le richieste da BigQuery agli endpoint privati per Amazon S3 all'interno del VPC AWS, che vengono sottoposti a provisioning utilizzando AWS PrivateLink.
L'utilizzo di un ILB con più interfacce di rete elastiche (ENI) come backend è essenziale per il bilanciamento del carico, la scalabilità e l'alta affidabilità. Questo vale sia che tu utilizzi Dedicated CCI sia Partner Interconnect.
Il flusso di lavoro delle query private segue questa procedura:
- BigQuery utilizza una connessione configurata con un servizio Service Directory.
- Service Directory risolve il nome del servizio nell'indirizzo IP interno di the Google Cloud ILB.
- L'ILB riceve le richieste da BigQuery e le distribuisce ai backend configurati.
- I backend ILB sono gruppi di endpoint di rete (NEG) di connettività ibrida, ognuno dei quali punta all'indirizzo IP privato di un'ENI nel VPC AWS.
- Il traffico scorre dall'ILB, attraverso i NEG, attraverso l'interconnect privato, fino alle ENI AWS.
- Le ENI AWS, che fanno parte di un endpoint di interfaccia VPC Amazon S3 (AWS PrivateLink), forniscono l'accesso privato al servizio Amazon S3.
Internet pubblico (senza CCI)
Se non configuri un interconnect privato, le query al catalogo remoto viaggiano su internet pubblico per impostazione predefinita.
Quando esegui query sui dati tramite internet pubblico, tieni presente le seguenti implicazioni:
- Crittografia standard: le richieste di accesso ai dati e i trasferimenti di dati vengono criptati in transito utilizzando i protocolli TLS standard su internet pubblico.
- Costi per i dati in uscita: il trasferimento di dati comporta addebiti standard per il traffico in uscita verso internet dal provider di servizi cloud remoto (ad esempio, AWS), che in genere sono superiori alle tariffe per i dati in uscita da interconnect privati.
- Latenza variabile: le prestazioni della rete, la larghezza di banda e la latenza dipendono dal routing e dalla congestione di internet pubblico, con conseguenti tempi di esecuzione delle query meno prevedibili rispetto a un interconnect privato dedicato.
- Configurazione semplificata: non richiede infrastruttura di rete aggiuntiva, peering VPC o configurazione di Service Directory in Google Cloud o nel provider di servizi cloud remoto.
Panoramica dell'architettura
Quando esegui query sui dati tramite internet pubblico, Lakehouse si connette direttamente al catalogo remoto e agli endpoint di archiviazione di oggetti senza richiedere infrastruttura di rete cloud privata Google Cloud o remota.
Il flusso di lavoro delle query su internet pubblico segue questa procedura:
- BigQuery avvia una query su una tabella remota definita nel catalogo Lakehouse.
- Lakehouse esegue l'autenticazione in modo sicuro con il catalogo Apache Iceberg remoto utilizzando le credenziali archiviate in Secret Manager o nella federazione di token OIDC.
- Lakehouse recupera i metadati della tabella e i file manifest su internet pubblico per identificare i file di dati sottostanti pertinenti (ad esempio, in AWS Amazon S3).
- Le richieste di accesso ai dati per gli oggetti sottostanti vengono inviate direttamente da Google Cloud tramite internet pubblico utilizzando la crittografia TLS standard.
- Il servizio di archiviazione remota verifica la richiesta utilizzando le credenziali temporanee con ambito vendute da Lakehouse e restituisce i blocchi di dati richiesti tramite internet pubblico a Google Cloud.
Memorizzazione nella cache intelligente
Quando esegui query sui dati del cloud remoto, Lakehouse memorizza automaticamente nella cache i blocchi di dati recuperati localmente in Google Cloud. La memorizzazione nella cache è abilitata automaticamente per tutte le query cross-cloud per ridurre al minimo le tariffe per i dati in uscita dai provider di servizi cloud remoti. Le query successive che hanno come target i dati memorizzati nella cache vengono lette direttamente dall'archiviazione locale Google Cloud anziché recuperare i dati su più cloud.
Risparmi sui costi per i dati in uscita
Durante l'esecuzione della query iniziale, Lakehouse recupera i data block richiesti dal provider cloud remoto e popola la cache locale. Le query successive che hanno come target gli stessi blocchi di dati vengono lette direttamente dalla cache locale Google Cloud anziché recuperare i dati su più cloud.
Per i carichi di lavoro con pattern di query ripetuti sullo stesso set di dati, la memorizzazione nella cache riduce le tariffe per i dati in uscita cross-cloud pubblicando le richieste di dati dallo spazio di archiviazione locale. I risparmi effettivi sui costi per i dati in uscita dipendono da fattori quali i pattern di accesso alle query, le tariffe di modifica dei dati e la conservazione della cache nella regione di destinazione. Google Cloud
Verificare l'utilizzo della cache e i risparmi sui costi per i dati in uscita nelle statistiche dei job
Per verificare i successi della cache e i risparmi sui costi per i dati in uscita per una query, esamina le statistiche delle query nella console o nell'API BigQuery (JobStatistics2). Poiché una query può fare riferimento ai dati di più provider, le statistiche dei job forniscono un campo object_storage_stats (objectStorageStats) ripetuto con una voce per ogni provider cloud a cui è stato eseguito l'accesso durante l'esecuzione.
Ogni voce object_storage_stats riporta le seguenti metriche:
cloud_provider(cloudProvider): il provider di servizi cloud che ospita l'archiviazione di oggetti (ad esempio,AWSoAZURE).cache_bytes_read(cacheBytesRead): il numero totale di byte letti dalla cache Google Cloud locale, evitando una lettura dell'archiviazione di oggetti remota.object_storage_bytes_read(objectStorageBytesRead): il numero totale di byte letti direttamente dall'archiviazione di oggetti del provider di servizi cloud remoto.
Considerazioni sulla residenza dei dati e sulla giurisdizione
La creazione di un catalogo o di una connessione remota in una Google Cloud regione archivia i dati memorizzati nella cache at-rest localmente all'interno di quella regione di destinazione.
Se la residenza dei dati del cloud remoto si trova in una regione geografica o in una giurisdizione diversa (ad esempio, AWS Amazon S3 nell'Unione Europea abbinato al calcolo di BigQuery in us-east4), le query cross-cloud archiviano le copie memorizzate nella cache dei dati remoti at-rest nella regioneGoogle Cloud di destinazione. L'utente o l'amministratore che crea la connessione o il catalogo deve assicurarsi che la memorizzazione nella cache cross-giurisdizione sia conforme ai requisiti di residenza dei dati, sovranità e conformità della propria organizzazione.
Supporto per la crittografia e CMEK
Le chiavi di crittografia gestite dal cliente (CMEK) non sono supportate per la memorizzazione nella cache di Lakehouse. Tutti i data block memorizzati nella cache vengono protetti con crittografia at-rest utilizzando il valore predefinito Google-owned and Google-managed encryption keys.
Se la tua organizzazione applica il vincolo del criterio dell'organizzazione Limitare i servizi non CMEK (constraints/gcp.restrictNonCmekServices), Lakehouse disabilita automaticamente la memorizzazione nella cache per le query che accedono alle tabelle con limitazioni. Le query vengono comunque eseguite correttamente, ma non memorizzano nella cache i data block né usufruiscono dei risparmi sui dati in uscita correlati alla cache.
Passaggi successivi
- Configura una connessione cross-cloud per AWS Glue, Databricks Unity Catalog, Snowflake Horizon Catalog, Workday Data Lake, o SAP Business Data Cloud.