


Mit der Funktion für den cloudübergreifenden Datenzugriff können Sie Daten, die bei anderen Cloud-Anbietern gespeichert sind, direkt abfragen, Google Cloud ohne Dateien migrieren oder komplexe ETL-Pipelines mit Cross-Cloud Interconnect erstellen zu müssen.
Im Rahmen von grenzenlosem Lakehouse können Sie mit dieser Funktion einheitliche Analysen durchführen und KI auf Ihre verteilten Datasets anwenden. Dazu können Sie BigQuery, eigenständige Apache Spark-Umgebungen oder Managed Service for Apache Spark verwenden.
Neben analytischen Abfragen können Sie Ihre Remote-Daten auch für KI-gestützte Analysen und Governance verwenden:
- Konversationelle Analyse: Erstellen Sie spezialisierte KI-Agenten, die auf Ihren genauen Datenquellen basieren, einschließlich cloudübergreifender Tabellen, um Daten aus verschiedenen Clouds in einer einzigen Konversation zu analysieren.
- Knowledge Catalog: Verwenden Sie die Funktionen von Knowledge Catalog für Datenprofiling und Analysen mit Remote-Datenquellen.
Anwendungsfälle
Lakehouse unterstützt mehrere wichtige Anwendungsfälle für den Zugriff auf Daten bei mehreren Cloud-Anbietern:
- Durch reduzierte Datenverschiebung können Sie Daten, die in anderen Cloud-Umgebungen gespeichert sind, direkt abfragen. So wird der Datenzugriff und die Datenverarbeitung vereinfacht.
- Mit einheitlichen Analysen können Sie erweiterte Analysen mit konsistenten Funktionen und Hardwareoptimierung für alle Ihre Daten durchführen, unabhängig davon, wo sie sich befinden.
- Mit grenzenloser KI und ML können Sie KI-Modelle, autonome KI-Agenten und maschinelles Lernen direkt auf Ihre Remote-Daten anwenden, ohne sie zu migrieren.
Architektur
Das folgende Diagramm zeigt die Architektur für den cloudübergreifenden Datenzugriff von Lakehouse:
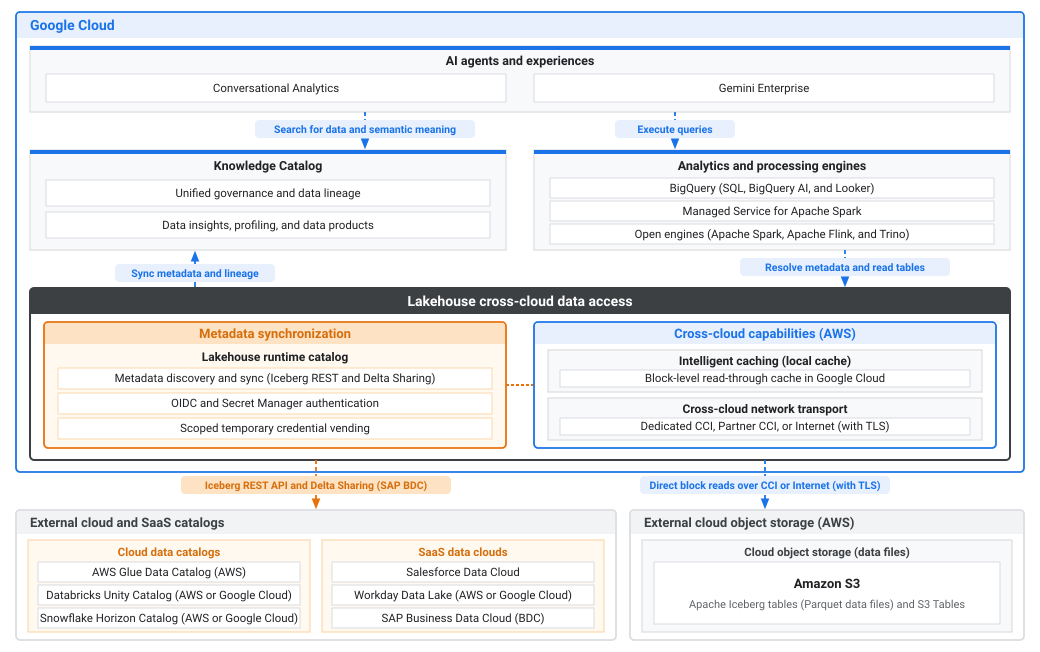
Das vorherige Diagramm zeigt die Architektur für Google Cloud und externe Cloud- und SaaS-Umgebungen:
- Google Cloud: bietet KI, Governance, Analysen und cloudübergreifenden Datenzugriff auf Remote-Datasets:
- KI-Agenten und -Angebote: erstellt autonome KI-Agenten in Conversational Analytics und Gemini Enterprise, die in Knowledge Catalog nach Daten und semantischer Bedeutung suchen und Abfragen über Analyse- und Verarbeitungs-Engines ausführen.
- Knowledge Catalog: bietet einheitliche Governance und Datenherkunft, sowie Dateneinblicke, Profiling, und Datenprodukte, indem Metadaten und Herkunft aus Lakehouse synchronisiert werden.
- Analyse- und Verarbeitungs-Engines: führt BigQuery SQL-, BigQuery AI- und Looker-Arbeitslasten aus oder verarbeitet Remote-Daten mit Managed Service for Apache Spark und Open-Source-Engines (Apache Spark, Apache Flink und Trino), indem Metadaten aufgelöst und Tabellen über Lakehouse gelesen werden.
- Cloudübergreifender Datenzugriff von Lakehouse: fragt Remote-
Daten direkt ab, ohne dass eine Dateimigration oder ETL-Pipelines erforderlich sind:
- Metadatensynchronisierung: ermittelt und synchronisiert Tabellen metadaten über Apache Iceberg REST und Delta Sharing mit dem Lakehouse-Laufzeitkatalog, authentifiziert sich über OpenID Connect (OIDC) oder Secret Manager und stellt temporäre Anmeldedaten mit beschränktem Zugriff bereit.
- Cloudübergreifende Funktionen (AWS): speichert gelesene Daten blöcke in Google Cloud mit einem Block-Level-Read-Through-Cache (Intelligentes Caching (lokaler Cache)) und leitet Traffic über Dedicated Cross-Cloud Interconnect (CCI), Partner Interconnect oder das Internet (mit TLS) mit Cloudübergreifender Netzwerkübertragung weiter.
- Externe Cloud- und SaaS-Datenquellen: hostet die Remote-Kataloge, SaaS
Datenclouds und den Objektspeicher:
- Externe Cloud- und SaaS-Kataloge: synchronisiert Metadaten aus Cloud Datenkatalogen (AWS Glue Data Catalog in AWS und Databricks Unity Catalog und Snowflake Horizon Catalog in AWS oder Google Cloud) und SaaS-Datenclouds (Salesforce Data Cloud, Workday Data Lake in AWS oder Google Cloud, und SAP Business Data Cloud (BDC)) über die Iceberg REST API und Delta Sharing (für SAP BDC).
- Externer Cloud-Objektspeicher (AWS): speichert Apache Iceberg-Tabellen (Parquet-Datendateien) und Amazon S3-Tabellen in Amazon S3 für direkte Blocklesevorgänge über CCI oder das Internet (mit TLS).
So funktioniert der Zugriff auf cloudübergreifende Daten
Lakehouse fragt Remote-Daten mit dem folgenden Verfahren ab:
- Metadatenermittlung: Google Cloud's Lakehouse stellt eine Verbindung zu Remote-Apache Iceberg REST-Katalogen wie Databricks Unity oder AWS Glue her. Lakehouse ermittelt die Daten, ohne Dateien zu kopieren. Je nach Anbieter des Remote-Katalogs authentifiziert sich Lakehouse sicher über Secret Manager oder die OIDC-Tokenföderation mit Google als Identitätsanbieter.
- Sichere Übertragung:Wenn Sie den Traffic über eine private Interconnect-Verbindung (z. B. Dedicated CCI oder Partner Interconnect) weiterleiten, werden die Kosten für die Datenübertragung im Vergleich zum öffentlichen Internet erheblich gesenkt und die Latenz ist sehr vorhersehbar.
- Optimierte Ausführung: Wenn Abfragen Daten aus Remote-Clouds lesen, speichert Lakehouse diese Datensegmente vorübergehend lokal in Google Cloud einem speziellen Speicher. Nachfolgende Abfragen verwenden den lokalen Cache, wodurch ein erheblicher Teil der Kosten für cloudübergreifenden ausgehenden Traffic vermieden wird.
Unterstützte Kataloge
Lakehouse unterstützt das Abfragen von Daten von den folgenden Remote-Kataloganbietern:
- Databricks Unity Catalog: gehostet in Amazon Web Services (AWS) oder Google Cloud.
- AWS Glue: gehostet in AWS.
- Snowflake Horizon Catalog: gehostet in AWS oder Google Cloud.
- **Workday Data Lake**: gehostet in AWS oder Google Cloud.
- SAP Business Data Cloud (BDC): gehostet in AWS, Microsoft Azure oder Google Cloud über den SAP BDC-Connector.
Wichtige Konzepte
In diesem Abschnitt werden die wichtigsten Komponenten beschrieben, die für die Verwendung der Funktion für den cloudübergreifenden Datenzugriff erforderlich sind.
Metadatenebene
Die Metadatenebene stellt eine Verbindung zu Remote-Apache Iceberg REST-Katalogendpunkten her, um Metadaten von Iceberg-Ressourcen (Namespace, Tabelle) basierend auf einem Aktualisierungsintervall zu synchronisieren. Lakehouse authentifiziert sich sicher mit OAuth-Anmeldedaten, die in Secret Manager gespeichert sind, oder mit der OIDC-Tokenföderation.
Transportschicht
Die Transportschicht ermöglicht es BigQuery- und Open-Source-Engines, die Daten mit den synchronisierten Metadaten aus der Metadatenebene abzufragen. Für bestimmte Arten von Remote-Katalogen unterstützt Lakehouse das Abfragen von Daten über das öffentliche Internet oder eine dedizierte private Interconnect-Verbindung.
Wählen Sie die Transportmethode aus, die Ihren Architektur- und Sicherheitsanforderungen entspricht:
Kundeneigene Interconnect-Verbindung (CCI)
Sie können BigQuery so konfigurieren, dass Daten, die in AWS Amazon S3-Buckets gespeichert sind, über eine private Cross-Cloud Interconnect-Verbindung abgefragt werden. Dazu können Sie entweder Dedicated Cross-Cloud Interconnect oder Partner Cross-Cloud Interconnect verwenden.
Die Verwendung einer privaten Interconnect-Verbindung bietet folgende Vorteile:
- Höhere Sicherheit: Daten werden über eine private Netzwerkverbindung zwischen Google Cloud und AWS übertragen, ohne das öffentliche Internet zu nutzen.
- Geringere Kosten:Möglicherweise niedrigere Gebühren für ausgehenden Traffic von AWS im Vergleich zu ausgehendem Internet-Traffic, insbesondere in Kombination mit Ihrer privaten Interconnect-Kapazität.
- Konstante Leistung:Vorhersehbarere Netzwerklatenz und Bandbreite im Vergleich zum öffentlichen Internet.
Architektur
Um private Abfragen zu ermöglichen, konfigurieren Sie einen Pfad von BigQuery zu Ihrem AWS Amazon S3-Bucket über Ihre private Interconnect-Verbindung. Eine Schlüsselkomponente in der Google Cloud Virtual Private Cloud (VPC) ist ein interner Load-Balancer (Internal Load Balancer, ILB). Der ILB verteilt Anfragen von BigQuery an die privaten Endpunkte für Amazon S3 in Ihrer AWS VPC, die mit AWS PrivateLink bereitgestellt werden.
Die Verwendung eines ILB mit mehreren Elastic Network Interfaces (ENIs) als Back-Ends ist für den Lastenausgleich, die Skalierbarkeit und die Hochverfügbarkeit unerlässlich. Dies gilt unabhängig davon, ob Sie Dedicated CCI oder Partner Interconnect verwenden.
Der Workflow für private Abfragen folgt diesem Prozess:
- BigQuery verwendet eine Verbindung, die mit einem Service Directory-Dienst konfiguriert wurde.
- Service Directory löst den Dienstnamen in die interne IP-Adresse des the Google Cloud ILB auf.
- Der ILB empfängt die Anfragen von BigQuery und verteilt sie an die konfigurierten Back-Ends.
- Die ILB-Back-Ends sind Netzwerk-Endpunktgruppen (Network Endpoint Groups, NEGs) mit Hybridkonnektivität, die jeweils auf die private IP-Adresse einer ENI in Ihrer AWS VPC verweisen.
- Der Traffic fließt vom ILB über die NEGs, über die private Interconnect-Verbindung zu den AWS-ENIs.
- Die AWS-ENIs, die Teil eines Amazon S3 VPC-Schnittstellenendpunkts (AWS PrivateLink) sind, ermöglichen den privaten Zugriff auf den Amazon S3-Dienst.
Öffentliches Internet (keine CCI)
Wenn Sie keine private Interconnect-Verbindung konfigurieren, werden Abfragen an Ihren Remote-Katalog standardmäßig über das öffentliche Internet weitergeleitet.
Beachten Sie beim Abfragen von Daten über das öffentliche Internet Folgendes:
- Standardverschlüsselung:Datenzugriffsanfragen und Datenübertragungen werden während der Übertragung mit Standard-TLS-Protokollen über das öffentliche Internet verschlüsselt.
- Kosten für ausgehenden Traffic:Für die Datenübertragung fallen standardmäßige Gebühren für ausgehenden Internet-Traffic von Ihrem Remote-Cloud-Anbieter (z. B. AWS) an, die in der Regel höher sind als die Gebühren für ausgehenden Traffic über eine private Interconnect-Verbindung.
- Variable Latenz:Die Netzwerkleistung, Bandbreite und Latenz hängen vom Routing und der Überlastung des öffentlichen Internets ab. Daher sind die Ausführungszeiten von Abfragen im Vergleich zu einer dedizierten privaten Interconnect-Verbindung weniger vorhersehbar.
- Einfache Einrichtung: Erfordert keine zusätzliche Netzwerkinfrastruktur, kein VPC-Peering und keine Service Directory-Konfiguration in Google Cloud oder bei Ihrem Remote-Cloud-Anbieter.
Architektur
Beim Abfragen von Daten über das öffentliche Internet stellt Lakehouse eine direkte Verbindung zu Ihren Remote-Katalog- und Objektspeicherendpunkten her, ohne dass eine private Google Cloud oder Remote-Cloud-Netzwerkinfrastruktur erforderlich ist.
Der Workflow für Abfragen über das öffentliche Internet folgt diesem Prozess:
- BigQuery initiiert eine Abfrage für eine Remote-Tabelle, die in Ihrem Lakehouse-Katalog definiert ist.
- Lakehouse authentifiziert sich sicher bei Ihrem Remote-Apache Iceberg-Katalog mit Anmeldedaten, die in Secret Manager gespeichert sind, oder mit der OIDC-Tokenföderation.
- Lakehouse ruft die Tabellenmetadaten und Manifestdateien über das öffentliche Internet ab, um die relevanten zugrunde liegenden Datendateien zu identifizieren (z. B. in AWS Amazon S3).
- Datenzugriffsanfragen für die zugrunde liegenden Objekte werden direkt von Google Cloud über das öffentliche Internet mit der Standard-TLS-Verschlüsselung gesendet.
- Der Remote-Speicherdienst überprüft die Anfrage mit temporären Anmeldedaten mit beschränktem Zugriff , die von Lakehouse bereitgestellt werden, und gibt die angeforderten Datenblöcke über das öffentliche Internet an zurück Google Cloud.
Intelligentes Caching
Wenn Sie Remote-Cloud-Daten abfragen, speichert Lakehouse automatisch abgerufene Datenblöcke lokal in Google Cloud. Das Caching ist für alle cloudübergreifenden Abfragen automatisch aktiviert, um die Gebühren für ausgehenden Traffic von Remote-Cloud-Anbietern zu minimieren. Nachfolgende Abfragen, die auf zwischengespeicherte Daten abzielen, lesen direkt aus dem lokalen Google Cloud Speicher, anstatt die Daten cloudübergreifend neu abzurufen.
Kosteneinsparungen für ausgehenden Traffic
Bei der ersten Abfrageausführung ruft Lakehouse die erforderlichen Datenblöcke vom Remote-Cloud-Anbieter ab und füllt den lokalen Cache. Nachfolgende Abfragen, die auf dieselben Datenblöcke abzielen, lesen direkt aus dem lokalen Google Cloud Cache, anstatt die Daten cloudübergreifend neu abzurufen.
Bei Arbeitslasten mit wiederholten Abfragemustern für dasselbe Dataset werden durch das Caching die Gebühren für cloudübergreifenden ausgehenden Traffic reduziert, da Datenanfragen aus dem lokalen Speicher bedient werden. Die tatsächlichen Kosteneinsparungen für ausgehenden Traffic hängen von Faktoren wie Abfragemustern, Datenänderungsraten und der Cache-Aufbewahrung in der Ziel Google Cloud region ab.
Cache-Nutzung und Kosteneinsparungen für ausgehenden Traffic in Jobstatistiken überprüfen
Wenn Sie die Cache-Trefferrate und die Kosteneinsparungen für ausgehenden Traffic für eine Abfrage überprüfen möchten, sehen Sie sich die Abfragestatistiken in der BigQuery Console oder API (JobStatistics2) an. Da eine Abfrage auf Daten von mehreren Anbietern verweisen kann, enthalten die Jobstatistiken ein wiederholtes Feld object_storage_stats (objectStorageStats) mit einem Eintrag für jeden Cloud-Anbieter, auf den während der Ausführung zugegriffen wurde.
Jeder object_storage_stats-Eintrag enthält die folgenden Messwerte:
cloud_provider(cloudProvider): Der Cloud-Anbieter, der den Objektspeicher hostet (z. B.AWSoderAZURE).cache_bytes_read(cacheBytesRead): Die Gesamtzahl der Byte, die aus dem lokalen Google Cloud Cache gelesen wurden, wodurch ein Lesevorgang aus dem Remote-Objektspeicher vermieden wurde.object_storage_bytes_read(objectStorageBytesRead): Die Gesamtzahl der Byte, die direkt aus dem Objektspeicher des Remote-Cloud-Anbieters gelesen wurden.
Überlegungen zum Datenstandort und zur Gerichtsbarkeit
Wenn Sie einen Remote-Katalog oder eine Verbindung in einer Google Cloud Region erstellen, werden zwischengespeicherte Daten im Ruhezustand lokal in dieser Zielregion gespeichert.
Wenn sich Ihre Remote-Cloud-Daten in einer anderen geografischen Region oder
Gerichtsbarkeit befinden (z. B. AWS Amazon S3 in der Europäischen
Union in Kombination mit BigQuery-Compute in us-east4), werden beim cloudübergreifenden
Abfragen zwischengespeicherte Kopien der Remote-Daten im Ruhezustand in der Ziel
Google Cloud region gespeichert. Der Nutzer oder Administrator, der die Verbindung oder den Katalog erstellt, muss dafür sorgen, dass das Caching über Gerichtsbarkeiten hinweg den Anforderungen seiner Organisation an Datenstandort, Datenhoheit und Compliance entspricht.
Verschlüsselung und CMEK-Unterstützung
Kundenverwaltete Verschlüsselungsschlüssel (Customer-Managed Encryption Keys, CMEK) werden für das Lakehouse-Caching nicht unterstützt. Alle im Cache gespeicherten Datenblöcke werden mit der Standard-Verschlüsselung ruhender Daten von Google-owned and Google-managed encryption keysverschlüsselt.
Wenn Ihre Organisation die Organisationsrichtlinieneinschränkung Nicht-CMEK-Dienste einschränken (constraints/gcp.restrictNonCmekServices) erzwingt, deaktiviert Lakehouse automatisch das Caching für Abfragen, die auf eingeschränkte Tabellen zugreifen. Die Abfragen werden weiterhin erfolgreich ausgeführt, aber es werden keine Datenblöcke zwischengespeichert und es gibt keine Kosteneinsparungen für ausgehenden Traffic im Zusammenhang mit dem Cache.
Nächste Schritte
- Richten Sie eine cloudübergreifende Verbindung für AWS Glue, Databricks Unity Catalog, Snowflake Horizon Catalog, Workday Data Lake, oder SAP Business Data Cloud ein.