


O recurso de acesso a dados entre nuvens permite consultar dados armazenados em outros provedores de nuvem diretamente do Google Cloud sem migrar arquivos ou criar pipelines ETL complexos com o Interconexão entre nuvens.
Como parte do Lakehouse sem fronteiras, esse recurso permite realizar análises unificadas e aplicar IA aos conjuntos de dados distribuídos usando o BigQuery, ambientes autônomos do Apache Spark ou o Serviço Gerenciado para Apache Spark.
Além das consultas analíticas, é possível usar os dados remotos para insights e governança baseados em IA:
- Análise conversacional: crie agentes especializados com base nas suas fontes de dados exatas, incluindo tabelas entre nuvens, para analisar dados em nuvens a partir de uma única conversa.
- Knowledge Catalog: use os recursos do Knowledge Catalog para criação de perfil de dados e insights com fontes de dados remotas.
Casos de uso
O Lakehouse oferece suporte a vários casos de uso importantes para acessar dados em vários provedores de nuvem:
- Movimentação de dados reduzida : permite consultar dados armazenados em outros ambientes de nuvem diretamente, simplificando o acesso e o processamento de dados.
- Análise unificada : permite realizar análises avançadas com recursos consistentes e otimização de hardware em todos os dados, independentemente de onde eles estejam.
- IA e ML sem fronteiras : permite aplicar modelos de IA, agentes autônomos e machine learning diretamente aos dados remotos sem migrá-los.
Arquitetura
O diagrama a seguir ilustra a arquitetura de acesso a dados entre nuvens do Lakehouse:
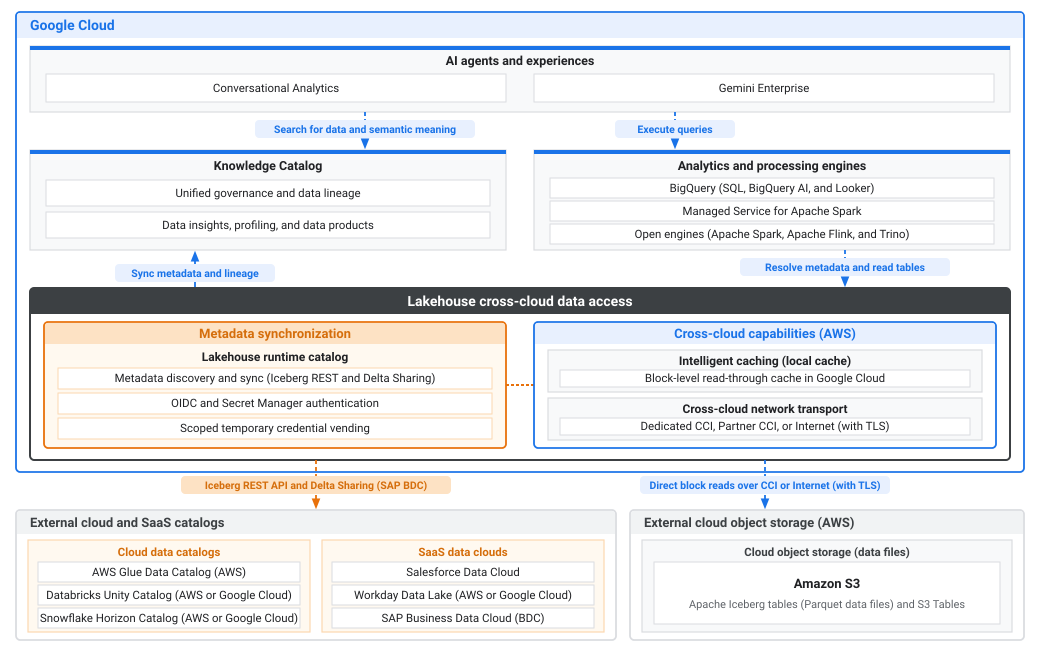
O diagrama anterior ilustra a arquitetura em Google Cloud ambientes de nuvem e SaaS externos:
- Google Cloud: oferece IA, governança, análise e acesso a dados entre nuvens em conjuntos de dados remotos:
- Agentes e experiências de IA: cria agentes autônomos na Análise conversacional e no Gemini Enterprise que pesquisam dados e significado semântico no Knowledge Catalog e executam consultas por mecanismos de análise e processamento.
- Knowledge Catalog: oferece governança unificada e linhagem de dados, além de insights de dados, criação de perfil, e produtos de dados, sincronizando metadados e linhagem do Lakehouse.
- Mecanismos de análise e processamento: executa cargas de trabalho do BigQuery SQL, do BigQuery AI e do Looker ou processa dados remotos com o Serviço Gerenciado para Apache Spark e mecanismos abertos (Apache Spark, Apache Flink e Trino) resolvendo metadados e lendo tabelas pelo Lakehouse.
- Acesso a dados entre nuvens do Lakehouse: consulta dados remotos
no local sem migração de arquivos ou pipelines ETL:
- Sincronização de metadados: descobre e sincroniza metadados de tabelas no Apache Iceberg REST e no Delta Sharing usando o catálogo do ambiente de execução do Lakehouse, autentica pelo OpenID Connect (OIDC) ou Secret Manager e vende credenciais temporárias com escopo.
- Recursos entre nuvens (AWS): armazena em cache blocos de dados lidos em Google Cloud usando um cache de leitura direta no nível do bloco (Armazenamento em cache inteligente (cache local)) e roteia o tráfego pelo Interconexão entre nuvens dedicada (CCI, na sigla em inglês), pela Interconexão por parceiro ou pela internet (com TLS) usando o Transporte de rede entre nuvens.
- Fontes de dados de nuvem e SaaS externas: hospeda os catálogos remotos, os Data Clouds SaaS
e o repositório de objetos:
- Catálogos de nuvem e SaaS externos: sincroniza metadados de catálogos de dados de nuvem (AWS Glue Data Catalog na AWS e Databricks Unity Catalog e Snowflake Horizon Catalog na AWS ou Google Cloud) e nuvens de dados SaaS (Salesforce Data Cloud, Workday Data Lake na AWS ou Google Cloud, e SAP Business Data Cloud (BDC)) pela API REST do Iceberg e pelo Delta Sharing (para SAP BDC).
- Repositório de objetos de nuvem externo (AWS): armazena tabelas do Apache Iceberg (arquivos de dados Parquet) e tabelas do Amazon S3 no Amazon S3 para leituras de método de bloqueio diretas pela CCI ou pela Internet (com TLS).
Como funciona o acesso a dados entre nuvens
O Lakehouse consulta dados remotos usando o seguinte processo:
- Descoberta de metadados: Google Cloud's Lakehouse conecta-se a catálogos REST remotos do Apache Iceberg, como Databricks Unity ou AWS Glue. O Lakehouse descobre os dados sem copiar arquivos. Dependendo do provedor de catálogo remoto, o Lakehouse autentica com segurança pelo Secret Manager ou pela federação de tokens OIDC com o Google como provedor de identidade.
- Transporte seguro:a opção de rotear o tráfego por uma interconexão privada (por exemplo, CCI dedicada ou Interconexão por parceiro) reduz significativamente os custos de transferência de dados em comparação com a Internet pública e torna a latência altamente previsível.
- Execução otimizada: à medida que as consultas leem dados de nuvens remotas, o Lakehouse armazena temporariamente esses segmentos de dados em cache localmente em Google Cloud armazenamento especializado. As consultas subsequentes usam o cache local, o que evita uma parte significativa das cobranças de saída entre nuvens.
Catálogos compatíveis
O Lakehouse oferece suporte à consulta de dados dos seguintes provedores de catálogo remoto:
- Catálogo do Databricks Unity: hospedado no Amazon Web Services (AWS) ou Google Cloud.
- AWS Glue: hospedado na AWS.
- Catálogo do Snowflake Horizon: Hospedado na AWS ou Google Cloud.
- Workday Data Lake: Hospedado na AWS ou Google Cloud.
- SAP Business Data Cloud (BDC): Hospedado na AWS, no Microsoft Azure ou Google Cloud usando o conector SAP BDC.
Principais conceitos
Esta seção descreve os principais componentes essenciais para usar o recurso de acesso a dados entre nuvens.
Camada de metadados
A camada de metadados se conecta a endpoints de catálogo REST remotos do Apache Iceberg para sincronizar metadados de recursos do Iceberg (namespace, tabela) com base em um intervalo de atualização. O Lakehouse autentica com segurança usando credenciais OAuth armazenadas no Secret Manager ou na federação de tokens OIDC.
Camada de transporte
A camada de transporte permite que o BigQuery e os mecanismos de código aberto consultem os dados usando os metadados sincronizados da camada de metadados. Para determinados tipos de catálogos remotos, o Lakehouse oferece suporte à consulta de dados pela Internet pública ou por uma interconexão privada dedicada.
Selecione o método de transporte que corresponde aos seus requisitos arquitetônicos e de segurança:
De propriedade do cliente (CCI)
É possível configurar o BigQuery para consultar dados armazenados em buckets do AWS Amazon S3 em uma interconexão privada entre nuvens usando a Interconexão dedicada entre nuvens ou a Interconexão por parceiro entre nuvens.
O uso de uma interconexão privada oferece os seguintes benefícios:
- Segurança aprimorada: os dados viajam por uma conexão de rede privada entre Google Cloud o Google Cloud e a AWS, evitando a Internet pública.
- Custos reduzidos:taxas de saída potencialmente mais baixas da AWS em comparação com a saída de dados para a internet, especialmente quando combinadas com a capacidade de interconexão privada.
- Desempenho consistente:latência e largura de banda de rede mais previsíveis em comparação com a Internet pública.
Informações gerais da arquitetura
Para ativar a consulta privada, configure um caminho do BigQuery para o bucket do AWS Amazon S3 pela interconexão privada. Um componente essencial na Google Cloud nuvem privada virtual (VPC) é um balanceador de carga interno (ILB, na sigla em inglês). O ILB distribui solicitações do BigQuery para os endpoints particulares do Amazon S3 na sua VPC da AWS, que são provisionados usando o AWS PrivateLink.
O uso de um ILB com várias interfaces de rede elásticas (ENIs, na sigla em inglês) como back-ends é essencial para balanceamento de carga, escalonabilidade e alta disponibilidade. Isso se aplica ao uso da CCI dedicada ou da Interconexão por parceiro.
O fluxo de trabalho de consulta privada segue este processo:
- O BigQuery usa uma conexão configurada com um serviço do Diretório de serviços.
- Diretório de serviços resolve o nome do serviço para o endereço IP interno de o Google Cloud ILB.
- O ILB recebe as solicitações do BigQuery e as distribui para os back-ends configurados.
- Os back-ends do ILB são grupos de endpoints de rede (NEGs, na sigla em inglês) de conectividade híbrida, cada um apontando para o endereço IP particular de uma ENI na sua VPC da AWS.
- O tráfego flui do ILB, pelos NEGs, pela interconexão privada, para as ENIs da AWS.
- As ENIs da AWS, parte de um endpoint de interface de VPC do Amazon S3 (AWS PrivateLink), fornecem acesso privado ao serviço do Amazon S3.
Internet pública (sem CCI)
Se você não configurar uma interconexão privada, as consultas ao catálogo remoto vão viajar pela Internet pública por padrão.
Ao consultar dados pela Internet pública, considere as seguintes implicações:
- Criptografia padrão:as solicitações de acesso a dados e as transferências de dados são criptografadas em trânsito usando protocolos TLS padrão na Internet pública.
- Custos de saída:a transferência de dados incorre em cobranças de saída da Internet padrão do provedor de nuvem remoto (por exemplo, AWS), que geralmente são mais altas do que as taxas de saída de interconexão privada.
- Latência variável:o desempenho da rede, a largura de banda e a latência dependem do roteamento e do congestionamento da Internet pública, resultando em tempos de execução de consulta menos previsíveis em comparação com uma interconexão privada dedicada.
- Configuração simplificada: não requer infraestrutura de rede adicional, peering de VPC ou configuração do Diretório de serviços em Google Cloud ou seu provedor de nuvem remoto.
Informações gerais da arquitetura
Ao consultar dados pela Internet pública, o Lakehouse se conecta diretamente ao catálogo remoto e aos endpoints de repositório de objetos sem exigir privada Google Cloud ou infraestrutura de rede de nuvem remota.
O fluxo de trabalho de consulta da Internet pública segue este processo:
- O BigQuery inicia uma consulta em uma tabela remota definida no catálogo do Lakehouse.
- O Lakehouse autentica com segurança com o catálogo remoto do Apache Iceberg usando credenciais armazenadas no Secret Manager ou na federação de tokens OIDC.
- O Lakehouse recupera os metadados da tabela e os arquivos de manifesto na Internet pública para identificar os arquivos de dados subjacentes relevantes (por exemplo, no AWS Amazon S3).
- As solicitações de acesso a dados para os objetos subjacentes são enviadas diretamente do Google Cloud pela Internet pública usando a criptografia TLS padrão.
- O serviço de armazenamento remoto verifica a solicitação usando credenciais temporárias e com escopo vendidas pelo Lakehouse e retorna os blocos de dados solicitados pela Internet pública para Google Cloud.
Armazenamento em cache inteligente
Ao consultar dados de nuvem remotos, o Lakehouse armazena automaticamente em cache os blocos de dados recuperados localmente em Google Cloud. O armazenamento em cache é ativado automaticamente para todas as consultas entre nuvens para ajudar a minimizar as taxas de saída de provedores de nuvem remotos. As consultas subsequentes direcionadas a dados armazenados em cache são lidas diretamente do armazenamento local Google Cloud em vez de buscar os dados novamente entre nuvens.
Economia de custos de saída
Na execução da consulta inicial, o Lakehouse busca os blocos de dados necessários do provedor de nuvem remoto e preenche o cache local. As consultas subsequentes direcionadas aos mesmos blocos de dados são lidas diretamente do cache Google Cloud local em vez de buscar os dados novamente entre nuvens.
Para cargas de trabalho com padrões de consulta repetidos no mesmo conjunto de dados, o armazenamento em cache reduz as taxas de saída entre nuvens, atendendo às solicitações de dados do armazenamento local. A economia real de custos de saída depende de fatores como padrões de acesso a consultas, taxas de modificação de dados e retenção de cache na região de destino Google Cloud.
Como verificar o uso do cache e a economia de custos de saída nas estatísticas de jobs
Para verificar as ocorrências em ocorrência em cache e a economia de custos de saída de uma consulta, inspecione as estatísticas de consulta no console ou na API do BigQuery (JobStatistics2). Como uma consulta pode referenciar dados de vários provedores, as estatísticas do job fornecem um campo object_storage_stats (objectStorageStats) repetido com uma entrada para cada provedor de nuvem acessado durante a execução.
Cada entrada object_storage_stats informa as seguintes métricas:
cloud_provider(cloudProvider): o provedor de nuvem que hospeda o repositório de objetos (por exemplo,AWSouAZURE).cache_bytes_read(cacheBytesRead): o total de bytes lidos do cache Google Cloud local, evitando uma leitura de repositório de objetos remotos.object_storage_bytes_read(objectStorageBytesRead): o total de bytes lidos diretamente do repositório de objetos do provedor de nuvem remoto.
Considerações sobre residência e jurisdição de dados
A criação de um catálogo ou conexão remota em uma Google Cloud região armazena dados em cache localmente nessa região de destino.
Se os dados de nuvem remotos residirem em uma região geográfica ou
jurisdição diferente (por exemplo, AWS Amazon S3 na União
Europeia pareado com a computação do BigQuery em us-east4), a consulta
entre nuvens armazena cópias em cache de dados remotos na
Google Cloud região de destino. O usuário ou administrador que cria a conexão ou o catálogo precisa garantir que o armazenamento em cache entre jurisdições esteja em conformidade com os requisitos de residência de dados, soberania e conformidade da organização.
Criptografia e suporte a CMEK
As chaves de criptografia gerenciadas pelo cliente (CMEK, na sigla em inglês) não são compatíveis com o armazenamento em cache do Lakehouse. Todos os blocos de dados armazenados em cache são criptografados em repouso usando o padrão Google-owned and Google-managed encryption keys.
Se a organização aplicar a restrição de política da organização Restringir serviços não CMEK (constraints/gcp.restrictNonCmekServices), o Lakehouse vai desativar automaticamente o armazenamento em cache para consultas que acessam tabelas restritas. As consultas ainda são executadas com sucesso, mas não armazenam blocos de dados em cache nem se beneficiam de economias de saída relacionadas ao cache.
A seguir
- Configure uma conexão entre nuvens para o AWS Glue, o Databricks Unity Catalog, o Snowflake Horizon Catalog, o Workday Data Lake, ou o SAP Business Data Cloud.