


Mit dem cloudübergreifenden Datenzugriff können Sie Daten, die bei anderen Cloud-Anbietern gespeichert sind, direkt von Google Cloud aus abfragen, ohne Dateien migrieren oder komplexe ETL-Pipelines erstellen zu müssen. Abfragen können über das öffentliche Internet weitergeleitet werden oder Cross-Cloud Interconnect für den privaten Netzwerktransport verwenden.
Als Teil des grenzenlosen Lakehouse vereinheitlicht diese Funktion Analyse- und KI-Arbeitslasten über Ihre verteilten Datasets hinweg über BigQuery, eigenständige Apache Spark-Umgebungen oder Managed Service for Apache Spark.
Zusätzlich zum Ausführen von Analyseabfragen können Sie Konversationsanalyse-Agenten erstellen, die auf Ihren verteilten Tabellen basieren, einschließlich cloudübergreifender Quellen, um Daten aus verschiedenen Clouds in einer einzigen Unterhaltung zu analysieren. Sie können auch Knowledge Catalog für Datenprofilerstellung und Statistiken auf Remote-Plattformen verwenden.
Anwendungsfälle
Lakehouse unterstützt mehrere wichtige Anwendungsfälle für den Zugriff auf Daten über mehrere Cloud-Anbieter hinweg:
- Reduzierte Datenverschiebung ermöglicht es Ihnen, in anderen Cloud-Umgebungen gespeicherte Daten direkt abzufragen, was den Datenzugriff und die Datenverarbeitung vereinfacht.
- Mit Unified Analytics können Sie erweiterte Analysen mit einheitlichen Funktionen und Hardwareoptimierung für alle Ihre Daten durchführen, unabhängig davon, wo sie sich befinden.
- Mit Borderless AI and ML können Sie KI-Modelle, autonome Agenten und maschinelles Lernen direkt auf Ihre Remote-Daten anwenden, ohne sie migrieren zu müssen.
Architektur
Das folgende Diagramm veranschaulicht die cloudübergreifende Datenzugriffsarchitektur von Lakehouse:
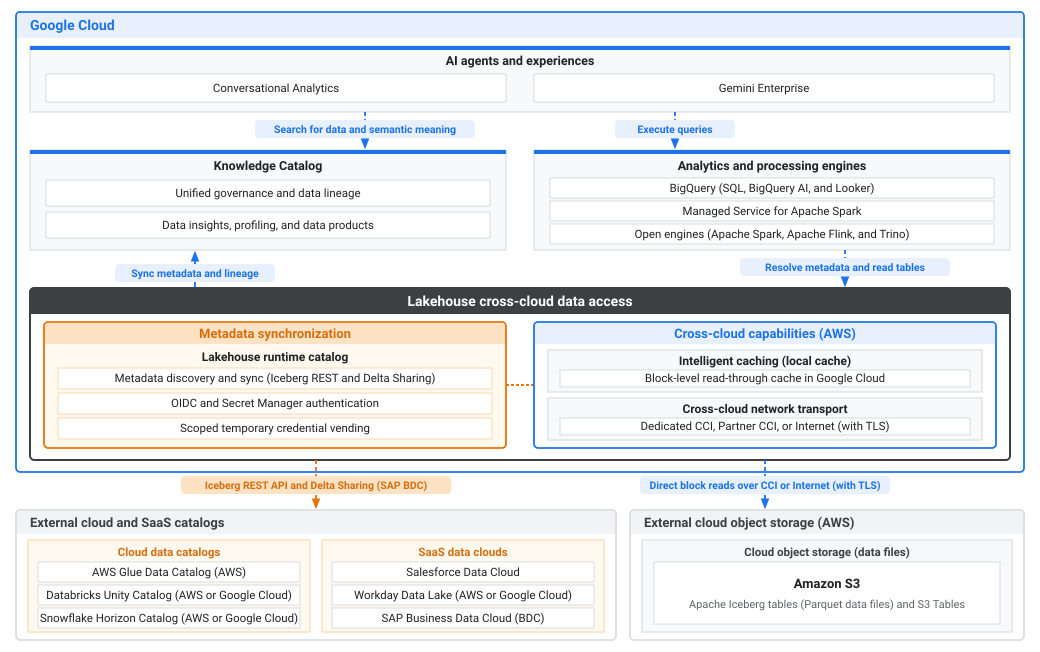
Das vorherige Diagramm veranschaulicht die Architektur in Google Cloud und externen Cloud- und SaaS-Umgebungen:
- Google Cloud: bietet KI, Governance, Analysen und cloudübergreifenden Datenzugriff für Remote-Datasets:
- KI-Agenten und ‑Anwendungen: Erstellt autonome Agenten in Conversational Analytics und Gemini Enterprise, die im Knowledge Catalog nach Daten und semantischer Bedeutung suchen und Abfragen über Analyse- und Verarbeitungs-Engines ausführen.
- Knowledge Catalog: bietet eine einheitliche Governance und Datenherkunft sowie Dateneinblicke, Profilerstellung und Datenprodukte, indem Metadaten und Herkunft aus Lakehouse synchronisiert werden.
- Analyse- und Verarbeitungs-Engines: Führt BigQuery SQL-, BigQuery AI- und Looker-Arbeitslasten aus oder verarbeitet Remote-Daten mit Managed Service for Apache Spark und offenen Engines (Apache Spark, Apache Flink und Trino), indem Metadaten aufgelöst und Tabellen über Lakehouse gelesen werden.
- Cloudübergreifender Datenzugriff in Lakehouse: Abfragen von Remote-Daten ohne Dateimigration oder ETL-Pipelines:
- Metadatensynchronisierung: Ermittelt und synchronisiert Tabellenmetadaten über Apache Iceberg REST und Delta Sharing mithilfe des Lakehouse-Laufzeitkatalogs, authentifiziert sich über OpenID Connect (OIDC) oder Secret Manager und stellt temporäre Anmeldedaten mit eingeschränktem Bereich bereit.
- Cloudübergreifende Funktionen (AWS): Liest Datenblöcke in Google Cloud mit einem Read-Through-Cache auf Blockebene (Intelligentes Caching (lokaler Cache)) und leitet Traffic über Dedicated Cross-Cloud Interconnect (CCI), Partner Interconnect oder das Internet (mit TLS) mithilfe des cloudübergreifenden Netzwerktransports weiter.
- Externe Cloud- und SaaS-Datenquellen: Hostet die Remote-Kataloge, SaaS-Daten-Clouds und Objektspeicher:
- Externe Cloud- und SaaS-Kataloge: Synchronisiert Metadaten aus Cloud-Datenkatalogen (AWS Glue Data Catalog in AWS sowie Databricks Unity Catalog und Snowflake Horizon Catalog in AWS oder Google Cloud) und SaaS-Daten-Clouds (Salesforce Data Cloud, Workday Data Lake in AWS oderGoogle Cloudund SAP Business Data Cloud (BDC)) über die Iceberg REST API und Delta Sharing (für SAP BDC).
- Externer Cloud-Objektspeicher (AWS): Speichert Apache Iceberg-Tabellen (Parquet-Datendateien) und Amazon S3-Tabellen in Amazon S3 für direkte Blocklesevorgänge über CCI oder das Internet (mit TLS).
So funktioniert der Zugriff auf cloudübergreifende Daten
Lakehouse fragt Remote-Daten mit dem folgenden Prozess ab:
- Metadaten-Erkennung: Das Lakehouse von Google Cloudstellt eine Verbindung zu Remote-Apache Iceberg REST-Katalogen wie Databricks Unity oder AWS Glue her. Lakehouse erkennt die Daten, ohne Dateien zu kopieren. Je nach Remote-Kataloganbieter authentifiziert sich Lakehouse sicher über Secret Manager oder die OIDC-Tokenföderation mit Google als Identitätsanbieter.
- Sicherer Transport: Wenn Sie Traffic über eine private Interconnect-Verbindung (z. B. Dedicated CCI oder Partner Interconnect) weiterleiten, werden die Kosten für die Datenübertragung im Vergleich zum öffentlichen Internet erheblich reduziert und die Latenz ist sehr vorhersehbar.
- Optimierte Ausführung: Wenn Abfragen Daten aus Remote-Clouds lesen, speichert Lakehouse diese Datensegmente vorübergehend lokal in Google Cloud auf einem speziellen Speicher. Bei nachfolgenden Abfragen wird der lokale Cache verwendet, wodurch ein erheblicher Teil der Gebühren für cloudübergreifenden ausgehenden Traffic vermieden wird.
Unterstützte Kataloge
Lakehouse unterstützt das Abfragen von Daten aus den folgenden Remote-Katalogen:
- Databricks Unity Catalog: Gehostet auf Amazon Web Services (AWS) oder Google Cloud.
- AWS Glue: Wird auf AWS gehostet.
- Snowflake Horizon Catalog: Gehostet auf AWS oder Google Cloud.
- Workday Data Lake: Gehostet auf AWS oder Google Cloud.
- SAP Business Data Cloud (BDC): Gehostet auf AWS, Microsoft Azure oder Google Cloud mit dem SAP BDC-Connector.
Wichtige Konzepte
In diesem Abschnitt werden die wichtigsten Komponenten beschrieben, die für die Verwendung der Funktion für den cloudübergreifenden Datenzugriff erforderlich sind.
Metadatenebene
Die Metadatenebene stellt eine Verbindung zu Remote-Apache Iceberg-REST-Katalogendpunkten her, um Metadaten von Iceberg-Ressourcen (Namespace, Tabelle) basierend auf einem Aktualisierungsintervall zu synchronisieren. Lakehouse authentifiziert sich sicher mit OAuth-Anmeldedaten, die in Secret Manager oder der OIDC-Token-Föderation gespeichert sind.
Transportschicht
Die Transportschicht ermöglicht es BigQuery und Open-Source-Engines, die Daten mithilfe der synchronisierten Metadaten aus der Metadatenschicht abzufragen. Für bestimmte Arten von Remote-Katalogen unterstützt Lakehouse das Abfragen von Daten über das öffentliche Internet oder eine dedizierte private Interconnect-Verbindung.
Wählen Sie die Transportmethode aus, die Ihren Architektur- und Sicherheitsanforderungen entspricht:
Kundeneigen (CCI)
Sie können BigQuery so konfigurieren, dass Daten, die in AWS Amazon S3-Buckets gespeichert sind, über eine private Cross-Cloud Interconnect-Verbindung abgefragt werden. Dazu können Sie entweder Dedicated Cross-Cloud Interconnect oder Partner Cross-Cloud Interconnect verwenden.
Die Verwendung eines privaten Interconnect bietet folgende Vorteile:
- Erhöhte Sicherheit: Daten werden über eine private Netzwerkverbindung zwischen Google Cloud und AWS übertragen, ohne das öffentliche Internet zu nutzen.
- Geringere Kosten: Potenziell niedrigere Gebühren für ausgehenden Traffic von AWS im Vergleich zu ausgehendem Internet-Traffic, insbesondere in Kombination mit Ihrer privaten Interconnect-Kapazität.
- Konsistente Leistung: Vorhersehbarere Netzwerklatenz und Bandbreite im Vergleich zum öffentlichen Internet.
Architektur
Wenn Sie private Abfragen aktivieren möchten, konfigurieren Sie einen Pfad von BigQuery zu Ihrem AWS Amazon S3-Bucket über Ihre private Interconnect-Verbindung. Eine Schlüsselkomponente in der Google CloudVirtual Private Cloud (VPC) ist ein interner Load Balancer (ILB). Der ILB verteilt Anfragen von BigQuery an die privaten Endpunkte für Amazon S3 in Ihrer AWS-VPC, die mit AWS PrivateLink bereitgestellt werden.
Die Verwendung eines ILB mit mehreren Elastic Network Interfaces (ENIs) als Back-Ends ist für Load Balancing, Skalierbarkeit und Hochverfügbarkeit unerlässlich. Dies gilt unabhängig davon, ob Sie Dedicated CCI oder Partner Interconnect verwenden.
Der Workflow für private Abfragen sieht so aus:
- BigQuery verwendet eine Verbindung, die mit einem Service Directory-Dienst konfiguriert ist.
- Service Directory löst den Dienstnamen in die interne IP-Adresse des Google Cloud ILB auf.
- Der ILB empfängt die Anfragen von BigQuery und verteilt sie an konfigurierte Back-Ends.
- Die ILB-Backends sind Netzwerk-Endpunktgruppen (NEGs) mit Hybridkonnektivität, die jeweils auf die private IP-Adresse einer ENI in Ihrer AWS-VPC verweisen.
- Der Traffic fließt vom ILB über die NEGs und die private Interconnect-Verbindung zu den AWS-ENIs.
- Die AWS-ENIs, die Teil eines Amazon S3-VPC-Schnittstellenendpunkts (AWS PrivateLink) sind, bieten privaten Zugriff auf den Amazon S3-Dienst.
Öffentliches Internet (kein CCI)
Wenn Sie keine private Interconnect-Verbindung konfigurieren, werden Abfragen an Ihren Remote-Katalog standardmäßig über das öffentliche Internet übertragen.
Beachten Sie beim Abfragen von Daten über das öffentliche Internet die folgenden Auswirkungen:
- Standardverschlüsselung: Datenzugriffsanfragen und Datenübertragungen werden während der Übertragung über das öffentliche Internet mit Standard-TLS-Protokollen verschlüsselt.
- Kosten für ausgehenden Traffic: Für die Datenübertragung fallen die standardmäßigen Gebühren für ausgehenden Internettraffic Ihres Remote-Cloud-Anbieters (z. B. AWS) an, die in der Regel höher sind als die Gebühren für ausgehenden Traffic über eine private Interconnect-Verbindung.
- Variable Latenz: Netzwerkleistung, Bandbreite und Latenz hängen vom Routing und der Überlastung im öffentlichen Internet ab. Dies führt zu weniger vorhersehbaren Abfrageausführungszeiten im Vergleich zu einer dedizierten privaten Interconnect-Verbindung.
- Vereinfachte Einrichtung: Es ist keine zusätzliche Netzwerkinfrastruktur, kein VPC-Peering und keine Service Directory-Konfiguration in Google Cloud oder bei Ihrem Remote-Cloud-Anbieter erforderlich.
Architektur
Wenn Sie Daten über das öffentliche Internet abfragen, stellt Lakehouse eine direkte Verbindung zu Ihren Remote-Katalog- und Objektspeicher-Endpunkten her, ohne dass eine private Google Cloud - oder Remote-Cloud-Netzwerkinfrastruktur erforderlich ist.
Der Workflow für Abfragen im öffentlichen Internet sieht so aus:
- BigQuery initiiert eine Abfrage für eine Remote-Tabelle, die in Ihrem Lakehouse-Katalog definiert ist.
- Lakehouse authentifiziert sich sicher bei Ihrem Remote-Apache Iceberg-Katalog mit Anmeldedaten, die in Secret Manager oder der OIDC-Tokenföderation gespeichert sind.
- Lakehouse ruft die Tabellenmetadaten und Manifestdateien über das öffentliche Internet ab, um die relevanten zugrunde liegenden Datendateien zu identifizieren (z. B. in AWS Amazon S3).
- Datenzugriffsanfragen für die zugrunde liegenden Objekte werden direkt vonGoogle Cloud über das öffentliche Internet mit Standard-TLS-Verschlüsselung gesendet.
- Der Remote-Speicherdienst verifiziert die Anfrage mithilfe von temporären, bereichsbezogenen Anmeldedaten, die von Lakehouse bereitgestellt werden, und gibt die angeforderten Datenblöcke über das öffentliche Internet an Google Cloudzurück.
Intelligentes Caching
Wenn Sie Remote-Cloud-Daten abfragen, werden die abgerufenen Datenblöcke von Lakehouse automatisch lokal in Google Cloudzwischengespeichert. Caching ist für alle cloudübergreifenden Abfragen automatisch aktiviert, um die Gebühren für ausgehenden Traffic von Remote-Cloud-Anbietern zu minimieren. Nachfolgende Abfragen, die auf im Cache gespeicherte Daten abzielen, werden direkt aus dem lokalen Google Cloud -Speicher gelesen, anstatt die Daten noch einmal über Clouds hinweg abzurufen.
Kosteneinsparungen bei ausgehendem Traffic
Bei der ersten Abfrageausführung ruft Lakehouse die erforderlichen Datenblöcke vom Remote-Cloud-Anbieter ab und füllt den lokalen Cache. Nachfolgende Abfragen, die auf dieselben Datenblöcke abzielen, werden direkt aus dem lokalenGoogle Cloud -Cache gelesen, anstatt die Daten erneut über Clouds hinweg abzurufen.
Bei Arbeitslasten mit wiederholten Abfragemustern für dasselbe Dataset reduziert das Caching die cloudübergreifenden Gebühren für ausgehenden Traffic, da Datenanfragen aus dem lokalen Speicher bedient werden. Die tatsächlichen Einsparungen bei den Kosten für ausgehenden Traffic hängen von Faktoren wie Abfragezugriffsmustern, Datenänderungsraten und Cache-Aufbewahrung in der Zielregion von Google Cloudab.
Cache-Nutzung und Kosteneinsparungen für ausgehenden Traffic in Jobstatistiken prüfen
Wenn Sie die Cache-Trefferraten und die Einsparungen bei den Kosten für ausgehenden Traffic für eine Abfrage prüfen möchten, sehen Sie sich die Abfragestatistiken in der BigQuery-Konsole oder ‑API (JobStatistics2) an. Da eine Abfrage auf Daten von mehreren Anbietern verweisen kann, enthalten die Jobstatistiken ein wiederkehrendes object_storage_stats-Feld (objectStorageStats) mit einem Eintrag für jeden Cloud-Anbieter, auf den während der Ausführung zugegriffen wurde.
Für jeden object_storage_stats-Eintrag werden die folgenden Messwerte erfasst:
cloud_provider(cloudProvider): Der Cloud-Anbieter, der den Objektspeicher hostet (z. B.AWSoderAZURE).cache_bytes_read(cacheBytesRead): Die Gesamtzahl der Byte, die aus dem lokalen Google Cloud Cache gelesen wurden, wodurch ein Lesevorgang im Remote-Objektspeicher vermieden wurde.object_storage_bytes_read(objectStorageBytesRead): Die Gesamtzahl der Byte, die direkt aus dem Objektspeicher des Remote-Cloud-Anbieters gelesen wurden.
Überlegungen zum Datenstandort und zur Gerichtsbarkeit
Wenn Sie einen Remote-Katalog oder eine Remote-Verbindung in einer Google Cloud -Region erstellen, werden im Cache gespeicherte inaktive Daten lokal in dieser Zielregion gespeichert.
Wenn sich Ihre Remote-Cloud-Daten in einer anderen geografischen Region oder Gerichtsbarkeit befinden (z. B. AWS Amazon S3 in der Europäischen Union in Kombination mit BigQuery-Computing in us-east4), werden bei cloudübergreifenden Abfragen im Ruhezustand befindliche Kopien von Remote-Daten in der ZielregionGoogle Cloud gespeichert. Der Nutzer oder Administrator, der die Verbindung oder den Katalog erstellt, muss dafür sorgen, dass das Caching über mehrere Gerichtsbarkeiten hinweg den Anforderungen seiner Organisation an Datenstandort, Datenhoheit und Compliance entspricht.
Verschlüsselung und CMEK-Unterstützung
Kundenverwaltete Verschlüsselungsschlüssel (CMEK) werden für das Lakehouse-Caching nicht unterstützt. Alle im Cache gespeicherten Datenblöcke werden im Ruhezustand mit der Standardverschlüsselung vonGoogle-owned and Google-managed encryption keysverschlüsselt.
Wenn Ihre Organisation die Einschränkung der Organisationsrichtlinie Nicht-CMEK-Dienste einschränken (constraints/gcp.restrictNonCmekServices) erzwingt, deaktiviert Lakehouse automatisch das Caching für Abfragen, die auf eingeschränkte Tabellen zugreifen. Die Abfragen werden weiterhin erfolgreich ausgeführt, aber es werden keine Datenblöcke im Cache gespeichert und es gibt keine Einsparungen beim ausgehenden Traffic im Zusammenhang mit dem Cache.
Nächste Schritte
- Richten Sie eine cloudübergreifende Verbindung für AWS Glue, Databricks Unity Catalog, Snowflake Horizon Catalog, Workday Data Lake oder SAP Geschäftsdaten-Cloud ein.