


크로스 클라우드 데이터 액세스 기능을 사용하면 Cross-Cloud Interconnect를 사용하여 파일을 마이그레이션하거나 복잡한 ETL 파이프라인을 빌드하지 않고도 다른 클라우드 제공업체에 저장된 데이터를 에서 직접 쿼리할 수 있습니다. Google Cloud
경계 없는 레이크하우스의 일부인 이 기능을 사용하면 BigQuery, 독립형 Apache Spark 환경 또는 Managed Service for Apache Spark를 사용하여 분산 데이터 세트 전반에서 통합 분석을 실행하고 AI를 적용할 수 있습니다.
분석 쿼리 외에도 AI 기반 인사이트 및 거버넌스에 원격 데이터를 사용할 수 있습니다.
- 대화형 분석: 크로스 클라우드 테이블을 비롯한 정확한 데이터 소스를 기반으로 하는 전문 에이전트를 빌드하여 단일 대화에서 클라우드 전반의 데이터를 분석합니다.
- Knowledge Catalog: Knowledge Catalog 기능을 사용하여 원격 데이터 소스로 데이터 프로파일링 및 인사이트를 얻습니다.
사용 사례
레이크하우스는 여러 클라우드 제공업체에서 데이터에 액세스하기 위한 몇 가지 주요 사용 사례를 지원합니다.
- 데이터 이동 감소 를 사용하면 다른 클라우드 환경에 저장된 데이터를 직접 쿼리하여 데이터 액세스 및 처리를 간소화할 수 있습니다.
- 통합 분석 을 사용하면 데이터가 어디에 있든 일관된 기능과 하드웨어 최적화를 통해 모든 데이터에서 고급 분석을 실행할 수 있습니다.
- 경계 없는 AI 및 ML 을 사용하면 원격 데이터를 마이그레이션하지 않고도 AI 모델, 자율 에이전트, 머신러닝을 원격 데이터에 직접 적용할 수 있습니다.
아키텍처
다음 다이어그램은 레이크하우스 크로스 클라우드 데이터 액세스 아키텍처를 보여줍니다.
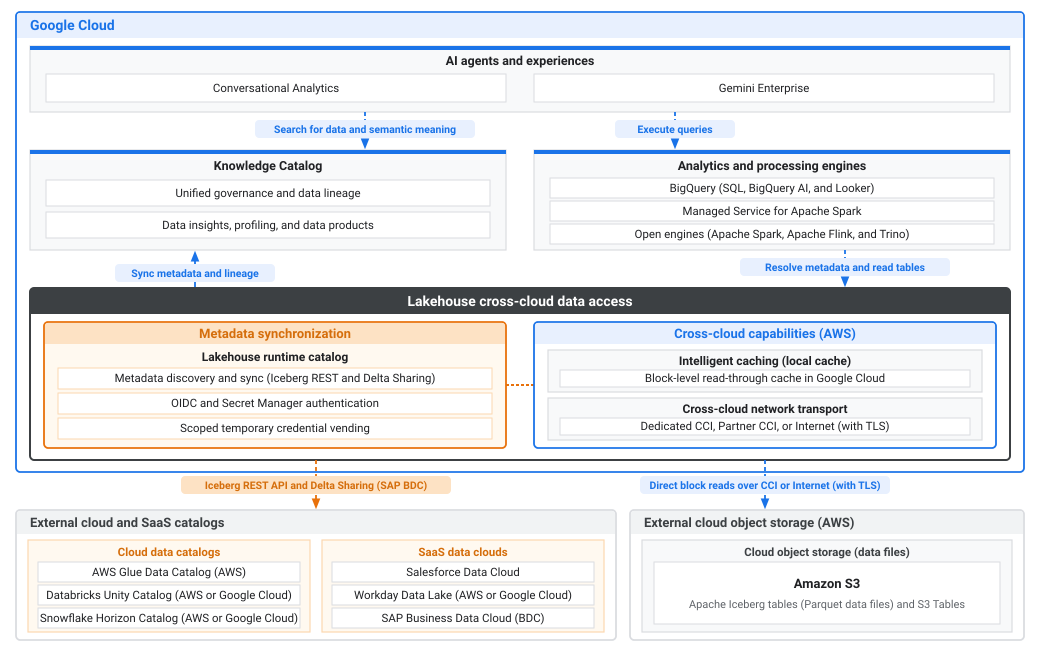
위 다이어그램은 Google Cloud 및 외부 클라우드 및 SaaS 환경 전반의 아키텍처를 보여줍니다.
- Google Cloud: 원격 데이터 세트 전반에서 AI, 거버넌스, 분석, 크로스 클라우드 데이터 액세스를 제공합니다.
- AI 에이전트 및 환경: Knowledge Catalog에서 데이터 및 시맨틱 의미를 검색하고 분석 및 처리 엔진을 통해 쿼리를 실행하는 대화형 분석 및 Gemini Enterprise에서 자율 에이전트를 빌드합니다.
- Knowledge Catalog: 레이크하우스에서 메타데이터 및 데이터 계보를 동기화하여 데이터 인사이트, 프로파일링, 데이터 제품과 함께 통합 거버넌스 및 데이터 계보를 제공합니다.
- 분석 및 처리 엔진: BigQuery SQL, BigQuery AI, Looker 워크로드를 실행하거나 레이크하우스를 통해 메타데이터를 확인하고 테이블을 읽어 Managed Service for Apache Spark 및 오픈 엔진 (Apache Spark, Apache Flink, Trino)으로 원격 데이터를 처리합니다.
- 레이크하우스 크로스 클라우드 데이터 액세스: 파일 마이그레이션 또는 ETL 파이프라인 없이 원격
데이터를 즉시 쿼리합니다.
- 메타데이터 동기화: 레이크하우스 런타임 카탈로그를 사용하여 Apache Iceberg REST 및 Delta 공유를 통해 테이블 메타데이터를 검색하고 동기화하며, OpenID Connect (OIDC) 또는 Secret Manager를 통해 인증하고, 범위가 지정된 임시 사용자 인증 정보를 제공합니다.
- 크로스 클라우드 기능 (AWS): 블록 수준 읽기 캐시 (지능형 캐싱 (로컬 캐시))를 사용하여 읽은 데이터 블록을 에 캐시하고 Google Cloud Dedicated Cross-Cloud Interconnect (CCI), Partner Interconnect 또는 인터넷 (TLS 사용)을 통해 트래픽을 라우팅합니다. 크로스 클라우드 네트워크 전송을 사용하여
- 외부 클라우드 및 SaaS 데이터 소스: 원격 카탈로그, SaaS
데이터 클라우드, 객체 스토리지를 호스팅합니다.
- 외부 클라우드 및 SaaS 카탈로그: Iceberg REST API 및 Delta 공유 (SAP BDC용)를 통해 클라우드 데이터 카탈로그(AWS의 AWS Glue Data Catalog, AWS 또는 의 Databricks Unity Catalog 및 Snowflake Horizon Catalog Google Cloud) 및 SaaS 데이터 클라우드 (Salesforce Data Cloud, AWS 또는 의 Workday Data Lake Google Cloud, SAP Business Data Cloud (BDC))의 메타데이터를 동기화합니다.
- 외부 클라우드 객체 스토리지 (AWS): CCI 또는 인터넷 (TLS 사용)을 통한 직접 블록 읽기를 위해 Apache Iceberg 테이블 (Parquet 데이터 파일) 및 Amazon S3 테이블을 Amazon S3에 저장합니다.
크로스 클라우드 데이터 액세스 작동 방식
레이크하우스는 다음 프로세스를 사용하여 원격 데이터를 쿼리합니다.
- 메타데이터 검색: Google Cloud's Lakehouse 는 Databricks Unity 또는 AWS Glue와 같은 원격 Apache Iceberg REST 카탈로그에 연결합니다. 레이크하우스는 파일을 복사하지 않고 데이터를 검색합니다. 원격 카탈로그 제공업체에 따라 레이크하우스는 Secret Manager 또는 Google을 ID 제공업체로 사용하는 OIDC 토큰 제휴를 통해 안전하게 인증합니다.
- 보안 전송: 비공개 상호 연결(예: Dedicated CCI 또는 Partner Interconnect)을 통해 트래픽을 라우팅하도록 선택하면 공개 인터넷에 비해 데이터 전송 비용이 크게 절감되고 지연 시간을 예측하기 쉬워집니다.
- 최적화된 실행: 쿼리가 원격 클라우드에서 데이터를 읽을 때 레이크하우스는 이러한 데이터 세그먼트를 특수 스토리지의 내에 Google Cloud 로컬로 일시적으로 캐시합니다. 후속 쿼리는 로컬 캐시를 사용하므로 크로스 클라우드 이그레스 요금의 상당 부분을 피할 수 있습니다.
지원되는 카탈로그
레이크하우스는 다음 원격 카탈로그 제공업체의 데이터 쿼리를 지원합니다.
- Databricks Unity Catalog: Amazon Web Services (AWS) 또는 에 호스팅됩니다 Google Cloud.
- AWS Glue: AWS에 호스팅됩니다.
- Snowflake Horizon Catalog: AWS 또는 에 호스팅됩니다 Google Cloud.
- Workday 데이터 레이크: AWS 또는 에 호스팅됩니다 Google Cloud.
- SAP 비즈니스 데이터 클라우드 (BDC): AWS, Microsoft Azure 또는 Google Cloud SAP BDC 커넥터를 사용하여 에 호스팅됩니다.
핵심 개념
이 섹션에서는 크로스 클라우드 데이터 액세스 기능을 사용하는 데 필수적인 주요 구성요소를 설명합니다.
메타데이터 레이어
메타데이터 레이어는 원격 Apache Iceberg REST 카탈로그 엔드포인트에 연결하여 새로고침 간격을 기준으로 Iceberg 리소스 (네임스페이스, 테이블) 메타데이터를 동기화합니다. 레이크하우스는 Secret Manager 또는 OIDC 토큰 제휴에 저장된 OAuth 사용자 인증 정보를 사용하여 안전하게 인증합니다.
전송 계층
전송 계층을 사용하면 BigQuery 및 오픈소스 엔진이 메타데이터 레이어의 동기화된 메타데이터를 사용하여 데이터를 쿼리할 수 있습니다. 특정 유형의 원격 카탈로그의 경우 레이크하우스는 공개 인터넷 또는 전용 비공개 상호 연결을 통해 데이터 쿼리를 지원합니다.
아키텍처 및 보안 요구사항에 맞는 전송 방법을 선택합니다.
고객 소유 (CCI)
비공개 Cross-Cloud Interconnect를 통해 AWS Amazon S3 버킷에 저장된 데이터를 쿼리하도록 BigQuery를 구성할 수 있습니다. 이때 Dedicated Cross-Cloud Interconnect 또는 Partner Cross-Cloud Interconnect를 사용할 수 있습니다.
비공개 상호 연결을 사용하면 다음과 같은 이점이 있습니다.
- 보안 강화: 데이터는 공개 인터넷을 피하여 와 AWS 간의 비공개 네트워크 연결을 통해 이동합니다. Google Cloud
- 비용 절감: 특히 비공개 상호 연결 용량과 결합된 경우 인터넷 이그레스에 비해 AWS의 이그레스 요금이 낮을 수 있습니다.
- 일관된 성능: 공개 인터넷에 비해 네트워크 지연 시간과 대역폭을 더 예측할 수 있습니다.
아키텍처 개요
비공개 쿼리를 사용 설정하려면 비공개 상호 연결을 통해 BigQuery에서 AWS Amazon S3 버킷으로의 경로를 구성합니다. Virtual Private Cloud (VPC) (VPC)의 주요 구성요소는 내부 부하 분산기 (ILB)입니다. Google Cloud ILB는 BigQuery의 요청을 AWS PrivateLink를 사용하여 프로비저닝된 AWS VPC 내의 Amazon S3의 비공개 엔드포인트로 분산합니다.
여러 탄력적 네트워크 인터페이스 (ENI)를 백엔드로 사용하는 ILB는 부하 분산, 확장성, 고가용성에 필수적입니다. Dedicated CCI 또는 Partner Interconnect를 사용하는지 여부에 관계없이 적용됩니다.
비공개 쿼리 워크플로는 다음 프로세스를 따릅니다.
- BigQuery는 서비스 디렉터리 서비스로 구성된 연결을 사용합니다.
- 서비스 디렉터리는 서비스 이름을 the Google Cloud ILB의 내부 IP 주소로 확인합니다.
- ILB는 BigQuery의 요청을 수신하여 구성된 백엔드로 분산합니다.
- ILB 백엔드는 하이브리드 연결 네트워크 엔드포인트 그룹 (NEG)으로, 각 NEG는 AWS VPC의 ENI의 비공개 IP 주소를 가리킵니다.
- 트래픽은 ILB에서 NEG를 통해 비공개 상호 연결을 거쳐 AWS ENI로 이동합니다.
- Amazon S3 VPC 인터페이스 엔드포인트 (AWS PrivateLink)의 일부인 AWS ENI는 Amazon S3 서비스에 대한 비공개 액세스를 제공합니다.
공개 인터넷 (CCI 없음)
비공개 상호 연결을 구성하지 않으면 원격 카탈로그에 대한 쿼리가 기본적으로 공개 인터넷을 통해 이동합니다.
공개 인터넷을 통해 데이터를 쿼리할 때는 다음과 같은 영향을 고려하세요.
- 표준 암호화: 데이터 액세스 요청 및 데이터 전송은 공개 인터넷에서 표준 TLS 프로토콜을 사용하여 전송 중에 암호화됩니다.
- 이그레스 비용: 데이터 전송에는 원격 클라우드 제공업체 (예: AWS)의 표준 인터넷 이그레스 요금이 발생하며, 이는 일반적으로 비공개 상호 연결 이그레스 요금보다 높습니다.
- 가변 지연 시간: 네트워크 성능, 대역폭, 지연 시간은 공개 인터넷 라우팅 및 정체에 따라 달라지므로 전용 비공개 상호 연결에 비해 쿼리 실행 시간을 예측하기 어렵습니다.
- 간소화된 설정: 또는 원격 클라우드 제공업체에서 추가 네트워킹 인프라, VPC 피어링, 서비스 디렉터리 구성이 필요하지 않습니다. Google Cloud 또는
아키텍처 개요
공개 인터넷을 통해 데이터를 쿼리할 때 레이크하우스는 비공개 Google Cloud 또는 원격 클라우드 네트워킹 인프라가 필요하지 않고 원격 카탈로그 및 객체 스토리지 엔드포인트에 직접 연결합니다.
공개 인터넷 쿼리 워크플로는 다음 프로세스를 따릅니다.
- BigQuery는 레이크하우스 카탈로그에 정의된 원격 테이블에 대해 쿼리를 시작합니다.
- 레이크하우스는 Secret Manager 또는 OIDC 토큰 제휴에 저장된 사용자 인증 정보를 사용하여 원격 Apache Iceberg 카탈로그로 안전하게 인증합니다.
- 레이크하우스는 공개 인터넷을 통해 테이블 메타데이터 및 매니페스트 파일을 가져와 관련 기본 데이터 파일(예: AWS Amazon S3)을 식별합니다.
- 기본 객체에 대한 데이터 액세스 요청은 표준 TLS 암호화를 사용하여 공개 인터넷을 통해 Google Cloud 에서 직접 전송됩니다.
- 원격 스토리지 서비스는 레이크하우스에서 제공하는 범위가 지정된 임시 사용자 인증 정보를 사용하여 요청을 확인하고 요청된 데이터 블록을 공개 인터넷을 통해 에 반환합니다. Google Cloud
지능형 캐싱
원격 클라우드 데이터를 쿼리할 때 레이크하우스는 검색된 데이터 블록을 내에 Google Cloud로컬로 자동 캐시합니다. 원격 클라우드 제공업체의 이그레스 요금을 최소화하기 위해 모든 크로스 클라우드 쿼리에 캐싱이 자동으로 사용 설정됩니다. 캐시된 데이터를 타겟팅하는 후속 쿼리는 클라우드 전반에서 데이터를 다시 가져오는 대신 로컬 Google Cloud 스토리지에서 직접 읽습니다.
이그레스 비용 절감
초기 쿼리 실행 시 레이크하우스는 원격 클라우드 제공업체에서 필요한 데이터 블록을 가져와 로컬 캐시를 채웁니다. 동일한 데이터 블록을 타겟팅하는 후속 쿼리는 클라우드 전반에서 데이터를 다시 가져오는 대신 로컬 Google Cloud 캐시에서 직접 읽습니다.
동일한 데이터 세트에 대해 반복되는 쿼리 패턴이 있는 워크로드의 경우 캐싱은 로컬 스토리지에서 데이터 요청을 제공하여 크로스 클라우드 이그레스 요금을 줄입니다. 실제 이그레스 비용 절감은 쿼리 액세스 패턴, 데이터 수정 비율, 대상 Google Cloud 리전의 캐시 보존과 같은 요소에 따라 달라집니다.
작업 통계에서 캐시 사용량 및 이그레스 비용 절감 확인
쿼리의 캐시 적중률 및 이그레스 비용 절감을 확인하려면 BigQuery 콘솔 또는 API (JobStatistics2)에서 쿼리 통계를 검사합니다. 쿼리는 여러 제공업체의 데이터를 참조할 수 있으므로 작업 통계는 실행 중에 액세스한 각 클라우드 제공업체의 항목이 포함된 반복되는 object_storage_stats (objectStorageStats) 필드를 제공합니다.
각 object_storage_stats 항목은 다음 측정항목을 보고합니다.
cloud_provider(cloudProvider): 객체 스토리지를 호스팅하는 클라우드 제공업체 (예:AWS또는AZURE).cache_bytes_read(cacheBytesRead): 로컬 Google Cloud 캐시에서 읽은 총 바이트 수로, 원격 객체 스토리지 읽기를 방지합니다.object_storage_bytes_read(objectStorageBytesRead): 원격 클라우드 제공업체의 객체 스토리지에서 직접 읽은 총 바이트 수입니다.
데이터 레지던시 및 관할권 고려사항
Google Cloud 리전에서 원격 카탈로그 또는 연결을 만들면 캐시된 저장 데이터가 해당 대상 리전 내에 로컬로 저장됩니다.
원격 클라우드 데이터가 다른 지리적 리전 또는
관할권 (예: 유럽
연합의 AWS Amazon S3와 us-east4의 BigQuery 컴퓨팅 페어링)에 있는 경우 크로스 클라우드
쿼리는 대상
Google Cloud 리전에 원격 데이터의 저장 데이터 캐시된 사본을 저장합니다. 연결 또는 카탈로그를 만드는 사용자 또는 관리자는 관할권 간 캐싱이 조직의 데이터 레지던시, 주권, 규정 준수 요구사항을 준수하는지 확인해야 합니다.
암호화 및 CMEK 지원
고객 관리 암호화 키 (CMEK)는 레이크하우스 캐싱에서 지원되지 않습니다. 모든 캐시된 데이터 블록은 기본 Google-owned and Google-managed encryption keys를 사용하여 저장 데이터로 암호화됩니다.
조직에서 CMEK가 아닌 서비스 제한 조직 정책 제약조건 (constraints/gcp.restrictNonCmekServices)을 적용하는 경우 레이크하우스는 제한된 테이블에 액세스하는 쿼리에 대해 캐싱을 자동으로 사용 중지합니다. 쿼리는 계속 실행되지만 데이터 블록을 캐시하거나 캐시 관련 이그레스 절감 효과를 얻지 못합니다.
다음 단계
- AWS Glue, Databricks Unity Catalog, Snowflake Horizon Catalog, Workday 데이터 레이크, 또는 SAP 비즈니스 데이터 클라우드의 크로스 클라우드 연결을 설정합니다.