


Fitur akses data lintas cloud memungkinkan Anda membuat kueri data yang disimpan di penyimpanan data penyedia cloud lain secara langsung tanpa Google Cloud memigrasikan file atau membuat pipeline ETL yang kompleks dengan Cross-Cloud Interconnect.
Sebagai bagian dari Lakehouse tanpa batas, kemampuan ini memungkinkan Anda melakukan analisis terpadu dan menerapkan AI di seluruh set data terdistribusi menggunakan BigQuery, lingkungan Apache Spark mandiri, atau Managed Service untuk Apache Spark.
Selain kueri analisis, Anda dapat menggunakan data jarak jauh untuk insight dan tata kelola berbasis AI:
- Analisis Percakapan: Buat agen khusus yang didasarkan pada sumber data Anda yang sebenarnya, termasuk tabel lintas cloud, untuk menganalisis data di seluruh cloud dari satu percakapan.
- Knowledge Catalog: Gunakan fitur Knowledge Catalog untuk pembuatan profil dan insight data dengan sumber data jarak jauh.
Kasus penggunaan
Lakehouse mendukung beberapa kasus penggunaan utama untuk mengakses data di beberapa penyedia cloud:
- Pengurangan pergerakan data memungkinkan Anda membuat kueri data yang disimpan di lingkungan cloud lain secara langsung, sehingga menyederhanakan akses dan pemrosesan data.
- Analisis terpadu memungkinkan Anda melakukan analisis lanjutan dengan fitur dan pengoptimalan hardware yang konsisten di seluruh data Anda, terlepas dari tempat data tersebut berada.
- AI dan ML tanpa batas memungkinkan Anda menerapkan model AI, agen otonom, dan machine learning langsung ke data jarak jauh tanpa memigrasikannya.
Arsitektur
Diagram berikut mengilustrasikan arsitektur akses data lintas cloud Lakehouse:
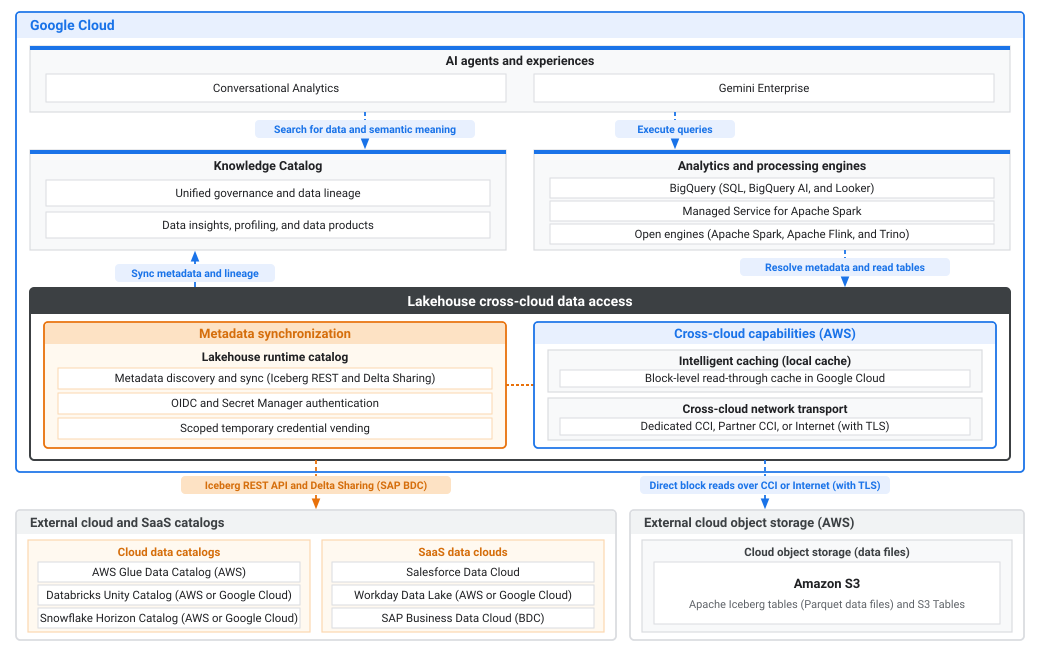
Diagram sebelumnya mengilustrasikan arsitektur di seluruh Google Cloud dan lingkungan cloud dan SaaS eksternal:
- Google Cloud: menyediakan AI, tata kelola, analisis, dan akses data lintas cloud di seluruh set data jarak jauh:
- Agen dan pengalaman AI: membangun agen otonom di Analisis Percakapan dan Gemini Enterprise yang menelusuri data dan makna semantik di Knowledge Catalog serta menjalankan kueri melalui mesin analisis dan pemrosesan.
- Knowledge Catalog: memberikan tata kelola dan silsilah data terpadu, beserta insight data, pembuatan profil, dan produk data, dengan menyinkronkan metadata dan silsilah dari Lakehouse.
- Mesin analisis dan pemrosesan: menjalankan workload BigQuery SQL, BigQuery AI, dan Looker, atau memproses data jarak jauh dengan Managed Service untuk Apache Spark dan mesin terbuka (Apache Spark, Apache Flink, dan Trino) dengan menyelesaikan metadata dan membaca tabel melalui Lakehouse.
- Akses data lintas cloud Lakehouse: membuat kueri data jarak jauh
di tempat tanpa migrasi file atau pipeline ETL:
- Sinkronisasi metadata: menemukan dan menyinkronkan metadata tabel melalui Apache Iceberg REST dan Delta Sharing menggunakan katalog runtime Lakehouse, melakukan autentikasi melalui OpenID Connect (OIDC) atau Secret Manager, dan menjual kredensial sementara yang tercakup.
- Kemampuan lintas cloud (AWS): menyimpan blok data yang dibaca dalam cache Google Cloud menggunakan cache baca-tulis tingkat blok (Caching cerdas (cache lokal)), dan merutekan traffic melalui Dedicated Cross-Cloud Interconnect (CCI), Partner Interconnect, atau internet (dengan TLS) menggunakan Transport jaringan lintas cloud.
- Sumber data cloud dan SaaS eksternal: menghosting katalog jarak jauh, cloud data SaaS, dan penyimpanan objek:
- Katalog cloud dan SaaS eksternal: menyinkronkan metadata dari Katalog data cloud (AWS Glue Data Catalog di AWS, dan Databricks Unity Catalog serta Snowflake Horizon Catalog di AWS atau Google Cloud) dan Cloud data SaaS (Salesforce Data Cloud, Workday Data Lake di AWS atau Google Cloud, dan SAP Business Data Cloud (BDC)) melalui Iceberg REST API dan Delta Sharing (untuk SAP BDC).
- Penyimpanan objek cloud eksternal (AWS): menyimpan tabel Apache Iceberg (file data Parquet) dan Tabel Amazon S3 di Amazon S3 untuk pembacaan blok langsung melalui CCI atau internet (dengan TLS).
Cara kerja akses data lintas cloud
Lakehouse membuat kueri data jarak jauh menggunakan proses berikut:
- Penemuan metadata: Google Cloud's Lakehouse terhubung ke endpoint katalog REST Apache Iceberg jarak jauh, seperti Databricks Unity atau AWS Glue. Lakehouse menemukan data tanpa menyalin file apa pun. Bergantung pada penyedia katalog jarak jauh, Lakehouse melakukan autentikasi dengan aman melalui Secret Manager atau gabungan token OIDC dengan Google sebagai penyedia identitas.
- Transport yang aman: Memilih untuk merutekan traffic melalui interkoneksi pribadi (misalnya, Dedicated CCI atau Partner Interconnect) akan mengurangi biaya transfer data secara signifikan dibandingkan dengan internet publik dan membuat latensi sangat dapat diprediksi.
- Eksekusi yang dioptimalkan: Saat kueri membaca data dari cloud jarak jauh, Lakehouse akan menyimpan sementara segmen data tersebut dalam cache secara lokal di Google Cloud penyimpanan khusus. Kueri berikutnya menggunakan cache lokal, yang menghindari sebagian besar biaya egress lintas cloud.
Katalog yang didukung
Lakehouse mendukung pembuatan kueri data dari penyedia katalog jarak jauh berikut:
- Databricks Unity Catalog: Dihosting di Amazon Web Services (AWS) atau Google Cloud.
- AWS Glue: Dihosting di AWS.
- Snowflake Horizon Catalog: Dihosting di AWS atau Google Cloud.
- Workday Data Lake: Dihosting di AWS atau Google Cloud.
- SAP Business Data Cloud (BDC): Dihosting di AWS, Microsoft Azure, atau Google Cloud menggunakan konektor SAP BDC.
Konsep inti
Bagian ini menjelaskan komponen utama yang penting untuk menggunakan fitur akses data lintas cloud.
Lapisan metadata
Lapisan metadata terhubung ke endpoint katalog REST Apache Iceberg jarak jauh untuk menyinkronkan metadata resource Iceberg (namespace, tabel) berdasarkan interval refresh. Lakehouse melakukan autentikasi dengan aman menggunakan kredensial OAuth yang disimpan di Secret Manager atau gabungan token OIDC.
Lapisan transpor
Lapisan transpor memungkinkan BigQuery dan mesin open source membuat kueri data menggunakan metadata yang disinkronkan dari lapisan metadata. Untuk jenis katalog jarak jauh tertentu, Lakehouse mendukung pembuatan kueri data melalui internet publik atau interkoneksi pribadi khusus.
Pilih metode transpor yang sesuai dengan persyaratan arsitektur dan keamanan Anda:
Milik pelanggan (CCI)
Anda dapat mengonfigurasi BigQuery untuk membuat kueri data yang disimpan di bucket AWS Amazon S3 melalui Cross-Cloud Interconnect pribadi menggunakan Dedicated Cross-Cloud Interconnect atau Partner Cross-Cloud Interconnect.
Menggunakan interkoneksi pribadi memberikan manfaat berikut:
- Keamanan yang ditingkatkan: Data berpindah melalui koneksi jaringan pribadi antara Google Cloud dan AWS, sehingga menghindari internet publik.
- Biaya yang lebih rendah: Potensi biaya egress yang lebih rendah dari AWS dibandingkan dengan egress internet, terutama jika dikombinasikan dengan kapasitas interkoneksi pribadi Anda.
- Performa yang konsisten: Latensi dan bandwidth jaringan yang lebih dapat diprediksi dibandingkan dengan internet publik.
Ringkasan arsitektur
Untuk mengaktifkan kueri pribadi, Anda mengonfigurasi jalur dari BigQuery ke bucket AWS Amazon S3 melalui interkoneksi pribadi. Komponen utama di Google Cloud Virtual Private Cloud (VPC) (VPC) adalah Load Balancer Internal (ILB). ILB mendistribusikan permintaan dari BigQuery ke endpoint pribadi untuk Amazon S3 dalam AWS VPC Anda, yang disediakan menggunakan AWS PrivateLink.
Menggunakan ILB dengan beberapa Elastic Network Interface (ENI) sebagai backend sangat penting untuk load balancing, skalabilitas, dan ketersediaan tinggi. Hal ini berlaku baik Anda menggunakan Dedicated CCI maupun Partner Interconnect.
Alur kerja kueri pribadi mengikuti proses ini:
- BigQuery menggunakan koneksi yang dikonfigurasi dengan layanan Service Directory.
- Service Directory menyelesaikan nama layanan ke alamat IP internal the Google Cloud ILB.
- ILB menerima permintaan dari BigQuery dan mendistribusikannya ke backend yang dikonfigurasi.
- Backend ILB adalah Hybrid Connectivity Network Endpoint Group (NEG), yang masing-masing mengarah ke alamat IP pribadi ENI di AWS VPC Anda.
- Traffic mengalir dari ILB, melalui NEG, melalui interkoneksi pribadi, ke ENI AWS.
- ENI AWS, yang merupakan bagian dari Endpoint Antarmuka VPC Amazon S3 (AWS PrivateLink), menyediakan akses pribadi ke layanan Amazon S3.
Internet publik (tanpa CCI)
Jika Anda tidak mengonfigurasi interkoneksi pribadi, kueri ke katalog jarak jauh akan berpindah melalui internet publik secara default.
Saat membuat kueri data melalui internet publik, pertimbangkan implikasi berikut:
- Enkripsi standar: Permintaan akses data dan transfer data dienkripsi dalam pengiriman menggunakan protokol TLS standar di seluruh internet publik.
- Biaya egress: Transfer data dikenai biaya egress internet standar dari penyedia cloud jarak jauh Anda (misalnya, AWS), yang biasanya lebih tinggi daripada tarif egress interkoneksi pribadi.
- Latensi variabel: Performa jaringan, bandwidth, dan latensi bergantung pada perutean dan kemacetan internet publik, sehingga menghasilkan waktu eksekusi kueri yang kurang dapat diprediksi dibandingkan dengan interkoneksi pribadi khusus.
- Penyiapan yang disederhanakan: Tidak memerlukan infrastruktur jaringan tambahan, peering VPC, atau konfigurasi Service Directory di Google Cloud atau penyedia cloud jarak jauh Anda.
Ringkasan arsitektur
Saat membuat kueri data melalui internet publik, Lakehouse terhubung langsung ke endpoint katalog dan penyimpanan objek jarak jauh tanpa memerlukan infrastruktur jaringan cloud pribadi Google Cloud atau jarak jauh.
Alur kerja kueri internet publik mengikuti proses ini:
- BigQuery memulai kueri terhadap tabel jarak jauh yang ditentukan dalam katalog Lakehouse Anda.
- Lakehouse melakukan autentikasi dengan aman menggunakan katalog Apache Iceberg jarak jauh Anda menggunakan kredensial yang disimpan di Secret Manager atau gabungan token OIDC.
- Lakehouse mengambil metadata tabel dan file manifes di seluruh internet publik untuk mengidentifikasi file data dasar yang relevan (misalnya, di AWS Amazon S3).
- Permintaan akses data untuk objek dasar dikirim langsung dari Google Cloud melalui internet publik menggunakan enkripsi TLS standar.
- Layanan penyimpanan jarak jauh memverifikasi permintaan menggunakan kredensial sementara yang tercakup yang dijual oleh Lakehouse dan menampilkan blok data yang diminta di seluruh internet publik ke Google Cloud.
Caching cerdas
Saat Anda membuat kueri data cloud jarak jauh, Lakehouse akan otomatis menyimpan blok data yang diambil dalam cache secara lokal di Google Cloud. Caching diaktifkan secara otomatis untuk semua kueri lintas cloud guna membantu meminimalkan biaya egress dari penyedia cloud jarak jauh. Kueri berikutnya yang menargetkan data dalam cache dibaca langsung dari penyimpanan lokal Google Cloud bukan mengambil ulang data di seluruh cloud.
Penghematan biaya egress
Pada eksekusi kueri awal, Lakehouse mengambil blok data yang diperlukan dari penyedia cloud jarak jauh dan mengisi cache lokal. Kueri berikutnya yang menargetkan blok data yang sama dibaca langsung dari cache Google Cloud lokal, bukan mengambil ulang data di seluruh cloud.
Untuk workload dengan pola kueri berulang pada set data yang sama, caching mengurangi biaya egress lintas cloud dengan menayangkan permintaan data dari penyimpanan lokal. Penghematan biaya egress yang sebenarnya bergantung pada faktor-faktor seperti pola akses kueri, kecepatan modifikasi data, dan retensi cache di region target Google Cloud.
Memverifikasi penggunaan cache dan penghematan biaya egress dalam statistik tugas
Untuk memverifikasi kecepatan hit cache dan penghematan biaya egress untuk kueri, periksa statistik kueri di konsol atau API BigQuery (JobStatistics2). Karena kueri dapat mereferensikan data di beberapa penyedia, statistik tugas menyediakan kolom object_storage_stats (objectStorageStats) berulang dengan entri untuk setiap penyedia cloud yang diakses selama eksekusi.
Setiap entri object_storage_stats melaporkan metrik berikut:
cloud_provider(cloudProvider): Penyedia cloud yang menghosting penyimpanan objek (misalnya,AWSatauAZURE).cache_bytes_read(cacheBytesRead): Total byte yang dibaca dari cache lokal Google Cloud , sehingga menghindari pembacaan penyimpanan objek jarak jauh.object_storage_bytes_read(objectStorageBytesRead): Total byte yang dibaca langsung dari penyimpanan objek penyedia cloud jarak jauh.
Pertimbangan residensi dan yurisdiksi data
Membuat katalog atau koneksi jarak jauh di a Google Cloud region akan menyimpan data dalam cache saat tidak aktif secara lokal dalam region target tersebut.
Jika residensi data cloud jarak jauh Anda berada di region atau yurisdiksi geografis yang berbeda (misalnya, AWS Amazon S3 di Uni Eropa yang dipasangkan dengan komputasi BigQuery di us-east4), kueri lintas cloud akan menyimpan salinan data dalam cache yang tidak aktif dari data jarak jauh di regionGoogle Cloud target. Pengguna atau administrator yang membuat koneksi atau katalog harus memastikan bahwa caching lintas yurisdiksi mematuhi persyaratan residensi data, kedaulatan, dan kepatuhan organisasi mereka.
Dukungan enkripsi dan CMEK
Kunci enkripsi yang dikelola pelanggan (CMEK) tidak didukung untuk caching Lakehouse. Semua blok data dalam cache dienkripsi dalam penyimpanan menggunakan default Google-owned and Google-managed encryption keys.
Jika organisasi Anda menerapkan batasan kebijakan organisasi Restrict Non-CMEK Services (constraints/gcp.restrictNonCmekServices), Lakehouse akan otomatis menonaktifkan caching untuk kueri yang mengakses tabel yang dibatasi. Kueri masih berhasil dijalankan, tetapi tidak menyimpan blok data dalam cache atau mendapatkan manfaat dari penghematan egress terkait cache.
Langkah berikutnya
- Siapkan koneksi lintas cloud untuk AWS Glue, Databricks Unity Catalog, Snowflake Horizon Catalog, Workday Data Lake, atau SAP Business Data Cloud.