


La función de acceso a datos entre nubes te permite consultar datos almacenados en otros proveedores de servicios en la nube directamente desde Google Cloud sin migrar archivos ni compilar canalizaciones de ETL complejas con Cross‑Cloud Interconnect.
Como parte de Lakehouse sin límites, esta capacidad te permite realizar análisis unificados y aplicar IA en tus conjuntos de datos distribuidos con BigQuery, entornos independientes de Apache Spark o Managed Service para Apache Spark.
Además de las consultas analíticas, puedes usar tus datos remotos para obtener estadísticas y administración basadas en IA:
- Conversational Analytics: Compila agentes especializados fundamentados en tus fuentes de datos exactas, incluidas las tablas multinube, para analizar datos en las nubes desde una sola conversación.
- Knowledge Catalog: Usa las funciones de Knowledge Catalog para la generación de perfiles de datos y las estadísticas con fuentes de datos remotas.
Casos de uso
Lakehouse admite varios casos de uso clave para acceder a datos en varios proveedores de servicios en la nube:
- El movimiento de datos reducido te permite consultar datos almacenados en otros entornos de nube directamente, lo que simplifica el acceso y el procesamiento de datos.
- El análisis unificado te permite realizar análisis avanzados con funciones coherentes y optimización de hardware en todos tus datos, sin importar dónde residan.
- La IA y el AA sin límites te permiten aplicar modelos de IA, agentes autónomos y aprendizaje automático directamente a tus datos remotos sin migrarlos.
Arquitectura
En el siguiente diagrama, se ilustra la arquitectura de acceso a datos multinube de Lakehouse:
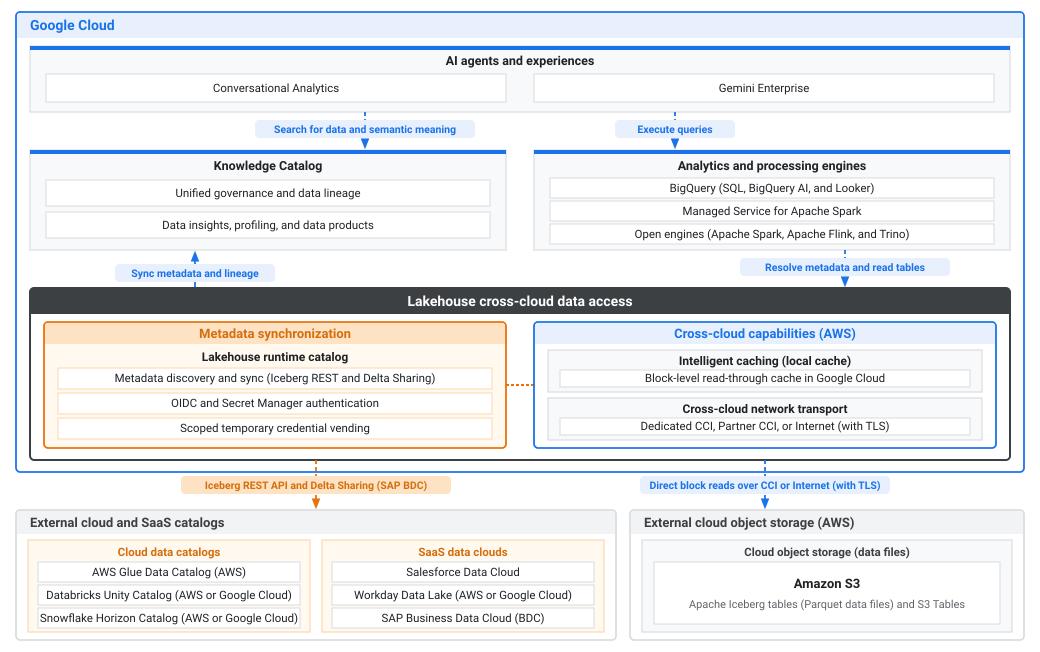
En el diagrama anterior, se ilustra la arquitectura en entornos de nube y SaaS externos: Google Cloud
- Google Cloud: Proporciona IA, administración, análisis y acceso a datos multinube en conjuntos de datos remotos:
- Agentes y experiencias de IA: Compila agentes autónomos en Conversational Analytics y Gemini Enterprise que buscan datos y significado semántico en Knowledge Catalog y ejecutan consultas a través de motores de análisis y procesamiento.
- Knowledge Catalog: Ofrece administración unificada y linaje de datos, junto con estadísticas de datos, generación de perfiles, y productos de datos, mediante la sincronización de metadatos y linaje de Lakehouse.
- Motores de análisis y procesamiento: Ejecuta cargas de trabajo de BigQuery SQL, BigQuery AI y Looker, o procesa datos remotos con Managed Service para Apache Spark y motores abiertos (Apache Spark, Apache Flink y Trino) mediante la resolución de metadatos y la lectura de tablas a través de Lakehouse.
- Acceso a datos multinube de Lakehouse: Consulta datos remotos en el lugar sin migración de archivos ni canalizaciones de ETL:
- Sincronización de metadatos: Descubre y sincroniza metadatos de tablas a través de Apache Iceberg REST y Delta Sharing con el catálogo de entornos de ejecución de Lakehouse, se autentica a través de OpenID Connect (OIDC) o Secret Manager, y vende credenciales temporales con alcance.
- Capacidades multinube (AWS): Almacena en caché los datos leídos bloques en Google Cloud con una caché de lectura directa a nivel de bloque (Almacenamiento en caché inteligente (caché local)) y enruta el tráfico a través de Cross‑Cloud Interconnect (CCI) dedicada, interconexión de socio o Internet (con TLS) con transporte de red multinube.
- Fuentes de datos de SaaS y de la nube externa: Aloja los catálogos remotos, las nubes de datos de SaaS
y el almacén de objetos:
- Catálogos de SaaS y de la nube externa: Sincroniza metadatos de catálogos de datos de la nube (AWS Glue Data Catalog en AWS, y Databricks Unity Catalog y Snowflake Horizon Catalog en AWS o Google Cloud) y nubes de datos de SaaS (Salesforce Data Cloud, Workday Data Lake en AWS o Google Cloud, y SAP Business Data Cloud (BDC)) a través de la API de REST de Iceberg y Delta Sharing (para SAP BDC).
- Almacenamiento de objetos de la nube externa (AWS): Almacena tablas de Apache Iceberg (archivos de datos de Parquet) y tablas de Amazon S3 en Amazon S3 para lecturas directas de bloques a través de CCI o Internet (con TLS).
Cómo funciona el acceso a datos multinube
Lakehouse consulta datos remotos con el siguiente proceso:
- Descubrimiento de metadatos: Google Cloud's Lakehouse se conecta a catálogos remotos de Apache Iceberg REST, como Databricks Unity o AWS Glue. Lakehouse descubre los datos sin copiar ningún archivo. Según el proveedor del catálogo remoto, Lakehouse se autentica de forma segura a través de Secret Manager o la federación de tokens de OIDC con Google como proveedor de identidad.
- Transporte seguro: Si eliges enrutar el tráfico a través de una interconexión privada (por ejemplo, CCI dedicada o interconexión de socio), se reducen significativamente los costos de transferencia de datos en comparación con Internet pública y se hace que la latencia sea altamente predecible.
- Ejecución optimizada: A medida que las consultas leen datos de nubes remotas, Lakehouse almacena en caché temporalmente esos segmentos de datos de forma local en Google Cloud almacenamiento especializado. Las consultas posteriores usan la caché local, lo que evita una parte importante de los cargos de salida multinube.
Catálogos admitidos
Lakehouse admite la consulta de datos de los siguientes proveedores de catálogos remotos:
- Catálogo de Unity de Databricks: Alojado en Amazon Web Services (AWS) o Google Cloud.
- AWS Glue: Alojado en AWS.
- Catálogo de Snowflake Horizon: Alojado en AWS o Google Cloud.
- Workday Data Lake: Alojado en AWS o Google Cloud.
- SAP Business Data Cloud (BDC): Alojado en AWS, Microsoft Azure o Google Cloud con el conector de SAP BDC.
Conceptos básicos
En esta sección, se describen los componentes clave esenciales para usar la función de acceso a datos multinube.
Capa de metadatos
La capa de metadatos se conecta a extremos remotos del catálogo de Apache Iceberg REST para sincronizar los metadatos de recursos de Iceberg (espacio de nombres, tabla) según un intervalo de actualización. Lakehouse se autentica de forma segura con credenciales de OAuth almacenadas en Secret Manager o la federación de tokens de OIDC.
Capa de transporte
La capa de transporte permite que BigQuery y los motores de código abierto consulten los datos con los metadatos sincronizados de la capa de metadatos. Para ciertos tipos de catálogos remotos, Lakehouse admite la consulta de datos a través de Internet pública o una interconexión privada dedicada.
Selecciona el método de transporte que coincida con tus requisitos arquitectónicos y de seguridad:
Propiedad del cliente (CCI)
Puedes configurar BigQuery para consultar datos almacenados en buckets de AWS Amazon S3 a través de una interconexión privada de Cross-Cloud con Cross-Cloud Interconnect dedicada o Cross-Cloud Interconnect de socio.
El uso de una interconexión privada proporciona los siguientes beneficios:
- Seguridad mejorada: Los datos viajan a través de una conexión de red privada entre Google Cloud y AWS, lo que evita la Internet pública.
- Reducción de costos: Posiblemente, se reduzcan los cargos de salida de AWS en comparación con la salida de Internet, en especial cuando se combina con la capacidad de interconexión privada.
- Rendimiento coherente: Latencia y ancho de banda de red más predecibles en comparación con Internet pública.
Descripción general de la arquitectura
Para habilitar las consultas privadas, configura una ruta de BigQuery a tu bucket de AWS Amazon S3 a través de tu interconexión privada. Un componente clave en la Google Cloud nube privada virtual (VPC) es un balanceador de cargas interno (ILB). El ILB distribuye las solicitudes de BigQuery a los extremos privados de Amazon S3 dentro de tu VPC de AWS, que se aprovisionan con AWS PrivateLink.
El uso de un ILB con varias interfaces de red elásticas (ENI) como backends es esencial para el balanceo de cargas, la escalabilidad y la alta disponibilidad. Esto se aplica si usas CCI dedicada o interconexión de socio.
El flujo de trabajo de consulta privada sigue este proceso:
- BigQuery usa una conexión configurada con un servicio de Directorio de servicios.
- Directorio de servicios resuelve el nombre del servicio en la dirección IP interna de the Google Cloud ILB.
- El ILB recibe las solicitudes de BigQuery y las distribuye a los backends configurados.
- Los backends de ILB son grupos de extremos de red de conectividad híbrida (NEG), cada uno de los cuales apunta a la dirección IP privada de una ENI en tu VPC de AWS.
- El tráfico fluye desde el ILB, a través de los NEGs, a través de la interconexión privada, hasta las ENIs de AWS.
- Las ENIs de AWS, que forman parte de un extremo de interfaz de VPC de Amazon S3 (AWS PrivateLink), proporcionan acceso privado al servicio de Amazon S3.
Internet pública (sin CCI)
Si no configuras una interconexión privada, las consultas a tu catálogo remoto viajan a través de Internet pública de forma predeterminada.
Cuando consultes datos a través de Internet pública, ten en cuenta las siguientes implicaciones:
- Encriptación estándar: Las solicitudes de acceso a datos y las transferencias de datos se encriptan en tránsito con protocolos TLS estándar a través de Internet pública.
- Costos de salida: La transferencia de datos genera cargos de salida de Internet estándar de tu proveedor de servicios en la nube remoto (por ejemplo, AWS), que suelen ser más altos que las tarifas de salida de interconexión privada.
- Latencia variable: El rendimiento, el ancho de banda y la latencia de la red dependen del enrutamiento y la congestión de Internet pública, lo que genera tiempos de ejecución de consultas menos predecibles en comparación con una interconexión privada dedicada.
- Configuración simplificada: No requiere infraestructura de red adicional, intercambio de tráfico entre VPC ni configuración de Directorio de servicios en Google Cloud o tu proveedor de servicios en la nube remoto.
Descripción general de la arquitectura
Cuando consultas datos a través de Internet pública, Lakehouse se conecta directamente a tu catálogo remoto y a los extremos de almacenamiento de objetos sin requerir privada Google Cloud o infraestructura de red de nube remota.
El flujo de trabajo de consulta de Internet pública sigue este proceso:
- BigQuery inicia una consulta en una tabla remota definida en tu catálogo de Lakehouse.
- Lakehouse se autentica de forma segura con tu catálogo remoto de Apache Iceberg con credenciales almacenadas en Secret Manager o la federación de tokens de OIDC.
- Lakehouse recupera los metadatos de la tabla y los archivos de manifiesto a través de Internet pública para identificar los archivos de datos subyacentes relevantes (por ejemplo, en AWS Amazon S3).
- Las solicitudes de acceso a datos para los objetos subyacentes se envían directamente desde Google Cloud a través de Internet pública con encriptación TLS estándar.
- El servicio de almacenamiento remoto verifica la solicitud con credenciales temporales y con alcance que vende Lakehouse y muestra los bloques de datos solicitados a través de Internet pública a Google Cloud.
Almacenamiento en caché inteligente
Cuando consultas datos de la nube remota, Lakehouse almacena automáticamente en caché los bloques de datos recuperados de forma local en Google Cloud. El almacenamiento en caché se habilita automáticamente para todas las consultas multinube para ayudar a minimizar las tarifas de salida de los proveedores de servicios en la nube remotos. Las consultas posteriores dirigidas a datos almacenados en caché se leen directamente desde el almacenamiento local Google Cloud en lugar de volver a recuperar los datos entre nubes.
Ahorro de costos de salida
En la ejecución de la consulta inicial, Lakehouse recupera los bloques de datos necesarios del proveedor de servicios en la nube remoto y propaga la caché local. Las consultas posteriores dirigidas a los mismos bloques de datos se leen directamente desde la caché local Google Cloud en lugar de volver a recuperar los datos entre nubes.
Para las cargas de trabajo con patrones de consulta repetidos en el mismo conjunto de datos, el almacenamiento en caché reduce las tarifas de salida multinube mediante la entrega de solicitudes de datos desde el almacenamiento local. El ahorro de costos de salida real depende de factores como los patrones de acceso a las consultas, las tasas de modificación de datos y la retención de caché en la región de destino Google Cloud.
Verifica el uso de la caché y el ahorro de costos de salida en las estadísticas de trabajos
Para verificar las tasas de acierto de caché y el ahorro de costos de salida de una consulta, inspecciona las estadísticas de la consulta en la consola o la API de BigQuery (JobStatistics2). Debido a que una consulta puede hacer referencia a datos de varios proveedores, las estadísticas del trabajo proporcionan un campo object_storage_stats (objectStorageStats) repetido con una entrada para cada proveedor de servicios en la nube al que se accedió durante la ejecución.
Cada entrada object_storage_stats informa las siguientes métricas:
cloud_provider(cloudProvider): El proveedor de servicios en la nube que aloja el almacén de objetos (por ejemplo,AWSoAZURE).cache_bytes_read(cacheBytesRead): La cantidad total de bytes leídos de la caché Google Cloud local, lo que evita una lectura de almacén de objetos remoto.object_storage_bytes_read(objectStorageBytesRead): La cantidad total de bytes leídos directamente del almacén de objetos del proveedor de servicios en la nube remoto.
Consideraciones sobre la residencia de datos y la jurisdicción
Si creas un catálogo o una conexión remota en una Google Cloud región, se almacenan los datos almacenados en caché en reposo de forma local dentro de esa región de destino.
Si tus datos de la nube remota residen en una región o
jurisdicción geográfica diferente (por ejemplo, AWS Amazon S3 en la Unión
Europea junto con el procesamiento de BigQuery en us-east4), las consultas entre nubes
almacenan copias almacenadas en caché de datos en reposo de datos remotos en la
Google Cloud región de destino. El usuario o administrador que crea la conexión o el catálogo debe asegurarse de que el almacenamiento en caché entre jurisdicciones cumpla con los requisitos de residencia de datos, soberanía y cumplimiento de su organización.
Encriptación y compatibilidad con CMEK
No se admiten las claves de encriptación administradas por el cliente (CMEK) para el almacenamiento en caché de Lakehouse. Todos los bloques de datos almacenados en caché se encriptan en reposo con el valor predeterminado Google-owned and Google-managed encryption keys.
Si tu organización aplica la restricción de política de la organización Restringir servicios que no sean de CMEK (constraints/gcp.restrictNonCmekServices), Lakehouse inhabilita automáticamente el almacenamiento en caché para las consultas que acceden a tablas restringidas. Las consultas aún se ejecutan correctamente, pero no almacenan en caché los bloques de datos ni se benefician de los ahorros de salida relacionados con la caché.
¿Qué sigue?
- Configura una conexión entre nubes para AWS Glue, Databricks Unity Catalog, Snowflake Horizon Catalog, Workday Data Lake, o SAP Business Data Cloud.