


La fonctionnalité d'accès aux données multicloud vous permet d'interroger des données stockées chez d'autres fournisseurs de cloud directement depuis Google Cloud sans migrer de fichiers ni créer de pipelines ETL complexes avec interconnexion cross-cloud.
Dans le cadre de Lakehouse sans frontières, cette fonctionnalité vous permet d'effectuer des analyses unifiées et d'appliquer l'IA à vos ensembles de données distribués à l'aide de BigQuery, d'environnements Apache Spark autonomes ou Managed Service for Apache Spark.
En plus des requêtes analytiques, vous pouvez utiliser vos données à distance pour obtenir des insights et une gouvernance basés sur l'IA :
- Conversational Analytics: Créez des agents spécialisés basés sur vos sources de données exactes, y compris des tables multicloud, pour analyser les données dans les clouds à partir d'une seule conversation.
- Knowledge Catalog : utilisez les fonctionnalités de Knowledge Catalog pour le profilage des données et les insights avec des sources de données à distance.
Cas d'utilisation
Lakehouse est compatible avec plusieurs cas d'utilisation clés pour accéder aux données de plusieurs fournisseurs de services cloud :
- La réduction des déplacements de données vous permet d'interroger directement les données stockées dans d'autres environnements cloud, ce qui simplifie l'accès aux données et leur traitement.
- L'analyse unifiée vous permet d'effectuer des analyses avancées avec des fonctionnalités cohérentes et une optimisation matérielle sur toutes vos données, quel que soit leur emplacement.
- L'IA et le ML sans frontières vous permettent d'appliquer des modèles d'IA, des agents autonomes et le machine learning directement à vos données à distance sans les migrer.
Architecture
Le schéma suivant illustre l'architecture d'accès aux données multicloud de Lakehouse :
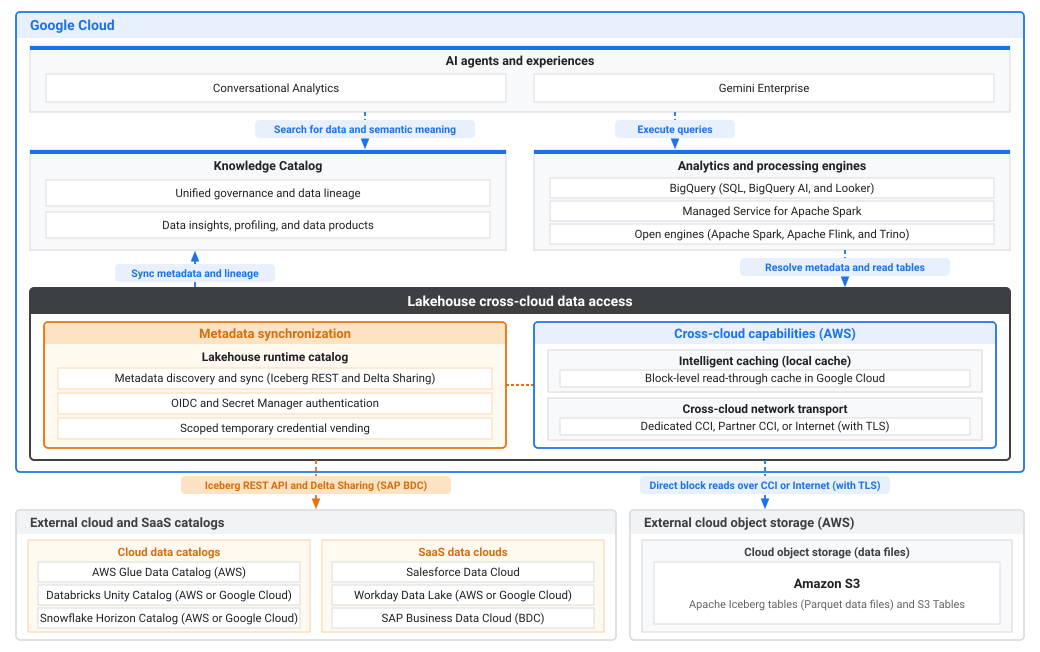
Le schéma précédent illustre l'architecture dans Google Cloud et les environnements cloud et SaaS externes :
- Google Cloud: fournit l'IA, la gouvernance, l'analyse et l'accès aux données multicloud sur des ensembles de données à distance :
- Agents et expériences d'IA : crée des agents autonomes dans Conversational Analytics et Gemini Enterprise qui recherchent des données et une signification sémantique dans Knowledge Catalog, et exécutent des requêtes via des moteurs d'analyse et de traitement.
- Knowledge Catalog : fournit une gouvernance unifiée et une traçabilité des données, ainsi que des informations sur les données, un profilage, et des produits de données, en synchronisant les métadonnées et la traçabilité de Lakehouse.
- Moteurs d'analyse et de traitement : exécute les charges de travail BigQuery SQL, BigQuery AI et Looker, ou traite les données à distance avec Managed Service for Apache Spark et des moteurs ouverts (Apache Spark, Apache Flink et Trino) en résolvant les métadonnées et en lisant les tables via Lakehouse.
- Accès aux données cross-cloud de Lakehouse : interroge les données à distance sur place sans migration de fichiers ni pipelines ETL :
- Synchronisation des métadonnées : découvre et synchronise les métadonnées de table sur Apache Iceberg REST et Delta Sharing à l'aide du catalogue d'environnements d'exécution Lakehouse, s'authentifie via OpenID Connect (OIDC) ou Secret Manager, et fournit des identifiants temporaires limités.
- Fonctionnalités multicloud (AWS) : met en cache les blocs de données lus dans Google Cloud en utilisant un cache de lecture au niveau des blocs (Mise en cache intelligente (cache local)), et achemine le trafic via Dedicated interconnexion cross-cloud (CCI), interconnexion partenaire ou Internet (avec TLS) à l'aide du transport réseau multicloud.
- Sources de données cloud et SaaS externes : héberge les catalogues à distance, les clouds de données SaaS et le stockage d'objets :
- Catalogues cloud et SaaS externes : synchronise les métadonnées des catalogues de données cloud (AWS Glue Data Catalog sur AWS, et Databricks Unity Catalog et Snowflake Horizon Catalog sur AWS ou Google Cloud) et des clouds de données SaaS (Salesforce Data Cloud, Workday Data Lake sur AWS ou Google Cloud, et SAP Business Data Cloud (BDC)) via l'API REST Iceberg et Delta Sharing (pour SAP BDC).
- Stockage d'objets cloud externe (AWS) : stocke les tables Apache Iceberg (fichiers de données Parquet) et les tables Amazon S3 dans Amazon S3 pour les lectures de blocs directs via CCI ou Internet (avec TLS).
Fonctionnement de l'accès aux données multicloud
Lakehouse interroge les données à distance à l'aide du processus suivant :
- Découverte des métadonnées Google Cloud: le Lakehouse de se connecte à des catalogues Apache Iceberg REST à distance, tels que Databricks Unity ou AWS Glue. Lakehouse découvre les données sans copier de fichiers. En fonction du fournisseur de catalogue à distance, Lakehouse s'authentifie de manière sécurisée via Secret Manager ou la fédération de jetons OIDC avec Google comme fournisseur d'identité.
- Transport sécurisé : le choix d'acheminer le trafic via une interconnexion privée (par exemple, CCI dédiée ou interconnexion partenaire) réduit considérablement les coûts de transfert de données par rapport à l'Internet public et rend la latence très prévisible.
- Exécution optimisée : lorsque les requêtes lisent des données provenant de clouds à distance, Lakehouse met temporairement en cache ces segments de données localement dans Google Cloud sur un stockage spécialisé. Les requêtes suivantes utilisent le cache local, ce qui évite une partie importante des frais de sortie cross-cloud.
Catalogues compatibles
Lakehouse permet d'interroger des données provenant des fournisseurs de catalogues à distance suivants :
- Databricks Unity Catalog: hébergé sur Amazon Web Services (AWS) ou Google Cloud.
- **AWS Glue**: hébergé sur AWS.
- Catalogue Snowflake Horizon: hébergé sur AWS ou Google Cloud.
- Lac de données Workday: hébergé sur AWS ou Google Cloud.
- **SAP Business Data Cloud (BDC)**: hébergé sur AWS, Microsoft Azure ou Google Cloud à l'aide du connecteur SAP BDC.
Concepts fondamentaux
Cette section décrit les composants clés essentiels à l'utilisation de la fonctionnalité d'accès aux données multicloud.
Couche de métadonnées
La couche de métadonnées se connecte aux points de terminaison du catalogue Apache Iceberg REST à distance pour synchroniser les métadonnées des ressources Iceberg (espace de noms, table) en fonction d'un intervalle d'actualisation. Lakehouse s'authentifie de manière sécurisée avec les identifiants OAuth stockés dans Secret Manager ou la fédération de jetons OIDC.
Couche transport
La couche transport permet à BigQuery et aux moteurs Open Source d'interroger les données à l'aide des métadonnées synchronisées de la couche de métadonnées. Pour certains types de catalogues à distance, Lakehouse permet d'interroger des données sur l'Internet public ou une interconnexion privée dédiée.
Sélectionnez la méthode de transport qui correspond à vos exigences architecturales et de sécurité :
Appartenant au client (CCI)
Vous pouvez configurer BigQuery pour interroger les données stockées dans les buckets AWS Amazon S3 via une interconnexion privée Cross-Cloud Interconnect à l'aide de Dedicated Cross-Cloud Interconnect ou de Partner Cross-Cloud Interconnect.
L'utilisation d'une interconnexion privée présente les avantages suivants :
- Sécurité renforcée : les données transitent via une connexion réseau privée entre Google Cloud et AWS, ce qui évite l'Internet public.
- Coûts réduits : frais de sortie potentiellement inférieurs depuis AWS par rapport à la sortie Internet, en particulier lorsqu'ils sont combinés à la capacité de votre interconnexion privée.
- Performances cohérentes : latence et bande passante du réseau plus prévisibles par rapport à l'Internet public.
Présentation de l'architecture
Pour activer les requêtes privées, configurez un chemin d'accès de BigQuery à votre bucket AWS Amazon S3 via votre interconnexion privée. Un composant clé du Google Cloud cloud privé virtuel (VPC) est un équilibreur de charge interne (ILB). L'ILB distribue les requêtes de BigQuery aux points de terminaison privés d'Amazon S3 dans votre VPC AWS, qui sont provisionnés à l'aide d'AWS PrivateLink.
L'utilisation d'un ILB avec plusieurs interfaces réseau Elastic (ENI) comme backends est essentielle pour l'équilibrage de charge, l'évolutivité et la haute disponibilité. Cela s'applique que vous utilisiez Dedicated CCI ou interconnexion partenaire.
Le workflow de requête privée suit le processus suivant :
- BigQuery utilise une connexion configurée avec un service Annuaire des services.
- Annuaire des services résout le nom de service en adresse IP interne de l' Google Cloud ILB.
- L'ILB reçoit les requêtes de BigQuery et les distribue aux backends configurés.
- Les backends ILB sont des groupes de points de terminaison du réseau de connectivité hybride (NEG), chacun pointant vers l'adresse IP privée d'une ENI dans votre VPC AWS.
- Le trafic transite de l'ILB, via les NEG, via l'interconnexion privée, vers les ENI AWS.
- Les ENI AWS, qui font partie d'un point de terminaison d'interface VPC Amazon S3 (AWS PrivateLink), fournissent un accès privé au service Amazon S3.
Internet public (sans CCI)
Si vous ne configurez pas d'interconnexion privée, les requêtes adressées à votre catalogue à distance transitent par défaut sur l'Internet public.
Lorsque vous interrogez des données sur l'Internet public, tenez compte des implications suivantes :
- Chiffrement standard : les requêtes d'accès aux données et les transferts de données sont chiffrés en transit à l'aide de protocoles TLS standards sur l'Internet public.
- Coûts de sortie : le transfert de données entraîne des frais de sortie Internet standards de votre fournisseur de cloud à distance (par exemple, AWS), qui sont généralement plus élevés que les tarifs de sortie d'interconnexion privée.
- Latence variable : les performances, la bande passante et la latence du réseau dépendent du routage et de la congestion de l'Internet public, ce qui entraîne des temps d'exécution des requêtes moins prévisibles par rapport à une interconnexion privée dédiée.
- Configuration simplifiée : ne nécessite aucune infrastructure réseau supplémentaire, aucun appairage VPC ni aucune configuration d'Annuaire des services dans Google Cloud ou votre fournisseur de services cloud à distance.
Présentation de l'architecture
Lorsque vous interrogez des données sur l'Internet public, Lakehouse se connecte directement à votre catalogue à distance et aux points de terminaison de stockage d'objets sans nécessiter d'infrastructure réseau cloud privée Google Cloud ou à distance.
Le workflow de requête Internet public suit le processus suivant :
- BigQuery lance une requête sur une table à distance définie dans votre catalogue Lakehouse.
- Lakehouse s'authentifie de manière sécurisée auprès de votre catalogue Apache Iceberg à distance à l'aide d'identifiants stockés dans Secret Manager ou la fédération de jetons OIDC.
- Lakehouse récupère les métadonnées de la table et les fichiers manifestes sur l'Internet public pour identifier les fichiers de données sous-jacents pertinents (par exemple, dans AWS Amazon S3).
- Les requêtes d'accès aux données pour les objets sous-jacents sont envoyées directement depuis Google Cloud sur l'Internet public à l'aide du chiffrement TLS standard.
- Le service de stockage à distance vérifie la requête à l'aide d'identifiants temporaires limités fournis par Lakehouse et renvoie les blocs de données demandés sur l'Internet public à Google Cloud.
Mise en cache intelligente
Lorsque vous interrogez des données cloud à distance, Lakehouse met automatiquement en cache les blocs de données récupérés localement dans Google Cloud. La mise en cache est activée automatiquement pour toutes les requêtes cross-cloud afin de réduire les frais de sortie des fournisseurs de services cloud à distance. Les requêtes suivantes ciblant les données mises en cache sont lues directement à partir du stockage local Google Cloud au lieu de récupérer à nouveau les données dans les clouds.
Économies sur les coûts de sortie
Lors de l'exécution initiale de la requête, Lakehouse récupère les blocs de données requis auprès du fournisseur de services cloud à distance et remplit le cache local. Les requêtes suivantes ciblant les mêmes blocs de données sont lues directement à partir du cache local Google Cloud au lieu de récupérer à nouveau les données dans les clouds.
Pour les charges de travail avec des schémas de requêtes répétés sur le même ensemble de données, la mise en cache réduit les frais de sortie cross-cloud en diffusant les requêtes de données à partir du stockage local. Les économies réelles sur les coûts de sortie dépendent de facteurs tels que les modèles d'accès aux requêtes, les taux de modification des données et la conservation du cache dans la région Google Cloud cible.
Vérifier l'utilisation du cache et les économies sur les coûts de sortie dans les statistiques de tâches
Pour vérifier les succès de cache et les économies sur les coûts de sortie d'une requête, inspectez les statistiques de la requête dans la console ou l'API BigQuery (JobStatistics2). Étant donné qu'une requête peut référencer des données provenant de plusieurs fournisseurs de services cloud, les statistiques de la tâche fournissent un champ object_storage_stats (objectStorageStats) répété avec une entrée pour chaque fournisseur de services cloud auquel vous avez accédé lors de l'exécution.
Chaque entrée object_storage_stats indique les métriques suivantes :
cloud_provider(cloudProvider) : fournisseur de services cloud hébergeant le stockage d'objets (par exemple,AWSouAZURE).cache_bytes_read(cacheBytesRead) : nombre total d'octets lus à partir du cache Google Cloud local, ce qui évite une lecture du stockage d'objets à distance.object_storage_bytes_read(objectStorageBytesRead) : nombre total d'octets lus directement à partir du stockage d'objets du fournisseur de services cloud à distance.
Considérations sur la résidence et la juridiction des données
La création d'un catalogue ou d'une connexion à distance dans une Google Cloud région stocke les données mises en cache au repos localement dans cette région cible.
Si vos données cloud à distance résident dans une région géographique ou
une juridiction différente (par exemple, AWS Amazon S3 dans l'Union
européenne associé au calcul BigQuery dans us-east4), les requêtes multicloud
stockent les copies mises en cache des données à distance au repos dans la région
Google Cloud cible. L'utilisateur ou l'administrateur qui crée la connexion ou le catalogue doit s'assurer que la mise en cache interjuridictionnelle est conforme aux exigences de résidence, de souveraineté et de conformité des données de son organisation.
Chiffrement et compatibilité avec les CMEK
Les clés de chiffrement gérées par le client (CMEK) ne sont pas compatibles avec la mise en cache de Lakehouse. Tous les blocs de données mis en cache sont chiffrés au repos à l'aide de par défaut Google-owned and Google-managed encryption keys.
Si votre organisation applique la contrainte de règle d'administration Restreindre les services non CMEK (constraints/gcp.restrictNonCmekServices), Lakehouse désactive automatiquement la mise en cache pour les requêtes qui accèdent aux tables restreintes. Les requêtes s'exécutent toujours correctement, mais elles ne mettent pas en cache les blocs de données ni ne bénéficient des économies de sortie liées au cache.
Étape suivante
- Configurez une connexion multicloud pour AWS Glue, Databricks Unity Catalog, Snowflake Horizon Catalog, Workday Data Lake, ou SAP Business Data Cloud.