


La fonctionnalité d'accès aux données cross-cloud vous permet d'interroger les données stockées chez d'autres fournisseurs de services cloud directement depuis Google Cloud sans migrer de fichiers ni créer de pipelines ETL complexes. Les requêtes peuvent être acheminées via l'Internet public ou utiliser interconnexion cross-cloud pour le transport sur un réseau privé.
Dans le cadre du lakehouse sans frontières, cette fonctionnalité unifie les charges de travail d'analyse et d'IA sur vos ensembles de données distribués via BigQuery, des environnements Apache Spark autonomes ou Managed Service pour Apache Spark.
En plus d'exécuter des requêtes analytiques, vous pouvez créer des agents d'analyse conversationnelle ancrés dans vos tables distribuées (y compris les sources cross-cloud) pour analyser les données de plusieurs clouds à partir d'une seule conversation. Vous pouvez également utiliser Knowledge Catalog pour le profilage des données et les insights sur les plates-formes distantes.
Cas d'utilisation
Lakehouse est compatible avec plusieurs cas d'utilisation clés pour accéder aux données de plusieurs fournisseurs de services cloud :
- La réduction des déplacements de données vous permet d'interroger directement les données stockées dans d'autres environnements cloud, ce qui simplifie l'accès aux données et leur traitement.
- L'analyse unifiée vous permet d'effectuer des analyses avancées avec des fonctionnalités cohérentes et une optimisation matérielle sur l'ensemble de vos données, où qu'elles se trouvent.
- L'IA et le ML sans frontières vous permettent d'appliquer des modèles d'IA, des agents autonomes et le machine learning directement à vos données distantes sans les migrer.
Architecture
Le diagramme suivant illustre l'architecture d'accès aux données cross-cloud de Lakehouse :
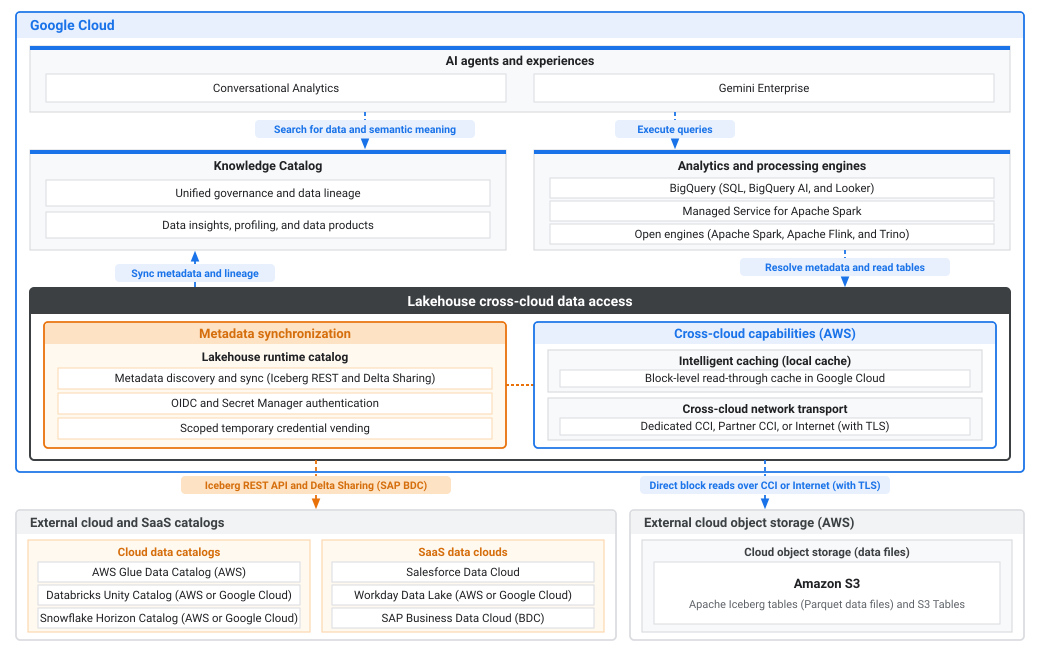
Le schéma précédent illustre l'architecture dans Google Cloud et les environnements cloud et SaaS externes :
- Google Cloud : fournit des fonctionnalités d'IA, de gouvernance, d'analyse et d'accès aux données cross-cloud sur des ensembles de données distants :
- Agents et expériences d'IA : crée des agents autonomes dans Conversational Analytics et Gemini Enterprise qui recherchent des données et une signification sémantique dans Knowledge Catalog et exécutent des requêtes via des moteurs d'analyse et de traitement.
- Knowledge Catalog : fournit une gouvernance unifiée et une traçabilité des données, ainsi que des insights sur les données, un profilage et des produits de données, en synchronisant les métadonnées et la traçabilité depuis Lakehouse.
- Moteurs d'analyse et de traitement : exécute les charges de travail BigQuery SQL, BigQuery AI et Looker, ou traite les données distantes avec Managed Service pour Apache Spark et les moteurs ouverts (Apache Spark, Apache Flink et Trino) en résolvant les métadonnées et en lisant les tables via Lakehouse.
- Accès aux données cross-cloud Lakehouse : interroge les données distantes sur place sans migration de fichiers ni pipelines ETL :
- Synchronisation des métadonnées : découvre et synchronise les métadonnées des tables sur Apache Iceberg REST et Delta Sharing à l'aide du catalogue d'environnements d'exécution Lakehouse, s'authentifie via OpenID Connect (OIDC) ou Secret Manager, et fournit des identifiants temporaires limités.
- Fonctionnalités cross-cloud (AWS) : met en cache les blocs de données lus dans Google Cloud à l'aide d'un cache de lecture au niveau du bloc (mise en cache intelligente (cache local)) et achemine le trafic via Dedicated interconnexion cross-cloud (CCI), interconnexion partenaire ou Internet (avec TLS) à l'aide du transport réseau cross-cloud.
- Sources de données cloud et SaaS externes : héberge les catalogues distants, les Data Clouds SaaS et le stockage d'objets :
- Catalogues cloud et SaaS externes : synchronise les métadonnées des catalogues de données cloud (AWS Glue Data Catalog sur AWS, et Databricks Unity Catalog et Snowflake Horizon Catalog sur AWS ou Google Cloud) et des clouds de données SaaS (Salesforce Data Cloud, Workday Data Lake sur AWS ouGoogle Cloud, et SAP Business Data Cloud (BDC)) via l'API REST Iceberg et Delta Sharing (pour SAP BDC).
- Stockage d'objets cloud externe (AWS) : stocke les tables Apache Iceberg (fichiers de données Parquet) et les tables Amazon S3 dans Amazon S3 pour les lectures de blocs directes via CCI ou Internet (avec TLS).
Fonctionnement de l'accès aux données cross-cloud
Lakehouse interroge les données distantes à l'aide du processus suivant :
- Découverte des métadonnées : Lakehouse de Google Cloudse connecte aux catalogues REST Apache Iceberg distants, tels que Databricks Unity ou AWS Glue. Lakehouse découvre les données sans copier de fichiers. Selon le fournisseur de catalogue distant, Lakehouse s'authentifie de manière sécurisée via Secret Manager ou la fédération de jetons OIDC avec Google comme fournisseur d'identité.
- Transport sécurisé : choisir d'acheminer le trafic via une interconnexion privée (par exemple, Dedicated CCI ou interconnexion partenaire) réduit considérablement les coûts de transfert de données par rapport à l'Internet public et rend la latence hautement prévisible.
- Exécution optimisée : lorsque les requêtes lisent des données à partir de clouds distants, Lakehouse met temporairement en cache ces segments de données localement dans Google Cloud sur un stockage spécialisé. Les requêtes suivantes utilisent le cache local, ce qui évite une grande partie des frais de sortie cross-cloud.
Catalogues compatibles
Lakehouse permet d'interroger des données provenant des fournisseurs de catalogues distants suivants :
- Databricks Unity Catalog : hébergé sur Amazon Web Services (AWS) ou Google Cloud.
- AWS Glue : hébergé sur AWS.
- Catalogue Snowflake Horizon : hébergé sur AWS ou Google Cloud.
- Workday Data Lake : hébergé sur AWS ou Google Cloud.
- SAP Business Data Cloud (BDC) : hébergé sur AWS, Microsoft Azure ou Google Cloud à l'aide du connecteur SAP BDC.
Concepts fondamentaux
Cette section décrit les composants clés essentiels à l'utilisation de la fonctionnalité d'accès aux données cross-cloud.
Couche de métadonnées
La couche de métadonnées se connecte aux points de terminaison du catalogue REST Apache Iceberg distant pour synchroniser les métadonnées des ressources Iceberg (espace de noms, table) en fonction d'un intervalle d'actualisation. Lakehouse s'authentifie de manière sécurisée avec des identifiants OAuth stockés dans Secret Manager ou la fédération de jetons OIDC.
Couche transport
La couche transport permet à BigQuery et aux moteurs Open Source d'interroger les données à l'aide des métadonnées synchronisées de la couche de métadonnées. Pour certains types de catalogues distants, Lakehouse permet d'interroger des données via l'Internet public ou une interconnexion privée dédiée.
Sélectionnez la méthode de transport qui correspond à vos exigences architecturales et de sécurité :
Appartenant au client (CCI)
Vous pouvez configurer BigQuery pour interroger les données stockées dans des buckets AWS Amazon S3 via interconnexion cross-cloud privée à l'aide de Cross-Cloud Interconnect dédié ou de Cross-Cloud Interconnect partenaire.
L'utilisation d'une interconnexion privée présente les avantages suivants :
- Sécurité renforcée : les données transitent via une connexion réseau privée entre Google Cloud et AWS, sans passer par l'Internet public.
- Réduction des coûts : réduction potentielle des frais de sortie d'AWS par rapport à la sortie Internet, en particulier lorsqu'ils sont combinés à votre capacité d'interconnexion privée.
- Performances constantes : latence et bande passante réseau plus prévisibles par rapport à l'Internet public.
Présentation de l'architecture
Pour activer les requêtes privées, vous devez configurer un chemin d'accès de BigQuery vers votre bucket AWS Amazon S3 via votre interconnexion privée. Un composant clé du cloud privé virtuel (VPC) Google Cloudest un équilibreur de charge interne (ILB). L'ILB distribue les requêtes de BigQuery aux points de terminaison privés pour Amazon S3 au sein de votre VPC AWS, qui sont provisionnés à l'aide d'AWS PrivateLink.
L'utilisation d'un équilibreur de charge interne avec plusieurs interfaces réseau Elastic (ENI) en tant que backends est essentielle pour l'équilibrage de charge, l'évolutivité et la haute disponibilité. Cela s'applique que vous utilisiez Dedicated CCI ou interconnexion partenaire.
Le workflow de requête privée suit ce processus :
- BigQuery utilise une connexion configurée avec un service de l'Annuaire des services.
- L'Annuaire des services résout le nom du service en adresse IP interne de l'ILB Google Cloud .
- L'ILB reçoit les requêtes de BigQuery et les distribue aux backends configurés.
- Les backends de l'ILB sont des groupes de points de terminaison du réseau (NEG) de connectivité hybride, chacun pointant vers l'adresse IP privée d'une ENI dans votre VPC AWS.
- Le trafic circule de l'ILB vers les ENI AWS, en passant par les NEG et l'interconnexion privée.
- Les ENI AWS, qui font partie d'un point de terminaison d'interface VPC Amazon S3 (AWS PrivateLink), fournissent un accès privé au service Amazon S3.
Internet public (pas de CCI)
Si vous ne configurez pas d'interconnexion privée, les requêtes adressées à votre catalogue distant transitent par défaut par l'Internet public.
Lorsque vous interrogez des données sur l'Internet public, tenez compte des implications suivantes :
- Chiffrement standard : les demandes d'accès aux données et les transferts de données sont chiffrés en transit à l'aide des protocoles TLS standards sur l'Internet public.
- Coûts de sortie : le transfert de données entraîne des frais de sortie Internet standards de la part de votre fournisseur cloud distant (par exemple, AWS), qui sont généralement plus élevés que les tarifs de sortie d'interconnexion privée.
- Latence variable : les performances, la bande passante et la latence du réseau dépendent du routage et de la congestion de l'Internet public, ce qui se traduit par des temps d'exécution des requêtes moins prévisibles par rapport à une interconnexion privée dédiée.
- Configuration simplifiée : ne nécessite aucune infrastructure réseau supplémentaire, d'appairage de VPC ou de configuration de l'Annuaire des services dans Google Cloud ou votre fournisseur de services cloud distant.
Présentation de l'architecture
Lors de l'interrogation de données sur l'Internet public, Lakehouse se connecte directement à vos points de terminaison de catalogue et de stockage d'objets distants, sans nécessiter d'infrastructure réseau cloud privée Google Cloud ou distante.
Le workflow de requête Internet public suit ce processus :
- BigQuery lance une requête sur une table distante définie dans votre catalogue Lakehouse.
- Lakehouse s'authentifie de manière sécurisée auprès de votre catalogue Apache Iceberg distant à l'aide d'identifiants stockés dans Secret Manager ou de la fédération de jetons OIDC.
- Lakehouse récupère les métadonnées de la table et les fichiers manifestes sur l'Internet public pour identifier les fichiers de données sous-jacents pertinents (par exemple, dans AWS Amazon S3).
- Les requêtes d'accès aux données pour les objets sous-jacents sont envoyées directement depuisGoogle Cloud sur l'Internet public à l'aide du chiffrement TLS standard.
- Le service de stockage distant valide la requête à l'aide d'identifiants temporaires et limités fournis par Lakehouse, puis renvoie les blocs de données demandés à Google Cloudvia l'Internet public.
Mise en cache intelligente
Lorsque vous interrogez des données cloud distantes, Lakehouse met automatiquement en cache les blocs de données récupérés localement dans Google Cloud. La mise en cache est activée automatiquement pour toutes les requêtes cross-cloud afin de réduire les frais de sortie des fournisseurs de services cloud distants. Les requêtes ultérieures ciblant les données mises en cache sont lues directement à partir de l'espace de stockage Google Cloud local au lieu de récupérer à nouveau les données dans les clouds.
Économies sur les coûts de sortie
Lors de l'exécution initiale de la requête, Lakehouse récupère les blocs de données requis auprès du fournisseur de services cloud distant et remplit le cache local. Les requêtes ultérieures ciblant les mêmes blocs de données sont lues directement à partir du cacheGoogle Cloud local au lieu de récupérer à nouveau les données dans les clouds.
Pour les charges de travail avec des schémas de requête répétés sur le même ensemble de données, la mise en cache réduit les frais de sortie cross-cloud en diffusant les requêtes de données à partir du stockage local. Les économies réelles sur les coûts de sortie dépendent de facteurs tels que les modèles d'accès aux requêtes, les taux de modification des données et la conservation du cache dans la région Google Cloudcible.
Vérifier l'utilisation du cache et les économies sur les coûts de sortie dans les statistiques de job
Pour vérifier les taux de succès de cache (hit) et les économies sur les coûts de sortie pour une requête, inspectez les statistiques de la requête dans la console ou l'API BigQuery (JobStatistics2). Comme une requête peut référencer des données de plusieurs fournisseurs, les statistiques du job fournissent un champ object_storage_stats (objectStorageStats) répété avec une entrée pour chaque fournisseur de services cloud auquel vous avez accédé pendant l'exécution.
Chaque entrée object_storage_stats indique les métriques suivantes :
cloud_provider(cloudProvider) : fournisseur de services cloud hébergeant le store d'objets (par exemple,AWSouAZURE).cache_bytes_read(cacheBytesRead) : nombre total d'octets lus à partir du cache Google Cloud local, ce qui évite une lecture de l'espace de stockage d'objets distant.object_storage_bytes_read(objectStorageBytesRead) : nombre total d'octets lus directement à partir du store d'objets du fournisseur de services cloud distant.
Points à prendre en compte concernant la résidence des données et la juridiction
La création d'un catalogue ou d'une connexion distants dans une région Google Cloud stocke les données mises en cache au repos localement dans cette région cible.
Si vos données cloud distantes résident dans une région géographique ou une juridiction différente (par exemple, AWS Amazon S3 dans l'Union européenne associé au calcul BigQuery dans us-east4), les requêtes cross-cloud stockent des copies mises en cache des données au repos dans la régionGoogle Cloud cible. L'utilisateur ou l'administrateur qui crée la connexion ou le catalogue doit s'assurer que la mise en cache interjuridictionnelle est conforme aux exigences de son organisation en matière de résidence des données, de souveraineté et de conformité.
Chiffrement et compatibilité avec les CMEK
Les clés de chiffrement gérées par le client (CMEK) ne sont pas compatibles avec la mise en cache Lakehouse. Tous les blocs de données mis en cache sont chiffrés au repos à l'aide de la cléGoogle-owned and Google-managed encryption keyspar défaut.
Si votre organisation applique la contrainte de règle d'administration Limiter les services non-CMEK (constraints/gcp.restrictNonCmekServices), Lakehouse désactive automatiquement la mise en cache pour les requêtes qui accèdent aux tables restreintes. Les requêtes s'exécutent toujours correctement, mais elles ne mettent pas en cache les blocs de données et ne bénéficient pas des économies de sortie liées au cache.
Étapes suivantes
- Configurez une connexion cross-cloud pour AWS Glue, Databricks Unity Catalog, Snowflake Horizon Catalog, Workday Data Lake ou SAP Business Data Cloud.