

Übersicht
Diese Solution Reference Architecture (SRA) (Referenzarchitektur für Lösungen) definiert das konzeptionelle Design, die Komponententopologie und die technischen Grenzen für das Hosten, Bereitstellen und Validieren von Large Language Models (LLMs) mit offenem Gewicht in eigenständigen Clustern, die nur auf Distributed Cloud-Software basieren.
In Enterprise-Edge-Umgebungen sind oft Inferenz mit niedriger Latenz und strenge Datenhoheit erforderlich. Diese Referenzarchitektur für Lösungen bietet einen standardisierten, sicheren und beobachtbaren Bereitstellungs-Stack zum Bereitstellen des Modells Gemma 4 31B in einem einzelnen Knoten des Distributed Cloud-Clusters (nur Software), der mit einer vom Kunden bereitgestellten NVIDIA RTX PRO 6000-GPU (96 GB VRAM) ausgestattet ist.
Funktionen
- Lokales Bereitstellen von Modellen:Stellt eine branchenübliche, OpenAI-kompatible API lokal innerhalb der Clustergrenze der Distributed Cloud-Software bereit.
- Unterstützung für Large Edge Models:Optimiert für die Ausführung von Gemma 4 31B in nativer Precision (BF16) oder quantisierten Formaten, wobei die VRAM-Kapazität von 96 GB voll ausgeschöpft wird.
- Beobachtbarkeit:Die Überwachungsinfrastruktur (Google Cloud Managed Service for Prometheus) wird nur in die Distributed Cloud-Software integriert. Dabei werden native
PodMonitoring-Ressourcen verwendet, um GPU-Telemetrie- und vLLM-Leistungsmesswerte zu exportieren. Ein separater lokaler Prometheus-Server ist nicht erforderlich. - Interaktive Validierung:Stellt eine Gradio-basierte Weboberfläche für die sofortige, visuelle Überprüfung der Reaktionsfähigkeit des Modells bereit.
Architekturprinzipien
- Einfachheit und Portabilität:Es werden Kubernetes-native Konstrukte (Bereitstellung, Dienst) anstelle komplexer Serving-Operatoren verwendet, was die Bereitstellung und Wartung auf Einzelknoten-Setups vereinfacht.
- Datenhoheit:Der gesamte Inferenz-Traffic sowie Prompt- und Antwortdaten bleiben streng innerhalb der lokalen Clustergrenze.
- Ressourcenisolation:Der physische GPU-Beschleuniger wird einer einzelnen Instanz für die Modellbereitstellung zugewiesen, um Ressourcenkonflikte zu vermeiden und eine vorhersehbare Latenz zu gewährleisten.
Architektur und Design
Komponenten
Die Lösungskomponenten bestehen aus:
- Kundennamespace (nur Software-Cluster von Distributed Cloud):
- vLLM Serving Engine:Wird als Kubernetes-Deployment bereitgestellt, in dem der vLLM-Container ausgeführt wird. Konfiguriert, um Gemma-Gewichtungen aus dem nichtflüchtigen Speicher zu laden und eine OpenAI-kompatible API bereitzustellen.
- Gradio-Web-UI:Wird als Kubernetes-Bereitstellung bereitgestellt und bietet die Chatoberfläche für die Überprüfung. Optional: Kann auch extern auf einer Entwickler-Workstation oder in einer Testlaufzeit ausgeführt werden, die mit dem vLLM-Dienst des Clusters verbunden ist.
- PersistentVolumeClaim (PVC): Wird nur von lokaler freigegebener Speicherung (mit der StorageClass
local-shared) unterstützt, die von Distributed Cloud-Software zum Hosten der Modellgewichte verwendet wird. - Kubernetes-Dienste:ClusterIP-Dienst für den vLLM-API-Endpunkt; NodePort- oder LoadBalancer-Dienst für die Gradio-UI, um sie für das Kundennetzwerk verfügbar zu machen.
- Infrastruktur (vom Kunden verwaltet):
- NVIDIA GPU-Operator:Orchestriert und stellt die physischen GPU-Ressourcen nur für Kubernetes-Worker-Knoten der Distributed Cloud-Software bereit.
- NVIDIA RTX PRO 6000-GPU:Der zugrunde liegende physische Beschleuniger (96 GB GDDR7-Speicherarchitektur).
- Google Cloud-Integration:
- Google Cloud Monitoring & Logging:Standardmäßige Agents für die reine Distributed Cloud-Software, die Systemlogs, Containerlogs und grundlegende Messwerte erfassen und anGoogle Cloudweiterleiten.
Übersicht über die Gesamtarchitektur
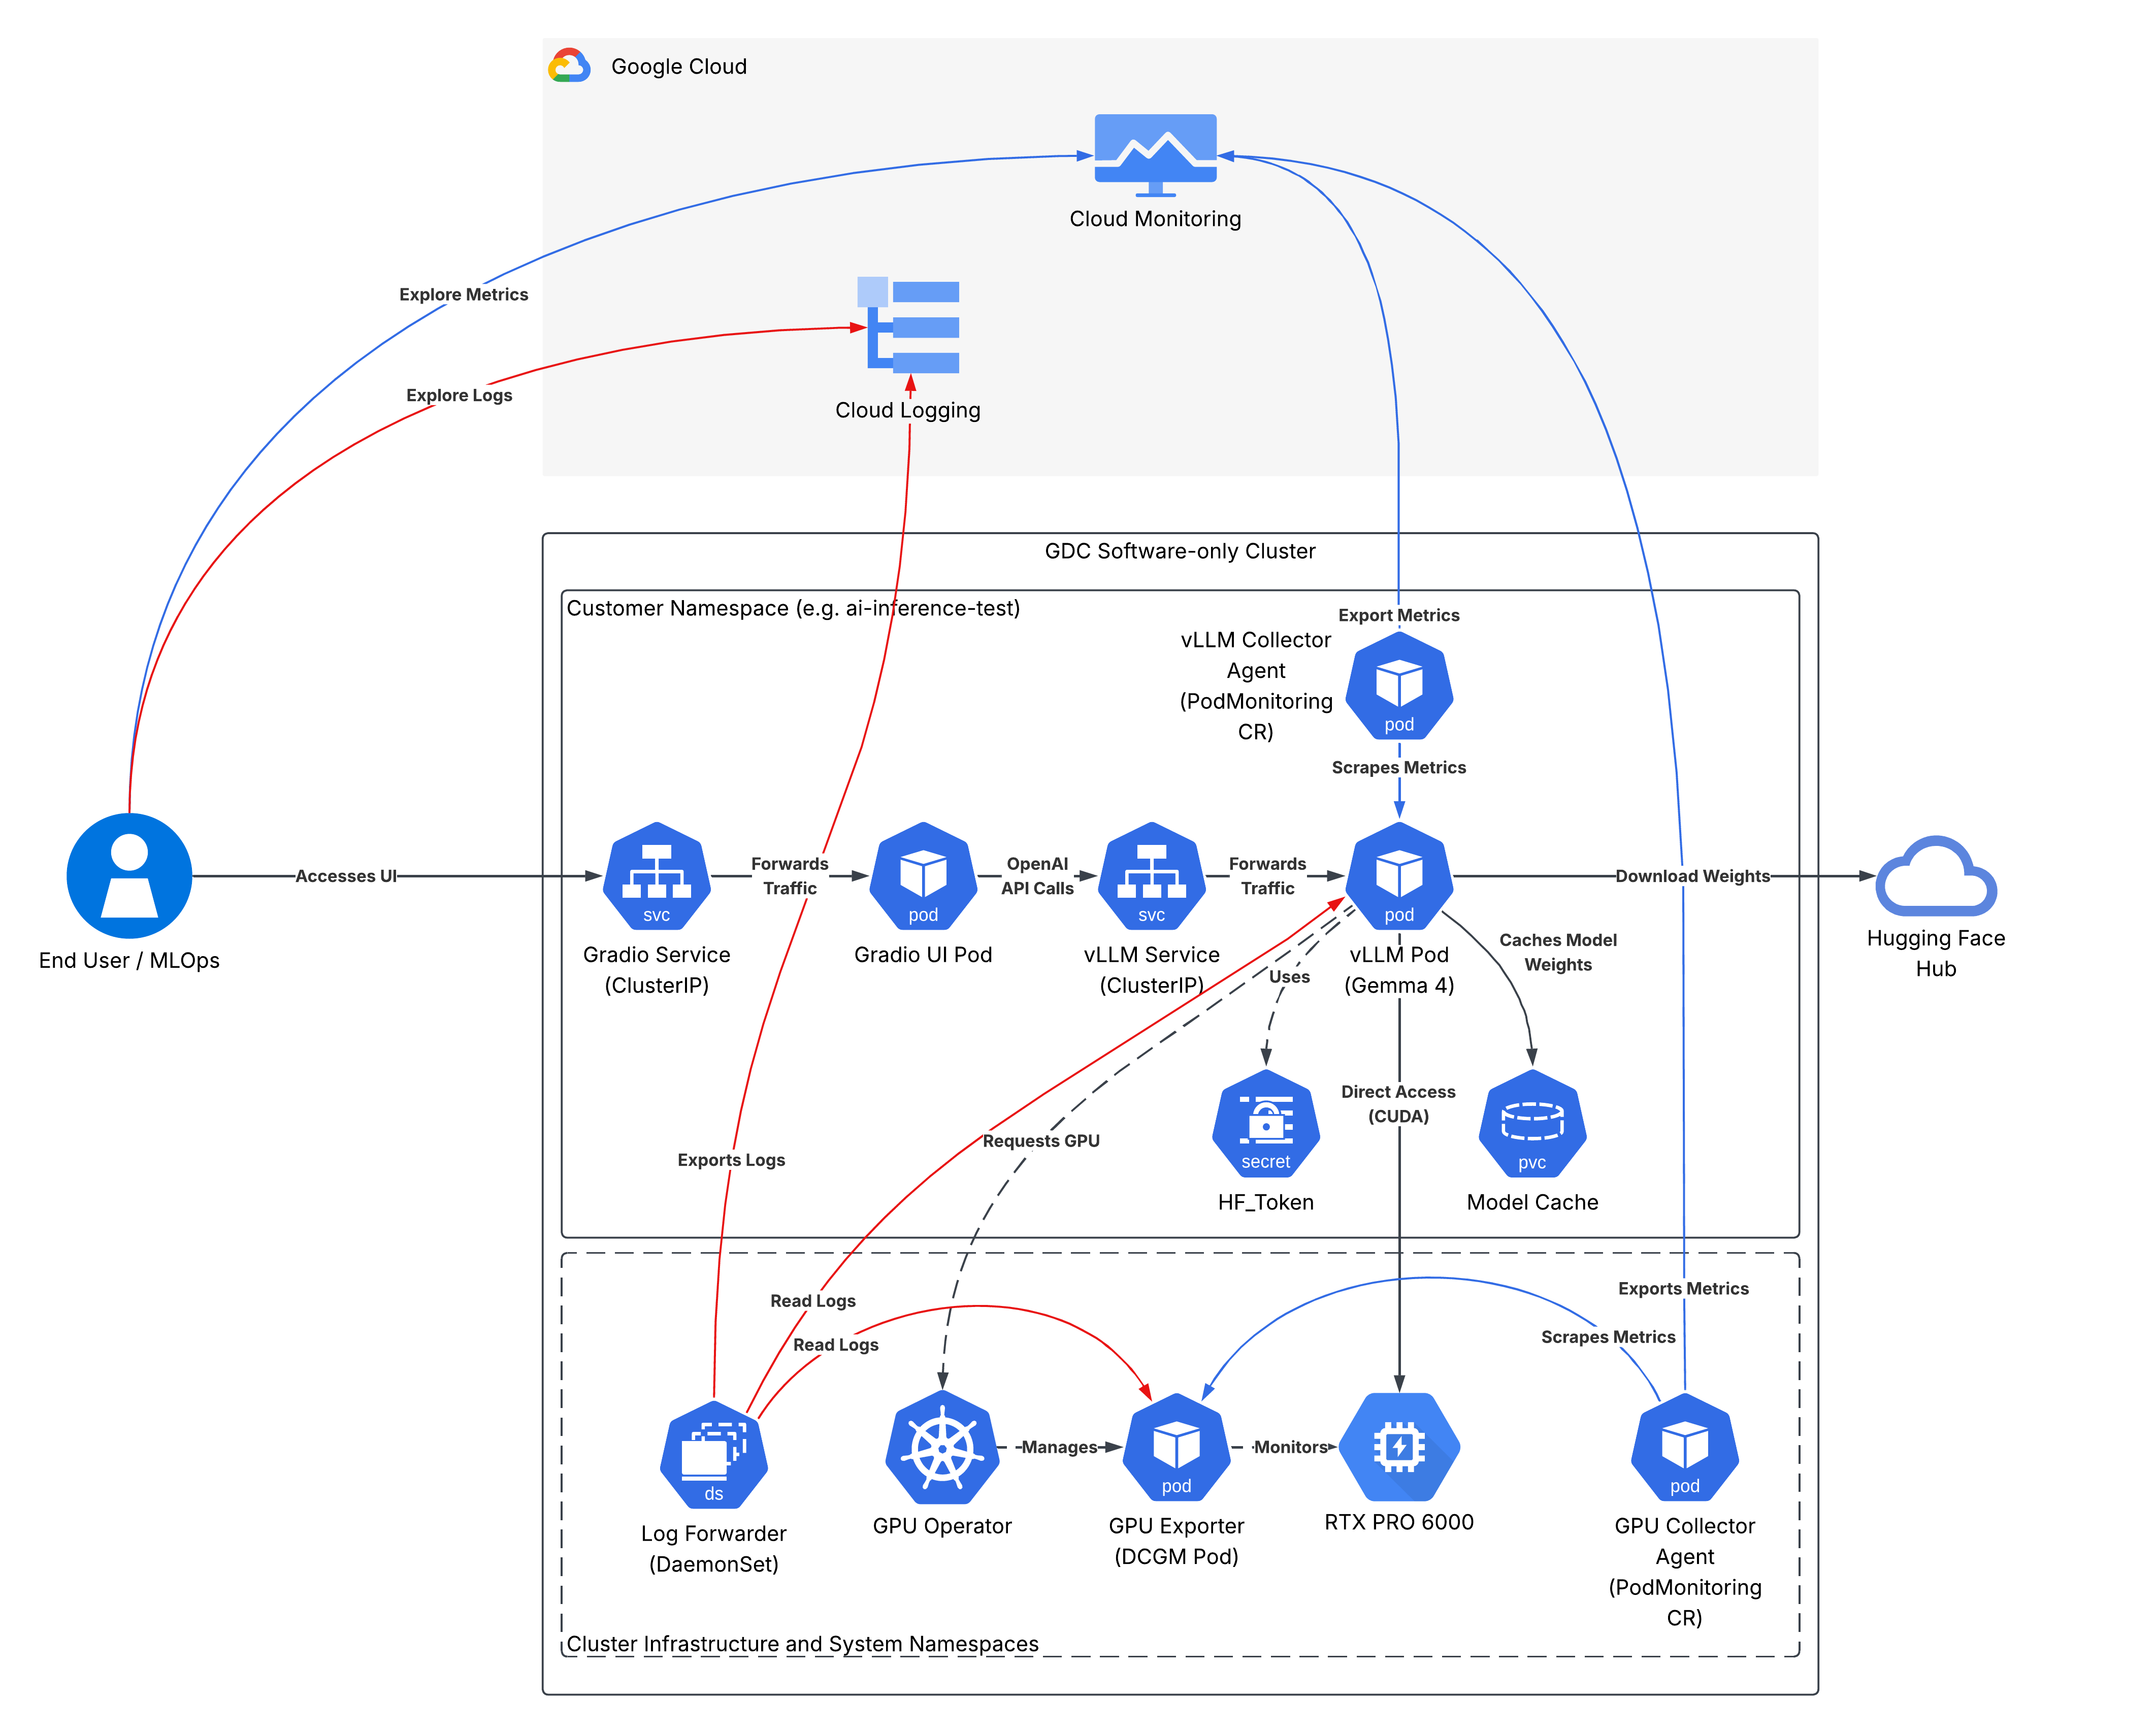
Das folgende Diagramm veranschaulicht den Fluss von Anfragen und die Interaktionen zwischen Komponenten im Distributed Cloud-Cluster, der nur Software umfasst:
Hardwarebeschränkungen
Die Lösung ist für Hardware von Kunden konzipiert, die mit der NVIDIA RTX PRO 6000 Blackwell-GPU ausgestattet ist.
- GPU-Spezifikation:NVIDIA RTX PRO 6000 (Blackwell Server- oder Workstation-Edition).
- Arbeitsspeicherarchitektur:96 GB GDDR7-VRAM (mit ECC)
- Auswirkungen der Modellauswahl:
- Mit 96 GB VRAM kann das Zielmodell „Gemma 4 31B“ in nativer BF16-Präzision ausgeführt werden. Es belegt etwa 62 GB an Gewichten und lässt etwa 34 GB VRAM-Spielraum für den Key-Value-Cache (KV-Cache).
- Wenn die hardwarebeschleunigte FP8-Quantisierung (
--quantization=fp8) von Blackwell aktiviert ist – wie in der Referenzimplementierung konfiguriert –, wird der Arbeitsspeicher für Modellgewichte auf etwa 31 GB halbiert. Dadurch wird der verfügbare KV-Cache auf etwa 56,5 GiB (61,728Tokens) bei--gpu-memory-utilization=0.95erweitert. So sind große Kontextfenster oder hohe gleichzeitige Batchgrößen möglich, ohne dass OOM-Fehler (Out-of-Memory) auftreten.
Supportfähigkeitsmatrix (Verantwortlichkeiten)
| Komponente | Verwaltet von | Hinweise |
|---|---|---|
| Physische Hardware und Betriebssystem | Kunde | Vom Kunden bereitgestellte Hardware (insbesondere Server oder Workstation mit NVIDIA RTX PRO 6000 Blackwell-GPU). |
| Installation von Distributed Cloud-Clustern (nur Software) | Kunde | Es muss die Standarddokumentation für die reine Softwareinstallation von Distributed Cloud befolgt werden. |
| GPU-Treiber und Operator | Kunde | Installation des NVIDIA GPU-Operators und der Helm-Charts. Google unterstützt die Bereitstellung von NVIDIA-Operatoren nicht. |
| vLLM-Bereitstellungsmanifeste | Google (Lösung) | Wird in diesem Lösungsleitfaden bereitgestellt. |
| Modellartefakte | Kunde | Die Gemma-Modellgewichte werden heruntergeladen und gehostet. |
| Gradio-Benutzeroberfläche und App-Code | Kunde | Anwendungsschicht im Besitz des Kunden für Validierung und Nutzung. |
| Cloud Logging und Cloud Monitoring | Gelenk | Google bietet eine Standardintegration. Der Kunde konfiguriert. |
Konzepte und Technologien
In diesem Abschnitt werden die funktionalen Komponenten, ihre Verantwortlichkeiten und die Art ihrer Kommunikation innerhalb des Systems beschrieben. Darin werden die wichtigsten Dienste, Datenspeichereinheiten und Netzwerkschnittstellen identifiziert, die zur Unterstützung des Zielanwendungsfalls erforderlich sind.
Infrastruktur und Plattform
- NVIDIA RTX PRO 6000-GPU:Bietet 96 GB GDDR7-VRAM. Die physische GPU ist ausschließlich der Instanz für die Modellbereitstellung zugewiesen. Die GPU-Partitionierung (MIG) ist nicht aktiviert, damit das Modell exklusiven Zugriff auf den gesamten VRAM und die gesamte Speicherbandbreite hat und Ressourcenkonflikte vermieden werden.
- NVIDIA GPU-Operator:Ein vom Kunden verwalteter Operator, der die physischen GPU-Ressourcen nur für Kubernetes-Worker-Knoten der Distributed Cloud-Software orchestriert und verfügbar macht.
- Knotenlokaler Speicher (PersistentVolumeClaim): Nur knotenlokaler Speicher, der von der Distributed Cloud-Software unterstützt wird, um die Modellgewichte auf dem Knoten zu hosten und beizubehalten. So wird sichergestellt, dass Modellgewichte nach dem Herunterladen lokal gespeichert werden. Bei nachfolgenden Neustarts oder Aktualisierungen von Pods werden Gewichte aus diesem lokalen Cache geladen, wodurch die Startzeit verkürzt und vor WAN-Ausfällen geschützt wird.
- Segment für gemeinsam genutzten Arbeitsspeicher (
/dev/shm): EinemptyDir-Volume mitmedium: Memorywird unter/dev/shmbereitgestellt und mit 16 GiB zugewiesen, um Segmentierungsfehler bei Tensor-Operationen mit hoher Parallelität in vLLM zu vermeiden.
Dienste und Logik
- vLLM Serving Engine:Wird als Kubernetes-Bereitstellung bereitgestellt, in der der für Vertex AI qualifizierte vLLM-Container ausgeführt wird. Der Zugriff erfolgt über einen
ClusterIP-Dienst (Port 8000). Zu den wichtigsten Konfigurationsparametern gehören:--model: Pfad oder ID des Gemma-Modells (z.B.google/gemma-4-31B-it).--tensor-parallel-size: Auf1(Einschränkung auf eine einzelne GPU) festgelegt.--dtype: Legen Siebfloat16fest, um die hardwareeigene Präzision für nicht quantisierte Ebenen und Aktivierungen zu nutzen.--quantization: In der Referenzimplementierung auffp8gesetzt, um die Blackwell-FP8-Gewichtsquantisierung (~31 GB Gewichte, ~56,5 GiB KV-Cache) zu nutzen, oder ausgelassen, wenn unquantisiertes BF16 (~62 GB Gewichte, ~34 GB KV-Cache) bevorzugt wird.
- Gradio-Web-UI:Wird als Kubernetes-Deployment bereitgestellt und bietet eine Chatoberfläche für die Validierung, die über einen
ClusterIP-Dienst (Port 8080) bereitgestellt wird. Es stellt eine Verbindung zum vLLM-Dienst für die Interaktion mit Prompts und Antworten her.
Beobachtbarkeit und Google Cloud Integration
- Cloud Logging:Hier werden nur die standardmäßigen Logging-Agents der Distributed Cloud-Software verwendet, um Containerlogs (vLLM-Anwendungslogs und GPU-Diagnosedaten) automatisch zu erfassen und an Cloud Logging weiterzuleiten.
- Cloud Monitoring (PodMonitoring): GMP-Ressourcen (Google Cloud Managed Service for Prometheus) sind sowohl auf den vLLM-Pod (für Serving-Telemetrie wie Token-Durchsatz und KV-Cache-Nutzung) als auch auf den GPU-Exporter-Pod (für GPU-Telemetrie) ausgerichtet und exportieren Messwerte in Cloud Monitoring.
Hinweise
Skalierbarkeit und Leistung
- GPU-Zuweisung:Die NVIDIA RTX PRO 6000-GPU ist ausschließlich dem vLLM-Container zugewiesen. Die GPU-Freigabe über MIG oder Time-Slicing ist in dieser Architektur nicht implementiert, um eine vorhersehbare Inferenzlatenz zu gewährleisten und OOM-Fehler zu vermeiden. Das Gemma 4 31B-Modell benötigt außerdem den größten Teil des VRAM-Speichers für die Modellgewichte (~62 GB), sodass nicht viel Speicher für andere Modelle bleibt, die gleichzeitig ausgeführt werden können.
- Bereitstellungsstrategie:Wird als
Recreateerzwungen. Da wir nur eine GPU haben, können wir während eines Updates nicht zwei Instanzen des vLLM-Pods gleichzeitig ausführen. Der alte Pod muss beendet werden, um die GPU-Sperre aufzuheben, bevor der neue Pod gestartet werden kann.
Ressourcenverwaltung
- VRAM-Puffer: Die 96 GB NVIDIA RTX PRO 6000-GPU bietet ausreichend VRAM für das Gemma 4-Modell mit 31 Milliarden Parametern in unquantisierter BF16-Präzision (~62 GB für Gewichte, sodass ~34 GB für den KV-Cache verbleiben). Bei der Referenzbereitstellung wird jedoch die Blackwell-FP8-Quantisierung (
--quantization=fp8) verwendet, um den Arbeitsspeicher für Gewichte auf ~31 GB zu reduzieren und den verfügbaren KV-Cache auf ~56,5 GiB (61,728gleichzeitige Tokens) zu erweitern. - KV-Cache-Größe:Bei der SRA wird die Standardzuweisung für vLLM (
--gpu-memory-utilization=0.95) angenommen, wodurch die VRAM-Nutzung für die Engine maximiert wird.
Verfügbarkeit und Zuverlässigkeit
- Cache-Warmth:Die Verwendung von knotenlokalen PVs ist entscheidend. Wenn der Knoten neu gestartet wird, werden die im Hostverzeichnis zwischengespeicherten Gewichte wiederverwendet.
- Image-Caching:Da das vLLM-Container-Image groß ist (> 10 GB), wird empfohlen,
imagePullPolicy: IfNotPresentfestzulegen, um Verzögerungen beim Registry-Pull beim Neustart des Pods zu vermeiden.
Operative Komplexität
- Konsolensichtbarkeit:Im Gegensatz zu GKE wird die konsolenbasierte Ansicht „AI/ML Models“ (KI-/ML-Modelle) in Distributed Cloud-Software nicht unterstützt. Alle Validierungs- und Monitoring-Vorgänge müssen über die
kubectlCLI, Portweiterleitung und direkte Cloud Monitoring-Dashboards erfolgen.
Designentscheidung
Inferenz-Engine: vLLM im Vergleich zu Triton und Ollama
- Ausgewählte Option:vLLM
- Begründung:vLLM bietet die beste Out-of-the-Box-Leistung für LLMs über PagedAttention, unterstützt die OpenAI API-Parität und verfügt über vorab qualifizierte Container-Images von Vertex AI.
- Abgelehnte Alternativen:
- Triton:Zu komplex, um für die Edge-Bereitstellung eines einzelnen Modells konfiguriert und kompiliert zu werden.
- Ollama:Es fehlen die erweiterten Telemetrie-Endpunkte und die detaillierte Abstimmung der Parallelität, die für das Produktionsmonitoring erforderlich sind.
Telemetriepfad: natives GMP im Vergleich zu lokalem Prometheus
Ausgewählte Option:Native GMP (PodMonitoring)
- Begründung:Die Distributed Cloud-Software unterstützt nur die native Integration mit Cloud Monitoring. Wir können Messwerte mit Managed Prometheus direkt anGoogle Cloud weiterleiten und so den betrieblichen Overhead im Cluster reduzieren.
- Abgelehnte Alternativen:
- Lokaler Prometheus- und Grafana-Stack:Abgelehnt, um die Ressourcennutzung der Steuerungsebene im Einzelknotencluster zu minimieren.
Annahmen und Einschränkungen
Annahmen
- Verfügbarkeit des GPU-Operators:Es wird davon ausgegangen, dass der Kunde den NVIDIA GPU-Operator erfolgreich installiert und die
nvidia-RuntimeClass konfiguriert hat, bevor er diese Lösung bereitstellt. - Hugging Face-Zugriff:Für das Deployment ist ein gültiges Hugging Face-Token mit Zugriff auf das Repository für Gemma 4 mit eingeschränktem Zugriff erforderlich, das als Kubernetes-Secret gespeichert ist.
- Netzwerkpfad:Der Cluster muss Internetzugriff (oder einen internen Proxy) haben, um das Container-Image und die Modellgewichte bei der Ersteinrichtung herunterzuladen.
Beschränkungen
- Grenze für einzelne GPU:Die Architektur der Phase 1 ist durch die physische Kapazität einer einzelnen NVIDIA RTX PRO 6000-GPU begrenzt. Modelle mit mehr als 31 Mrd. Parametern oder Arbeitslasten mit hoher Parallelität, die Tensorparallelität mit mehreren GPUs erfordern, werden in Phase 1 nicht unterstützt.
- Keine Rolling Updates:Die
Recreate-Strategie führt zu einer vorübergehenden Dienstunterbrechung bei Modellaktualisierungen oder Konfigurationsänderungen, da die GPU nicht zwischen den alten und neuen Pods geteilt werden kann. - Leistungsoptimierung ausgeschlossen:Entsprechend dem Projektumfang sind Optimierungen auf Knotenebene (CPU-Pinning, Huge Pages,
PerformanceTuningProfile) in dieser Architektur ausgeschlossen.