


בדף הזה מוסבר איך להתחיל לתכנן ולעצב תהליכי צינור עיבוד נתונים של CI/CD GitOps ל-Kubernetes. GitOps, יחד עם כלים כמו סנכרון תצורות, מציע יתרונות כמו יציבות קוד משופרת, קריאוּת טובה יותר ואוטומציה.
GitOps היא גישה שצוברת פופולריות במהירות לניהול של הגדרות Kubernetes בקנה מידה נרחב. בהתאם לדרישות של צינור עיבוד הנתונים של CI/CD, יש הרבה אפשרויות לארכיטקטורה ולארגון של קוד האפליקציה וההגדרות. השיטות המומלצות הבאות ל-GitOps יעזרו לכם ליצור ארכיטקטורה יציבה, מאורגנת ומאובטחת.
הדף הזה מיועד לאדמינים, לארכיטקטים ולמפעילים שרוצים להטמיע את GitOps בסביבה שלהם. במאמר תפקידים ומשימות נפוצים של משתמשי GKE מפורטים תפקידים ומשימות לדוגמה שמוזכרים בתוכן של Google Cloud .
ארגון המאגרים
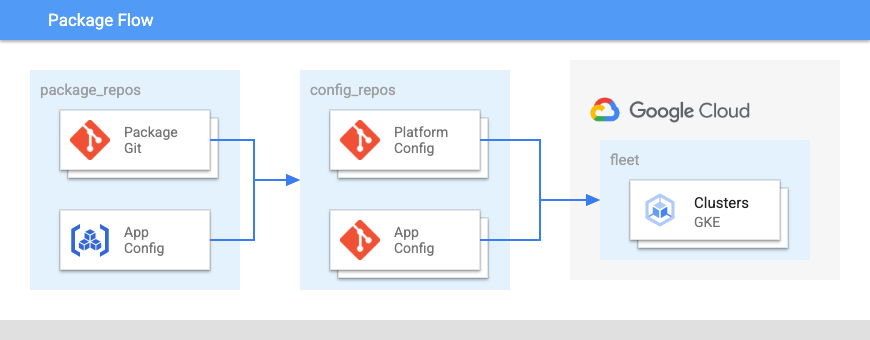
כשמגדירים את ארכיטקטורת GitOps, צריך להפריד את המאגרים לפי סוגי קובצי התצורה שמאוחסנים בכל מאגר. באופן כללי, כדאי לשקול לפחות ארבעה סוגים של מאגרים:
- מאגר חבילות לקבוצות של הגדרות קשורות.
- מאגר פלטפורמה להגדרת אשכולות ומרחבי שמות בכל ה-fleet.
- מאגר של הגדרות אישיות של אפליקציה.
- מאגר המקורות של קוד האפליקציה.
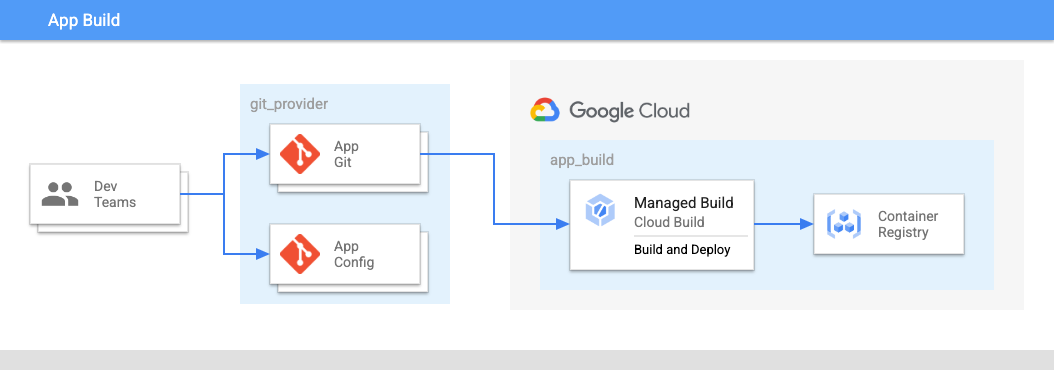
באיור 2:
- צוותי הפיתוח מעבירים קוד של אפליקציות והגדרות של אפליקציות למאגר.
- הקוד של האפליקציות וההגדרות מאוחסן באותו מקום, ולצוותי האפליקציות יש שליטה על המאגרים האלה.
- צוותי האפליקציות מעבירים קוד ל-build.
שימוש ב-Package Repository פרטי ומרוכז
כדי לעזור לצוותים למצוא חבילות, כדאי להשתמש במאגר מרכזי לחבילות ציבוריות או פנימיות,כמו תרשימי Helm. לדוגמה, אם המאגר בנוי בצורה לוגית או מכיל readme, שימוש במאגרי חבילות פרטיים ומרכזיים יכול לעזור לצוותים למצוא מידע במהירות. כדי לארגן את המאגר המרכזי, אתם יכולים להשתמש בשירותים כמו Artifact Registry או מאגרי Git.
לדוגמה, צוות הפלטפורמה של הארגון יכול להטמיע כללי מדיניות שבהם צוותי האפליקציות יכולים להשתמש רק בחבילות מהמאגר המרכזי.
אתם יכולים להגביל את הרשאות הכתיבה למאגר למספר קטן של מהנדסים. לשאר הארגון יכולה להיות גישת קריאה. מומלץ להטמיע תהליך לקידום חבילות למאגר המרכזי ולשידור עדכונים.
למרות שניהול של מאגר מרכזי יכול להוסיף קצת עומס, כי מישהו צריך לתחזק את המאגר המרכזי וזה מוסיף עוד תהליך לצוותי האפליקציות, יש הרבה יתרונות לגישה הזו:
- צוות מרכזי יכול לבחור להוסיף חבילות ציבוריות בקצב מוגדר, כדי למנוע שיבושים בגלל בעיות בקישוריות או שינויים במאגרים קודמים.
- שילוב של בודקים אוטומטיים ואנושיים יכול לבדוק אם יש בעיות בחבילות לפני שהן הופכות לזמינות באופן נרחב.
- המאגר המרכזי מאפשר לצוותים לגלות מה נמצא בשימוש ומה נתמך. לדוגמה, צוותים יכולים למצוא את פריסת Redis הרגילה שמאוחסנת במאגר המרכזי.
- אתם יכולים להפוך את השינויים בחבילות במעלה הזרם לאוטומטיים כדי לוודא שהן עומדות בסטנדרטים פנימיים, כמו ערכי ברירת מחדל, הוספת תוויות ומאגרי קובצי אימג' של קונטיינרים.
יצירת מאגרי WET
WET הוא ראשי תיבות של Write Everything Twice (לכתוב הכל פעמיים). הוא מנוגד ל-DRY, ראשי תיבות של Don't Repeat Yourself (אל תחזרו על עצמכם). הגישות האלה מייצגות שני סוגים שונים של קובצי תצורה:
- הגדרות DRY, שבהן קובץ תצורה יחיד עובר פעולת טרנספורמציה כדי לאכלס שדות עם ערכים שונים לסביבות שונות. לדוגמה, יכולה להיות לכם הגדרת אשכול משותפת שמאכלסת אזור אחר או הגדרות אבטחה שונות לסביבות שונות.
- הגדרות WET (או לפעמים "fully-hydrated"), שבהן כל קובץ תצורה מייצג את המצב הסופי.
למרות שמאגרי WET יכולים להוביל לכמה קובצי תצורה חוזרים, יש להם את היתרונות הבאים לתהליך עבודה של GitOps:
- לחברי הצוות קל יותר לבדוק את השינויים.
- לא צריך לבצע עיבוד כדי לראות את המצב הרצוי של קובץ תצורה.
בדיקה בשלב מוקדם יותר כשמאמתים הגדרות אישיות
אם תחכו עד שסנכרון ההגדרות יתחיל לסנכרן כדי לבדוק אם יש בעיות, יכול להיות שייווצרו פקודות Git commit מיותרות ולולאת משוב ארוכה. אפשר למצוא הרבה בעיות לפני שמחילים הגדרה על אשכול באמצעות פונקציות האימות של kpt.
למרות שצריך להוסיף עוד כלים ולוגיקה לתהליך ה-commit, לבדיקה לפני החלת ההגדרות יש את היתרונות הבאים:
- הצגת שינויים בהגדרות בבקשת שינוי יכולה לעזור למנוע שגיאות במאגר.
- מפחיתה את ההשפעה של בעיות בהגדרות משותפות.
שימוש בתיקיות במקום בענפים
להשתמש בתיקיות לווריאציות של קובצי תצורה במקום בהסתעפויות. בתיקיות, אתם יכולים להשתמש בפקודה tree כדי לראות וריאציות. כשמשתמשים בהסתעפויות, אי אפשר לדעת אם ההבדל בין הסתעפות הייצור להסתעפות הפיתוח הוא שינוי עתידי בהגדרות או הבדל קבוע בין הסביבות prod ו-dev.
החיסרון העיקרי בגישה הזו הוא ששימוש בתיקיות לא מאפשר לקדם שינויים בהגדרות האישיות באמצעות בקשת שינוי לאותם קבצים. עם זאת, לשימוש בתיקיות במקום בענפים יש את היתרונות הבאים:
- קל יותר למצוא תיקיות מאשר ענפים.
- אפשר לבצע השוואה בין תיקיות באמצעות הרבה כלי CLI ו-GUI, אבל השוואה בין הסתעפויות פחות נפוצה מחוץ לספקי Git.
- קל יותר להבחין בין הבדלים קבועים להבדלים שלא קודמו באמצעות תיקיות.
- אפשר לפרוס שינויים בכמה אשכולות ומרחבי שמות בבקשת שינוי אחת, ואילו הסתעפויות דורשות כמה בקשות שינוי להסתעפויות שונות.
צמצום השימוש ב-ClusterSelectors
ClusterSelectors מאפשרים להחיל חלקים מסוימים של הגדרה על קבוצת משנה של אשכולות. במקום להגדיר אובייקט RootSync או RepoSync, אתם יכולים לשנות את המשאב שמוחל או להוסיף תוויות לאשכולות. למרות שזו דרך קלה להוסיף מאפיינים לאשכול, ככל שמספר ה-ClusterSelectors גדל עם הזמן, יכול להיות שיהיה קשה יותר להבין את המצב הסופי של האשכול.
מכיוון שסנכרון ההגדרות מאפשר לסנכרן כמה אובייקטים של RootSync ו-RepoSync בבת אחת, אתם יכולים להוסיף את ההגדרה הרלוונטית למאגר נפרד ואז לסנכרן אותה עם האשכולות הרצויים. כך קל יותר להבין את המצב הסופי של האשכול, ואפשר לאסוף את ההגדרות של האשכול בתיקייה במקום להחיל את החלטות ההגדרה האלה ישירות על האשכול.
לא מומלץ לנהל משימות באמצעות "סנכרון הגדרות"
ברוב המקרים, משימות ומטלות אחרות שקשורות למצב מסוים צריכות להיות מנוהלות על ידי שירות שמטפל בניהול מחזור החיים שלהן. לאחר מכן תוכלו לנהל את השירות הזה באמצעות סנכרון תצורות, במקום את המשימות עצמן.
למרות שסנכרון ההגדרות יכול להחיל משימות, משימות לא מתאימות לפריסות GitOps מהסיבות הבאות:
שדות שלא ניתן לשנות: שדות רבים של משימות לא ניתנים לשינוי. כדי לשנות שדה שלא ניתן לשינוי, צריך למחוק את האובייקט וליצור אותו מחדש. עם זאת, סנכרון ההגדרות לא מוחק את האובייקט, אלא אם מסירים אותו מהמקור.
הפעלה לא מכוונת של משימות: אם מסנכרנים משימה באמצעות סנכרון תצורות ואז המשימה נמחקת מהאשכול, סנכרון תצורות מחשיב את זה כסטייה מהמצב שבחרתם ויוצר מחדש את המשימה. אם מציינים אורך חיים (TTL) של משימה, סנכרון ההגדרות מוחק את המשימה באופן אוטומטי, יוצר אותה מחדש ומפעיל אותה מחדש, עד שמוחקים את המשימה ממקור המידע המהימן.
בעיות בהתאמה: בדרך כלל, אחרי שהאובייקטים מוחלים, סנכרון תצורות ממתין להתאמה שלהם. עם זאת, משימות נחשבות כמתואמות כשהן מתחילות לפעול. כלומר, סנכרון תצורות לא ממתין להשלמת המשימה לפני שהוא ממשיך להחיל אובייקטים אחרים. עם זאת, אם המשימה נכשלת בהמשך, זה נחשב ככישלון בהתאמה. במקרים מסוימים, זה יכול לחסום את הסנכרון של משאבים אחרים ולגרום לשגיאות עד שתתקנו את הבעיה. במקרים אחרים, יכול להיות שהסנכרון יצליח ורק ההתאמה תיכשל.
לכן, אנחנו לא ממליצים לסנכרן משימות באמצעות סנכרון תצורות.
שימוש במאגרים לא מובְנים
סנכרון ההגדרות תומך בשני מבנים לארגון מאגר: לא מובנה והיררכי.
הגישה הלא מובנית היא הגישה המומלצת כי היא מאפשרת לארגן מאגר בדרך שהכי נוחה לכם.
לעומת זאת, מאגרים היררכיים אוכפים מבנה ספציפי, כמו הגדרות של משאבים בהתאמה אישית (CRD) בספרייה cluster.
זה יכול לגרום לבעיות כשצריך לשתף הגדרות אישיות. לדוגמה, אם צוות אחד מפרסם חבילה שמכילה CRD, צוות אחר שצריך להשתמש בחבילה הזו יצטרך להעביר את ה-CRD לספריית cluster, מה שמוסיף עוד תקורה לתהליך.
כשמשתמשים במאגר לא מובנה, קל יותר לשתף חבילות של הגדרות אישיות ולהשתמש בהן שוב. עם זאת, בלי תהליך מוגדר או הנחיות לארגון המאגרים, המבנים של המאגרים יכולים להשתנות בין הצוותים, מה שיכול להקשות על הטמעת כלים בכל המערך.
במאמר המרת מאגר היררכי למאגר לא מובנה מוסבר איך ממירים מאגר היררכי.
מאגרים נפרדים לקוד ולהגדרות אישיות
כשמרחיבים מאגר יחיד, צריך ליצור גרסה ספציפית לכל תיקייה. בדרך כלל, ההרשאות והדאגות של אנשים שעובדים על הקוד שונות מאלה של אנשים שעובדים על הגדרת האשכול.
להפרדה בין מאגרי הקוד וההגדרות יש כמה יתרונות:
- מונעת "לולאות" של פקודות commit. לדוגמה, ביצוע commit למאגר המקורות של הקוד עשוי להפעיל בקשת CI, שעשויה ליצור קובץ אימג', ואז נדרש commit של קוד.
- מספר ה-commits הנדרש יכול להפוך לנטל על חברי הצוות שתורמים.
- אתם יכולים להשתמש בהרשאות שונות לאנשים שעובדים על קוד האפליקציה ועל הגדרת האשכול.
להפרדה בין מאגרי הקוד וההגדרות יש את החסרונות הבאים:
- מפחית את החשיפה של הגדרות האפליקציה, כי הן לא נמצאות באותו מאגר כמו קוד האפליקציה.
- ניהול של מאגרים רבים יכול לקחת הרבה זמן.
שימוש במאגרים נפרדים כדי לבודד שינויים
כשמרחיבים מאגר יחיד, נדרשות הרשאות שונות בתיקיות שונות. לכן, הפרדת המאגרים מאפשרת גבולות אבטחה בין הגדרות האבטחה, הפלטפורמה והאפליקציה. מומלץ גם להפריד בין מאגרים של סביבת הייצור למאגרים של סביבות אחרות.
ניהול של מאגרים רבים יכול להיות משימה גדולה בפני עצמה, אבל לבידוד של סוגי הגדרות שונים במאגרים שונים יש את היתרונות הבאים:
- בארגון עם צוותי פלטפורמה, אבטחה ואפליקציות, קצב השינויים וההרשאות שונה.
- ההרשאות נשארות ברמת המאגר. קבצים מסוג
CODEOWNERSמאפשרים לארגונים להגביל את הרשאת הכתיבה, ועדיין לאפשר הרשאת קריאה. - סנכרון ההגדרות תומך בכמה סנכרונים לכל מרחב שמות, מה שמאפשר להשיג אפקט דומה לזה של קבלת קבצים מכמה מאגרים.
הצמדת גרסאות של חבילות
לא משנה אם אתם משתמשים ב-Helm או ב-Git, כדאי להצמיד את גרסת חבילת ההגדרות למשהו שלא יתקדם בטעות בלי השקה מפורשת.
אמנם זה מוסיף עוד בדיקות להשקות כשמעדכנים הגדרה משותפת, אבל זה מפחית את הסיכון שלעדכונים משותפים תהיה השפעה גדולה יותר מהמתוכנן.
שימוש באיחוד זהויות של עומסי עבודה ל-GKE
אתם יכולים להפעיל את איחוד הזהויות של עומסי עבודה ל-GKE באשכולות GKE, כדי לאפשר לעומסי עבודה של Kubernetes לגשת לשירותי Google בצורה מאובטחת וניתנת לניהול.
למרות ששירותים מסוימים שהם לא שלGoogle Cloud , כמו GitHub ו-GitLab, לא תומכים באיחוד זהויות של עומסי עבודה ל-GKE, כדאי לנסות להשתמש באיחוד זהויות של עומסי עבודה ל-GKE בכל הזדמנות אפשרית, כי הוא משפר את האבטחה ומפחית את המורכבות של ניהול הסודות והסיסמאות.