


Profila e convalida la qualità dei dati
Knowledge Catalog (in precedenza Dataplex Universal Catalog) consente di profilare le tabelle BigQuery per calcolare statistiche a livello di colonna, come percentuali di valori nulli, conteggi di valori univoci e distribuzioni di valori. Puoi quindi utilizzare questi insight per definire regole di qualità dei dati e convalidare i record per rilevare eventuali anomalie.
In questa guida rapida, compili una tabella BigQuery di esempio con anomalie intenzionali, esegui una scansione di profilazione dei dati e valuti i risultati con una scansione della qualità dei dati. Per saperne di più, consulta Informazioni sulla profilazione dei dati e Informazioni sulla qualità dei dati automatica.
Prima di iniziare
Configura il progetto:
- Accedi al tuo account Google Cloud . Se non conosci Google Cloud, crea un account per valutare le prestazioni dei nostri prodotti in scenari reali. I nuovi clienti ricevono anche 300 $di crediti senza costi per l'esecuzione, il test e il deployment dei workload.
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
If you're using an existing project for this guide, verify that you have the permissions required to complete this guide. If you created a new project, then you already have the required permissions.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Knowledge Catalog and BigQuery APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
If you're using an existing project for this guide, verify that you have the permissions required to complete this guide. If you created a new project, then you already have the required permissions.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Knowledge Catalog and BigQuery APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.
Ruoli obbligatori
Per ottenere le autorizzazioni necessarie per creare ed eseguire scansioni del profilo di dati e della qualità dei dati e gestire le risorse BigQuery, chiedi all'amministratore di concederti i seguenti ruoli IAM nel progetto:
-
Creare, eseguire ed eliminare analisi dei dati:
Dataplex DataScan Editor (
roles/dataplex.dataScanEditor) -
Creare, compilare ed eliminare tabelle di esempio:
BigQuery Data Owner (
roles/bigquery.dataOwner) -
Eseguire query SQL in BigQuery:
Utente job BigQuery (
roles/bigquery.jobUser)
Per saperne di più sulla concessione dei ruoli, consulta Gestisci l'accesso a progetti, cartelle e organizzazioni.
Potresti anche riuscire a ottenere le autorizzazioni richieste tramite i ruoli personalizzati o altri ruoli predefiniti.
Se disponi delle autorizzazioni necessarie per gestire l'accesso IAM nel tuo progetto, puoi concedere questi ruoli al tuo account utente eseguendo i seguenti comandi gcloud:
gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/dataplex.dataScanEditor"

gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/bigquery.dataOwner"

gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/bigquery.jobUser"
Sostituisci quanto segue:
PROJECT_ID: il tuo ID progetto Google Cloud .USER_EMAIL: l'indirizzo email del tuo account utente (ad esempioname@example.com).
Concedi le autorizzazioni all'agente di servizio Knowledge Catalog
Un agente di servizio è un service account gestito da Google che Knowledge Catalog utilizza per eseguire query di scansione in BigQuery per tuo conto.
Nella console Google Cloud , fai clic su Attiva Cloud Shell nella barra degli strumenti. Bastano pochi istanti per eseguire il provisioning e connettersi all'ambiente.
Crea l'agente di servizio Knowledge Catalog:
gcloud beta services identity create --service=dataplex.googleapis.comQuesto comando crea l'agente di servizio se non è stato ancora eseguito il provisioning e restituisce la sua email. Se il tuo progetto ha già un agente di servizio Knowledge Catalog, il comando restituisce l'identità esistente senza apportare modifiche.
L'output è simile al seguente:
serviceAccount:service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.comPrendi nota del
PROJECT_NUMBERnell'output per i passaggi successivi.Concedi il ruolo BigQuery Job User (
roles/bigquery.jobUser) in modo che Knowledge Catalog possa eseguire job di query nel tuo progetto:gcloud projects add-iam-policy-binding PROJECT_ID \ --member="serviceAccount:service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com" \ --role="roles/bigquery.jobUser"
Sostituisci quanto segue:
PROJECT_ID: il tuo ID progetto Google Cloud .PROJECT_NUMBER: il tuo numero di progetto Google Cloud .
Concedi il ruolo BigQuery Data Viewer (
roles/bigquery.dataViewer) in modo che l'agente di servizio possa leggere i dati e lo schema della tabella:gcloud projects add-iam-policy-binding PROJECT_ID \ --member="serviceAccount:service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com" \ --role="roles/bigquery.dataViewer"
Sostituisci quanto segue:
PROJECT_ID: il tuo ID progetto Google Cloud .PROJECT_NUMBER: il tuo numero di progetto Google Cloud .
Crea un set di dati e una tabella di esempio
Per provare in sicurezza la profilazione e le scansioni della qualità dei dati senza toccare i dati di produzione, configura un set di dati BigQuery dedicato e crea una tabella contenente dati di esempio di bike sharing con anomalie intenzionali, come duplicati e valori nulli.
Console
Nella console Google Cloud , vai alla pagina BigQuery.
Nel riquadro Explorer, fai clic su Visualizza azioni accanto al tuo ID progetto, quindi su Crea set di dati.
Nel campo Dataset ID (ID set di dati), inserisci
quickstart_data_profile.Nell'elenco Località dei dati, seleziona us-central1 (Iowa).
Fai clic su Crea set di dati.
Nell'editor di query, inserisci la seguente query SQL per generare dati di esempio sul bike sharing nella tabella
bikeshare_trips:CREATE OR REPLACE TABLE `PROJECT_ID.quickstart_data_profile.bikeshare_trips` AS SELECT -- Duplicate and null IDs IF(MOD(x, 100) = 0, NULL, IF(x > 9900, 1000 + (x - 9900), 1000 + x)) AS trip_id, -- Nulls and unrecognized category values CASE WHEN MOD(x, 50) = 0 THEN 'INVALID_TIER' WHEN MOD(x, 25) = 0 THEN NULL WHEN MOD(x, 4) = 0 THEN 'Local Rider' WHEN MOD(x, 4) = 1 THEN 'Walk Up' WHEN MOD(x, 4) = 2 THEN 'Student Membership' ELSE 'Weekender' END AS subscriber_type, -- Nulls and malformed bike IDs CASE WHEN MOD(x, 60) = 0 THEN 'UNKNOWN' WHEN MOD(x, 30) = 0 THEN NULL ELSE CAST(2000 + x AS STRING) END AS bike_id, -- Null dates and future timestamps CASE WHEN MOD(x, 70) = 0 THEN NULL WHEN MOD(x, 40) = 0 THEN TIMESTAMP_ADD(CURRENT_TIMESTAMP(), INTERVAL x MINUTE) ELSE TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL x MINUTE) END AS start_time, -- Nulls and placeholder station values CASE WHEN MOD(x, 20) = 0 THEN 'STATION_UNKNOWN' WHEN MOD(x, 10) = 0 THEN NULL ELSE CAST(100 + MOD(x, 50) AS STRING) END AS start_station_id, -- Negative durations, zeros, and extreme outliers CASE WHEN MOD(x, 15) = 0 THEN -10.0 WHEN MOD(x, 35) = 0 THEN 0.0 WHEN MOD(x, 200) = 0 THEN 99999.0 ELSE CAST(MOD(x, 120) + 1.5 AS FLOAT64) END AS duration_minutes FROM UNNEST(GENERATE_ARRAY(1, 10000)) AS x;
Sostituisci
PROJECT_IDcon l'ID progetto Google Cloud .Fai clic su Esegui.
gcloud
In Cloud Shell, crea il set di dati
quickstart_data_profilenella regioneus-central1:bq --location=us-central1 mk --dataset PROJECT_ID:quickstart_data_profile
Sostituisci
PROJECT_IDcon l'ID progettoGoogle Cloud .Crea e compila la tabella di esempio
bikeshare_trips:bq query \ --use_legacy_sql=false \ "CREATE OR REPLACE TABLE \`PROJECT_ID.quickstart_data_profile.bikeshare_trips\` AS SELECT IF(MOD(x, 100) = 0, NULL, IF(x > 9900, 1000 + (x - 9900), 1000 + x)) AS trip_id, CASE WHEN MOD(x, 50) = 0 THEN 'INVALID_TIER' WHEN MOD(x, 25) = 0 THEN NULL WHEN MOD(x, 4) = 0 THEN 'Local Rider' WHEN MOD(x, 4) = 1 THEN 'Walk Up' WHEN MOD(x, 4) = 2 THEN 'Student Membership' ELSE 'Weekender' END AS subscriber_type, CASE WHEN MOD(x, 60) = 0 THEN 'UNKNOWN' WHEN MOD(x, 30) = 0 THEN NULL ELSE CAST(2000 + x AS STRING) END AS bike_id, CASE WHEN MOD(x, 70) = 0 THEN NULL WHEN MOD(x, 40) = 0 THEN TIMESTAMP_ADD(CURRENT_TIMESTAMP(), INTERVAL x MINUTE) ELSE TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL x MINUTE) END AS start_time, CASE WHEN MOD(x, 20) = 0 THEN 'STATION_UNKNOWN' WHEN MOD(x, 10) = 0 THEN NULL ELSE CAST(100 + MOD(x, 50) AS STRING) END AS start_station_id, CASE WHEN MOD(x, 15) = 0 THEN -10.0 WHEN MOD(x, 35) = 0 THEN 0.0 WHEN MOD(x, 200) = 0 THEN 99999.0 ELSE CAST(MOD(x, 120) + 1.5 AS FLOAT64) END AS duration_minutes FROM UNNEST(GENERATE_ARRAY(1, 10000)) AS x;"
Crea ed esegui una scansione di profilazione dei dati
Una scansione di profilazione dei dati esamina le righe della tabella per calcolare insight statistici, tra cui conteggi di valori univoci, rapporti di valori nulli e intervalli di distribuzione dei dati.
Console
Nella console Google Cloud , vai alla pagina Profilazione e qualità dei dati.
Fai clic su Crea scansione di profilazione dei dati.
In Scegli tipo, lascia selezionata l'opzione Scansione di profilazione dei dati.
In Generali, nel campo Nome visualizzato, inserisci
bikeshare-trips-profile.In Tabella da scansionare, nel campo Tabella, fai clic su Sfoglia, seleziona la tabella
quickstart_data_profile.bikeshare_tripsnel progetto e poi fai clic su Seleziona.In Modalità, seleziona Standard.
In Ambito, seleziona Tutti i dati.
In Pianificazione, seleziona On demand.
Non modificare le altre impostazioni predefinite.
Fai clic su Esegui scansione.
Il job di scansione viene avviato. In genere, Knowledge Catalog impiega dai 3 ai 5 minuti per eseguire la scansione e calcolare le statistiche per la tabella.
gcloud
In Cloud Shell, crea la scansione di profilazione dei dati:
gcloud dataplex datascans create data-profile bikeshare-trips-profile \
 --location=us-central1 \
 --data-source-resource="//bigquery.googleapis.com/projects/PROJECT_ID/datasets/quickstart_data_profile/tables/bikeshare_trips" \
 --description="Data profile scan for sample bikeshare dataset"
Sostituisci
PROJECT_IDcon l'ID progettoGoogle Cloud .Esegui la scansione di profilazione dei dati:
gcloud dataplex datascans run bikeshare-trips-profile \
 --location=us-central1
Il job di scansione viene avviato in background. In genere, la scansione richiede da 3 a 5 minuti.
Esamina i risultati della scansione di profilazione dei dati
Al termine della scansione, esamina le statistiche delle colonne per comprendere le caratteristiche dei dati.
Nella console Google Cloud , vai alla pagina Profilazione e qualità dei dati.
Nell'elenco delle scansioni, fai clic su bikeshare-trips-profile.
Se la scansione non è ancora stata eseguita, fai clic su Esegui ora.
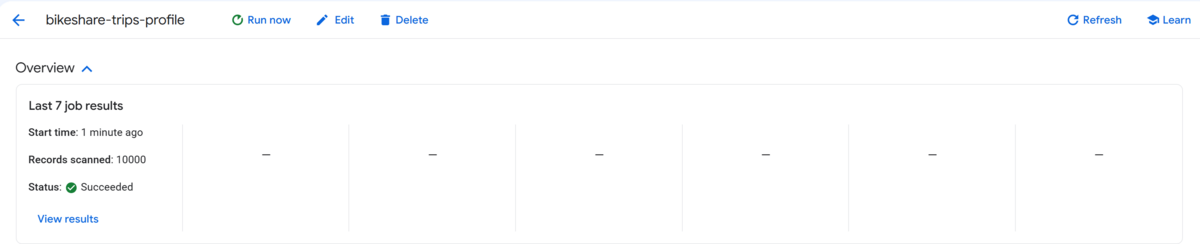
Nella sezione Panoramica, attendi che l'ultimo job di scansione mostri Riuscito.
L'immagine seguente mostra il job di scansione nella sezione Panoramica con lo stato Riuscito:
Esamina i risultati della scansione per comprendere la distribuzione dei dati della tabella e identificare potenziali target di convalida della qualità dei dati. Nella scheda Risultati job più recenti, Knowledge Catalog visualizza le metriche a livello di colonna, tra cui %null, Conteggio e %univoci, Valori principali e Statistiche di riepilogo.
La tabella seguente mostra quale metrica del profilo controllare per ogni colonna della tabella, come interpretare i risultati e quale regola di qualità dei dati scegliere come target:
Colonna Tabella Metrica dei risultati del profilo Cosa cercare e come interpretare Target di convalida della qualità dei dati duration_minutesStatistiche riepilogative Valori negativi rilevati: il valore Min è -10.0minuti. La durata del percorso trascorsa non può essere negativa, il che indica registrazioni dei sensori o della corsa non valide.Target con una regola di validità (intervallo) (ad esempio duration_minutes ≥ 1.0) per richiedere tempi di corsa trascorsi positivi.start_station_idNull % Circa il 5% di valori null: la percentuale di valori null è superiore allo 0%, il che indica che alcuni record non contengono identificatori di stazione di ritiro (ad esempio corse senza dock o senza chiosco). Target con una regola di completezza (non null) per rilevare e segnalare i record con ID stazione mancanti. subscriber_typeValori principali Categorie impreviste: l'elenco dei valori frequenti contiene categorie non standard (ad esempio INVALID_TIER) insieme a livelli di abbonamento validi, il che indica problemi di input o importazione degli utenti non convalidati.Scegli come target una regola di validità (impostata) per applicare che tutti i valori in entrata appartengano all'elenco consentito di tipi di iscrizione. trip_idConteggio unico e % Rilevato ID duplicato: l'unicità è inferiore al 100% (circa il 98%), il che indica record di identificatori ripetuti. Le chiavi primarie e gli identificatori delle corse devono essere univoci al 100%. Scegli come target una regola di univocità per segnalare e impedire record di corse duplicati.
Questi risultati del profilo ti forniscono una base di riferimento basata su prove per creare regole di qualità dei dati mirate.
Crea ed esegui un'analisi della qualità dei dati
Ora che hai scoperto l'aspetto dei dati, configura regole automatiche per la qualità dei dati per rilevare le anomalie. In questo passaggio, configurerai quattro tipi di regole comuni in base ai risultati del profilo.
Console
Nella console Google Cloud , vai alla pagina Profilazione e qualità dei dati.
Fai clic su Crea scansione della qualità dei dati.
In Generali, nel campo Nome visualizzato, inserisci
bikeshare-trips-quality.In Tabella da analizzare, nel campo Tabella, fai clic su Sfoglia, seleziona la tabella
quickstart_data_profile.bikeshare_tripse poi fai clic su Seleziona.In Ambito, seleziona Tutti i dati.
In Pianificazione, seleziona On demand.
Lascia invariate le altre impostazioni predefinite e fai clic su Continua.
Nella sezione Regole di qualità dei dati, fai clic su Aggiungi regole e seleziona Tipi di regole integrate.
Nel riquadro Aggiungi regole, seleziona le colonne e i tipi di regole:
- Nel campo Scegli colonne, fai clic su Sfoglia e seleziona
duration_minutes,start_station_id,subscriber_typeetrip_id. - Fai clic su Seleziona.
- Nell'elenco Scegli i tipi di regole, seleziona Controllo intervallo, Controllo NULL, Controllo set di valori e Controllo unicità, quindi fai clic su Ok.
Nell'elenco delle regole generate, seleziona la casella di controllo per ciascuna delle seguenti regole:
duration_minutes: controllo dell'intervallostart_station_id: controllo NULLsubscriber_type: controllo del set di valoritrip_id: Controllo unicità
Fai clic su Seleziona.
- Nel campo Scegli colonne, fai clic su Sfoglia e seleziona
Nella tabella Regole per la qualità dei dati, configura i parametri per le regole che richiedono valori:
- Per
duration_minutes(Controllo intervallo), fai clic su Modifica, inserisci1.0nel campo Valore minimo e fai clic su Salva. - Per
subscriber_type(Controllo del set di valori), fai clic su Modifica, fai clic su Aggiungi valore per aggiungere ciascuno dei valori consentiti (Local Rider,Walk Up,Student MembershipeWeekender) e fai clic su Salva.
- Per
Fai clic su Continua e poi su Esegui scansione.
gcloud
In Cloud Shell, crea un file denominato
dq_bikeshare.yamlcon le specifiche delle regole che hanno come target le anomalie trovate nel tuo profilo:cat << 'EOF' > dq_bikeshare.yaml rules: - column: trip_id dimension: UNIQUENESS uniquenessExpectation: {} - column: start_station_id dimension: COMPLETENESS nonNullExpectation: {} - column: duration_minutes dimension: VALIDITY rangeExpectation: minValue: "1.0" - column: subscriber_type dimension: VALIDITY setExpectation: values: - "Local Rider" - "Walk Up" - "Student Membership" - "Weekender" EOFCrea l'analisi della qualità dei dati:
gcloud dataplex datascans create data-quality bikeshare-trips-quality \
 --location=us-central1 \
 --data-source-resource="//bigquery.googleapis.com/projects/PROJECT_ID/datasets/quickstart_data_profile/tables/bikeshare_trips" \
 --data-quality-spec-file="dq_bikeshare.yaml" \
 --description="Data quality scan for sample bikeshare dataset"
Sostituisci
PROJECT_IDcon l'ID progettoGoogle Cloud .Esegui la scansione della qualità dei dati:
gcloud dataplex datascans run bikeshare-trips-quality \
 --location=us-central1
Esamina le valutazioni delle regole sulla qualità dei dati
Controlla i risultati della qualità dei dati per vedere in che modo le regole hanno valutato i dati campionati e identificato le anomalie.
Nella console Google Cloud , vai alla pagina Profilazione e qualità dei dati.
Nella tabella Scans (Analisi), fai clic sull'analisi bikeshare-trips-quality.
Nella sezione Panoramica, fai clic su Visualizza risultati per aprire i dettagli del job.
Nel riquadro Dettagli job, esamina i risultati della valutazione:
Stato della qualità dei dati: come previsto, tutte e tre le dimensioni valutate mostrano lo stato Non riuscito.
- Validità: Non riuscita. La colonna
duration_minutescontiene valori negativi esubscriber_typecontiene valori di appartenenza non validi (INVALID_TIER). - Completezza: Non riuscita. La colonna
start_station_idcontiene valori null. - Unicità: non riuscita. La colonna
trip_idcontiene record duplicati.
- Validità: Non riuscita. La colonna
Regole: nella tabella Regole, tutte e quattro le regole valutate mostrano lo stato Non riuscita.
duration_minutes: controllo dell'intervallo (non riuscito)start_station_id: controllo NULL (non riuscito)subscriber_type: controllo del set di valori (Non riuscito)trip_id: controllo unicità (non riuscito)
Per qualsiasi regola non riuscita, puoi copiare la query SQL nella colonna Query per ottenere i record non riusciti ed eseguirla in BigQuery per isolare e ispezionare le righe non valide.
Hai profilato una tabella BigQuery per scoprire le statistiche delle colonne e hai utilizzato questi insight per definire e convalidare le regole di qualità dei dati automatizzate.
Esegui la pulizia
Per evitare che al tuo account Google Cloud vengano addebitati costi relativi alle risorse utilizzate in questa pagina, segui questi passaggi.
Console
Nella console Google Cloud , vai alla pagina Profilazione e qualità dei dati.
Nella tabella Scansioni, seleziona bikeshare-trips-quality e bikeshare-trips-profile.
Fai clic su Elimina e conferma.
Vai alla pagina BigQuery.
Nel riquadro Explorer, fai clic su Set di dati.
Seleziona il set di dati
quickstart_data_profile, quindi fai clic su Elimina.
gcloud
In Cloud Shell, elimina la scansione della qualità dei dati, la scansione di profilazione dei dati e il set di dati di esempio:
gcloud dataplex datascans delete bikeshare-trips-quality --location=us-central1 --quiet
gcloud dataplex datascans delete bikeshare-trips-profile --location=us-central1 --quiet
bq rm -r -f -d PROJECT_ID:quickstart_data_profile
Sostituisci PROJECT_ID con l'ID progettoGoogle Cloud .
Passaggi successivi
- Visualizza e risolvi i problemi relativi ai risultati della scansione della qualità dei dati
- Monitora le metriche di Knowledge Catalog
- Crea un workflow per la qualità dei dati basato su policy-as-code utilizzando l'interfaccia a riga di comando di Antigravity
- Gestisci le regole di qualità dei dati come codice con Terraform
- Riutilizza le regole di qualità dei dati nelle tabelle
- Esplora altri casi d'uso di Knowledge Catalog