


O Knowledge Studio (pré-lançamento) transforma metadados em um mecanismo contextual ativo que ajuda a melhorar a confiabilidade dos aplicativos de IA generativa. É possível usar o Knowledge Studio para evitar alucinações em agentes de IA, como análises de conversas no BigQuery e no Gemini, embasando-os no contexto da sua empresa.
O Knowledge Studio automatiza a curadoria de metadados ao unificar o conhecimento fragmentado de esquemas, wikis e consultas SQL anteriores. É possível analisar dados usando linguagem natural, navegar em um gráfico de contexto visual que conecta recursos de dados à semântica de negócios e executar fluxos de trabalho automatizados que elaboram atualizações de catálogo para revisão humana. Em seguida, é possível disponibilizar dinamicamente esses blocos de contexto selecionados para os agentes usando o Protocolo de Contexto de Modelo (MCP) ou as APIs do Knowledge Catalog.
Este documento é destinado a arquitetos de dados, líderes de governança e engenheiros de IA que querem entender como o Knowledge Studio funciona.
De catálogo passivo a mecanismo contextual ativo
Os catálogos de metadados típicos armazenam esquemas estáticos, descrições e dicionários de dados. Embora sejam suficientes para analistas de dados humanos que procuram tabelas, os metadados estáticos são insuficientes para agentes de IA generativa que exigem o seguinte:
Relações semânticas profundas: entender como as tabelas se unem em esquemas, quais colunas representam as principais métricas de negócios e como os glossários de negócios são mapeados para o armazenamento subjacente.
Embasamento operacional: incorporar padrões de uso de SQL do mundo real, frequência de consultas e comandos e respostas reais do agente no contexto.
Autoaprendizado contínuo: refinamento automático de descrições de tabelas, aspectos e definições de colunas com base no feedback do usuário e nas taxas de sucesso de execução do agente.
O Knowledge Studio oferece esses recursos por meio de um mecanismo contextual sempre ativado que minera continuamente indicadores operacionais, gera propostas de metadados de alta fidelidade e disponibiliza blocos de contexto pré-formatados para agentes por meio do Protocolo de Contexto de Modelo (MCP) ou das APIs do Knowledge Catalog.
Interfaces do Knowledge Studio
O Knowledge Studio organiza seu fluxo de trabalho em três áreas principais:
Novo chat: uma interface de chat conversacional e um gráfico de contexto interativo para descoberta de dados, investigação e validação de consultas semânticas usando linguagem natural. Para mais informações, consulte Analisar recursos de dados.
Conjuntos de contexto: uma interface para criar e gerenciar os contêineres lógicos (grupos de entrada) que empacotam seus metadados enriquecidos para embasar com segurança os agentes de IA downstream. Para mais informações, consulte Gerenciar conjuntos de contexto.
Enriquecimentos: um centro de controle para automatizar a geração de metadados, configurar comparativos de avaliação e analisar as atualizações de catálogo propostas pela IA (solicitações de mudança) com fluxos de trabalho de curadoria com intervenção humana. Para mais informações, consulte Sobre tarefas de enriquecimento.
Cenários reais com vários produtos
O Knowledge Studio conecta seu data warehouse, repositórios de conhecimento empresarial e aplicativos de IA generativa. Os cenários a seguir ilustram como o Knowledge Studio opera em vários produtos em uma arquitetura corporativa.
Embasar consultas em linguagem natural no BigQuery
O desafio:os analistas de negócios usam linguagem natural na análise conversacional para fazer perguntas como "Qual foi nossa taxa de retenção líquida por região no último trimestre?" Sem uma semântica de negócios selecionada, o modelo pode alucinar chaves de mesclagem ou confundir reservas brutas com receita líquida.
A solução do Knowledge Studio:o analista usa a interface de Nova conversa para verificar as relações entre as tabelas de preparo de vendas e o
SZBank Business Glossarycertificado. O Knowledge Studio embasa as análises de conversação usando o gráfico de contexto ativo, garantindo que o SQL gerado inclua condições de mesclagem verificadas e fórmulas de KPI padrão.
Enriquecer metadados de SOPs empresariais
O desafio:as equipes de engenharia de dados mantêm dezenas de conjuntos de dados no BigQuery, enquanto as regras de negócios críticas e a linhagem de pipeline ficam em wikis externos do Confluence ou em tíquetes do Jira. À medida que os esquemas evoluem, a documentação do catálogo fica desatualizada.
A solução do Knowledge Studio:um líder de governança configura uma tarefa de enriquecimento recorrente que tem como destino o conjunto de dados de análise. O Knowledge Studio ingere SOPs não estruturados do Confluence e registros de consultas históricos do Cloud Logging, propondo automaticamente definições de coluna e relações de tabela atualizadas. Os curadores inspecionam as diferenças propostas na página Detalhes da execução e aprovam as atualizações verificadas no catálogo.
Fornecer contexto selecionado aos agentes
- O desafio:os desenvolvedores de IA que criam agentes de suporte ou consultoria para clientes usando o LangChain ou o ADK precisam de semânticas de esquema atualizadas sem codificar credenciais de banco de dados ou preencher definições de tabelas grandes.
- A solução do Knowledge Studio:o Knowledge Studio captura metadados selecionados e gráficos de mesclagem validados em um conjunto de contexto (como
entryGroups/customer-360). Para acessar o contexto, os agentes podem se conectar ao Knowledge Studio pelo Protocolo de Contexto de Modelo (MCP) ou usar as APIs do catálogo do Knowledge Catalog. No momento da inferência, o agente consulta o endpoint do MCP ou as APIs do catálogo para recuperar dinamicamente o contexto de negócios certificado e as consultas de amostra relevantes para a intenção do usuário.
Informações gerais da arquitetura
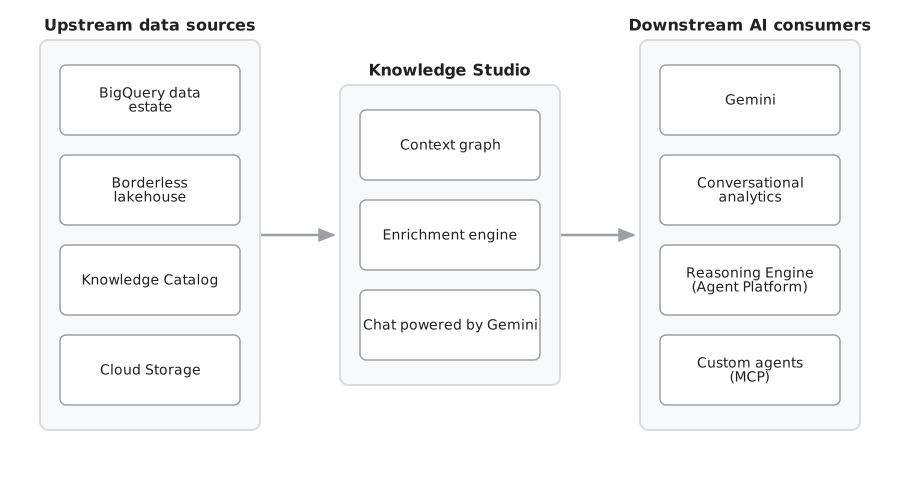
O diagrama a seguir ilustra como os componentes do Knowledge Studio interagem com seu patrimônio de dados, modelos de fundação e aplicativos de IA de consumo:
Principais conceitos
Para trabalhar de forma eficaz com o Knowledge Studio, entenda como os metadados corporativos são modelados, empacotados e selecionados.
Gráfico de contexto
O gráfico de contexto é a topologia visual central e interativa no Knowledge Studio. Ele unifica seus recursos de dados (como tabelas do BigQuery, visualizações e lakehouses) com semântica de negócios (como termos do glossário empresarial, fórmulas de métricas e produtos de dados). Em catálogos típicos, uma tabela de dados e a definição do glossário empresarial associado existem em silos separados. No gráfico de contexto, eles existem como nós em
na mesma tela. Analistas e engenheiros de dados podem visualizar as relações entre os dados, seja por uso inferido, condições de mesclagem em tabelas e muito mais, enquanto o Gemini usa o gráfico para fundamentar a exploração de linguagem natural. Para mais informações, consulte Analisar recursos de dados no Knowledge Studio.
Tipos de recursos e conexões compatíveis com o gráfico de contexto
O gráfico de contexto é compatível com a renderização dos seguintes recursos do Knowledge Catalog como nós ou contêineres:
- Tabelas e visualizações: tabelas, visualizações, conjuntos de dados e catálogos técnicos do BigQuery e do Lakehouse.
- Bancos de dados e armazenamento: bancos de dados operacionais (como Spanner e AlloyDB) e recursos do Cloud Storage.
- Análise e modelagem: projetos do Looker e modelos, testes e exposições do dbt.
- Termos do glossário: definições de negócios individuais de um glossário empresarial.
- Produtos de dados: pacotes selecionados de recursos de dados para consumo entre equipes.
- Contexto: conjuntos de contexto personalizados e documentação anexada.
- Recursos personalizados: grupos de entrada personalizados e tipos de entrada não compatíveis.
O gráfico define como esses recursos são conectados ao visualizar as seguintes arestas de relação semântica:
Mesclagem de esquema: relações de mesclagem estruturais e operacionais entre tabelas. O sistema verifica automaticamente os jobs do BigQuery em busca de consultas que indicam que colunas em tabelas diferentes compartilham o mesmo significado e podem ser mescladas.
Definição: links que mapeiam um recurso ou uma coluna de dados técnicos para a definição correspondente do glossário empresarial.
Contexto: links que atribuem conjuntos de contexto especializados ou documentação de domínio personalizado a um recurso de dados de destino.
Pacotes: links de agregação que mostram quais recursos de dados estão agrupados em um produto de dados específico.
Links de entrada
Um link de entrada representa uma borda semântica direcionada ou não direcionada no gráfico de contexto. Esses links unem visualmente seus recursos de dados e outros recursos unificados na tela. É possível filtrar esses links de forma seletiva para isolar relações específicas em todo o seu patrimônio de dados.
Os links de entrada conectam entidades distintas em toda a empresa:
Links de definição: conecte colunas de tabelas subjacentes diretamente a termos certificados do glossário empresarial e fórmulas de KPI.
Links de relacionamento: mapeie caminhos de junção de várias tabelas, chaves primárias e chaves externas verificadas.
Links de rastreamento do agente: associe comandos de usuários de IA do mundo real às tabelas específicas usadas para respondê-los.
Links de pacotes: junte conjuntos de recursos de dados a um produto de dados selecionado.
Os links de entrada servem como as conexões individuais percorridas para montar conjuntos de contexto. Durante as execuções de enriquecimento automatizado, o agente propõe novos links de entrada para aprovação do curador sempre que identifica junções candidatas ou termos não vinculados.
Conjuntos de contexto
Um conjunto de contexto é um contêiner limitado de informações semânticas e referências de recursos de dados. Cada conjunto de contexto é implementado como um grupo de entradas especializado (type="context-set").
Os conjuntos de contexto estabelecem limites de execução herméticos que impedem que os agentes realizem pesquisas abertas em todo o catálogo corporativo. Esse método reduz as alucinações e o consumo de tokens.
Para entender como os conjuntos de contexto diferem de construções relacionadas, como produtos de dados e o gráfico de contexto semântico, ou para recursos arquitetônicos detalhados, categorias, namespaces e padrões de consulta de agentes, consulte Visão geral dos conjuntos de contexto.
Tarefas e execuções de enriquecimento
A melhoria automatizada de metadados no Knowledge Studio é organizada em tarefas de enriquecimento, jobs de enriquecimento e execuções de enriquecimento.
Tarefa de enriquecimento: uma configuração durável que define como o agente de enriquecimento analisa um conjunto específico de recursos de dados. Uma tarefa de enriquecimento especifica o conjunto de contexto de destino, as fontes de entrada contextuais e os comparativos de mercado de avaliação.
Job de enriquecimento: o processo de orquestração de back-end no Knowledge Studio que executa uma tarefa de enriquecimento.
Execução de enriquecimento: uma única instância de execução pontual de uma tarefa. Cada execução inspeciona os recursos de destino, extrai indicadores semânticos e gera solicitações de mudança (propostas) que os administradores de dados podem analisar.
Para mais informações sobre fluxos de trabalho de enriquecimento, consulte Sobre tarefas de enriquecimento.
Gráfico de contexto em comparação com a linhagem de dados
Entender a diferença entre o gráfico de contexto do Knowledge Studio e a linhagem de dados do Knowledge Catalog é essencial para escolher a ferramenta certa.
A linhagem de dados rastreia o movimento operacional e a transformação subjacente dos dados ao longo do tempo. A linhagem responde a perguntas como: De onde vieram esses dados? Qual pipeline de ETL preencheu essa tabela? Se esse esquema upstream mudar, quais painéis downstream vão falhar? Os nós representam recursos e jobs de transformação (como pipelines do Dataflow ou jobs do BigQuery), e as arestas direcionadas representam o fluxo de dados.
O gráfico de contexto modela a semântica de negócios, os relacionamentos e o conhecimento de domínio. O gráfico de contexto responde a perguntas como: O que essa coluna significa em termos de negócios? Como essas duas tabelas se relacionam conceitualmente? Como um agente de IA deve unir esses recursos para responder a uma pergunta? Os nós representam os recursos subjacentes ao lado de entidades conceituais (como termos de glossário, fórmulas de KPI e produtos de dados), e as arestas representam conexões semânticas (como links de definição de coluna para glossário e condições de mesclagem verificadas).
Para mais informações sobre a rastreabilidade de pipelines, consulte Linhagem de dados do Knowledge Catalog.
Segurança e governança corporativas
O Knowledge Studio foi criado com base em uma arquitetura de segurança de nível empresarial projetada para ambientes estritamente controlados.
Identidade de execução gerenciada pelo usuário: as tarefas de enriquecimento são executadas usando uma conta serviço gerenciado pelo usuário, que é uma identidade criada e gerenciada no projeto para permitir que os serviços atuem em seu nome. O agente de serviço do Dataplex (P4SA) personifica essa conta de serviço usando o papel Criador de token da conta de serviço (
roles/iam.serviceAccountTokenCreator) para gerar credenciais do OAuth 2.0 de curta duração. A geração dessas credenciais de curta duração limita o ciclo de vida dos tokens de acesso, minimizando o risco de exposição de credenciais em comparação com o uso de chaves de conta de serviço de longa duração.Autenticação de terceiros: a conexão de fontes de conhecimento de SaaS remotas (como Microsoft SharePoint, Atlassian Confluence, Jira e GitHub) usa o gerenciador de autenticação de Identidade do Agente doGoogle Cloud, garantindo que os operadores humanos nunca lidem com chaves secretas do cliente brutas.
Para saber como configurar esses recursos de segurança, consulte Configurar pré-requisitos de enriquecimento.
Limitações
Regimes de conformidade do Assured Workloads (incluindo FedRAMP, CJIS, IL4/IL5 e HIPAA).
Compromissos de residência de dados (DRZ). Os dados processados por esse recurso podem ser armazenados ou processados fora dos limites geográficos estritamente configurados.
Chaves de criptografia gerenciadas pelo cliente (CMEK). Os dados armazenados ou processados por esse recurso são criptografados usando chaves de propriedade do Google e Google-owned and Google-managed encryption keys em vez das chaves do Cloud Key Management Service ou Cloud EKM.
VPC Service Controls. O VPC Service Controls não é compatível.
Notificações de Transparência no acesso (AXT) e controles de Aprovação de acesso. As ações realizadas pela equipe do Google para oferecer suporte ou manter essa pré-lançamento não serão registradas no Cloud Access Ledger (CAL) da Transparência no acesso.
Durante o pré-lançamento, o Knowledge Studio opera dentro dos seguintes limites adicionais:
Escopo regional do conjunto de contexto: não há suporte para conjuntos de contexto globais vinculados a recursos de dados regionais. Os conjuntos de contexto precisam estar alinhados com os limites regionais dos recursos que eles empacotam.
Gerenciamento priorizando o console: as tarefas de enriquecimento e as sessões de exploração são gerenciadas pelo console do Google Cloud . As APIs REST diretas e os comandos da CLI
gcloudpara gerenciamento de tarefas não estão disponíveis no pré-lançamento. No entanto, os agentes downstream podem descobrir e consultar de forma programática conjuntos de contexto selecionados usando as APIs do Knowledge Catalog (ListEntries,LookupEntry) e o Protocolo de Contexto de Modelo (MCP).Curadoria centralizada: toda a revisão e aprovação de metadados ocorre na página Detalhes da execução do enriquecimento.
Nenhuma SKU de faturamento independente: o Knowledge Studio não introduz SKUs de produtos separadas. As cobranças de uso refletem o consumo padrão dos recursos subjacentes ( Gemini Reasoning Engine, BigQuery e Cloud Storage).
A seguir
Analisar recursos de dados e o gráfico de contexto
Use a tela visual no Knowledge Studio para conversar com seus dados e rastrear relações semânticas.
Sobre o contexto de dados
Entender como o contexto ativo transforma metadados passivos para embasar agentes de IA e evitar alucinações.
Visão geral dos conjuntos de contexto
Aprenda mais sobre os contêineres de contexto empacotados do Knowledge Studio usados para embasar com segurança seus agentes de IA downstream.
Sobre as tarefas de enriquecimento
Saiba como configurar fluxos de trabalho de extração de metadados orientados por IA para criar contexto de dados automaticamente.
Estabelecer o contexto de dados fundamental
Criar um glossário empresarial, definir tipos de aspecto personalizados e enriquecer recursos no BigQuery.
Agentes de embasamento com MCP
Conecte agentes de IA e ferramentas para desenvolvedores ao Knowledge Catalog usando o Protocolo de Contexto de Modelo.