


Knowledge Studio (versión preliminar) transforma los metadatos en un motor de contexto activo que te ayuda a mejorar la confiabilidad de las aplicaciones de IA generativa. Puedes usar Knowledge Studio para evitar alucinaciones en los agentes de IA, como las estadísticas conversacionales en BigQuery y Gemini, ya que los fundamentas en el contexto de tu empresa.
Knowledge Studio automatiza la selección de metadatos unificando el conocimiento fragmentado de esquemas, wikis y consultas en SQL anteriores. Puedes explorar datos con lenguaje natural, navegar por un gráfico de contexto visual que conecta los recursos de datos con la semántica empresarial y ejecutar flujos de trabajo automatizados que redactan actualizaciones del catálogo para que las revisen personas. Luego, puedes entregar de forma dinámica estos bloques de contexto seleccionados a los agentes con el Protocolo de contexto del modelo (MCP) o las APIs de Knowledge Catalog.
Este documento está dirigido a arquitectos de datos, líderes de administración y ingenieros de IA que deseen comprender cómo funciona Knowledge Studio.
De un catálogo pasivo a un motor de contexto activo
Los catálogos de metadatos típicos almacenan esquemas, descripciones y diccionarios de datos estáticos. Aunque son suficientes para los analistas de datos humanos que buscan tablas, los metadatos estáticos no son suficientes para los agentes de IA generativa que requieren lo siguiente:
Relaciones semánticas profundas: Comprender cómo se unen las tablas en los esquemas, qué columnas representan las métricas empresariales clave y cómo se asignan los glosarios empresariales al almacenamiento subyacente.
Fundamentación operativa: Incorpora patrones de uso de SQL del mundo real, frecuencia de consultas, y las instrucciones y respuestas reales de los agentes en el contexto.
Autoaprendizaje continuo: Define mejor automáticamente las descripciones de las tablas, los aspectos y las definiciones de las columnas según los comentarios de los usuarios y las tasas de éxito de la ejecución del agente.
Knowledge Studio ofrece estas capacidades a través de un motor de contexto siempre activo que extrae continuamente indicadores operativos, genera propuestas de metadatos de alta fidelidad y entrega bloques de contexto con formato previo a los agentes a través de las APIs de catálogo de Knowledge Catalog o del Protocolo de contexto del modelo (MCP).
Interfaces de Knowledge Studio
Knowledge Studio organiza tu flujo de trabajo en tres áreas principales:
Nuevo chat: Es una interfaz de chat conversacional y un grafo de contexto interactivo para el descubrimiento de datos, la investigación y la validación de consultas semánticas con lenguaje natural. Para obtener más información, consulta Explora los recursos de datos.
Conjuntos de contexto: Es una interfaz para crear y administrar los contenedores lógicos (grupos de entradas) que empaquetan tus metadatos enriquecidos para fundamentar de forma segura los agentes de IA downstream. Para obtener más información, consulta Administra conjuntos de contexto.
Enriquecimientos: Es un centro de control para automatizar la generación de metadatos, configurar comparativas de evaluación y revisar las actualizaciones de catálogo propuestas por la IA (solicitudes de cambio) con flujos de trabajo de selección con intervención humana. Para obtener más información, consulta Acerca de las tareas de enriquecimiento.
Situaciones reales con varios productos
Knowledge Studio conecta tu almacén de datos, los repositorios de conocimiento empresarial y las aplicaciones de IA generativa. En las siguientes situaciones, se ilustra cómo funciona Knowledge Studio en varios productos de una arquitectura empresarial.
Fundamenta las consultas en lenguaje natural en BigQuery
El desafío: Los analistas de negocios usan el lenguaje natural en el análisis conversacional para hacer preguntas como "¿Cuál fue nuestra tasa de retención neta por región el trimestre pasado?" Sin una semántica empresarial seleccionada, el modelo podría generar claves de unión o confundir las reservas brutas con los ingresos netos.
La solución de Knowledge Studio: El analista usa la interfaz de Nuevo chat para verificar las relaciones entre las tablas de etapa de pruebas de ventas y el
SZBank Business Glossarycertificado. Knowledge Studio fundamenta las estadísticas conversacionales con el grafo de contexto activo, lo que garantiza que el SQL generado incluya condiciones de unión verificadas y fórmulas de KPI estándar.
Enriquece los metadatos de los SOP empresariales
El desafío: Los equipos de ingeniería de datos mantienen decenas de conjuntos de datos en BigQuery, mientras que las reglas empresariales fundamentales y el linaje de las canalizaciones se encuentran en wikis externas de Confluence o tickets de Jira. A medida que los esquemas evolucionan, la documentación del catálogo queda desactualizada.
La solución de Knowledge Studio: Un líder de administración configura una tarea de enriquecimiento recurrente orientada al conjunto de datos de estadísticas. Knowledge Studio transfiere los SOP no estructurados de Confluence y los registros de consultas históricos de Cloud Logging, y propone automáticamente definiciones de columnas y relaciones de tablas actualizadas. Los curadores inspeccionan las diferencias propuestas en la página Detalles de la ejecución y aprueban las actualizaciones verificadas del catálogo.
Proporciona contexto seleccionado a los agentes
- El desafío: Los desarrolladores de IA que crean agentes de asistencia o asesoramiento orientados al cliente con LangChain o el ADK necesitan semántica de esquema actualizada sin codificar las credenciales de la base de datos ni rellenar con instrucciones las definiciones de tablas grandes.
- La solución de Knowledge Studio: Knowledge Studio captura metadatos seleccionados
y grafos de unión validados en un conjunto de contexto (como
entryGroups/customer-360). Para acceder al contexto, los agentes pueden conectarse a Knowledge Studio a través del Protocolo de contexto del modelo (MCP) o usar las APIs de Knowledge Catalog. En el momento de la inferencia, el agente consulta el extremo de MCP o las APIs de Catalog para recuperar de forma dinámica el contexto empresarial certificado y las consultas de ejemplo relevantes para la intención del usuario.
Descripción general de la arquitectura
En el siguiente diagrama, se ilustra cómo interactúan los componentes de Knowledge Studio con tu patrimonio de datos, los modelos de base y las aplicaciones de IA que los consumen:
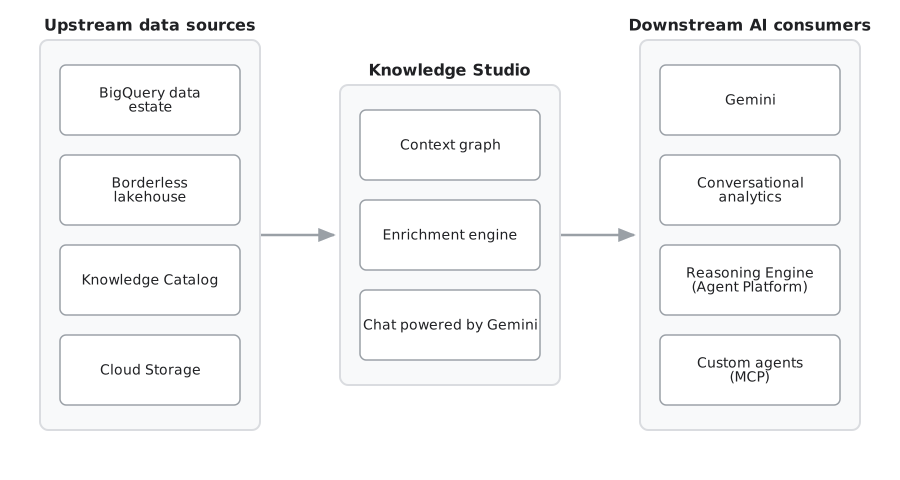
Conceptos básicos
Para trabajar de forma eficaz con Knowledge Studio, comprende cómo se modelan, empaquetan y seleccionan los metadatos empresariales.
Gráfico de contexto
El gráfico de contexto es la topología visual interactiva central en Knowledge Studio. Unifica tus recursos de datos (como tablas, vistas y lakehouses de BigQuery) con la semántica empresarial (como términos del glosario empresarial, fórmulas de métricas y productos de datos). En los catálogos típicos, una tabla de datos y su definición de glosario empresarial asociado existen en silos separados. En el gráfico de contexto, existen como nodos en
en el mismo lienzo. Los analistas y los ingenieros de datos pueden ver de forma visual las relaciones entre sus datos, ya sea por uso inferido, condiciones de unión en tablas y más, mientras que Gemini usa el gráfico para fundamentar la exploración en lenguaje natural. Para obtener más información, consulta Explora los recursos de datos en Knowledge Studio.
Tipos de recursos y conexiones admitidos para el gráfico de contexto
El gráfico de contexto admite la renderización de los siguientes recursos de Knowledge Catalog como nodos o contenedores:
- Tablas y vistas: Tablas, vistas, conjuntos de datos y catálogos técnicos de BigQuery y Lakehouse.
- Bases de datos y almacenamiento: Bases de datos operativas (como Spanner y AlloyDB) y recursos de Cloud Storage.
- Análisis y modelado: proyectos de Looker y modelos, pruebas y exposiciones de dbt.
- Términos del glosario: Son definiciones empresariales individuales de un glosario empresarial.
- Productos de datos: Son paquetes seleccionados de recursos de datos para el consumo entre equipos.
- Contexto: Conjuntos de contexto personalizados y documentación adjunta.
- Recursos personalizados: Son grupos de entradas personalizados y tipos de entradas no admitidos.
El grafo define cómo se conectan estos recursos visualizando los siguientes bordes de relación semántica:
Unión de esquemas: Son las relaciones de unión estructurales y operativas entre las tablas. El sistema analiza automáticamente los trabajos de BigQuery en busca de consultas que indiquen que las columnas de diferentes tablas comparten el mismo significado y se pueden unir.
Definición: Son vínculos que asignan un recurso o una columna de datos técnicos a su definición correspondiente del glosario empresarial.
Contexto: Son vínculos que atribuyen conjuntos de contexto especializados o documentación de dominio personalizado a un recurso de datos de destino.
Paquetes: Son vínculos de agregación que muestran qué recursos de datos se agrupan en un producto de datos específico.
Vínculos de entrada
Un vínculo de entrada representa un borde semántico dirigido o no dirigido en el grafo de contexto. Estos vínculos unen visualmente tus recursos de datos y otros recursos unificados en el lienzo. Puedes filtrar estos vínculos de forma selectiva para aislar relaciones específicas en tu patrimonio de datos.
Los vínculos de entrada conectan distintas entidades en toda tu empresa:
Vínculos de definición: Conecta las columnas de la tabla subyacente directamente con los términos certificados del glosario empresarial y las fórmulas de KPI.
Vínculos de relación: Asigna rutas de acceso de unión de varias tablas, clave externa y clave primaria verificadas.
Vínculos de seguimiento de agentes: Asocia las instrucciones de los usuarios de IA del mundo real con las tablas específicas que se usan para responderlas.
Vínculos de paquetes: Une conjuntos de recursos de datos a un producto de datos seleccionado.
Los vínculos de entrada sirven como las conexiones individuales que se recorren para ensamblar conjuntos de contexto. Durante las ejecuciones de enriquecimiento automatizadas, el agente propone nuevos vínculos de entrada para la aprobación del administrador de contenido cada vez que identifica uniones candidatas o términos no vinculados.
Conjuntos de contextos
Un conjunto de contexto es un contenedor limitado de información semántica y referencias de recursos de datos. Cada conjunto de contexto se implementa como un grupo de entradas especializado (type="context-set").
Los conjuntos de contexto establecen límites de ejecución herméticos que evitan que los agentes realicen búsquedas abiertas en todo el catálogo empresarial. Este método reduce las alucinaciones y el consumo de tokens.
Para comprender en qué se diferencian los conjuntos de contexto de las construcciones relacionadas, como los productos de datos y el grafo de contexto semántico, o para obtener información detallada sobre las capacidades, las categorías, los espacios de nombres y los patrones de consulta de agentes, consulta Descripción general de los conjuntos de contexto.
Tareas y ejecuciones de enriquecimiento
La mejora automatizada de metadatos en Knowledge Studio se organiza en tareas de enriquecimiento, trabajos de enriquecimiento y ejecuciones de enriquecimiento.
Tarea de enriquecimiento: Es una configuración duradera que define cómo el agente de enriquecimiento analiza un conjunto específico de recursos de datos. Una tarea de enriquecimiento especifica el conjunto de contexto de destino, las fuentes de entrada contextuales y las comparativas de evaluación.
Trabajo de enriquecimiento: Es el proceso de organización de backend dentro de Knowledge Studio que ejecuta una tarea de enriquecimiento.
Ejecución de enriquecimiento: Es una instancia de ejecución única y puntual de una tarea. Cada ejecución inspecciona los recursos de destino, extrae indicadores semánticos y genera solicitudes de cambio (propuestas) que los administradores de datos pueden revisar.
Para obtener más información sobre los flujos de trabajo de enriquecimiento, consulta Acerca de las tareas de enriquecimiento.
Gráfico de contexto en comparación con el linaje de datos
Comprender la diferencia entre el gráfico de contexto de Knowledge Studio y el linaje de datos de Knowledge Catalog es esencial para elegir la herramienta adecuada.
El linaje de datos hace un seguimiento del movimiento operativo y la transformación subyacente de los datos a lo largo del tiempo. El linaje responde preguntas como las siguientes: ¿De dónde provienen estos datos? ¿Qué canalización de ETL propagó esta tabla? Si este esquema upstream cambia, ¿qué paneles downstream se verán afectados? Los nodos representan los recursos subyacentes y los trabajos de transformación (como las canalizaciones de Dataflow o los trabajos de BigQuery), y los bordes dirigidos representan el flujo de datos subyacente.
El grafo de contexto modela la semántica empresarial, las relaciones y el conocimiento del dominio. El gráfico de contexto responde preguntas como las siguientes: ¿Qué significa esta columna en términos empresariales? ¿Cómo se relacionan estas dos tablas conceptualmente? ¿Cómo debería un agente de IA unir estos recursos para responder una pregunta? Los nodos representan los recursos subyacentes junto con las entidades conceptuales (como los términos del glosario, las fórmulas de KPI y los productos de datos), y los bordes representan las conexiones semánticas (como los vínculos de definición de columna a glosario y las condiciones de unión verificadas).
Para obtener más información sobre la trazabilidad de las canalizaciones, consulta Linaje de datos de Knowledge Catalog.
Seguridad y administración empresarial
Knowledge Studio se basa en una arquitectura de seguridad de nivel empresarial diseñada para entornos con un control estricto.
Identidad de ejecución administrada por el usuario: Las tareas de enriquecimiento se ejecutan con una cuenta de servicio administrada por el usuario, que es una identidad que creas y administras en tu proyecto para permitir que los servicios actúen en tu nombre. El agente de servicio de Dataplex (P4SA) actúa en nombre de esta cuenta de servicio con el rol de creador de tokens de cuenta de servicio (
roles/iam.serviceAccountTokenCreator) para generar credenciales de OAuth 2.0 de corta duración. La generación de estas credenciales de corta duración limita la vida útil de los tokens de acceso, lo que minimiza el riesgo de exposición de las credenciales en comparación con el uso de claves de cuentas de servicio de larga duración.Autenticación de terceros: La conexión de fuentes de conocimiento de SaaS remotas (como Microsoft SharePoint, Atlassian Confluence, Jira y GitHub) usa el administrador de autenticación de Agent Identity deGoogle Cloud, lo que garantiza que los operadores humanos nunca manejen secretos de cliente sin procesar.
Para obtener información sobre cómo configurar estas funciones de seguridad, consulta Configura los requisitos previos de enriquecimiento.
Limitaciones
Regímenes de cumplimiento de Assured Workloads (incluidos FedRAMP, CJIS, IL4/IL5 y HIPAA).
Compromisos de residencia de datos (DRZ) Los datos que procesa esta función se pueden almacenar o procesar fuera de los límites geográficos configurados de forma estricta.
Claves de encriptación administradas por el cliente (CMEK). Los datos almacenados o procesados por esta función se encriptan con claves de Google y Google-owned and Google-managed encryption keys en lugar de tus claves de Cloud Key Management Service o Cloud EKM.
Controles del servicio de VPC No se admiten los Controles del servicio de VPC.
Notificaciones de Transparencia de acceso (AXT) y controles de Aprobación de acceso. Las acciones que realice el personal de Google para respaldar o mantener esta versión preliminar no se registrarán en tu Cloud Access Ledger (CAL) de Transparencia de acceso.
Durante la versión preliminar, Knowledge Studio funciona dentro de los siguientes límites adicionales:
Alcance regional del conjunto de contexto: No se admiten los conjuntos de contexto globales vinculados a recursos de datos regionales. Los conjuntos de contexto deben alinearse con los límites regionales de los recursos que empaquetan.
Administración centrada en la consola: Las tareas de enriquecimiento y las sesiones de exploración se administran a través de la consola de Google Cloud . Las APIs de REST directas y los comandos de la CLI de
gcloudpara la administración de tareas no están disponibles en la versión preliminar. Sin embargo, los agentes downstream pueden descubrir y consultar de forma programática conjuntos de contexto seleccionados con las APIs de Catalog de Knowledge Catalog (ListEntries,LookupEntry) y el Protocolo de contexto del modelo (MCP).Selección centralizada: Toda la revisión y aprobación de los metadatos se realiza en la página Detalles de la ejecución del enriquecimiento.
No hay un SKU de facturación independiente: Knowledge Studio no introduce SKU de productos independientes. Los cargos por uso reflejan el consumo estándar de los recursos subyacentes ( motor de razonamiento de Gemini, BigQuery y Cloud Storage).
¿Qué sigue?
Explora los recursos de datos y el gráfico de contexto
Usa el lienzo visual de Knowledge Studio para chatear con tus datos y rastrear relaciones semánticas.
Acerca del contexto de los datos
Comprender cómo el contexto activo transforma los metadatos pasivos para fundamentar a los agentes de IA y evitar las alucinaciones
Descripción general de los conjuntos de contexto
Obtén información sobre los contenedores de contexto empaquetados de Knowledge Studio que se usan para fundamentar de forma segura tus agentes de IA downstream.
Acerca de las tareas de enriquecimiento
Aprende a configurar flujos de trabajo de extracción de metadatos basados en IA para crear contexto de datos automáticamente.
Establecer un contexto de datos fundamental
Crear un glosario empresarial, definir tipos de aspectos personalizados y enriquecer los recursos en BigQuery
Fundamenta las respuestas de los agentes con el MCP
Conecta agentes de IA y herramientas para desarrolladores a Knowledge Catalog con el Protocolo de contexto del modelo.