


Las tareas de enriquecimiento son agentes autónomos en Knowledge Catalog que ayudan a los administradores de datos y a los ingenieros de plataformas a escalar sus operaciones de metadatos. Una tarea de enriquecimiento analiza de forma continua los esquemas de tus conjuntos de datos, lee la documentación de tu empresa y genera descripciones propuestas para tus recursos de datos. Para aprovechar al máximo las tareas de enriquecimiento, debes conocer los conceptos básicos de Knowledge Catalog y la arquitectura de datos de tu organización.
Con la automatización de la generación de metadatos, las tareas de enriquecimiento reducen la carga de la selección manual y, al mismo tiempo, garantizan que tu catálogo refleje un contexto preciso y específico de la empresa.
Por qué usar tareas de enriquecimiento
Las tareas de enriquecimiento abordan el desafío de mantener los Data Catalog a gran escala precisos y actualizados.
| Aspecto | Enfoque convencional | Enfoque de Knowledge Studio |
|---|---|---|
| Proceso | Descripciones escritas a mano. Los administradores revisan manualmente miles de tablas y entrevistan a expertos en el dominio. | Impulsado por agentes. Un agente autónomo analiza datos y lee procedimientos operativos estándar. |
| Velocidad y escalamiento | Es lento y difícil de mantener a medida que los esquemas cambian con el tiempo. | Altamente escalable Las propuestas de metadatos de alta calidad se generan de forma continua. |
| Esfuerzo humano | Alta. Ingreso manual de datos y mantenimiento continuo extensivos | Baja. Los administradores de datos solo necesitan revisar y aprobar las sugerencias generadas. |
Casos de uso de tareas de enriquecimiento
Las tareas de enriquecimiento ayudan a las organizaciones a resolver los siguientes desafíos comunes de metadatos:
Integración de adquisiciones: Una empresa adquiere una nueva unidad de negocio con miles de recursos de datos no documentados. Los ingenieros de datos apuntan una tarea de enriquecimiento al conjunto de datos nuevo y usan los diccionarios de datos de la empresa adquirida como un indicador de conocimiento. El agente propone descripciones alineadas con el negocio para todo el conjunto de datos en horas en lugar de meses.
Documentación continua: Un equipo de ingeniería de plataformas compila un lakehouse dinámico en el que los esquemas cambian a diario. Configuran una tarea de enriquecimiento para que se ejecute de forma diaria con la publicación automática habilitada, lo que garantiza que el catálogo siempre refleje los cambios más recientes en el esquema.
Administración semántica: Una oficina de datos central quiere estandarizar la terminología en todos los departamentos. Implementan una tarea de enriquecimiento que hace referencia a un glosario seleccionado de Knowledge Catalog. El agente marca y propone anulaciones de forma automática para cualquier descripción de tabla que infrinja los términos aprobados del glosario empresarial.
Conceptos básicos
Cuando configuras una tarea de enriquecimiento, defines los siguientes componentes principales:
- Tarea de enriquecimiento
-
Es la configuración que define lo que debe hacer el agente. Una tarea contiene el conjunto de contexto seleccionado, los recursos de destino, el programa y cualquier indicador de conocimiento que proporciones.
Por ejemplo, una tarea configurada para indicarle al agente que lea tus repositorios de GitHub y enriquezca tu conjunto de datos de
financetodos los domingos a la medianoche. - Trabajo de enriquecimiento
- Es el proceso de organización de backend en Knowledge Studio que ejecuta una tarea de enriquecimiento.
- Ejecución de enriquecimiento
-
Es una instancia de ejecución única y puntual de una tarea. La consola de Knowledge Studio incluye una pestaña Trabajos en la que se enumeran las ejecuciones históricas de una tarea, y puedes abrir una ejecución específica para revisar las propuestas de metadatos que generó.
Por ejemplo, la instancia de ejecución específica que ocurrió el 24 de octubre y generó 15 cambios de columna propuestos.
- Conjunto de información contextual
-
Es un contenedor limitado de recursos de datos y metadatos de destino. Cada tarea de enriquecimiento debe configurarse para que se oriente exactamente a un conjunto de contextos. El conjunto de contexto puede contener recursos de destino, como un conjunto de datos de BigQuery o Lakehouse, pero también puedes crear un conjunto de contexto vacío si no existe uno.
Por ejemplo, un conjunto de contexto de marketing que vincula lógicamente tus tablas de campañas, métricas de ROAS y glosarios de terminología en un solo límite de contexto de IA.
- Indicadores de conocimiento
- Son materiales externos que fundamentan al agente en la realidad de tu empresa. Si proporcionas buckets de Cloud Storage que contengan diccionarios de datos, glosarios de Knowledge Catalog o URLs de documentación interna, te aseguras de que el agente use tu lógica empresarial específica en lugar de hacer suposiciones genéricas.
- Conjuntos de evaluación
-
Preguntas de prueba y SQL correspondiente (proporcionado en formato
.jsonl) que se usan para calificar la exactitud del agente. Cuando el agente propone metadatos nuevos, ejecuta estas preguntas de prueba con las propuestas para garantizar que la exactitud no disminuya antes de la publicación.Por ejemplo, proporcionar una pregunta de prueba como "¿Cuál es nuestro MRR?" junto con la consulta en SQL exacta necesaria para calcular los ingresos recurrentes mensuales. Si el agente propone metadatos confusos que hacen que esta consulta de prueba falle, se marcará la propuesta.
- Fuentes de autoaprendizaje
-
Registros de conversaciones en vivo de tus apps de Gemini Enterprise o del análisis de agentes de BigQuery. El agente lee estos registros de chat para identificar lo que preguntan los usuarios, descubre las lagunas de conocimiento que faltan y propone automáticamente metadatos nuevos para llenar esas lagunas.
Por ejemplo, si los registros de chat revelan que los usuarios preguntan con frecuencia "¿Qué significa el código de estado 42?" y el agente no responde, el autoaprendizaje activa una propuesta de metadatos para documentar ese código de estado faltante.
Fuentes de datos y, también, integraciones compatibles para las tareas de enriquecimiento
Las tareas de enriquecimiento se integran en sistemas de Google Cloud y de terceros.
Recursos de datos de destino
El agente de enriquecimiento puede enriquecer y agregar directamente los siguientes recursos de datos de destino deGoogle Cloud a tus conjuntos de contexto:
Tablas, vistas y conjuntos de datos de BigQuery
Lakes, zonas y recursos de lakehouse
A través de la integración de Lakehouse, Knowledge Studio admite de forma indirecta el enriquecimiento de metadatos de fuentes de terceros adjuntas a través de integraciones de Iceberg REST Catalog (como Databricks Unity, Snowflake Horizon, AWS Glue Data Catalog y SAP Business Data Cloud).
Indicadores de conocimiento
Durante una ejecución de enriquecimiento, el agente extrae reglas semánticas, contexto empresarial y conocimiento del dominio de las siguientes fuentes de solo lectura:
Google Cloud:
- Buckets de Cloud Storage que contienen formatos de archivo compatibles (como PDF, CSV, Markdown, configuración, conjuntos de datos y archivos de texto no estructurados)
- Glosarios empresariales de Knowledge Catalog ubicados en el mismo permiso regional
- Aplicaciones de Google Workspace, incluidos los archivos de Google Drive (como Documentos, Hojas de cálculo, Presentaciones, PDFs, archivos y documentos de texto genéricos)
Sistemas de terceros (que no son de Google Cloud):
- Archivos de Microsoft SharePoint de menos de 5 MB (como archivos PDF, archivos de Office y documentos de texto genéricos, sin incluir formatos o imágenes heredados)
- Repositorios de GitHub (cualquier archivo que contenga texto legible)
- Cuerpos de páginas de Atlassian Confluence
Fuentes de autoaprendizaje
Para identificar las brechas de conocimiento a partir de los registros de interacciones reales, el agente de enriquecimiento extrae trayectorias de lo siguiente:
- Aplicaciones de Gemini Enterprise
- Tablas de análisis de agentes de BigQuery
- Cloud Logging con vistas de registro con alcance
Cómo funciona el agente de enriquecimiento
Cuando activas una tarea de enriquecimiento, ya sea a pedido o de forma recurrente, se inicia una ejecución de enriquecimiento. El agente de enriquecimiento se ejecuta de forma asíncrona en segundo plano, analiza tus recursos de datos, seguimientos de consultas y documentación para producir propuestas de metadatos verificadas.
En el siguiente diagrama, se ilustra la arquitectura de alto nivel del flujo de trabajo de un agente de enriquecimiento:
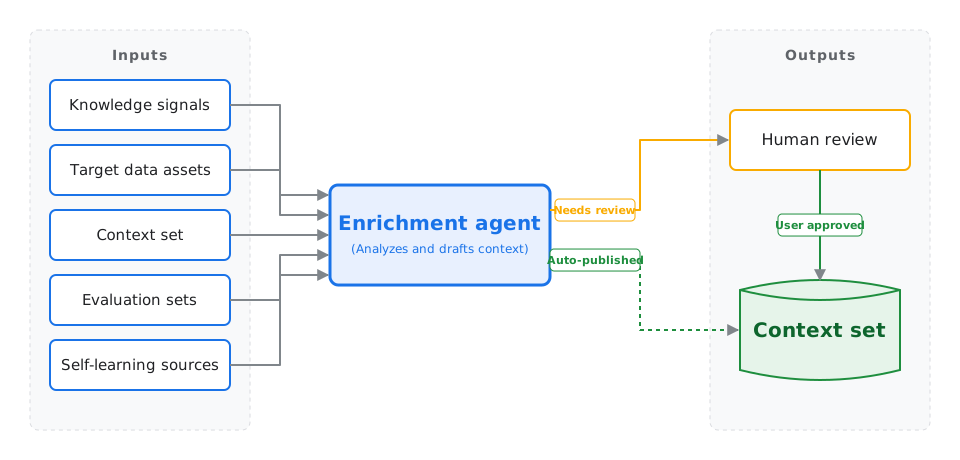
El agente selecciona tu conjunto de contexto a través de cuatro fases clave:
- Analizar indicadores y documentación: El agente extrae registros de interacción para encontrar dónde los agentes de IA downstream tuvieron dificultades o requirieron desambiguación. Analiza los documentos empresariales en Cloud Storage o las apps de terceros vinculadas, y examina el historial de consultas para descubrir uniones de tablas de alta frecuencia y dependencias ascendentes.
- Redacción de propuestas de contexto: Guiado por tu objetivo de selección, el agente redacta un contexto estructurado para tus recursos de destino. Esto incluye descripciones generales de tablas orientadas a la empresa, fórmulas de métricas formales, condiciones de unión verificadas y plantillas de consulta en SQL basadas en parámetros de oro.
- Comparativas y optimización: Con las preguntas de prueba de tu conjunto de evaluación, el agente prueba de forma iterativa sus propios metadatos de borrador y define mejor las descripciones hasta que se maximice la exactitud de las consultas downstream. Luego, ejecuta consultas de prueba retenidas para calcular una tasa de error de regresión. A cada descripción o regla de métrica propuesta se le asigna una puntuación de confianza.
- Aplicación de políticas de revisión: Las propuestas que cumplen con el umbral de confianza activan tus reglas de política. Si habilitaste la publicación automática y la tasa de error de regresión está dentro del límite permitido, los cambios se combinan automáticamente. Si el error de regresión supera el umbral permitido, la publicación automática se detiene de inmediato y todas las propuestas se empaquetan en una sola solicitud de cambio para revisión humana.
Seguridad y administración de los datos
Debido a que las tareas de enriquecimiento de Knowledge Studio usan inteligencia artificial para analizar tus esquemas de datos y documentación interna, la plataforma implementa límites estrictos para proteger tu información de propiedad exclusiva.
Entrenamiento de modelos de base: Tus datos siguen siendo tuyos. Los seguimientos de ejecución, los esquemas de bases de datos y los indicadores de conocimiento proporcionados por el cliente (como documentos o glosarios internos) nunca se usan para entrenar los modelos de base de Google.
Limpieza de datos: Antes de que se escriban los metadatos propuestos en un conjunto de contexto, el agente oculta automáticamente la información de identificación personal (IIP) de los registros del sistema y los seguimientos de generación.
Límites de ejecución: El agente de enriquecimiento opera dentro de un usuario seguro administrado por Google. Llega de forma segura a tus fuentes de datos privadas con una interfaz de Private Service Connect y un proxy de salida controlado por el cliente.
Estado de cumplimiento: Durante la fase de versión preliminar actual, las tareas de enriquecimiento no admiten los Controles del servicio de VPC (VPC-SC), las claves de encriptación administradas por el cliente (CMEK) ni Assured Workloads.
Parámetros de configuración recomendados
Knowledge Catalog proporciona varios parámetros de configuración opcionales para las tareas de enriquecimiento. Te recomendamos que comiences con una configuración básica y, luego, habilites de forma progresiva las funciones avanzadas a medida que escales tus operaciones de metadatos.
| Configuración | Componentes incluidos | Publicación automática | Casos en los que se recomienda |
|---|---|---|---|
| Básica | Conjunto de información contextual | Inhabilitado | Prueba la herramienta. Te permite ver cómo el agente infiere metadatos estrictamente a partir del esquema de tu conjunto de datos. Debes revisar todas las propuestas de forma manual. |
| Con fundamento |
|
Inhabilitado | Entornos de producción Fundamenta al agente en tu lógica empresarial específica, usando tus procedimientos operativos estándar y glosarios para mejorar la precisión. |
| Automatizado |
|
Habilitado | Escala las operaciones de metadatos. El conjunto de evaluación actúa como una barandilla de seguridad. Si una propuesta generada de forma automática provoca una regresión en la exactitud de los datos posteriores, la publicación se detiene para realizar una revisión manual. |
| Autoaprendizaje |
|
Habilitado | Catálogos avanzados y autónomos El agente se adapta de forma continua analizando las interacciones de los usuarios en vivo y los registros de chat de los agentes para identificar y corregir las brechas de conocimiento. |
Limitaciones y límites de la versión preliminar
Durante la versión preliminar, las tareas de enriquecimiento operan dentro de los siguientes límites:
Administración centrada en la consola: Configuras y administras tareas exclusivamente a través de la consola de Google Cloud . Las APIs de REST públicas directas y los comandos de la CLI de
gcloudno están disponibles en la versión preliminar.Cuotas y límites: Las tareas de enriquecimiento y las ejecuciones de tareas están sujetas a cuotas de frecuencia y recursos regionales por proyecto. Para obtener más información, consulta la sección Tareas de enriquecimiento de Knowledge Studio en Cuotas y límites.
Ciclo de vida de la Deployment
El proceso de compilación e implementación de una tarea de enriquecimiento sigue un ciclo de vida lineal:
- Configura los requisitos previos: Otorga los roles necesarios, configura las cuentas de servicio y habilita la generación de perfiles de datos y las estadísticas de datos de IA en las tablas que se usan con frecuencia. Para obtener más información, consulta Configura los requisitos previos para las tareas de enriquecimiento.
- Vincular conocimiento externo: Autoriza a la tarea para que lea archivos de tu Google Drive o repositorios de Git externos para la fundamentación.
- Crea la tarea: Define el conjunto de contexto, los recursos de destino, los indicadores de conocimiento y la estrategia de evaluación.
- Revisa las propuestas de la IA: Verifica los diagnósticos de la ejecución, revisa las descripciones propuestas y aprueba los cambios en los metadatos.
¿Qué sigue?
Descripción general de Knowledge Studio
Conocer los conceptos básicos y la arquitectura de Knowledge Studio
Descripción general de los conjuntos de contexto
Aprende cómo los metadatos generados por las tareas de enriquecimiento se almacenan en conjuntos de contexto para fundamentar los agentes de IA.
Configura los requisitos previos de enriquecimiento
Aprende a configurar roles y cuentas de servicio de para ejecutar tareas de enriquecimiento.
Crear tareas de enriquecimiento
Aprende a generar metadatos ejecutando tareas de enriquecimiento automatizadas.
Administrar las ejecuciones de enriquecimiento
Aprende a supervisar los trabajos y a revisar o aprobar manualmente las propuestas de metadatos.
Administrar tareas de enriquecimiento
Aprende a editar, pausar y borrar trabajos de enriquecimiento programados.