


Knowledge Studio (Vorabversion) wandelt Metadaten in eine aktive Kontext-Engine um, mit der Sie die Zuverlässigkeit von generativen KI-Anwendungen verbessern können. Mit Knowledge Studio können Sie Halluzinationen bei KI-Agenten wie konversationellen Analysen in BigQuery und Gemini verhindern, indem Sie sie in Ihrem Geschäftskontext fundieren.
Knowledge Studio automatisiert die Metadatenkuratierung, indem fragmentiertes Wissen aus Schemas, Wikis und früheren SQL-Abfragen zusammengeführt wird. Sie können Daten mit natürlicher Sprache untersuchen, einen visuellen Kontextgraphen aufrufen, der Daten-Assets mit Geschäftssemantik verbindet, und automatisierte Workflows ausführen, die Katalogaktualisierungen für die manuelle Überprüfung entwerfen. Diese ausgewählten Kontextblöcke können dann mithilfe des Model Context Protocol (MCP) oder der Knowledge Catalog APIs dynamisch an KI-Agenten bereitgestellt werden.
Dieses Dokument richtet sich an Datenarchitekten, Governance-Leiter und KI-Entwickler, die verstehen möchten, wie Knowledge Studio funktioniert.
Vom passiven Katalog zur aktiven Kontext-Engine
In typischen Metadatenkatalogen werden statische Schemas, Beschreibungen und Datenverzeichnisse gespeichert. Statische Metadaten reichen zwar für menschliche Datenanalysten aus, die nach Tabellen suchen, aber nicht für generative KI-Agenten, die Folgendes benötigen:
Tiefe semantische Beziehungen: Verstehen, wie Tabellen über Schemas hinweg verknüpft werden, welche Spalten wichtige Geschäftsmesswerte darstellen und wie Unternehmensglossare dem zugrunde liegenden Speicher zugeordnet werden.
Operative Fundierung: Einbeziehung von realen SQL-Nutzungsmustern, Abfragehäufigkeit und tatsächlichen Agent-Prompts und ‑Antworten in den Kontext.
Kontinuierliches selbstständiges Lernen: Tabellenbeschreibungen, Aspekte und Spaltendefinitionen werden automatisch anhand von Nutzerfeedback und Erfolgsquoten bei der Ausführung von KI-Agenten verfeinert.
Knowledge Studio bietet diese Funktionen über eine Always-on-Kontext-Engine, die kontinuierlich operative Signale auswertet, hochwertige Metadatenvorschläge generiert und vorformatierte Kontextblöcke über das Model Context Protocol (MCP) oder die Knowledge Catalog-APIs an Agenten liefert.
Knowledge Studio-Oberflächen
Knowledge Studio organisiert Ihren Workflow in drei Hauptbereiche:
Neuer Chat: Eine konversationelle Chatoberfläche und ein interaktiver Kontextgraph für die Datenerkennung, ‑untersuchung und semantische Abfragevalidierung in natürlicher Sprache. Weitere Informationen finden Sie unter Daten-Assets untersuchen.
Kontextsätze: Eine Schnittstelle zum Erstellen und Verwalten der logischen Container (Eintragsgruppen), die Ihre angereicherten Metadaten verpacken, um nachgelagerte KI-Agenten sicher zu fundieren. Weitere Informationen finden Sie unter Kontextsätze verwalten.
Anreicherungen: Ein Kontrollzentrum, um die Metadatengenerierung zu automatisieren, Bewertungsbenchmarks zu konfigurieren und von der KI vorgeschlagene Katalogaktualisierungen (Änderungsanfragen) mit Human-in-the-Loop-Kuratierungsworkflows zu überprüfen. Weitere Informationen finden Sie unter Anreicherungsaufgaben.
Reale Szenarien mit mehreren Produkten
Knowledge Studio verbindet Ihr Data Warehouse, Ihre Unternehmens-Wissens-Repositories und Ihre generativen KI-Anwendungen. Die folgenden Szenarien veranschaulichen, wie Knowledge Studio in einer Unternehmensarchitektur mit mehreren Produkten interagiert.
Abfragen in natürlicher Sprache in BigQuery fundieren
Die Herausforderung: Business-Analysten verwenden natürliche Sprache in konversationellen Analysen, um Fragen wie „Wie hoch war unsere Nettobindungsrate nach Region im letzten Quartal?“ zu stellen. Ohne kuratierte Geschäftssemantik kann das Modell Join-Schlüssel halluzinieren oder Bruttobuchungen mit Nettoeinnahmen verwechseln.
Die Knowledge Studio-Lösung: Der Analyst verwendet die Oberfläche Neuer Chat, um die Beziehungen zwischen den Sales-Staging-Tabellen und dem zertifizierten
SZBank Business Glossaryzu überprüfen. Knowledge Studio fundiert die konversationelle Analyse mithilfe des aktiven Kontextgraphen, sodass generiertes SQL verifizierte Join-Bedingungen und Standard-KPI-Formeln enthält.
Metadaten aus Unternehmens-SOPs anreichern
Die Herausforderung: Data-Engineering-Teams verwalten Dutzende von Datasets in BigQuery, während wichtige Geschäftsregeln und die Pipeline-Herkunft in externen Confluence-Wikis oder Jira-Tickets gespeichert sind. Wenn sich Schemas weiterentwickeln, veraltet die Katalogdokumentation.
Die Knowledge Studio-Lösung: Ein Governance-Leiter konfiguriert eine wiederkehrende Anreicherungsaufgabe, die auf das Analyse-Dataset abzielt. Knowledge Studio nimmt unstrukturierte SOPs aus Confluence und historische Abfragelogs aus Cloud Logging auf und schlägt automatisch aktualisierte Spaltendefinitionen und Tabellenbeziehungen vor. Kuratoren prüfen die vorgeschlagenen Diffs auf der Seite Ausführungsdetails und genehmigen verifizierte Aktualisierungen des Katalogs.
KI-Agenten ausgewählte Kontextinformationen bereitstellen
- Die Herausforderung: KI-Entwickler, die mit LangChain oder dem ADK kundenorientierte Support- oder Beratungs-Agents erstellen, benötigen aktuelle Schemasemantik, ohne Datenbankanmeldedaten hartcodieren oder große Tabellendefinitionen in Prompts einfügen zu müssen.
- Die Knowledge Studio-Lösung: Knowledge Studio erfasst ausgewählte Metadaten und validierte Join-Diagramme in einem Kontextsatz (z. B.
entryGroups/customer-360). Um auf den Kontext zuzugreifen, können sich KI-Agenten über das Model Context Protocol (MCP) mit Knowledge Studio verbinden oder die Knowledge Catalog APIs verwenden. Bei der Inferenz fragt der KI-Agent den MCP-Endpunkt oder die Catalog APIs ab, um dynamisch zertifizierten Geschäftskontext und Beispielabfragen abzurufen, die für die Absicht des Nutzers relevant sind.
Architektur
Das folgende Diagramm zeigt, wie Knowledge Studio-Komponenten mit Ihrem Datenbestand, Foundation Models und KI-Anwendungen interagieren:
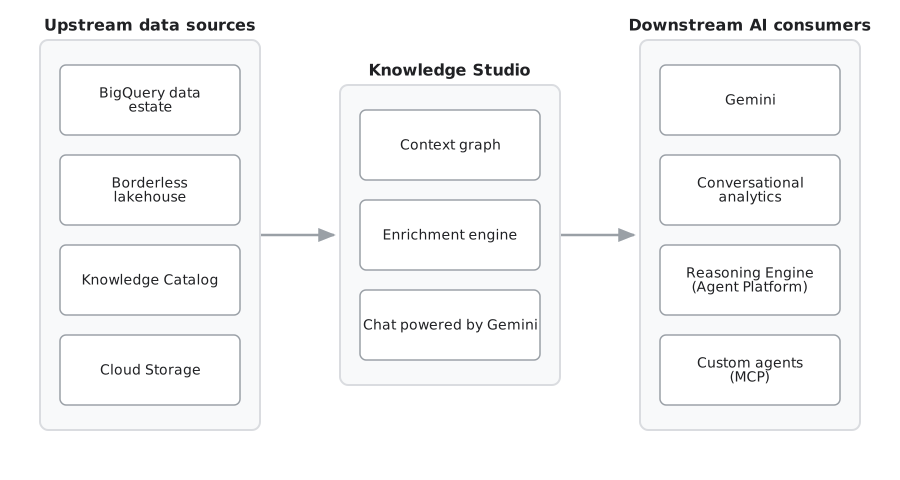
Wichtige Konzepte
Wenn Sie effektiv mit Knowledge Studio arbeiten möchten, müssen Sie wissen, wie Unternehmensmetadaten modelliert, verpackt und kuratiert werden.
Kontextdiagramm
Der Kontextgraph ist die zentrale, interaktive visuelle Topologie in Knowledge Studio. Dabei werden Ihre Daten-Assets (z. B. BigQuery-Tabellen, -Ansichten und -Lakehouses) mit Geschäftssemantik (z. B. Begriffe aus dem Unternehmensglossar, Messwertformeln und Datenprodukte) zusammengeführt. In typischen Katalogen befinden sich eine Datentabelle und die zugehörige Definition im Unternehmensglossar in separaten Silos. Im Kontextdiagramm sind sie als Knoten auf
auf demselben Canvas. Datenanalysten und ‑ingenieure können Beziehungen zwischen ihren Daten visuell darstellen, entweder durch abgeleitete Nutzung, Join-Bedingungen für Tabellen und mehr. Gemini verwendet das Diagramm, um die Exploration in natürlicher Sprache zu fundieren. Weitere Informationen finden Sie unter Daten-Assets in Knowledge Studio untersuchen.
Unterstützte Ressourcen- und Verbindungstypen für den Kontextgraphen
Der Kontextgraph unterstützt das Rendern der folgenden Knowledge Catalog-Ressourcen als Knoten oder Container:
- Tabellen und Ansichten: Technische BigQuery- und Lakehouse-Tabellen, -Ansichten, -Datasets und -Kataloge.
- Datenbanken und Speicher: Operative Datenbanken (z. B. Spanner und AlloyDB) und Cloud Storage-Ressourcen.
- Analyse und Modellierung: Looker-Projekte und dbt-Modelle, -Tests und -Exposures.
- Glossarbegriffe: Einzelne Geschäftsdefinitionen aus einem Unternehmensglossar.
- Datenprodukte: Kuratierte Bundles von Daten-Assets für die teamübergreifende Nutzung.
- Kontext: Benutzerdefinierte Kontextsets und angehängte Dokumentation.
- Benutzerdefinierte Assets: Benutzerdefinierte Eintragsgruppen und nicht unterstützte Eintragstypen.
Der Graph definiert, wie diese Ressourcen verbunden sind, indem die folgenden semantischen Beziehungskanten visualisiert werden:
Schema-Join: Strukturelle und operative Join-Beziehungen zwischen Tabellen. Das System scannt BigQuery-Jobs automatisch nach Abfragen, die darauf hindeuten, dass Spalten in verschiedenen Tabellen dieselbe Bedeutung haben und zusammengeführt werden können.
Definition: Links, die ein technisches Daten-Asset oder eine Spalte der entsprechenden Definition im Unternehmensglossar zuordnen.
Kontext: Links, die einem Zieldaten-Asset spezielle Kontextgruppen oder Dokumentationen zu benutzerdefinierten Domains zuordnen.
Pakete: Aggregationslinks, die zeigen, welche Daten-Assets in einem bestimmten Datenprodukt gebündelt sind.
Eintragslinks
Ein Eintragslink stellt eine gerichtete oder ungerichtete semantische Kante im Kontextgraphen dar. Diese Links verbinden Ihre Daten-Assets und andere vereinheitlichte Ressourcen auf dem Canvas visuell. Sie können diese Links selektiv filtern, um bestimmte Beziehungen in Ihrem Datenbestand zu isolieren.
Eintragslinks verbinden verschiedene Entitäten in Ihrem Unternehmen:
Definitionslinks: Verbinden Sie zugrunde liegende Tabellenspalten direkt mit zertifizierten Begriffen des Unternehmensglossars und KPI-Formeln.
Beziehungslinks: Ordnen Sie verifizierte Primärschlüssel, Fremdschlüssel und Join-Pfade für mehrere Tabellen zu.
Agent-Trace-Links: Verknüpfen Sie reale KI-Nutzerprompts mit den spezifischen Tabellen, die zur Beantwortung verwendet wurden.
Paketlinks: Verknüpfen Sie Datensätze mit einem ausgewählten Datenprodukt.
Eintragslinks dienen als einzelne Verbindungen, die durchlaufen werden, um Kontextgruppen zusammenzustellen. Bei automatisierten Anreicherungsläufen schlägt der Agent neue Eintragslinks zur Genehmigung durch den Kurator vor, wenn er Kandidatenverknüpfungen oder nicht verknüpfte Begriffe identifiziert.
Kontextsets
Ein Kontextsatz ist ein begrenzter Container mit semantischen Informationen und Verweisen auf Daten-Assets. Jeder Kontextsatz wird als spezialisierte Eintragsgruppe (type="context-set") implementiert.
Kontextsätze legen hermetische Ausführungsgrenzen fest, die verhindern, dass Agenten offene Suchanfragen im gesamten Unternehmenskatalog ausführen. Diese Methode reduziert Halluzinationen und den Tokenverbrauch.
Informationen dazu, wie sich Kontextgruppen von verwandten Konstrukten wie Datenprodukten und dem semantischen Kontextgraphen unterscheiden, sowie zu detaillierten Architekturfunktionen, Kategorien, Namespaces und Agenten-Konsultationsmustern finden Sie unter Kontextgruppen – Übersicht.
Anreicherungstasks und ‑ausführungen
Die automatisierte Metadatenverbesserung in Knowledge Studio ist in Anreicherungsaufgaben, Anreicherungsjobs und Anreicherungsausführungen unterteilt.
Anreicherungsaufgabe: Eine langlebige Konfiguration, die definiert, wie der Anreicherungs-Agent eine bestimmte Gruppe von Daten-Assets analysiert. Eine Anreicherungsaufgabe gibt das Zielkontextset, die kontextbezogenen Eingabequellen und die Bewertungsbenchmarks an.
Anreicherungsjob: Der Backend-Orchestrierungsprozess in Knowledge Studio, der eine Anreicherungsaufgabe ausführt.
Anreicherungsausführung: Eine einzelne, zeitpunktbezogene Ausführungsinstanz einer Aufgabe. Bei jeder Ausführung werden Ziel-Assets geprüft, semantische Signale extrahiert und Änderungsanfragen (Vorschläge) generiert, die von Data Stewards überprüft werden können.
Weitere Informationen zu Anreicherungs-Workflows finden Sie unter Anreicherungsaufgaben.
Kontextdiagramm im Vergleich zur Datenherkunft
Die Unterschiede zwischen dem Kontextgraphen von Knowledge Studio und der Datenherkunft von Knowledge Catalog zu kennen, ist entscheidend, um das richtige Tool auszuwählen.
Mit der Datenherkunft werden die operative Bewegung und die zugrunde liegende Transformation von Daten im Laufe der Zeit verfolgt. Die Herkunft beantwortet Fragen wie: Woher stammen diese Daten? Welche ETL-Pipeline hat diese Tabelle gefüllt? Wenn sich dieses Upstream-Schema ändert, welche Downstream-Dashboards funktionieren dann nicht mehr? Knoten stellen zugrunde liegende Assets und Transformationsjobs dar (z. B. Dataflow-Pipelines oder BigQuery-Jobs) und gerichtete Kanten stellen den zugrunde liegenden Datenfluss dar.
Kontextdiagramm: Modelliert Geschäftssemantik, Beziehungen und Domainwissen. Der Kontext-Graph beantwortet Fragen wie: Was bedeutet diese Spalte in geschäftlicher Hinsicht? Wie hängen diese beiden Tabellen konzeptionell zusammen? Wie sollte ein KI-Agent diese Assets zusammenführen, um eine Frage zu beantworten? Knoten stellen zugrunde liegende Assets sowie konzeptionelle Entitäten (z. B. Glossarbegriffe, KPI-Formeln und Datenprodukte) dar. Kanten stellen semantische Verbindungen dar (z. B. Links von Spalten zu Glossardefinitionen und verifizierte Join-Bedingungen).
Weitere Informationen zur Rückverfolgbarkeit von Pipelines finden Sie unter Knowledge Catalog-Datenherkunft.
Sicherheit und Governance für Unternehmen
Knowledge Studio basiert auf einer Sicherheitsarchitektur auf Unternehmensniveau, die für streng regulierte Umgebungen entwickelt wurde.
Nutzerverwaltete Ausführungsidentität: Anreicherungsaufgaben werden mit einem nutzerverwalteten Dienstkonto ausgeführt. Dies ist eine Identität, die Sie in Ihrem Projekt erstellen und verwalten, damit Dienste in Ihrem Namen agieren können. Der Dataplex-Dienst-Agent (P4SA) übernimmt die Identität dieses Dienstkontos mithilfe der Rolle Ersteller von Dienstkonto-Tokens (
roles/iam.serviceAccountTokenCreator), um kurzlebige OAuth 2.0-Anmeldedaten zu generieren. Durch das Generieren dieser kurzlebigen Anmeldedaten wird die Lebensdauer von Zugriffstokens begrenzt. Dadurch wird das Risiko einer Offenlegung von Anmeldedaten im Vergleich zur Verwendung langlebiger Dienstkontoschlüssel minimiert.Authentifizierung von Drittanbietern: Für die Verbindung von Remote-SaaS-Wissensquellen (wie Microsoft SharePoint, Atlassian Confluence, Jira und GitHub) wird der Agent Identity Auth Manager vonGoogle Cloudverwendet. So wird sichergestellt, dass menschliche Operatoren niemals unverschlüsselte Clientschlüssel verarbeiten.
Informationen zum Konfigurieren dieser Sicherheitsfunktionen finden Sie unter Voraussetzungen für die Anreicherung konfigurieren.
Beschränkungen
Assured Workloads-Compliance-Regelungen (einschließlich FedRAMP, CJIS, IL4/IL5 und HIPAA).
Zusicherungen zum Datenstandort (DRZ). Daten, die von dieser Funktion verarbeitet werden, können außerhalb Ihrer streng konfigurierten geografischen Grenzen gespeichert oder verarbeitet werden.
Kundenverwaltete Verschlüsselungsschlüssel (CMEK). Daten, die von dieser Funktion gespeichert oder verarbeitet werden, werden mit von Google verwalteten undGoogle-owned and Google-managed encryption keys anstelle Ihrer Cloud Key Management Service- oder Cloud EKM-Schlüssel verschlüsselt.
VPC Service Controls. VPC Service Controls wird nicht unterstützt.
Access Transparency-Benachrichtigungen (AXT) und Zugriffsgenehmigungs-Steuerelemente. Aktionen, die von Google-Mitarbeitern zur Unterstützung oder Wartung dieser Vorabversion ausgeführt werden, werden nicht in Ihrem Access Transparency Cloud Access Ledger (CAL) protokolliert.
In der Vorschau gelten für Knowledge Studio die folgenden zusätzlichen Einschränkungen:
Regionaler Kontextbereich: Globale Kontextbereiche, die mit regionalen Daten-Assets verknüpft sind, werden nicht unterstützt. Kontextsätze müssen mit den regionalen Grenzen der Assets übereinstimmen, die sie enthalten.
Verwaltung über die Console: Anreicherungsaufgaben und Explorationssitzungen werden über die Google Cloud Console verwaltet. Direkte REST APIs und
gcloud-Befehlszeilenbefehle für die Aufgabenverwaltung sind in der Vorabversion nicht verfügbar. Nachgelagerte Agenten können jedoch programmatisch kuratierte Kontextsets mithilfe der Knowledge Catalog-APIs (ListEntries,LookupEntry) und des Model Context Protocol (MCP) finden und abfragen.Zentralisierte Auswahl: Alle Metadaten werden auf der Seite Details zur Anreicherungsausführung überprüft und genehmigt.
Keine eigenständige Abrechnungs-SKU: Für Knowledge Studio werden keine separaten Produkt-SKUs eingeführt. Die Nutzungsgebühren spiegeln den Standardverbrauch der zugrunde liegenden Ressourcen ( Gemini Reasoning Engine, BigQuery und Cloud Storage) wider.
Nächste Schritte
Daten-Assets und Kontextdiagramm ansehen
Mit dem visuellen Canvas in Knowledge Studio können Sie mit Ihren Daten chatten und semantische Beziehungen nachverfolgen.
Datenkontext
Erfahren Sie, wie aktiver Kontext passive Metadaten transformiert, um KI-Agenten zu fundieren und Halluzinationen zu vermeiden.
Kontextsets – Übersicht
Hier erfahren Sie mehr über die verpackten Kontextcontainer von Knowledge Studio, mit denen Sie Ihre nachgelagerten KI-Agenten sicher fundieren können.
Anreicherungsaufgaben
Hier erfahren Sie, wie Sie KI-gestützte Workflows zur Metadatenextraktion konfigurieren, um automatisch Datenkontext zu erstellen.
Grundlegenden Datenkontext herstellen
Unternehmensglossar erstellen, benutzerdefinierte Aspekttypen definieren und Assets in BigQuery anreichern.
KI-Agenten mit MCP fundieren
KI-Agenten und Entwicklertools über das Model Context Protocol mit Knowledge Catalog verbinden